

En la antesala del inicio del curso hemos preparado para usted otra traducción útil.
Las bases de datos gráficas son una tecnología importante para los especialistas en bases de datos. Intento estar al tanto de las innovaciones y nuevas tecnologías en este campo, y tras trabajar con bases de datos relacionales y NoSQL, veo que el papel de las bases de datos gráficas se está volviendo cada vez más relevante. En el trabajo con datos jerárquicos complejos, no solo las bases de datos tradicionales son poco eficientes, sino también las NoSQL. A menudo, con el aumento de niveles de relaciones y el tamaño de la base de datos, se observa una disminución en el rendimiento. A medida que se complican las interrelaciones, también aumenta la cantidad de JOIN.
Por supuesto, en el modelo relacional existen soluciones para trabajar con jerarquías (por ejemplo, mediante CTE recursivos), pero siguen siendo soluciones alternativas. Sin embargo, la funcionalidad de las bases de datos gráficas de SQL Server permite manejar múltiples niveles de jerarquía con facilidad. Tanto el modelo de datos como las consultas se simplifican, lo que aumenta su eficiencia. Se reduce significativamente el volumen de código.
Las bases de datos gráficas son un lenguaje expresivo para representar sistemas complejos. Esta tecnología ya se utiliza ampliamente en la industria de TI en áreas como redes sociales, sistemas antifraude, análisis de redes de TI, recomendaciones sociales, y recomendaciones de productos y contenido.
La funcionalidad de las bases de datos gráficas en SQL Server es adecuada para escenarios en los que los datos están fuertemente interrelacionados y tienen vínculos claramente definidos.
Modelo de datos gráfico
Un gráfico es un conjunto de vértices (nodos, node) y aristas (relaciones, edge). Los vértices representan entidades y las aristas representan vínculos, cuyas atributos pueden contener información.
Una base de datos gráfica modela entidades en forma de gráfico, tal como se define en la teoría de grafos. Las estructuras de datos son vértices y aristas. Los atributos son propiedades de los vértices y aristas. La conexión es la unión de vértices.
A diferencia de otros modelos de datos, en las bases de datos gráficas las relaciones entre entidades son prioritarias. Por lo tanto, no es necesario calcular relaciones mediante claves externas o de ninguna otra manera. Se pueden crear modelos de datos complejos utilizando solo las abstracciones de vértices y aristas.
En el mundo moderno, la modelización de relaciones requiere técnicas cada vez más complejas. Para modelar relaciones, SQL Server 2017 ofrece capacidades de bases de datos gráficas. Los nodos y aristas del grafo se representan como nuevos tipos de tablas: NODE y EDGE. Para las consultas al grafo se utiliza una nueva función T-SQL llamada MATCH(). Dado que esta funcionalidad está integrada en SQL Server 2017, se puede utilizar en sus bases de datos existentes sin necesidad de ninguna conversión.
Beneficios del modelo gráfico
Actualmente, las empresas y los usuarios exigen aplicaciones que operen con volúmenes de datos cada vez mayores, esperando al mismo tiempo alta rendimiento y fiabilidad. La representación de datos en forma de grafo ofrece herramientas convenientes para manejar relaciones complejas. Este enfoque permite resolver muchos problemas y ayuda a obtener resultados dentro de un contexto dado.
Aparentemente, en el futuro muchas aplicaciones se beneficiarán del uso de bases de datos gráficas.
Modelización de datos: de la modelo relacional al gráfico
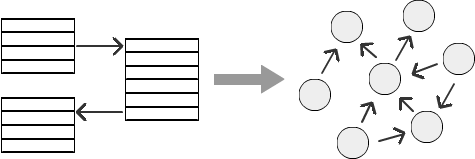
Ejemplo
Consideremos un ejemplo de estructura organizacional con jerarquía de empleados: un empleado reporta a un gerente, el gerente a un gerente senior, y así sucesivamente. Dependiendo de la empresa específica, esta jerarquía puede tener cualquier número de niveles. Pero a medida que aumenta el número de niveles, el cálculo de relaciones en una base de datos relacional se vuelve cada vez más complicado. Es bastante difícil representar la jerarquía de empleados, la jerarquía en marketing o las relaciones en redes sociales. Veamos cómo se puede resolver el problema de manejar varios niveles de jerarquía usando SQL Graph.
Para este ejemplo, hagamos un modelo de datos simple. Creemos una tabla de empleados EMP con un identificador EMPNO y una columna MGR, que indica el identificador del gerente (jefe) del empleado. Toda la información sobre la jerarquía se almacena en esta tabla y se puede consultar utilizando las columnas EMPNO y MGR.
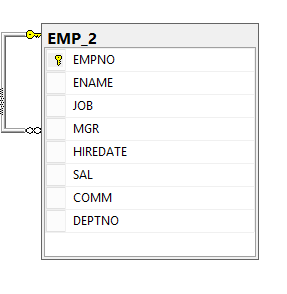
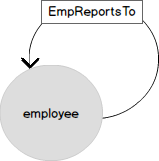
En el siguiente diagrama se representa el mismo modelo de estructura organizacional con cuatro niveles de anidación de una manera más familiar. Los empleados son los nodos del grafo de la tabla EMP. La entidad "empleado" está relacionada consigo misma mediante la relación "reporta a" (ReportsTo). En términos de grafo, la relación es una arista (EDGE) que conecta los nodos (NODE) de los empleados.
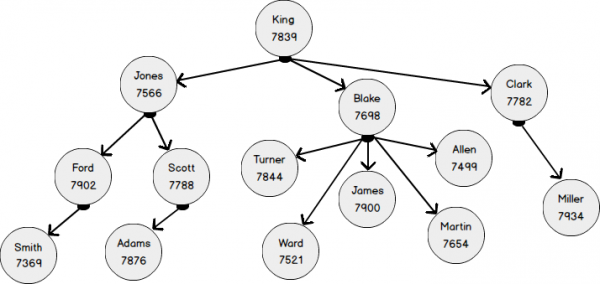
Creemos una tabla simple EMP y agreguemos valores de acuerdo con el diagrama anterior.
CREATE TABLE EMP
(EMPNO INT NOT NULL,
ENAME VARCHAR(20),
JOB VARCHAR(10),
MGR INT,
JOINDATE DATETIME,
SALARY DECIMAL(7, 2),
COMMISIION DECIMAL(7, 2),
DNO INT)

INSERT INTO EMP VALUES
(7369, 'SMITH', 'CLERK', 7902, '02-MAR-1970', 8000, NULL, 2),
(7499, 'ALLEN', 'SALESMAN', 7698, '20-MAR-1971', 1600, 3000, 3),
(7521, 'WARD', 'SALESMAN', 7698, '07-FEB-1983', 1250, 5000, 3),
(7566, 'JONES', 'MANAGER', 7839, '02-JUN-1961', 2975, 50000, 2),
(7654, 'MARTIN', 'SALESMAN', 7698, '28-FEB-1971', 1250, 14000, 3),
(7698, 'BLAKE', 'MANAGER', 7839, '01-JAN-1988', 2850, 12000, 3),
(7782, 'CLARK', 'MANAGER', 7839, '09-APR-1971', 2450, 13000, 1),
(7788, 'SCOTT', 'ANALYST', 7566, '09-DEC-1982', 3000, 1200, 2),
(7839, 'KING', 'PRESIDENT', NULL, '17-JUL-1971', 5000, 1456, 1),
(7844, 'TURNER', 'SALESMAN', 7698, '08-AUG-1971', 1500, 0, 3),
(7876, 'ADAMS', 'CLERK', 7788, '12-MAR-1973', 1100, 0, 2),
(7900, 'JAMES', 'CLERK', 7698, '03-NOV-1971', 950, 0, 3),
(7902, 'FORD', 'ANALYST', 7566, '04-MAR-1961', 3000, 0, 2),
(7934, 'MILLER', 'CLERK', 7782, '21-JAN-1972', 1300, 0, 1)
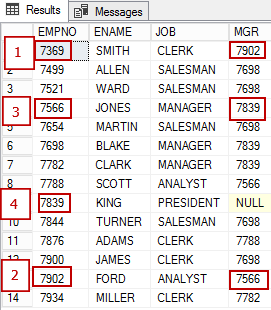
En la figura siguiente se muestran los empleados:
- el empleado con EMPNO 7369 reporta a 7902;
- el empleado con EMPNO 7902 reporta a 7566
- el empleado con EMPNO 7566 reporta a 7839
Ahora, veamos la representación de los mismos datos en forma de grafo. El nodo EMPLOYEE tiene varios atributos y está relacionado consigo mismo a través de la relación 'reporta a' (EmplReportsTo). EmplReportsTo es el nombre de la relación.
En la tabla de aristas (EDGE) también pueden existir atributos.
Creemos la tabla de nodos EmpNode
La sintaxis para crear un nodo es bastante sencilla: se añade al final de la expresión CREATE TABLE el término 'AS NODE'.
CREATE TABLE dbo.EmpNode(
ID Int Identity(1,1),
EMPNO NUMERIC(4) NOT NULL,
ENAME VARCHAR(10),
MGR NUMERIC(4),
DNO INT
) AS NODE;
Ahora convertimos los datos de la tabla simple a un grafo. La siguiente INSERTAR inserta datos desde la tabla relacional EMP.
INSERT INTO EmpNode(EMPNO,ENAME,MGR,DNO) select empno,ename,MGR,dno from emp 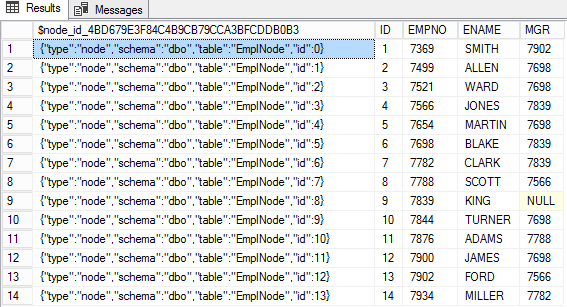
En la tabla de nodos, una columna especial $node_id_* almacena el identificador del nodo en formato JSON. En las otras columnas de esta tabla se encuentran los atributos del nodo.
Creando aristas (EDGE)
La creación de la tabla de aristas es muy similar a la creación de la tabla de nodos, con la excepción de que se utiliza la palabra clave 'AS EDGE'.
CREATE TABLE empReportsTo(Deptno int) AS EDGE 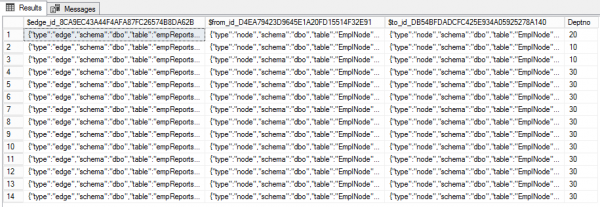
Ahora definamos las relaciones entre empleados utilizando las columnas EMPNO y MGR. En el diagrama de la estructura organizativa se puede ver claramente cómo escribir INSERTAR.
INSERTAR EN empReportsTo VALORES ((SELECCIONAR $node_id DE EmpNode DONDE ID = 1),
   	(SELECCIONAR $node_id DE EmpNode DONDE id = 13),20);
INSERTAR EN empReportsTo VALORES ((SELECCIONAR $node_id DE EmpNode DONDE ID = 2),
   	(SELECCIONAR $node_id DE EmpNode DONDE id = 6),10);
INSERTAR EN empReportsTo VALORES ((SELECCIONAR $node_id DE EmpNode DONDE ID = 3),
   	(SELECCIONAR $node_id DE EmpNode DONDE id = 6),10)
INSERTAR EN empReportsTo VALORES ((SELECCIONAR $node_id DE EmpNode DONDE ID = 4),
   	(SELECCIONAR $node_id DE EmpNode DONDE id = 9),30);
INSERTAR EN empReportsTo VALORES ((SELECCIONAR $node_id DE EmpNode DONDE ID = 5),
   	(SELECCIONAR $node_id DE EmpNode DONDE id = 6),30);
INSERTAR EN empReportsTo VALORES ((SELECCIONAR $node_id DE EmpNode DONDE ID = 6),
   	(SELECCIONAR $node_id DE EmpNode DONDE id = 9),30);
INSERTAR EN empReportsTo VALORES ((SELECCIONAR $node_id DE EmpNode DONDE ID = 7),
   	(SELECCIONAR $node_id DE EmpNode DONDE id = 9),30);
INSERTAR EN empReportsTo VALORES ((SELECCIONAR $node_id DE EmpNode DONDE ID = 8),
   	(SELECCIONAR $node_id DE EmpNode DONDE id = 4),30);
INSERTAR EN empReportsTo VALORES ((SELECCIONAR $node_id DE EmpNode DONDE ID = 9),
   	(SELECCIONAR $node_id DE EmpNode DONDE id = 9),30);
INSERTAR EN empReportsTo VALORES ((SELECCIONAR $node_id DE EmpNode DONDE ID = 10),
   	(SELECCIONAR $node_id DE EmpNode DONDE id = 6),30);
INSERTAR EN empReportsTo VALORES ((SELECCIONAR $node_id DE EmpNode DONDE ID = 11),
   	(SELECCIONAR $node_id DE EmpNode DONDE id = 8),30);
INSERTAR EN empReportsTo VALORES ((SELECCIONAR $node_id DE EmpNode DONDE ID = 12),
   	(SELECCIONAR $node_id DE EmpNode DONDE id = 6),30);
INSERTAR EN empReportsTo VALORES ((SELECCIONAR $node_id DE EmpNode DONDE ID = 13),
   	(SELECCIONAR $node_id DE EmpNode DONDE id = 4),30);
INSERTAR EN empReportsTo VALORES ((SELECCIONAR $node_id DE EmpNode DONDE ID = 14),
   	(SELECCIONAR $node_id DE EmpNode DONDE id = 7),30);
La tabla de bordes por defecto consta de tres columnas. La primera, $edge_id — es el identificador del borde en formato JSON. Las otras dos ($from_id y $to_id) representan la relación entre nodos. Además, los bordes pueden tener propiedades adicionales. En nuestro caso, esto es Deptno.
Vistas del sistema
En la vista del sistema sys.tables aparecieron dos nuevas columnas:
- is_edge
- is_node
SELECCIONAR t.is_edge,t.is_node,*
DE sys.tables t
DONDE name LIKE 'emp%' 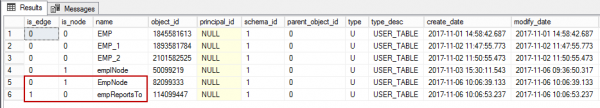
SSMS
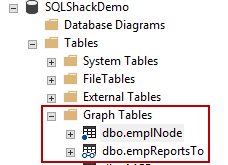
Los objetos relacionados con gráficos se encuentran en la carpeta Tablas de Gráficos. El ícono de la tabla de nodos está marcado con un punto, mientras que las tablas de bordes tienen dos círculos conectados (lo que se parece un poco a unos anteojos).
La expresión MATCH
Expresión MATCH proviene de CQL (Cypher Query Language). Es una forma eficiente de consultar propiedades de gráficos. CQL comienza con la expresión MATCH.
Sintaxis
MATCH ()

::=
    { {
                 	{ <-()- }
               	| { -()-> }

             	}
 	}
 	[ { AND } { () } ]
 	[ ,...n ]

::=
    node_table_name | node_alias

::=
    edge_table_name | edge_alias
Ejemplos
Veamos algunos ejemplos.
La consulta a continuación muestra a los empleados que están bajo Smith y su gerente.
SELECCIONAR
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR
DE
    empnode e, empnode e1, empReportsTo m
DONDE
    MATCH(e-(m)->e1)
y e.ENAME='SMITH' 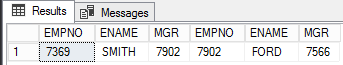
La siguiente consulta está destinada a buscar empleados y gerentes de segundo nivel para Smith. Si se elimina la propuesta WHERE, entonces se mostrarán todos los empleados.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR
FROM
    empnode e, empnode e1, empReportsTo m ,empReportsTo m1, empnode e2
WHERE
    MATCH(e-(m)->e1-(m1)->e2)
and e.ENAME='SMITH' 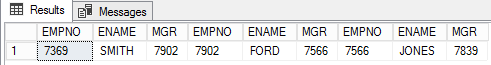
Y, finalmente, la consulta para empleados y gerentes de tercer nivel.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR,E3.EMPNO,e3.ENAME,E3.MGR
FROM
    empnode e, empnode e1, empReportsTo m ,empReportsTo m1, empnode e2, empReportsTo M2, empnode e3
WHERE
    MATCH(e-(m)->e1-(m1)->e2-(m2)->e3)
and e.ENAME='SMITH' 
Ahora cambiemos de dirección para obtener a los jefes de Smith.
SELECT
E.EMPNO,E.ENAME,E.MGR,E1.EMPNO,E1.ENAME,E1.MGR,E2.EMPNO,e2.ENAME,E2.MGR,E3.EMPNO,e3.ENAME,E3.MGR
FROM
    empnode e, empnode e1, empReportsTo m ,empReportsTo m1, empnode e2, empReportsTo M2, empnode e3
WHERE
MATCH(e<-(m)-e1<-(m1)-e2<-(m2)-e3) 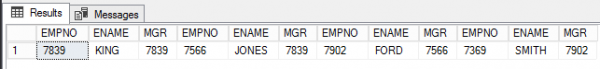
Conclusión
SQL Server 2017 ha demostrado ser una solución empresarial completa para diversas tareas de TI. La primera versión de SQL Graph es muy prometedora. A pesar de algunas limitaciones, ya existen suficientes funcionalidades para explorar las capacidades de los gráficos.
La funcionalidad de SQL Graph está completamente integrada en el motor SQL. Sin embargo, como ya se ha mencionado, SQL Server 2017 tiene las siguientes limitaciones:
No hay soporte para polimorfismo.
- Solo se admiten relaciones unidireccionales.
- No se pueden actualizar las columnas $from_id y $to_id de las aristas a través de UPDATE.
- No se admiten cierres transitivos, pero se pueden obtener mediante CTE.
- Soporte limitado para objetos In-Memory OLTP.
- No se admiten tablas temporales (System-Versioned Temporal Table), tablas temporales locales y globales.
- Los tipos de tabla y las variables de tabla no pueden declararse como NODE o EDGE.
- No se admiten consultas entre bases de datos.
- No hay una forma directa o un asistente para convertir tablas normales en gráficas.
- No hay GUI para la visualización de gráficos, pero se puede usar Power BI.
Leer más:
Fuente: habr.com
