

La computación en la nube se está infiltrando cada vez más en nuestras vidas y probablemente no hay una sola persona que no haya utilizado algún servicio en la nube al menos una vez. Sin embargo, ¿qué es realmente la nube y cómo funciona? La mayoría de la gente apenas lo sabe, incluso a un nivel básico. El 5G ya se está convirtiendo en una realidad y la infraestructura de telecomunicaciones comienza a pasar de soluciones convencionales a soluciones en la nube, como ocurrió cuando nos movimos de soluciones puramente de hardware a 'pilares' virtualizados.
Hoy hablaremos sobre el mundo interno de la infraestructura en la nube, en particular abordaremos los fundamentos de la parte de red.
¿Qué es la nube? ¿Es la virtualización solo un aspecto?
Es una pregunta más que lógica. No, no es solo virtualización, aunque no puede existir sin ella. Consideremos dos definiciones:
La computación en la nube (en adelante, Nube) — es un modelo que proporciona a los usuarios un acceso conveniente a recursos computacionales distribuidos, que deben ser desplegados y ejecutados a demanda con la mínima latencia posible y con costos mínimos por parte del proveedor de servicios.
Virtualización — es la capacidad de dividir una entidad física (como un servidor) en varias virtuales, aumentando así la utilización de los recursos (por ejemplo, si tenías 3 servidores que estaban cargados al 25-30 por ciento, después de la virtualización obtienes 1 servidor que está cargado al 80-90 por ciento). Naturalmente, la virtualización consume parte de los recursos: necesitas alimentar el hipervisor, sin embargo, como ha demostrado la práctica, vale la pena. Un ejemplo ideal de virtualización es VMWare, que prepara virtual machines perfectamente, o KVM, que me gusta más, pero eso ya es cuestión de gustos.
Usamos la virtualización sin darnos cuenta; incluso los enrutadores físicos ya utilizan virtualización. Por ejemplo, en las últimas versiones de JunOS, el sistema operativo se instala como una máquina virtual sobre un distribuidor de Linux en tiempo real (Wind River 9). Pero la virtualización no es la nube, aunque la nube no puede existir sin virtualización.
La virtualización es uno de los ladrillos sobre los cuales se construye la nube.
Crear una nube simplemente reuniendo varios hipervisores en un mismo dominio L2, añadiendo un par de playbooks en yaml para la automatización de VLAN a través de algún ansible y encima de todo esto colocando algún tipo de sistema de orquestación para la creación automática de máquinas virtuales, no será posible. O mejor dicho, será posible, pero el Frankenstein resultante no es la nube que necesitamos, aunque para algunos esto podría ser el sueño hecho realidad. Además, si tomamos OpenStack, en esencia, sigue siendo un Frankenstein, pero dejemos eso por ahora.
Sin embargo, entiendo que a partir de la definición anterior no está del todo claro qué se puede llamar realmente una nube.
Por eso, el documento del NIST (Instituto Nacional de Estándares y Tecnología) presenta 5 características clave que debe tener una infraestructura en la nube:
Provisión de servicios bajo demanda. Se debe garantizar al usuario un acceso libre a los recursos computacionales que se le asignen (como redes, discos virtuales, memoria, núcleos de procesadores, etc.), y estos recursos deben ser proporcionados automáticamente, es decir, sin la intervención del proveedor de servicios.
Amplia disponibilidad del servicio. El acceso a los recursos debe proporcionarse mediante mecanismos estándar que permitan su uso tanto en PC estándar como en clientes ligeros y dispositivos móviles.
Agrupación de recursos en pools. Los pools de recursos deben permitir la provisión simultánea de recursos a varios clientes, garantizando la aislamiento de estos y evitando la competencia por recursos. Los pools incluyen también redes, lo que indica la posibilidad de utilizar direccionamiento cruzado. Deben soportar la escalabilidad bajo demanda. El uso de pools permite asegurar el nivel necesario de resiliencia de los recursos y la abstracción de los recursos físicos y virtuales: al beneficiario del servicio simplemente se le proporciona el conjunto de recursos que ha solicitado (donde están ubicados físicamente esos recursos, en cuántos servidores y switches, no le importa al cliente). Sin embargo, se debe tener en cuenta que el proveedor debe garantizar la reserva transparente de esos recursos.
Adaptación rápida a diversas condiciones. Los servicios deben ser flexibles: proporcionar recursos rápidamente, redistribuir, agregar o reducir recursos a pedido del cliente, y el cliente debe tener la sensación de que los recursos de la nube son infinitos. Para facilitar la comprensión, por ejemplo, no recibe advertencias de que ha perdido parte del espacio de disco en su Apple iCloud debido a que un disco duro en el servidor falló, y los discos duros fallan. Además, desde su perspectiva, las capacidades de este servicio son prácticamente ilimitadas: si necesita 2 TB, no hay problema, paga y los obtiene. Un ejemplo similar se puede encontrar con Google Drive o Yandex Disk.
La capacidad de medir el servicio proporcionado. Los sistemas en la nube deben controlar y optimizar automáticamente los recursos consumidos; estos mecanismos deben ser transparentes tanto para el usuario como para el proveedor de servicios. Es decir, siempre puede verificar cuántos recursos usted y sus clientes consumen.
Es importante tener en cuenta que estos requisitos son en su mayoría para nubes públicas, por lo que para nubes privadas (es decir, nubes ejecutadas para necesidades internas de la empresa), estos requisitos pueden ajustarse. Sin embargo, aún deben cumplirse; de lo contrario, no obtendremos todas las ventajas de la computación en la nube.
¿Por qué necesitamos la nube?
Sin embargo, cualquier tecnología nueva o ya existente, cualquier protocolo nuevo se crea para algo (excepto, por supuesto, RIP-ng). Un protocolo creado por el mero hecho de tenerlo no le sirve a nadie (excepto, por supuesto, RIP-ng). Es lógico que la nube se crea para proporcionar algún servicio al usuario/cliente. Todos estamos familiarizados con al menos un par de servicios de nube, como Dropbox o Google Docs, y supongo que la mayoría los utiliza con éxito; este artículo, por ejemplo, fue escrito utilizando el servicio en la nube Google Docs. Pero los servicios en la nube que conocemos son solo una parte de las posibilidades de la nube; más bien, son solo servicios del tipo SaaS. Podemos proporcionar un servicio en la nube de tres maneras: como SaaS, PaaS o IaaS. El tipo de servicio que usted necesita depende de sus deseos y posibilidades.
Analicemos cada uno en orden:
Software como Servicio (SaaS) — es un modelo de prestación de servicios completo al cliente, como un servicio de correo electrónico tipo Yandex.Mail o Gmail. En este modelo, usted, como cliente, no tiene que hacer nada más que utilizar el servicio; es decir, no necesita preocuparse por la configuración del servicio, su tolerancia a fallos o su respaldo. La clave es no comprometer su contraseña, el resto lo manejará el proveedor del servicio. Desde la perspectiva del proveedor, este es completamente responsable de todo el servicio, desde el hardware del servidor y los sistemas operativos de host, hasta la configuración de bases de datos y software.
Platform as a Service (PaaS) — al utilizar este modelo, el proveedor de servicios ofrece al cliente una plantilla para el servicio, por ejemplo, tomemos un servidor web. El proveedor de servicios ha proporcionado al cliente un servidor virtual (en realidad un conjunto de recursos, como RAM/CPU/Almacenamiento/Redes, etc.), e incluso instaló el sistema operativo y el software necesario en este servidor; sin embargo, la configuración de todo esto la realiza el cliente y el cliente es responsable del funcionamiento del servicio. El proveedor de servicios, al igual que en el caso anterior, es responsable del funcionamiento del hardware físico, de los hipervisores, de la propia máquina virtual, su disponibilidad en la red, etc., pero el servicio ya está fuera de su ámbito de responsabilidad.
Infrastructure as a Service (IaaS) — este enfoque es ya más interesante, ya que el proveedor de servicios ofrece al cliente una infraestructura virtualizada completa, es decir, un conjunto (pool) de recursos, como núcleos de CPU, RAM, Redes, etc. Todo lo demás es asunto del cliente: lo que quiera hacer el cliente con esos recursos dentro del pool (cuota) asignado no le interesa en gran medida al proveedor. Si el cliente quiere crear su propio vEPC o incluso convertirse en un mini operador y ofrecer servicios de telecomunicaciones, no hay problema, hágalo. En este escenario, el proveedor es responsable de proporcionar recursos, su tolerancia a fallos y disponibilidad, así como del sistema operativo que permite agrupar esos recursos y ofrecerlos al cliente con la posibilidad de aumentar o disminuir esos recursos a petición del cliente en cualquier momento. Todas las máquinas virtuales y otros detalles los configura el cliente a través del portal de autoservicio y la consola, incluida la configuración de redes (excepto las redes externas).
¿Qué es OpenStack?
En las tres opciones, el proveedor de servicios necesita un sistema operativo que permita crear la infraestructura en la nube. De hecho, en el modelo SaaS, no es una sola división la que se encarga de todo el stack tecnológico: hay una división responsable de la infraestructura, que proporciona IaaS a otra división, y esta última ofrece SaaS a los clientes. OpenStack es uno de los sistemas operativos en la nube que permite reunir varios switches, servidores y sistemas de almacenamiento en un único pool de recursos, dividir este pool común en subpools (tenants) y proporcionar estos recursos a los clientes a través de la red.
OpenStack es un sistema operativo en la nube que permite controlar grandes pools de recursos computacionales, almacenamiento de datos y recursos de red, cuyo aprovisionamiento y gestión se realiza a través de API utilizando mecanismos de autenticación estándar.
En otras palabras, es un conjunto de proyectos de software libre destinado a crear servicios en la nube (tanto públicos como privados), es decir, un conjunto de herramientas que permite combinar el hardware de servidores y conmutadores en un único pool de recursos, gestionar estos recursos y garantizar el nivel necesario de redundancia.
Al momento de redactar este material, la estructura de OpenStack es la siguiente:
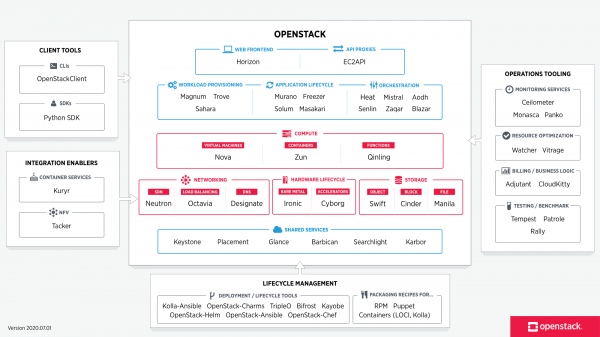
La imagen fue tomada de
Cada uno de los componentes que forman parte de OpenStack cumple una función específica. Esta arquitectura distribuida permite incluir en la solución solo el conjunto de componentes funcionales que se necesiten. Sin embargo, algunos de los componentes son fundamentales y su eliminación provocará la inoperatividad total o parcial de la solución en su conjunto. Los componentes considerados fundamentales son:
- Tablero — GUI basada en web para la gestión de los servicios de OpenStack
- Keystone — servicio centralizado de identificación que proporciona funcionalidad de autenticación y autorización para otros servicios, así como gestionar las credenciales de los usuarios y sus roles.
- Neutron — servicio de red que asegura la conectividad entre las interfaces de varios servicios de OpenStack (incluyendo la conectividad entre máquinas virtuales y su acceso al mundo exterior)
- Cinder — proporciona acceso a almacenamiento en bloques para máquinas virtuales
- Nova — gestión del ciclo de vida de máquinas virtuales
- Glance — repositorio de imágenes de máquinas virtuales y snapshots
- Swift — proporciona acceso al almacenamiento de objetos
- Ceilometer — servicio que permite la recopilación de telemetría y la medición de recursos disponibles y consumidos
- Heat — orquestación basada en plantillas para la creación automática y aprovisionamiento de recursos
Puede consultar la lista completa de todos los proyectos y su propósito .
Cada componente de OpenStack es un servicio responsable de una función específica y proporciona una API para gestionar esta función e interactuar con otros servicios del sistema operativo en la nube para crear una infraestructura unificada. Por ejemplo, Nova gestiona los recursos de computación y la API para configurar esos recursos, Glance gestiona las imágenes y la API para administrarlas, Cinder proporciona almacenamiento en bloques y la API para gestionarlo, etc. Todas las funciones están interconectadas de manera muy estrecha.
Sin embargo, si lo analizamos, todos los servicios que se ejecutan en OpenStack representan, en última instancia, alguna máquina virtual (o contenedor) conectada a la red. Surge la pregunta: ¿por qué necesitamos tantos elementos?
Vamos a repasar el algoritmo para crear una máquina virtual y conectarla a la red y al almacenamiento permanente en OpenStack.
- Cuando solicita la creación de una máquina, ya sea a través de Horizon (Dashboard) o mediante CLI, lo primero que sucede es la autorización de su solicitud en Keystone: si puede crear la máquina, si tiene derecho a utilizar esta red, si su proyecto tiene suficiente cuota, etc.
- Keystone autentica su solicitud y genera un token de autenticación en la respuesta, que se utilizará a continuación. Al recibir la respuesta de Keystone, la solicitud se envía a Nova (nova api).
- Nova-api verifica la validez de su solicitud consultando a Keystone, utilizando el token de autenticación previamente generado.
- Keystone autentica y proporciona, en función de este token de autenticación, información sobre permisos y restricciones.
- Nova-api crea un registro de la nueva VM en la base de datos de nova y envía la solicitud de creación de la máquina a nova-scheduler.
- El planificador de Nova selecciona el host (nodo de cómputo) en el que se desplegará la VM en función de los parámetros establecidos, los pesos y las zonas. Se registra esta información y se guarda el identificador de la VM en la base de datos de Nova.
- Luego, el planificador de Nova se comunica con nova-compute para solicitar el despliegue de una instancia. Nova-compute se dirige a nova-conductor para obtener información sobre los parámetros de la máquina (nova-conductor es un componente de Nova que actúa como servidor proxy entre la base de datos de Nova y nova-compute, limitando la cantidad de solicitudes hacia la base de datos de Nova para evitar problemas de consistencia de la base de datos y reducir la carga).
- Nova-conductor obtiene de la base de datos de Nova la información solicitada y la envía a nova-compute.
- A continuación, nova-compute se comunica con glance para obtener el ID de la imagen. Glance valida la solicitud en Keystone y devuelve la información solicitada.
- Nova-compute consulta a neutron para obtener información sobre los parámetros de la red. De manera similar a glance, neutron valida la solicitud en Keystone, después crea un registro en la base de datos (identificador del puerto, etc.), genera una solicitud para crear un puerto y devuelve la información solicitada a nova-compute.
- Nova-compute se comunica con cinder para solicitar la asignación de un volumen a la máquina virtual. De manera similar a glance, cinder valida la solicitud en Keystone, genera una solicitud para crear el volumen y devuelve la información solicitada.
- Nova-compute se comunica con libvirt para solicitar el despliegue de la máquina virtual con los parámetros especificados.
En realidad, lo que parece ser una operación sencilla para crear una máquina virtual simple se convierte en un torbellino de llamadas API entre los elementos de la plataforma en la nube. Además, como puede ver, incluso los servicios previamente mencionados también están compuestos por componentes más pequeños, entre los cuales se produce la interacción. La creación de una máquina es solo una pequeña parte de lo que permite hacer la plataforma en la nube: hay un servicio responsable de la equilibración del tráfico, un servicio encargado del almacenamiento en bloques, un servicio dedicado a DNS, un servicio para el aprovisionamiento de servidores bare metal, etc. La nube le permite tratar sus máquinas virtuales como un rebaño de ovejas (a diferencia de la virtualización). Si en un entorno virtual ocurre algo con la máquina, usted la recupera de las copias de seguridad, etc. Sin embargo, las aplicaciones en la nube están construidas de tal manera que la máquina virtual no juega un papel tan crucial: si la máquina virtual
Siempre debe tener en mente que no hay infraestructura en la nube sin red: cada elemento interactúa, de una forma u otra, con otros elementos a través de la red. Además, la nube tiene una red absolutamente no estática. Naturalmente, la red subyacente es más o menos estática; no se añaden nuevos nodos y conmutadores todos los días. Sin embargo, el componente de overlay puede y, inevitablemente, cambiará constantemente: se añadirán o eliminarán nuevas redes, aparecerán nuevas máquinas virtuales y morirán las viejas. Y como recuerda de la definición de la nube dada al principio del artículo, los recursos deben asignarse al usuario automáticamente y con la menor (o mejor, sin) intervención por parte del proveedor de servicios. Es decir, el tipo de provisión de recursos de red que existe ahora en forma de frontend en su panel de usuario accesible por http/https y el ingeniero de red de guardia Vasiliy como backend no es nube, incluso con Vasiliy teniendo ocho brazos.
Neutron, como servicio de red, proporciona una API para gestionar la parte de red de la infraestructura en la nube. El servicio asegura la funcionalidad y gestión de la red en OpenStack, proporcionando un nivel de abstracción conocido como Network-as-a-Service (NaaS). Es decir, la red es una unidad virtual medible, igual que los núcleos virtuales de CPU o la capacidad de RAM.
Pero antes de pasar a la arquitectura de la parte de red de OpenStack, veamos cómo funciona esta red en OpenStack y por qué la red es una parte importante e integral de la nube.
Así que tenemos dos máquinas virtuales del cliente RED y dos máquinas virtuales del cliente GREEN. Supongamos que estas máquinas están ubicadas en dos hipervisores de la siguiente manera:
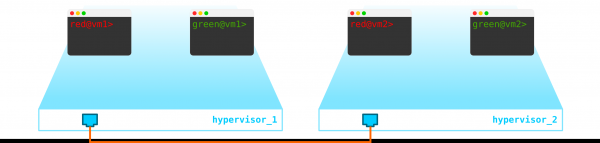
En este momento, esto es simplemente la virtualización de 4 servidores y no más, ya que hasta ahora solo hemos virtualizado 4 servidores, colocándolos en dos servidores físicos. Además, por el momento, ni siquiera están conectados a la red.
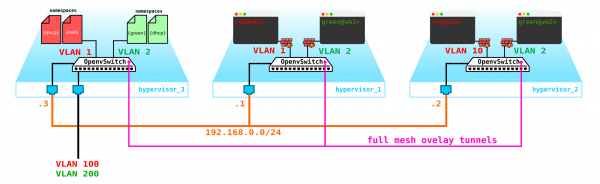
Para que tengamos una nube, necesitamos agregar algunos componentes. Primero, virtualicemos la parte de red: debemos conectar estas 4 máquinas en parejas, y los clientes quieren una conexión L2. Se puede utilizar un conmutador y configurarlo como trunk, gestionando todo mediante un puente de Linux, o para usuarios más avanzados, con Open vSwitch (a esto volveremos más adelante). Sin embargo, puede haber muchas redes, y constantemente empujar L2 a través del switch no es la mejor idea; así, diferentes departamentos, un servicio de asistencia, meses de espera para la ejecución de solicitudes, semanas de solución de problemas: en el mundo moderno, este enfoque ya no funciona. Y cuanto antes la empresa entienda esto, más fácil será avanzar. Por lo tanto, entre los hipervisores, asignaremos una red L3 a través de la cual se comunicarán nuestras máquinas virtuales, y sobre esta red L3 constructaremos redes L2 (overlay) virtuales, donde circulará el tráfico de nuestras máquinas virtuales. Para la encapsulación, se puede utilizar GRE, Geneve o VxLAN. Por ahora, nos detendremos en este último, aunque esto no es muy importante.
Necesitamos ubicar el VTEP en algún lugar (espero que todos estén familiarizados con la terminología de VxLAN). Dado que desde los servidores tenemos una red L3, nada nos impide ubicar el VTEP en los mismos servidores, y OVS (Open vSwitch) puede hacer esto muy bien. Al final, hemos conseguido esta construcción:
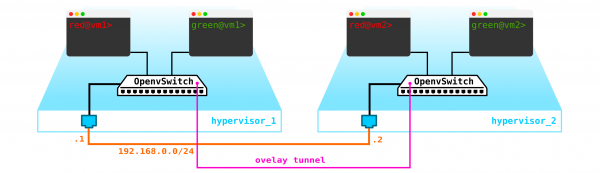
Dado que el tráfico entre las VM debe estar segregado, los puertos hacia las máquinas virtuales tendrán diferentes números de VLAN. El número de etiqueta solo es relevante dentro de un mismo conmutador virtual, ya que al encapsular en VxLAN podemos quitarlo sin problemas, ya que tendremos VNI.
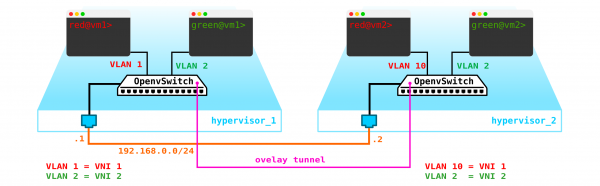
Ahora podemos crear nuestras máquinas y redes virtuales para ellas sin ningún problema.
Sin embargo, ¿qué pasa si el cliente tiene otra máquina, pero se encuentra en otra red? Necesitamos enrutamiento entre redes. Vamos a desglosar una opción sencilla, cuando se utiliza enrutamiento centralizado, es decir, el tráfico se enruta a través de nodos de red dedicados (que generalmente están combinados con nodos de control, por lo que será lo mismo).
Parece sencillo: creamos una interfaz de puente en el nodo de control, dirigimos el tráfico hacia ella y desde allí lo enrutamos a donde necesitamos. Pero el problema es que el cliente RED quiere usar la red 10.0.0.0/24, y el cliente GREEN quiere usar la red 10.0.0.0/24. Es decir, empezamos a tener una colisión de espacios de direcciones. Además, los clientes no quieren que otros clientes puedan enrutarse en sus redes internas, lo cual es lógico. Para separar las redes y el tráfico de datos de los clientes, asignaremos un namespace separado para cada uno de ellos. Un namespace es, de hecho, una copia de la pila de red de Linux, es decir, los clientes en el namespace RED están completamente aislados de los clientes en el namespace GREEN (o el enrutamiento entre estas redes de clientes está permitido a través del namespace por defecto o en el equipo de transporte superior).
Así que obtenemos un esquema como este:
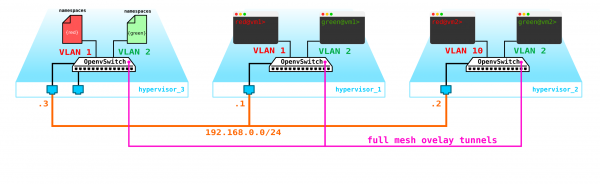
Los túneles L2 convergen desde todos los nodos de cómputo en el nodo de control, donde se encuentra la interfaz L3 para estas redes, cada una en un namespace dedicado para aislamiento.
Sin embargo, olvidamos lo más importante. La máquina virtual debe proporcionar un servicio al cliente, es decir, debe tener al menos una interfaz externa a través de la cual se pueda acceder a ella. Necesitamos salir al mundo exterior. Hay diferentes opciones. Haremos la opción más simple. Añadiremos una red a cada cliente, que será válida en la red del proveedor y no se cruzará con otras redes. Las redes también pueden ser superpuestas y mirar en diferentes VRF en el lado de la red del proveedor. Estas redes también vivirán en el espacio de nombres de cada uno de los clientes. Sin embargo, saldrán al mundo exterior a través de una única interfaz física (o de enlace, que es más lógico). Para separar el tráfico de los clientes, el tráfico que sale al exterior se etiquetará con el tag VLAN asignado al cliente.
Como resultado, obtuvimos el siguiente esquema:
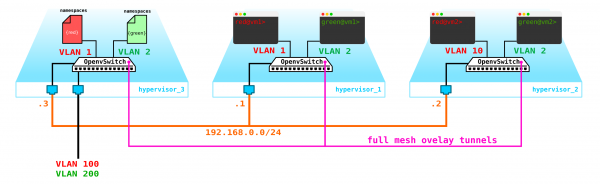
Una pregunta razonable: ¿por qué no hacer las puertas de enlace en las propias nodos de cómputo? Esto no representa un gran problema, de hecho, al activar el enrutador distribuido (DVR) funcionará así. En este escenario estamos considerando la opción más simple con una puerta de enlace centralizada, que se usa por defecto en Openstack. Para funciones de alta carga, se utilizarán tanto el enrutador distribuido como tecnologías de aceleración como SR-IOV y Passthrough, pero como se dice, esa es otra historia. Primero, abordemos la parte básica y luego iremos a los detalles.
Nuestra esquema ya es funcional, sin embargo, hay un par de matices:
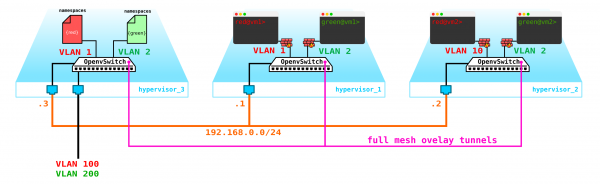
- Necesitamos proteger nuestras máquinas de alguna manera, es decir, colocar un filtro en la interfaz del switch hacia el cliente.
- Habilitar la posibilidad de que la máquina virtual obtenga automáticamente la dirección IP, para no tener que ingresar cada vez a través de la consola y escribir la dirección.
Comencemos con la protección de las máquinas. Para esto se pueden utilizar iptables, ¿por qué no?
Es decir, ahora nuestra topología se ha vuelto un poco más compleja:
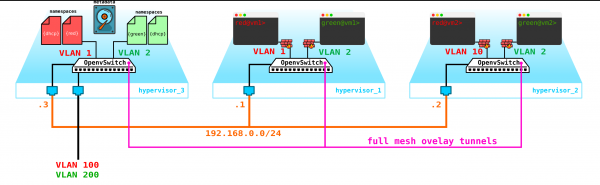
Sigamos adelante. Necesitamos añadir un servidor DHCP. El lugar más adecuado para ubicar los servidores DHCP de cada cliente será el nodo de control mencionado anteriormente, donde se encuentran los espacios de nombres:
Sin embargo, hay un pequeño problema. ¿Qué pasa si todo se reinicia y se pierde toda la información sobre la asignación de direcciones en DHCP? Es lógico que se asignen nuevas direcciones a las máquinas, lo cual no es muy conveniente. Hay dos soluciones: utilizar nombres de dominio y añadir un servidor DNS para cada cliente, de modo que la dirección no sea muy importante para nosotros (similar a la parte de red en k8s); sin embargo, hay un problema con las redes externas, ya que en ellas también se pueden asignar direcciones por DHCP, lo que requiere sincronización entre los servidores DNS de la plataforma en la nube y el servidor DNS externo, lo cual, en mi opinión, no es muy flexible, aunque es completamente posible. La segunda opción es utilizar metadatos, es decir, guardar información sobre la dirección de la máquina asignada para que el servidor DHCP sepa qué dirección asignar a la máquina si ya había recibido una dirección. La segunda opción es más sencilla y flexible, ya que permite conservar información adicional sobre la máquina. Ahora añadiremos el agente de metadatos al esquema:
Otra cuestión que también merece atención es la posibilidad de que todos los clientes utilicen una única red externa, ya que si las redes externas deben ser válidas en toda la red, habrá complicaciones: será necesario asignarlas constantemente y controlar su asignación. La posibilidad de utilizar una red externa preconfigurada y única para todos los clientes será muy bienvenida al crear una nube pública. Esto simplificará el despliegue de máquinas, ya que no tendremos que compararnos con la base de datos de direcciones y seleccionar un espacio de direcciones único para la red externa de cada cliente. Además, podemos definir la red externa de antemano y, en el momento del despliegue, solo tendremos que asociar las direcciones externas con las máquinas de los clientes.
Aquí es donde entra en juego el NAT: simplemente haremos posible que los clientes accedan al mundo exterior a través del espacio de nombres predeterminado utilizando la traducción NAT. Pero aquí hay un pequeño problema. Es bueno si el servidor del cliente actúa como cliente y no como servidor, es decir, inicia las conexiones en lugar de aceptarlas. Pero en nuestro caso será al revés. En ese caso, necesitamos realizar NAT de destino, para que al recibir el tráfico, el nodo de control entienda que este tráfico está destinado a la máquina virtual A del cliente A, y por lo tanto necesitamos hacer la traducción NAT de una dirección externa, como 100.1.1.1, a una dirección interna 10.0.0.1. De esta manera, aunque todos los clientes utilizarán la misma red, la separación interna se mantiene completamente. Es decir, necesitamos implementar dNAT y sNAT en el nodo de control. Utilizar una única red con direcciones flotantes o redes externas, o ambas a la vez, depende de lo que desee lograr en la nube. No añadiremos direcciones flotantes al esquema, sino que mantendremos las redes externas ya añadidas anteriormente: cada cliente tiene su propia red externa (en el esquema se indican como VLAN 100 y 200 en la interfaz externa).
En resumen, hemos conseguido una solución interesante y, al mismo tiempo, bien pensada, que posee una cierta flexibilidad, pero aún carece de mecanismos de redundancia.
En primer lugar, solo tenemos un nodo de control: si falla, todos los sistemas colapsarán. Para resolver este problema, es necesario crear al menos un quórum de 3 nodos. Añadiremos esto al esquema:
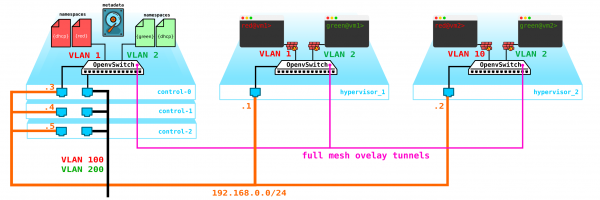
Por supuesto, todos los nodos se sincronizan y, si el nodo activo falla, otro nodo asumirá sus funciones.
El siguiente problema son los discos de las máquinas virtuales. En este momento, se almacenan en los propios hipervisores y, en caso de problemas con el hipervisor, perdemos todos los datos; y tener RAID aquí no ayuda si perdemos no solo un disco, sino todo el servidor. Para esto, necesitamos crear un servicio que actúe como frontend para algún tipo de almacenamiento. No importa mucho cuál será este almacenamiento, pero debe proteger nuestros datos de fallos tanto del disco como de la nodo, y posiblemente hasta de todo el armario. Hay varias opciones; por supuesto, existen redes SAN con Fiber Channel, pero seamos honestos: FC es ya un vestigio del pasado, como el E1 en el transporte; sí, está todavía en uso, pero solo donde es absolutamente necesario. Por eso, desplegar voluntariamente una red FC en 2020 no lo haría, sabiendo que hay otras alternativas más interesantes. Aunque cada uno a su manera y puede que haya quienes consideren que FC, con todas sus limitaciones, es exactamente lo que necesitamos; no voy a discutir, cada uno tiene su opinión. Sin embargo, la solución más interesante, en mi opinión, es el uso de SDS, como Ceph.
Ceph permite construir una solución de alta disponibilidad para el almacenamiento de datos con muchas opciones de redundancia, desde códigos con verificación de paridad (análogos a RAID 5 o 6) hasta replicación completa de datos en diferentes discos, considerando la ubicación de los discos en los servidores y los servidores en los armarios, etc.
Para montar Ceph, se necesitan otras 3 nodos. La interacción con el almacenamiento también se realizará a través de la red utilizando servicios de almacenamiento en bloques, objetos y archivos. Añadiremos al esquema de almacenamiento:
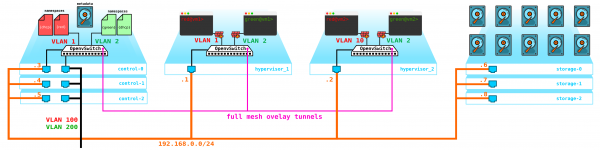
Nota: se pueden hacer nodos de computación hiperconvergentes; este es un concepto que combina varias funciones en un mismo nodo, por ejemplo, almacenamiento + computación; no es necesario dedicar nodos especiales para el almacenamiento Ceph. Obtendremos un esquema de alta disponibilidad, ya que SDS reserva los datos con el nivel de redundancia que especificamos. Sin embargo, los nodos hiperconvergentes siempre implican un compromiso, dado que el nodo de almacenamiento no solo ocupa espacio como puede parecer a primera vista (ya que no tiene máquinas virtuales); consume recursos de CPU para el mantenimiento de SDS (de hecho, en segundo plano realiza todas las replicaciones, recuperaciones de fallos de nodos, discos, etc.). Esto significa que perderá parte de la capacidad del nodo de computación si lo combina con almacenamiento.
Todo esto necesita ser gestionado de alguna manera; necesitamos algo que nos permita crear una máquina, una red, un enrutador virtual, etc. Para esto, agregaremos un servicio en el nodo de control que actuará como un panel de control; el cliente podrá conectarse a este portal a través de http/https y hacer lo que necesite (bueno, casi todo).
Como resultado, ahora tenemos un sistema de alta disponibilidad. Todos los elementos de esta infraestructura necesitan ser gestionados. Se ha mencionado anteriormente que OpenStack es un conjunto de proyectos, cada uno de los cuales proporciona una función específica. Como podemos ver, hay más que suficientes elementos que necesitan configuración y control. Hoy hablaremos sobre la parte de red.
Arquitectura de Neutron
En OpenStack, Neutron es el responsable de conectar los puertos de las máquinas virtuales a la red L2 común, asegurando el enrutamiento del tráfico entre VM ubicadas en diferentes redes L2 y también el enrutamiento hacia el exterior, proporcionando servicios como NAT, IP flotante, DHCP, etc.
El funcionamiento a alto nivel del servicio de red (parte básica) se puede describir así.
Al iniciar una VM, el servicio de red:
- Crea un puerto para esta VM (o puertos) y notifica al servicio DHCP;
- Se crea un nuevo dispositivo de red virtual (a través de libvirt);
- La VM se conecta al puerto creado en el paso 1 (puertos);
Curiosamente, la base del funcionamiento de Neutron se basa en mecanismos estándares conocidos por todos los que alguna vez se han sumergido en Linux: namespaces, iptables, puentes de Linux, openvswitch, conntrack, etc.
Es importante aclarar de inmediato que Neutron no es un controlador SDN.
Neutron consta de varios componentes interrelacionados:
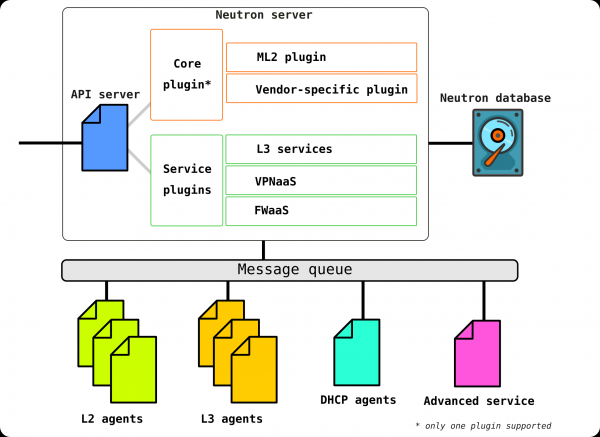
openstack-neutron-server es un demonio que trabaja con solicitudes de usuarios a través de API. Este demonio no se encarga de la configuración de conexiones de red, sino que proporciona la información necesaria a sus complementos, que luego configuran el elemento de red requerido. Los agentes de Neutron en los nodos de OpenStack se registran en el servidor de Neutron.
Neutron-server es, de hecho, una aplicación escrita en python, compuesta por dos partes:
- Servicio REST
- Plugin de Neutron (núcleo / servicio)
El servicio REST está destinado a recibir llamadas API de otros componentes (por ejemplo, solicitudes para proporcionar cierta información, etc.).
Los complementos son componentes / módulos de software que se invocan durante las solicitudes API, es decir, la incorporación de un servicio ocurre a través de ellos. Los complementos se dividen en dos tipos: de servicio y de núcleo. Por lo general, el complemento de núcleo se encarga principalmente de la gestión del espacio de direcciones y conexiones L2 entre las VM, mientras que los complementos de servicio ofrecen funcionalidades adicionales, como VPN o FW.
Se puede ver la lista de complementos disponibles hoy en día, por ejemplo,
Puede haber varios complementos de servicio, sin embargo, solo puede haber un complemento de núcleo.
Openstack-neutron-ml2 es el complemento de núcleo estándar de Openstack. Este complemento tiene una arquitectura modular (a diferencia de su predecesor) y, a través de los controladores que se le conectan, configura el servicio de red. Consideraremos el complemento más adelante, ya que, de hecho, ofrece la flexibilidad que posee OpenStack en la parte de red. El complemento de núcleo puede ser reemplazado (por ejemplo, Contrail Networking reemplaza este).
Servicio RPC (rabbitmq-server) es un servicio que proporciona la gestión de colas e interacción con otros servicios de OpenStack, así como la interacción entre los agentes del servicio de red.
Agentes de red son agentes que se encuentran en cada nodo, a través de los cuales se configura los servicios de red.
Los agentes pueden ser de varios tipos.
El agente principal es el agente L2. Estos agentes se ejecutan en cada uno de los hipervisores, incluyendo los nodos de control (más precisamente en todos los nodos que ofrecen algún servicio a los inquilinos) y su función principal es conectar máquinas virtuales a la red L2 común, así como generar alertas en caso de que ocurran eventos (como la desconexión/conexión de un puerto).
El siguiente agente, no menos importante, es agente L3. Por defecto, este agente se ejecuta exclusivamente en el nodo de red (a menudo el nodo de red se combina con el nodo de control) y proporciona enrutamiento entre las redes de los inquilinos (tanto entre sus redes y las de otros inquilinos, como también acceso al mundo exterior, proporcionando NAT y un servicio DHCP). Sin embargo, al utilizar DVR (enrutador distribuido), la necesidad de un plugin L3 también surge en los nodos de cómputo.
El agente L3 utiliza espacios de nombres de Linux para proporcionar a cada inquilino un conjunto de redes aisladas propias y la funcionalidad de enrutadores virtuales, que enrutan el tráfico y proporcionan servicios de puerta de enlace para redes de nivel 2.
Base de datos — base de datos de identificadores de redes, subredes, puertos, grupos, etc.
De hecho, Neutron recibe solicitudes API para la creación de cualquier entidad de red, autentica la solicitud, y a través de RPC (si se dirige a algún plugin o agente) o REST API (si se comunica en SDN) envía a los agentes (a través de plugins) las instrucciones necesarias para organizar el servicio solicitado.
Ahora vamos a la instalación de prueba (como se implementó y qué contiene veremos más adelante en la parte práctica) y veamos dónde se encuentra cada componente:
(overcloud) [stack@undercloud ~]$ openstack network agent list
+--------------------------------------+--------------------+-------------------------------------+-------------------+-------+-------+---------------------------+
| ID                                   | Agent Type         | Host                                | Availability Zone | Alive | State | Binary                    |
+--------------------------------------+--------------------+-------------------------------------+-------------------+-------+-------+---------------------------+
| 10495de9-ba4b-41fe-b30a-b90ec3f8728b | Agente de Open vSwitch | overcloud-novacompute-1.localdomain | Ninguno            | :-)   | ACTIVO | neutron-openvswitch-agent |
| 1515ad4a-5972-46c3-af5f-e5446dff7ac7 | Agente L3          | overcloud-controller-0.localdomain  | nova              | :-)   | ACTIVO | neutron-l3-agent          |
| 322e62ca-1e5a-479e-9a96-4f26d09abdd7 | Agente DHCP        | overcloud-controller-0.localdomain  | nova              | :-)   | ACTIVO | neutron-dhcp-agent        |
| 9c1de2f9-bac5-400e-998d-4360f04fc533 | Agente de Open vSwitch | overcloud-novacompute-0.localdomain | Ninguno            | :-)   | ACTIVO | neutron-openvswitch-agent |
| d99c5657-851e-4d3c-bef6-f1e3bb1acfb0 | Agente de Open vSwitch | overcloud-controller-0.localdomain  | Ninguno            | :-)   | ACTIVO | neutron-openvswitch-agent |
| ff85fae6-5543-45fb-a301-19c57b62d836 | Agente de Metadatos | overcloud-controller-0.localdomain  | Ninguno            | :-)   | ACTIVO | neutron-metadata-agent    |
+--------------------------------------+--------------------+-------------------------------------+-------------------+-------+-------+---------------------------+
(overcloud) [stack@undercloud ~]$ 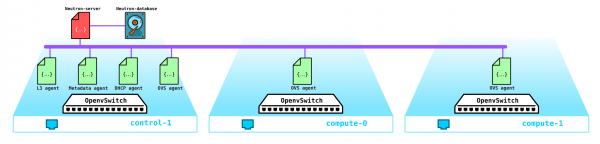
Así que esta es toda la estructura de Neutron. Ahora vale la pena dedicar un tiempo al plugin ML2.
Capa Modular 2
Como se mencionó anteriormente, el plugin es el plugin raíz estándar de OpenStack y tiene una arquitectura modular.
El predecesor del plugin ML2 tenía una estructura monolítica que no permitía, por ejemplo, utilizar una mezcla de varias tecnologías en una sola instalación. Por ejemplo, no podía utilizar openvswitch y linuxbridge al mismo tiempo: solo uno de los dos. Por esta razón se creó el plugin ML2 con su arquitectura.
ML2 tiene dos componentes: dos tipos de controladores: Controladores de Tipo y Controladores de Mecanismo.
Controladores de Tipo definen las tecnologías que se utilizarán para organizar las conexiones de red, por ejemplo, VxLAN, VLAN, GRE. A su vez, el controlador permite utilizar diferentes tecnologías. La tecnología estándar es la encapsulación VxLAN para redes overlay y vlan para redes externas.
Los siguientes tipos de redes son Controladores de Tipo:
Plano — red sin etiquetado
VLAN — red etiquetada
Local — un tipo especial de red para instalaciones tipo all-in-one (estas instalaciones son necesarias ya sea para desarrolladores o para formación)
GRE — red overlay que utiliza túneles GRE
VxLAN — red overlay que utiliza túneles VxLAN
Controladores de Mecanismo definen los medios que aseguran la organización de las tecnologías especificadas en el tipo de controlador, como openvswitch, sr-iov, opendaylight, OVN, etc.
Dependiendo de la implementación de este controlador, se utilizarán agentes gestionados por Neutron o se establecerán conexiones con un controlador SDN externo que se encargue de todas las cuestiones relacionadas con la organización de redes L2, enrutamiento, etc.
Por ejemplo, si usamos ML2 junto con OVS, se instalará un agente L2 en cada nodo computacional que gestiona OVS. Sin embargo, si usamos, por ejemplo, OVN o OpenDayLight, la gestión de OVS pasa a su jurisdicción: Neutron, a través del complemento raíz, da órdenes al controlador, que luego ejecuta lo que se le ha indicado.
Recordemos Open vSwitch
Actualmente, uno de los componentes clave de OpenStack es Open vSwitch.
Al instalar OpenStack sin ningún SDN de un vendedor adicional como Juniper Contrail o Nokia Nuage, OVS es el componente de red principal de la red en la nube y, en conjunto con iptables, conntrack y namespaces, permite organizar redes de superposición completas con multitenencia. Por supuesto, este componente puede ser reemplazado, por ejemplo, al utilizar soluciones SDN propietarias de terceros.
OVS es un conmutador de software de código abierto diseñado para su uso en entornos virtualizados como un reenvío virtual de tráfico.
Actualmente, OVS cuenta con un funcionalismo bastante decente, que incluye tecnologías como QoS, LACP, VLAN, VxLAN, GENEVE, OpenFlow, DPDK, etc.
Nota: inicialmente, OVS no fue concebido como un conmutador de software para funciones de telecomunicaciones de alta carga y estaba más orientado a funciones de TI que requieren menos ancho de banda, como servidores WEB o servidores de correo. Sin embargo, OVS ha sido mejorado y las implementaciones actuales de OVS han mejorado drásticamente su rendimiento y capacidades, lo que permite su uso por operadores de telecomunicaciones con funciones de alta carga; por ejemplo, existe una implementación de OVS con soporte de aceleración DPDK.
Hay tres componentes importantes de OVS que deben conocerse:
- Módulo de Kernel — componente ubicado en el espacio de kernel que realiza el procesamiento del tráfico basado en las reglas recibidas del elemento de control;
- vSwitch El daemon (ovs-vswitchd) es un proceso que se ejecuta en el espacio de usuario, responsable de programar el módulo del núcleo, es decir, representa la lógica de funcionamiento del conmutador.
- Servidor de base de datos — una base de datos local ubicada en cada host donde se ejecuta OVS, que almacena la configuración. A través de este módulo, los controladores SDN pueden comunicarse mediante el protocolo OVSDB.
Todo esto viene acompañado de un conjunto de utilidades de diagnóstico y gestión, tales como ovs-vsctl, ovs-appctl, ovs-ofctl, etc.
En la actualidad, Openstack es ampliamente utilizado por operadores de telecomunicaciones para migrar funciones de red como EPC, SBC, HLR, etc. Algunas funciones pueden coexistir sin problemas con OVS tal como está, pero por ejemplo, EPC maneja el tráfico de los suscriptores, es decir, procesa una enorme cantidad de tráfico (actualmente los volúmenes de tráfico alcanzan varios cientos de gigabits por segundo). Naturalmente, dirigir tal tráfico a través del espacio del núcleo (ya que por defecto el reenvío se encuentra en ese espacio) no es la mejor idea. Por lo tanto, a menudo OVS se despliega completamente en el espacio de usuario utilizando la tecnología de aceleración DPDK para hacer pasar el tráfico desde la NIC al espacio de usuario, eludiendo el núcleo.
Nota: para la nube desplegada para funciones de telecomunicaciones, existe la opción de enviar tráfico desde el nodo de cómputo, eludiendo OVS directamente hacia el equipo de conmutación. Para este propósito se utilizan los mecanismos SR-IOV y Passthrough.
¿Cómo funciona esto en un modelo real?
Ahora pasemos a la parte práctica y veamos cómo funciona todo esto en la práctica.
Para empezar, desplegaremos una simple instalación de Openstack. Dado que no tengo un conjunto de servidores a mano para experimentar, construiremos el modelo en un solo servidor físico utilizando máquinas virtuales. Sí, naturalmente, para fines comerciales, esta solución no es adecuada, pero para ver cómo funciona la red en una instalación de Openstack, es suficiente. Además, esta instalación para fines educativos es incluso más interesante, ya que se puede capturar el tráfico, etc.
Dado que solo necesitamos ver la parte básica, no es necesario utilizar varias redes, sino que podemos levantar todo utilizando solo dos redes, y la segunda red en este modelo se usará exclusivamente para el acceso a undercloud y al servidor DNS. Por ahora no abordaremos las redes externas; ese es un tema para un artículo grande separado.
Entonces, comencemos por el principio. Primero un poco de teoría. Vamos a instalar OpenStack utilizando TripleO (OpenStack sobre OpenStack). La esencia de TripleO es que instalamos OpenStack all-in-one (es decir, en un solo nodo), llamado undercloud, y luego utilizamos las capacidades del OpenStack desplegado para instalar el OpenStack destinado a la producción, llamado overcloud. Undercloud utilizará la funcionalidad integrada para gestionar servidores físicos (bare metal) — el proyecto Ironic — para aprovisionar hipervisor que desempeñarán los roles de nodos de computación, control y almacenamiento. Es decir, no utilizamos ninguna herramienta externa para desplegar OpenStack — desplegamos OpenStack con los propios recursos de OpenStack. A medida que avanzamos en la instalación, se volverá mucho más claro, así que no nos detengamos en esto y sigamos adelante.
Nota: En este artículo, para simplificar, no utilicé la isolación de red para las redes internas de OpenStack, y todo se desplegó usando una sola red. Sin embargo, la presencia o ausencia de aislamiento de redes no afecta la funcionalidad básica de la solución: todo funcionará exactamente igual que si se utilizara aislamiento, pero el tráfico se trasladará en una sola red. Para una instalación comercial, naturalmente es necesario usar aislamiento con diferentes VLAN y interfaces. Por ejemplo, el tráfico de gestión del almacenamiento Ceph y el tráfico de datos directos (las consultas de las máquinas a los discos, etc.) utilizarían diferentes subredes (Gestión de almacenamiento y Almacenamiento) al estar aislados, lo que permite que la solución sea más resistente, dividiendo este tráfico, por ejemplo, en diferentes puertos, o utilizando diferentes perfiles QoS para distintos tipos de tráfico, para que el tráfico de datos no ahogue el tráfico de señalización. En nuestro caso, sin embargo, estarán en la misma red y, de hecho, eso no nos limita de ninguna manera.
Nota: Dado que vamos a ejecutar máquinas virtuales en un entorno virtual basado en máquinas virtuales, primero debemos habilitar la virtualización anidada.
Para verificar si la virtualización anidada está habilitada o no, se puede hacer así:
[root@hp-gen9 bormoglotx]# cat /sys/module/kvm_intel/parameters/nested
N
[root@hp-gen9 bormoglotx]#
Si ves la letra N, entonces debes habilitar el soporte para la virtualización anidada siguiendo cualquier guía que encuentres en Internet, por ejemplo: .
Necesitamos construir un esquema como el siguiente de máquinas virtuales:
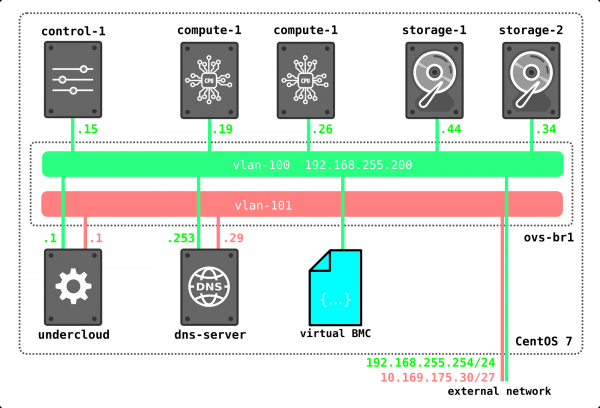
En mi caso, para la conectividad de las máquinas virtuales que formarían parte de la futura instalación (tengo 7, pero se puede manejar con 4 si no tienes muchos recursos), utilicé OpenvSwitch. Creé un puente OVS y conecté las máquinas virtuales a él a través de port-groups. Para esto, creé un archivo XML de la siguiente manera:
[root@hp-gen9 ~]# virsh net-dumpxml ovs-network-1

  ovs-network-1
  7a2e7de7-fc16-4e00-b1ed-4d190133af67
Aquí se declaran tres grupos de puertos: dos access y uno trunk (este último era necesario para el servidor DNS, pero se puede prescindir de él o levantarlo en la máquina host, como prefieras). A continuación, utilizando esta plantilla, definimos nuestra red con virsh net-define:
virsh net-define ovs-network-1.xml
virsh net-start ovs-network-1
virsh net-autostart ovs-network-1
Ahora ajustamos las configuraciones de los puertos del hipervisor:
[root@hp-gen9 ~]# cat /etc/sysconfig/network-scripts/ifcfg-ens1f0
TYPE=Ethernet
NAME=ens1f0
DEVICE=ens1f0
TYPE=OVSPort
DEVICETYPE=ovs
OVS_BRIDGE=ovs-br1
ONBOOT=yes
OVS_OPTIONS="trunk=100,101,102"
[root@hp-gen9 ~]
[root@hp-gen9 ~]# cat /etc/sysconfig/network-scripts/ifcfg-ovs-br1
DEVICE=ovs-br1
DEVICETYPE=ovs
TYPE=OVSBridge
BOOTPROTO=static
ONBOOT=yes
IPADDR=192.168.255.200
PREFIX=24
[root@hp-gen9 ~]#
Nota: en este escenario, la dirección en el puerto ovs-br1 no estará disponible, ya que no tiene etiqueta VLAN. Para corregir esto, debes ejecutar el comando sudo ovs-vsctl set port ovs-br1 tag=100. Sin embargo, después de reiniciar, esta etiqueta desaparecerá (si alguien sabe cómo hacer que permanezca, estaría muy agradecido). Pero eso no es tan importante, ya que esta dirección solo la necesitaremos durante la instalación y no será necesaria cuando OpenStack esté completamente desplegado.
A continuación, creamos la máquina undercloud:
virt-install -n undercloud --description "undercloud" --os-type=Linux --os-variant=centos7.0 --ram=8192 --vcpus=8 --disk path=/var/lib/libvirt/images/undercloud.qcow2,bus=virtio,size=40,format=qcow2 --network network:ovs-network-1,model=virtio,portgroup=access-100 --network network:ovs-network-1,model=virtio,portgroup=access-101 --graphics none --location /var/lib/libvirt/boot/CentOS-7-x86_64-Minimal-2003.iso --extra-args console=ttyS0Durante la instalación, especifique todos los parámetros necesarios, como el nombre de la máquina, contraseñas, usuarios, servidores NTP, etc. También puede configurar los puertos de inmediato, pero personalmente me resulta más fácil entrar en la máquina a través de la consola y ajustar los archivos necesarios después de la instalación. Si ya tiene una imagen lista, puede usarla, o puede hacer como yo: descargar una imagen mínima de CentOS 7 y utilizarla para instalar la VM.
Después de una instalación exitosa, debería aparecer una máquina virtual en la que se puede instalar el undercloud.
[root@hp-gen9 bormoglotx]# virsh list
 Id    Name                           State
----------------------------------------------------
 6     dns-server                     running
 62    undercloud                     running
Primero instalamos las herramientas necesarias para el proceso de instalación:
sudo yum update -y
sudo yum install -y net-tools
sudo yum install -y wget
sudo yum install -y ipmitool
Instalación de Undercloud
Creamos el usuario stack, establecemos una contraseña, lo añadimos al grupo sudo y le damos la posibilidad de ejecutar comandos de root a través de sudo sin necesidad de ingresar la contraseña:
useradd stack
passwd stack

echo "stack ALL=(root) NOPASSWD:ALL" > /etc/sudoers.d/stack
chmod 0440 /etc/sudoers.d/stack
Ahora indicamos en el archivo hosts el nombre completo del undercloud:
vi /etc/hosts

127.0.0.1   undercloud.openstack.rnd localhost localhost.localdomain localhost4 localhost4.localdomain4
::1         localhost localhost.localdomain localhost6 localhost6.localdomain6
A continuación, agregamos los repositorios e instalamos el software necesario:
sudo yum install -y https://trunk.rdoproject.org/centos7/current/python2-tripleo-repos-0.0.1-0.20200409224957.8bac392.el7.noarch.rpm
sudo -E tripleo-repos -b queens current
sudo -E tripleo-repos -b queens current ceph
sudo yum install -y python-tripleoclient
sudo yum install -y ceph-ansible
Nota: si no planea instalar ceph, entonces no introduzca los comandos relacionados con ceph. Yo utilicé la versión Queens, pero puede usar cualquier otra que le guste.
Luego copiamos el archivo de configuración del undercloud al directorio personal del usuario stack:
cp /usr/share/instack-undercloud/undercloud.conf.sample ~/undercloud.confAhora es necesario modificar este archivo, ajustándolo a nuestra instalación.
Al principio del archivo, hay que añadir las siguientes líneas:
vi undercloud.conf
[DEFAULT]
undercloud_hostname = undercloud.openstack.rnd
local_ip = 192.168.255.1/24
network_gateway = 192.168.255.1
undercloud_public_host = 192.168.255.2
undercloud_admin_host = 192.168.255.3
undercloud_nameservers = 192.168.255.253
generate_service_certificate = false
local_interface = eth0
local_mtu = 1450
network_cidr = 192.168.255.0/24
masquerade = true
masquerade_network = 192.168.255.0/24
dhcp_start = 192.168.255.11
dhcp_end = 192.168.255.50
inspection_iprange = 192.168.255.51,192.168.255.100
scheduler_max_attempts = 10
Así que, revisemos la configuración:
undercloud_hostname — el nombre completo del servidor undercloud, debe coincidir con la entrada en el servidor DNS
local_ip — dirección local del undercloud hacia la red de aprovisionamiento
network_gateway — esta misma dirección local servirá como gateway para acceder al mundo exterior durante la instalación de nodos overcloud, también coincide con la ip local
undercloud_public_host — dirección externa de la API, se puede asignar cualquier dirección libre de la red de aprovisionamiento
undercloud_admin_host dirección interna de la API, se puede asignar cualquier dirección libre de la red de aprovisionamiento
undercloud_nameservers — servidor DNS
generate_service_certificate — esta línea es muy importante en el ejemplo actual, ya que si no se establece en false, recibirás un error al instalar, el problema está descrito en el rastreador de errores de Red Hat
local_interface interfaz en la red de aprovisionamiento. Esta interfaz será reconfigurada durante el despliegue del undercloud, por lo que el undercloud necesita tener dos interfaces: una para acceder a él y otra para el aprovisionamiento
local_mtu — MTU. Dado que tenemos un laboratorio de prueba y mi MTU es 1500 en los puertos del switch OVS, debe establecerse en 1450 para que puedan pasar los paquetes encapsulados en VxLAN
network_cidr — red de aprovisionamiento
masquerade — uso de NAT para acceso a la red exterior
masquerade_network — red que será NATeada
dhcp_start — dirección inicial del pool de direcciones, desde el cual se asignarán direcciones a los nodos durante el despliegue del overcloud
dhcp_end — dirección final del pool de direcciones, desde el cual se asignarán direcciones a los nodos durante el despliegue del overcloud
inspection_iprange — pool de direcciones necesarias para realizar la introspección (no debe cruzarse con el pool mencionado anteriormente)
scheduler_max_attempts — número máximo de intentos para instalar el overcloud (debe ser mayor o igual a la cantidad de nodos)
Después de que se ha descrito el archivo, se puede dar la orden para desplegar el undercloud:
openstack undercloud install
El procedimiento dura entre 10 y 30 minutos, dependiendo de tu hardware. Al final, deberías ver la siguiente salida:
vi undercloud.conf
2020-08-13 23:13:12,668 INFO:
#############################################################################
Instalación del undercloud completa.

El archivo que contiene las contraseñas de esta instalación está en
/home/stack/undercloud-passwords.conf.

También hay un archivo stackrc en /home/stack/stackrc.

Estos archivos son necesarios para interactuar con los servicios de OpenStack y deben ser
asegurados.

#############################################################################
Esta salida indica que has instalado con éxito el undercloud y ahora puedes verificar el estado del undercloud y proceder con la instalación del overcloud.
Si miras la salida de ifconfig, verás que ha aparecido una nueva interfaz de puente.
[stack@undercloud ~]$ ifconfig
br-ctlplane: flags=4163  mtu 1450
        inet 192.168.255.1  netmask 255.255.255.0  broadcast 192.168.255.255
        inet6 fe80::5054:ff:fe2c:89e  prefixlen 64  scopeid 0x20
        ether 52:54:00:2c:08:9e  txqueuelen 1000  (Ethernet)
        RX packets 14  bytes 1095 (1.0 KiB)
        RX errors 0  dropped 0  overruns 0  frame 0
        TX packets 20  bytes 1292 (1.2 KiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
A través de esta interfaz ahora se realizará el trabajo de despliegue de overcloud.
En la salida a continuación, se puede ver que todos los servicios están en un solo nodo:
(undercloud) [stack@undercloud ~]$ openstack host list
+--------------------------+-----------+----------+
| Host Name                | Service   | Zone     |
+--------------------------+-----------+----------+
| undercloud.openstack.rnd | conductor | internal |
| undercloud.openstack.rnd | scheduler | internal |
| undercloud.openstack.rnd | compute   | nova     |
+--------------------------+-----------+----------+
A continuación se muestra la configuración de la parte de red de undercloud:
(undercloud) [stack@undercloud ~]$ python -m json.tool /etc/os-net-config/config.json
{
    "network_config": [
        {
            "addresses": [
                {
                    "ip_netmask": "192.168.255.1/24"
                }
            ],
            "members": [
                {
                    "dns_servers": [
                        "192.168.255.253"
                    ],
                    "mtu": 1450,
                    "name": "eth0",
                    "primary": "true",
                    "type": "interface"
                }
            ],
            "mtu": 1450,
            "name": "br-ctlplane",
            "ovs_extra": [
                "br-set-external-id br-ctlplane bridge-id br-ctlplane"
            ],
            "routes": [],
            "type": "ovs_bridge"
        }
    ]
}
(undercloud) [stack@undercloud ~]$
Instalación de overcloud
En este momento solo tenemos undercloud, y nos faltan los nodos de los que se formará overcloud. Por lo tanto, lo primero que haremos es desplegar las máquinas virtuales que necesitamos. Durante el despliegue, undercloud instalará el sistema operativo y el software necesario en las máquinas de overcloud — es decir, no necesitamos desplegar completamente la máquina, solo crear el disco (o discos) para ella y definir sus parámetros — por lo tanto, en realidad obtenemos un servidor vacío sin un sistema operativo instalado.
Pasamos a la carpeta con los discos de nuestras máquinas virtuales y crearemos discos del tamaño necesario:
cd /var/lib/libvirt/images/
qemu-img create -f qcow2 -o preallocation=metadata control-1.qcow2 60G
qemu-img create -f qcow2 -o preallocation=metadata compute-1.qcow2 60G
qemu-img create -f qcow2 -o preallocation=metadata compute-2.qcow2 60G
qemu-img create -f qcow2 -o preallocation=metadata storage-1.qcow2 160G
qemu-img create -f qcow2 -o preallocation=metadata storage-2.qcow2 160G
Dado que estamos actuando como root, necesitamos cambiar la propiedad de estos discos para no tener problemas de permisos:
[root@hp-gen9 images]# ls -lh
total 5.8G
drwxr-xr-x. 2 qemu qemu 4.0K Aug 13 16:15 backups
-rw-r--r--. 1 root root  61G Aug 14 03:07 compute-1.qcow2
-rw-r--r--. 1 root root  61G Aug 14 03:07 compute-2.qcow2
-rw-r--r--. 1 root root  61G Aug 14 03:07 control-1.qcow2
-rw-------. 1 qemu qemu  41G Aug 14 03:03 dns-server.qcow2
-rw-r--r--. 1 root root 161G Aug 14 03:07 storage-1.qcow2
-rw-r--r--. 1 root root 161G Aug 14 03:07 storage-2.qcow2
-rw-------. 1 qemu qemu  41G Aug 14 03:07 undercloud.qcow2
[root@hp-gen9 images]#
[root@hp-gen9 images]#
[root@hp-gen9 images]# chown qemu:qemu \/var\lib\libvirt\images\*qcow2
[root@hp-gen9 images]# ls -lh
total 5.8G
drwxr-xr-x. 2 qemu qemu 4.0K Aug 13 16:15 backups
-rw-r--r--. 1 qemu qemu  61G Aug 14 03:07 compute-1.qcow2
-rw-r--r--. 1 qemu qemu  61G Aug 14 03:07 compute-2.qcow2
-rw-r--r--. 1 qemu qemu  61G Aug 14 03:07 control-1.qcow2
-rw-------. 1 qemu qemu  41G Aug 14 03:03 dns-server.qcow2
-rw-r--r--. 1 qemu qemu 161G Aug 14 03:07 storage-1.qcow2
-rw-r--r--. 1 qemu qemu 161G Aug 14 03:07 storage-2.qcow2
-rw-------. 1 qemu qemu  41G Aug 14 03:08 undercloud.qcow2
[root@hp-gen9 images]#
Nota: si no planeas instalar Ceph con fines de aprendizaje, entonces no crees al menos 3 nodos con al menos dos discos, y en la plantilla indica que se utilizarán discos virtuales vda, vdb, etc.
Muy bien, ahora necesitamos definir todas estas máquinas:
virt-install --name control-1 --ram 32768 --vcpus 8 --os-variant centos7.0 --disk path=\/var\/lib\/libvirt\/images\/control-1.qcow2,device=disk,bus=virtio,format=qcow2 --noautoconsole --vnc  --network network:ovs-network-1,model=virtio,portgroup=access-100 --network network:ovs-network-1,model=virtio,portgroup=trunk-1 --dry-run --print-xml > \/tmp\/control-1.xml

virt-install --name storage-1 --ram 16384 --vcpus 4 --os-variant centos7.0 --disk path=\/var\/lib\/libvirt\/images\/storage-1.qcow2,device=disk,bus=virtio,format=qcow2 --noautoconsole --vnc  --network network:ovs-network-1,model=virtio,portgroup=access-100 --dry-run --print-xml > \/tmp\/storage-1.xml

virt-install --name storage-2 --ram 16384 --vcpus 4 --os-variant centos7.0 --disk path=\/var\/lib\/libvirt\/images\/storage-2.qcow2,device=disk,bus=virtio,format=qcow2 --noautoconsole --vnc  --network network:ovs-network-1,model=virtio,portgroup=access-100 --dry-run --print-xml > \/tmp\/storage-2.xml

virt-install --name compute-1 --ram 32768 --vcpus 12 --os-variant centos7.0 --disk path=\/var\/lib\/libvirt\/images\/compute-1.qcow2,device=disk,bus=virtio,format=qcow2 --noautoconsole --vnc  --network network:ovs-network-1,model=virtio,portgroup=access-100 --dry-run --print-xml > \/tmp\/compute-1.xml

virt-install --name compute-2 --ram 32768 --vcpus 12 --os-variant centos7.0 --disk path=\/var\/lib\/libvirt\/images\/compute-2.qcow2,device=disk,bus=virtio,format=qcow2 --noautoconsole --vnc  --network network:ovs-network-1,model=virtio,portgroup=access-100 --dry-run --print-xml > \/tmp\/compute-2.xml
Al final hay comandos —print-xml > \/tmp\/storage-1.xml, que crean un archivo xml con la descripción de cada máquina en la carpeta \/tmp\/, si no se añade, no podrás definir las máquinas virtuales.
Ahora necesitamos definir todas estas máquinas en virsh:
virsh define --file /tmp/control-1.xml
virsh define --file /tmp/compute-1.xml
virsh define --file /tmp/compute-2.xml
virsh define --file /tmp/storage-1.xml
virsh define --file /tmp/storage-2.xml

[root@hp-gen9 ~]# virsh list --all
 Id    Name                           Estado
----------------------------------------------------
 6     dns-server                     en ejecución
 64    undercloud                     en ejecución
 -     compute-1                      apagado
 -     compute-2                      apagado
 -     control-1                      apagado
 -     storage-1                      apagado
 -     storage-2                      apagado

[root@hp-gen9 ~]#
Ahora un pequeño matiz: tripleO utiliza IPMI para gestionar los servidores durante la instalación e introspección.
La introspección es el proceso de inspección del hardware para obtener sus parámetros, necesarios para el aprovisionamiento posterior de los nodos. La introspección se realiza mediante ironic, un servicio destinado a trabajar con servidores bare metal.
Aquí surge un problema: si en los servidores físicos el IPMI es un puerto separado (o un puerto compartido, pero eso no es lo principal), en las máquinas virtuales no hay tales puertos. Aquí nos ayuda un truco llamado vbmc, una herramienta que permite emular un puerto IPMI. Este matiz merece especial atención, especialmente para aquellos que quieran crear un laboratorio así en el hipervisor ESXI; sinceramente, no sé si hay un análogo de vbmc en él, así que es mejor preocuparse por esto antes de desplegar todo.
Instalamos vbmc:
yum install python2-virtualbmcSi su sistema operativo no puede encontrar el paquete, añada el repositorio:
yum install -y https://www.rdoproject.org/repos/rdo-release.rpmAhora configuramos la herramienta. Aquí todo es banal hasta el extremo. Ahora es lógico que en la lista de vbmc no haya servidores.
[root@hp-gen9 ~]# vbmc list

[root@hp-gen9 ~]#
Para que aparezcan, es necesario declararlos manualmente de la siguiente manera:
[root@hp-gen9 ~]# vbmc add control-1 --port 7001 --username admin --password admin
[root@hp-gen9 ~]# vbmc add storage-1 --port 7002 --username admin --password admin
[root@hp-gen9 ~]# vbmc add storage-2 --port 7003 --username admin --password admin
[root@hp-gen9 ~]# vbmc add compute-1 --port 7004 --username admin --password admin
[root@hp-gen9 ~]# vbmc add compute-2 --port 7005 --username admin --password admin
[root@hp-gen9 ~]#
[root@hp-gen9 ~]# vbmc list
+-------------+--------+---------+------+
| Nombre de dominio | Estado | Dirección | Puerto |
+-------------+--------+---------+------+
| compute-1   | apagado | ::      | 7004 |
| compute-2   | apagado | ::      | 7005 |
| control-1   | apagado | ::      | 7001 |
| storage-1   | apagado | ::      | 7002 |
| storage-2   | apagado | ::      | 7003 |
+-------------+--------+---------+------+
[root@hp-gen9 ~]#
Creo que la sintaxis del comando es comprensible sin explicaciones. Sin embargo, por ahora, todas nuestras sesiones están en estado APAGADO. Para que pasen al estado ENCENDIDO, es necesario activarlas:
[root@hp-gen9 ~]# vbmc start control-1
2020-08-14 03:15:57,826.826 13149 INFO VirtualBMC [-] Instancia de vBMC iniciada para el dominio control-1
[root@hp-gen9 ~]# vbmc start storage-1
2020-08-14 03:15:58,316.316 13149 INFO VirtualBMC [-] Instancia de vBMC iniciada para el dominio storage-1
[root@hp-gen9 ~]# vbmc start storage-2
2020-08-14 03:15:58,851.851 13149 INFO VirtualBMC [-] Instancia de vBMC iniciada para el dominio storage-2
[root@hp-gen9 ~]# vbmc start compute-1
2020-08-14 03:15:59,307.307 13149 INFO VirtualBMC [-] Instancia de vBMC iniciada para el dominio compute-1
[root@hp-gen9 ~]# vbmc start compute-2
2020-08-14 03:15:59,712.712 13149 INFO VirtualBMC [-] Instancia de vBMC iniciada para el dominio compute-2
[root@hp-gen9 ~]#
[root@hp-gen9 ~]#
[root@hp-gen9 ~]# vbmc list
+-------------+---------+---------+------+
| Nombre de dominio | Estado  | Dirección | Puerto |
+-------------+---------+---------+------+
| compute-1   | en ejecución | ::      | 7004 |
| compute-2   | en ejecución | ::      | 7005 |
| control-1   | en ejecución | ::      | 7001 |
| storage-1   | en ejecución | ::      | 7002 |
| storage-2   | en ejecución | ::      | 7003 |
+-------------+---------+---------+------+
[root@hp-gen9 ~]#
Y el último toque: es necesario ajustar las reglas del firewall (o desactivarlo por completo):
firewall-cmd --zone=public --add-port=7001/udp --permanent
firewall-cmd --zone=public --add-port=7002/udp --permanent
firewall-cmd --zone=public --add-port=7003/udp --permanent
firewall-cmd --zone=public --add-port=7004/udp --permanent
firewall-cmd --zone=public --add-port=7005/udp --permanent
firewall-cmd --reload
Ahora vamos a entrar en undercloud y verificar que todo funcione. La dirección de la máquina host es 192.168.255.200, en undercloud hemos añadido el paquete necesario ipmitool durante la preparación para el despliegue:
[stack@undercloud ~]$ ipmitool -I lanplus -U admin -P admin -H 192.168.255.200 -p 7001 power status
El poder del chasis está apagado
[stack@undercloud ~]$ ipmitool -I lanplus -U admin -P admin -H 192.168.255.200 -p 7001 power on
Control de poder del chasis: Encendido
[stack@undercloud ~]$

[root@hp-gen9 ~]# virsh list
 Id    Nombre                           Estado
----------------------------------------------------
 6     dns-server                     en ejecución
 64    undercloud                     en ejecución
 65    control-1                      en ejecución
Como pueden ver, hemos iniciado exitosamente el nodo de control a través de vbmc. Ahora lo apagaremos y continuaremos:
[stack@undercloud ~]$ ipmitool -I lanplus -U admin -P admin -H 192.168.255.200 -p 7001 power off
Control de poder del chasis: Apagado
[stack@undercloud ~]$ ipmitool -I lanplus -U admin -P admin -H 192.168.255.200 -p 7001 power status
El poder del chasis está apagado
[stack@undercloud ~]$

[root@hp-gen9 ~]# virsh list --all
 Id    Nombre                           Estado
----------------------------------------------------
 6     dns-server                     en ejecución
 64    undercloud                     en ejecución
 -     compute-1                      apagado
 -     compute-2                      apagado
 -     control-1                      apagado
 -     storage-1                      apagado
 -     storage-2                      apagado

[root@hp-gen9 ~]#
El siguiente paso es la introspección de los nodos en los que se instalará overcloud. Para ello, necesitamos preparar un archivo json que describa nuestros nodos. Tenga en cuenta que a diferencia de la instalación en servidores desnudos, en el archivo se indica el puerto en el que se está ejecutando vbmc para cada una de las máquinas.
[root@hp-gen9 ~]# virsh domiflist --domain control-1
Interface  Tipo       Fuente     Modelo       MAC
-------------------------------------------------------
-          red        ovs-network-1 virtio      52:54:00:20:a2:2f
-          red        ovs-network-1 virtio      52:54:00:3f:87:9f

[root@hp-gen9 ~]# virsh domiflist --domain compute-1
Interface  Tipo       Fuente     Modelo       MAC
-------------------------------------------------------
-          red        ovs-network-1 virtio      52:54:00:98:e9:d6

[root@hp-gen9 ~]# virsh domiflist --domain compute-2
Interface  Tipo       Fuente     Modelo       MAC
-------------------------------------------------------
-          red        ovs-network-1 virtio      52:54:00:6a:ea:be

[root@hp-gen9 ~]# virsh domiflist --domain storage-1
Interface  Tipo       Fuente     Modelo       MAC
-------------------------------------------------------
-          red        ovs-network-1 virtio      52:54:00:79:0b:cb

[root@hp-gen9 ~]# virsh domiflist --domain storage-2
Interface  Tipo       Fuente     Modelo       MAC
-------------------------------------------------------
-          red        ovs-network-1 virtio      52:54:00:a7:fe:27
Nota: en el nodo de control hay dos interfaces, pero en este caso no es importante, en esta instalación nos será suficiente con una.
Ahora preparamos el archivo json. Debemos especificar la dirección MAC del puerto a través del cual se realizará el aprovisionamiento, los parámetros de los nodos, asignarles nombres y especificar cómo acceder a ipmi:
{
    "nodes":[
        {
            "mac":[
                "52:54:00:20:a2:2f"
            ],
            "cpu":"8",
            "memory":"32768",
            "disk":"60",
            "arch":"x86_64",
            "name":"control-1",
            "pm_type":"pxe_ipmitool",
            "pm_user":"admin",
            "pm_password":"admin",
            "pm_addr":"192.168.255.200",
            "pm_port":"7001"
        },
        {
            "mac":[
                "52:54:00:79:0b:cb"
            ],
            "cpu":"4",
            "memory":"16384",
            "disk":"160",
            "arch":"x86_64",
            "name":"storage-1",
            "pm_type":"pxe_ipmitool",
            "pm_user":"admin",
            "pm_password":"admin",
            "pm_addr":"192.168.255.200",
            "pm_port":"7002"
        },
        {
            "mac":[
                "52:54:00:a7:fe:27"
            ],
            "cpu":"4",
            "memory":"16384",
            "disk":"160",
            "arch":"x86_64",
            "name":"storage-2",
            "pm_type":"pxe_ipmitool",
            "pm_user":"admin",
            "pm_password":"admin",
            "pm_addr":"192.168.255.200",
            "pm_port":"7003"
        },
        {
            "mac":[
                "52:54:00:98:e9:d6"
            ],
            "cpu":"12",
            "memory":"32768",
            "disk":"60",
            "arch":"x86_64",
            "name":"compute-1",
            "pm_type":"pxe_ipmitool",
            "pm_user":"admin",
            "pm_password":"admin",
            "pm_addr":"192.168.255.200",
            "pm_port":"7004"
        },
        {
            "mac":[
                "52:54:00:6a:ea:be"
            ],
            "cpu":"12",
            "memory":"32768",
            "disk":"60",
            "arch":"x86_64",
            "name":"compute-2",
            "pm_type":"pxe_ipmitool",
            "pm_user":"admin",
            "pm_password":"admin",
            "pm_addr":"192.168.255.200",
            "pm_port":"7005"
        }
    ]
}
Ahora necesitamos preparar las imágenes para ironic. Para ello, las descargamos a través de wget e instalamos:
(undercloud) [stack@undercloud ~]$ sudo wget https://images.rdoproject.org/queens/delorean/current-tripleo-rdo/overcloud-full.tar --no-check-certificate
(undercloud) [stack@undercloud ~]$ sudo wget https://images.rdoproject.org/queens/delorean/current-tripleo-rdo/ironic-python-agent.tar --no-check-certificate
(undercloud) [stack@undercloud ~]$ ls -lh
total 1.9G
-rw-r--r--. 1 stack stack 447M Aug 14 10:26 ironic-python-agent.tar
-rw-r--r--. 1 stack stack 1.5G Aug 14 10:26 overcloud-full.tar
-rw-------. 1 stack stack  916 Aug 13 23:10 stackrc
-rw-r--r--. 1 stack stack  15K Aug 13 22:50 undercloud.conf
-rw-------. 1 stack stack 2.0K Aug 13 22:50 undercloud-passwords.conf
(undercloud) [stack@undercloud ~]$ mkdir images/
(undercloud) [stack@undercloud ~]$ tar -xpvf ironic-python-agent.tar -C ~/images/
ironic-python-agent.initramfs
ironic-python-agent.kernel
(undercloud) [stack@undercloud ~]$ tar -xpvf overcloud-full.tar -C ~/images/
overcloud-full.qcow2
overcloud-full.initrd
overcloud-full.vmlinuz
(undercloud) [stack@undercloud ~]$
(undercloud) [stack@undercloud ~]$ ls -lh images/
total 1.9G
-rw-rw-r--. 1 stack stack 441M Aug 12 17:24 ironic-python-agent.initramfs
-rwxr-xr-x. 1 stack stack 6.5M Aug 12 17:24 ironic-python-agent.kernel
-rw-r--r--. 1 stack stack  53M Aug 12 17:14 overcloud-full.initrd
-rw-r--r--. 1 stack stack 1.4G Aug 12 17:18 overcloud-full.qcow2
-rwxr-xr-x. 1 stack stack 6.5M Aug 12 17:14 overcloud-full.vmlinuz
(undercloud) [stack@undercloud ~]$
Cargando imágenes en undercloud:
(undercloud) [stack@undercloud ~]$ openstack overcloud image upload --image-path ~\/images\/
La imagen "overcloud-full-vmlinuz" ha sido cargada.
+--------------------------------------+------------------------+-------------+---------+--------+
|                  ID                  |          Nombre        | Formato de Disco |   Tamaño  | Estado |
+--------------------------------------+------------------------+-------------+---------+--------+
| c2553770-3e0f-4750-b46b-138855b5c385 | overcloud-full-vmlinuz |     aki     | 6761064 | activo |
+--------------------------------------+------------------------+-------------+---------+--------+
La imagen "overcloud-full-initrd" ha sido cargada.
+--------------------------------------+-----------------------+-------------+----------+--------+
|                  ID                  |          Nombre       | Formato de Disco |   Tamaño   | Estado |
+--------------------------------------+-----------------------+-------------+----------+--------+
| 949984e0-4932-4e71-af43-d67a38c3dc89 | overcloud-full-initrd |     ari     | 55183045 | activo |
+--------------------------------------+-----------------------+-------------+----------+--------+
La imagen "overcloud-full" ha sido cargada.
+--------------------------------------+----------------+-------------+------------+--------+
|                  ID                  |      Nombre          | Formato de Disco |    Tamaño    | Estado |
+--------------------------------------+----------------+-------------+------------+--------+
| a2f2096d-c9d7-429a-b866-c7543c02a380 | overcloud-full      |    qcow2    | 1487475712 | activo |
+--------------------------------------+----------------+-------------+------------+--------+
La imagen "bm-deploy-kernel" ha sido cargada.
+--------------------------------------+------------------+-------------+---------+--------+
|                  ID                  |       Nombre        | Formato de Disco |   Tamaño  | Estado |
+--------------------------------------+------------------+-------------+---------+--------+
| e413aa78-e38f-404c-bbaf-93e582a8e67f | bm-deploy-kernel   |     aki     | 6761064 | activo |
+--------------------------------------+------------------+-------------+---------+--------+
La imagen "bm-deploy-ramdisk" ha sido cargada.
+--------------------------------------+-------------------+-------------+-----------+--------+
|                  ID                  |        Nombre       | Formato de Disco |    Tamaño   | Estado |
+--------------------------------------+-------------------+-------------+-----------+--------+
| 5cf3aba4-0e50-45d3-929f-27f025dd6ce3 | bm-deploy-ramdisk  |     ari     | 461759376 | activo |
+--------------------------------------+-------------------+-------------+-----------+--------+
(undercloud) [stack@undercloud ~]$
Verificamos que todas las imágenes se hayan cargado
(undercloud) [stack@undercloud ~]$  openstack image list
+--------------------------------------+------------------------+--------+
| ID                                   | Nombre                 | Estado |
+--------------------------------------+------------------------+--------+
| e413aa78-e38f-404c-bbaf-93e582a8e67f | bm-deploy-kernel        | activo |
| 5cf3aba4-0e50-45d3-929f-27f025dd6ce3 | bm-deploy-ramdisk       | activo |
| a2f2096d-c9d7-429a-b866-c7543c02a380 | overcloud-full          | activo |
| 949984e0-4932-4e71-af43-d67a38c3dc89 | overcloud-full-initrd   | activo |
| c2553770-3e0f-4750-b46b-138855b5c385 | overcloud-full-vmlinuz  | activo |
+--------------------------------------+------------------------+--------+
(undercloud) [stack@undercloud ~]$
Un último toque — hay que agregar el servidor DNS:
(undercloud) [stack@undercloud ~]$ openstack subnet list
+--------------------------------------+-----------------+--------------------------------------+------------------+
| ID                                   | Nombre          | Red                                  | Subred           |
+--------------------------------------+-----------------+--------------------------------------+------------------+
| f45dea46-4066-42aa-a3c4-6f84b8120cab | ctlplane-subnet | 6ca013dc-41c2-42d8-9d69-542afad53392 | 192.168.255.0/24 |
+--------------------------------------+-----------------+--------------------------------------+------------------+
(undercloud) [stack@undercloud ~]$ openstack subnet show f45dea46-4066-42aa-a3c4-6f84b8120cab
+-------------------+-----------------------------------------------------------+
| Campo             | Valor                                                     |
+-------------------+-----------------------------------------------------------+
| pools_de_asignación | 192.168.255.11-192.168.255.50                           |
| cidr              | 192.168.255.0/24                                          |
| creado_en         | 2020-08-13T20:10:37Z                                      |
| descripción       |                                                           |
| servidores_dns     |                                                           |
| habilitar_dhcp    | True                                                      |
| gateway_ip        | 192.168.255.1                                             |
| rutas_host        | destino='169.254.169.254/32', gateway='192.168.255.1'   |
| id                | f45dea46-4066-42aa-a3c4-6f84b8120cab                      |
| version_ip        | 4                                                         |
| modo_direccion_ipv6 | Ninguno                                                  |
| modo_ra_ipv6     | Ninguno                                                  |
| nombre            | ctlplane-subnet                                           |
| id_red            | 6ca013dc-41c2-42d8-9d69-542afad53392                      |
| longitud_prefijo  | Ninguno                                                  |
| id_proyecto       | a844ccfcdb2745b198dde3e1b28c40a3                          |
| numero_revision    | 0                                                         |
| id_segmento       | Ninguno                                                  |
| tipos_servicio    |                                                           |
| id_subredpool     | Ninguno                                                  |
| etiquetas         |                                                           |
| actualizado_en    | 2020-08-13T20:10:37Z                                      |
+-------------------+-----------------------------------------------------------+
(undercloud) [stack@undercloud ~]$
(undercloud) [stack@undercloud ~]$ neutron subnet-update f45dea46-4066-42aa-a3c4-6f84b8120cab --dns-nameserver 192.168.255.253
neutron CLI está en desuso y será eliminado en el futuro. Use openstack CLI en su lugar.
Subred actualizada: f45dea46-4066-42aa-a3c4-6f84b8120cab
(undercloud) [stack@undercloud ~]$
Ahora podemos dar el comando para la introspección:
(undercloud) [stack@undercloud ~]$ openstack overcloud node import --introspect --provide inspection.json
Se inició el flujo de trabajo de Mistral tripleo.baremetal.v1.register_or_update. ID de ejecución: d57456a3-d8ed-479c-9a90-dff7c752d0ec
Esperando mensajes en la cola 'tripleo' sin tiempo de espera.


5 nodo(s) trasladados con éxito al estado "gestionable".
Nodo UUID b4b2cf4a-b7ca-4095-af13-cc83be21c4f5 registrado con éxito.
Nodo UUID b89a72a3-6bb7-429a-93bc-48393d225838 registrado con éxito.
Nodo UUID 20a16cc0-e0ce-4d88-8f17-eb0ce7b4d69e registrado con éxito.
Nodo UUID bfc1eb98-a17a-4a70-b0b6-6c0db0eac8e8 registrado con éxito.
Nodo UUID 766ab623-464c-423d-a529-d9afb69d1167 registrado con éxito.
Esperando que la introspección termine...
Se inició el flujo de trabajo de Mistral tripleo.baremetal.v1.introspect. ID de ejecución: 6b4d08ae-94c3-4a10-ab63-7634ec198a79
Esperando mensajes en la cola 'tripleo' sin tiempo de espera.
La introspección del nodo b89a72a3-6bb7-429a-93bc-48393d225838 se completó. Estado: ÉXITO. Errores: Ninguno.
La introspección del nodo 20a16cc0-e0ce-4d88-8f17-eb0ce7b4d69e se completó. Estado: ÉXITO. Errores: Ninguno.
La introspección del nodo bfc1eb98-a17a-4a70-b0b6-6c0db0eac8e8 se completó. Estado: ÉXITO. Errores: Ninguno.
La introspección del nodo 766ab623-464c-423d-a529-d9afb69d1167 se completó. Estado: ÉXITO. Errores: Ninguno.
La introspección del nodo b4b2cf4a-b7ca-4095-af13-cc83be21c4f5 se completó. Estado: ÉXITO. Errores: Ninguno.
Se introspeccionaron 5 nodo(s) con éxito.
Se inició el flujo de trabajo de Mistral tripleo.baremetal.v1.provide. ID de ejecución: f5594736-edcf-4927-a8a0-2a7bf806a59a
Esperando mensajes en la cola 'tripleo' sin tiempo de espera.
5 nodo(s) trasladados con éxito al estado "disponible".
(undercloud) [stack@undercloud ~]$
Como se puede ver en la salida, todo terminó sin errores. Verifiquemos que todos los nodos están en estado disponible:
(undercloud) [stack@undercloud ~]$ openstack baremetal node list
+--------------------------------------+-----------+---------------+-------------+--------------------+-------------+
| UUID                                 | Nombre     | UUID de instancia | Estado de energía | Estado de aprovisionamiento | Mantenimiento |
+--------------------------------------+-----------+---------------+-------------+--------------------+-------------+
| b4b2cf4a-b7ca-4095-af13-cc83be21c4f5 | control-1 | Ninguno       | apagado     | disponible          | Falso       |
| b89a72a3-6bb7-429a-93bc-48393d225838 | almacenamiento-1 | Ninguno    | apagado     | disponible          | Falso       |
| 20a16cc0-e0ce-4d88-8f17-eb0ce7b4d69e | almacenamiento-2 | Ninguno    | apagado     | disponible          | Falso       |
| bfc1eb98-a17a-4a70-b0b6-6c0db0eac8e8 | computación-1 | Ninguno    | apagado     | disponible          | Falso       |
| 766ab623-464c-423d-a529-d9afb69d1167 | computación-2 | Ninguno    | apagado     | disponible          | Falso       |
+--------------------------------------+-----------+---------------+-------------+--------------------+-------------+
(undercloud) [stack@undercloud ~]$
Si los nodos están en otro estado, generalmente 'gestionable', entonces algo salió mal y debes revisar el registro para averiguar por qué ocurrió eso. Ten en cuenta que en este escenario estamos usando virtualización y puede haber errores relacionados con el uso de máquinas virtuales o vbmc.
A continuación, debemos indicar qué nodo desempeñará qué función, es decir, especificar el perfil con el que se desplegará el nodo:
(undercloud) [stack@undercloud ~]$ openstack overcloud profiles list
+--------------------------------------+-----------+-----------------+-----------------+-------------------+
| Node UUID                            | Node Name | Provision State | Current Profile | Possible Profiles |
+--------------------------------------+-----------+-----------------+-----------------+-------------------+
| b4b2cf4a-b7ca-4095-af13-cc83be21c4f5 | control-1 | disponible      | Ninguno         |                   |
| b89a72a3-6bb7-429a-93bc-48393d225838 | storage-1 | disponible      | Ninguno         |                   |
| 20a16cc0-e0ce-4d88-8f17-eb0ce7b4d69e | storage-2 | disponible      | Ninguno         |                   |
| bfc1eb98-a17a-4a70-b0b6-6c0db0eac8e8 | compute-1 | disponible      | Ninguno         |                   |
| 766ab623-464c-423d-a529-d9afb69d1167 | compute-2 | disponible      | Ninguno         |                   |
+--------------------------------------+-----------+-----------------+-----------------+-------------------+
(undercloud) [stack@undercloud ~]$ openstack flavor list
+--------------------------------------+---------------+------+------+-----------+-------+-----------+
| ID                                   | Nombre        |  RAM | Disco | Efímero   | VCPUs | Es Público |
+--------------------------------------+---------------+------+------+-----------+-------+-----------+
| 168af640-7f40-42c7-91b2-989abc5c5d8f | swift-storage | 4096 |   40 |         0 |     1 | Verdadero  |
| 52148d1b-492e-48b4-b5fc-772849dd1b78 | baremetal     | 4096 |   40 |         0 |     1 | Verdadero  |
| 56e66542-ae60-416d-863e-0cb192d01b09 | control       | 4096 |   40 |         0 |     1 | Verdadero  |
| af6796e1-d0c4-4bfe-898c-532be194f7ac | block-storage | 4096 |   40 |         0 |     1 | Verdadero  |
| e4d50fdd-0034-446b-b72c-9da19b16c2df | compute       | 4096 |   40 |         0 |     1 | Verdadero  |
| fc2e3acf-7fca-4901-9eee-4a4d6ef0265d | ceph-storage  | 4096 |   40 |         0 |     1 | Verdadero  |
+--------------------------------------+---------------+------+------+-----------+-------+-----------+
(undercloud) [stack@undercloud ~]$
Especificamos el perfil para cada nodo:
openstack baremetal node set --property capabilities='profile:control,boot_option:local' b4b2cf4a-b7ca-4095-af13-cc83be21c4f5
openstack baremetal node set --property capabilities='profile:ceph-storage,boot_option:local' b89a72a3-6bb7-429a-93bc-48393d225838
openstack baremetal node set --property capabilities='profile:ceph-storage,boot_option:local' 20a16cc0-e0ce-4d88-8f17-eb0ce7b4d69e
openstack baremetal node set --property capabilities='profile:compute,boot_option:local' bfc1eb98-a17a-4a70-b0b6-6c0db0eac8e8
openstack baremetal node set --property capabilities='profile:compute,boot_option:local' 766ab623-464c-423d-a529-d9afb69d1167
Verificamos que hemos hecho todo correctamete:
(undercloud) [stack@undercloud ~]$ openstack overcloud profiles list
+--------------------------------------+-----------+-----------------+-----------------+-------------------+
| Node UUID                            | Node Name | Provision State | Current Profile | Possible Profiles |
+--------------------------------------+-----------+-----------------+-----------------+-------------------+
| b4b2cf4a-b7ca-4095-af13-cc83be21c4f5 | control-1 | available       | control         |                   |
| b89a72a3-6bb7-429a-93bc-48393d225838 | storage-1 | available       | ceph-storage    |                   |
| 20a16cc0-e0ce-4d88-8f17-eb0ce7b4d69e | storage-2 | available       | ceph-storage    |                   |
| bfc1eb98-a17a-4a70-b0b6-6c0db0eac8e8 | compute-1 | available       | compute         |                   |
| 766ab623-464c-423d-a529-d9afb69d1167 | compute-2 | available       | compute         |                   |
+--------------------------------------+-----------+-----------------+-----------------+-------------------+
(undercloud) [stack@undercloud ~]$
Si todo es correcto, damos el comando para desplegar el overcloud:
openstack overcloud deploy --templates --control-scale 1 --compute-scale 2 --ceph-storage-scale 2 --control-flavor control --compute-flavor compute --ceph-storage-flavor ceph-storage --libvirt-type qemuEn una instalación real, naturalmente se utilizarán plantillas personalizadas, en nuestro caso esto complicará mucho el proceso, ya que habrá que explicar cada modificación en la plantilla. Como se mencionó anteriormente, incluso una instalación simple será suficiente para ver cómo funciona.
Nota: la variable --libvirt-type qemu es necesaria en este caso, ya que utilizaremos virtualización anidada. De lo contrario, no podrán iniciarse máquinas virtuales.
Ahora tienen alrededor de una hora, o tal vez más (dependiendo de las capacidades del hardware) y deben esperar que, al final de este tiempo, vean el siguiente mensaje:
2020-08-14 08:39:21Z [overcloud]: CREATE_COMPLETE  Stack CREATE completed successfully

 Stack overcloud CREATE_COMPLETE

Host 192.168.255.21 not found in /home/stack/.ssh/known_hosts
Started Mistral Workflow tripleo.deployment.v1.get_horizon_url. Execution ID: fcb996cd-6a19-482b-b755-2ca0c08069a9
Overcloud Endpoint: http://192.168.255.21:5000/
Overcloud Horizon Dashboard URL: http://192.168.255.21:80/dashboard
Overcloud rc file: /home/stack/overcloudrc
Overcloud Deployed
(undercloud) [stack@undercloud ~]$
Ahora tienen una versión casi completa de OpenStack, en la que pueden aprender, experimentar, etc.
Verificaremos que todo funcione correctamente. En el directorio principal del usuario stack hay dos archivos: uno stackrc (para gestionar el undercloud) y el otro overcloudrc (para gestionar el overcloud). Estos archivos deben indicarse como fuente, ya que contienen la información necesaria para la autenticación.
(undercloud) [stack@undercloud ~]$ openstack server list
+--------------------------------------+-------------------------+--------+-------------------------+----------------+--------------+
| ID                                   | Name                    | Status | Networks                | Image          | Flavor       |
+--------------------------------------+-------------------------+--------+-------------------------+----------------+--------------+
| fd7d36f4-ce87-4b9a-93b0-add2957792de | overcloud-controller-0  | ACTIVE | ctlplane=192.168.255.15 | overcloud-full | control      |
| edc77778-8972-475e-a541-ff40eb944197 | overcloud-novacompute-1 | ACTIVE | ctlplane=192.168.255.26 | overcloud-full | compute      |
| 5448ce01-f05f-47ca-950a-ced14892c0d4 | overcloud-cephstorage-1 | ACTIVE | ctlplane=192.168.255.34 | overcloud-full | ceph-storage |
| ce6d862f-4bdf-4ba3-b711-7217915364d7 | overcloud-novacompute-0 | ACTIVE | ctlplane=192.168.255.19 | overcloud-full | compute      |
| e4507bd5-6f96-4b12-9cc0-6924709da59e | overcloud-cephstorage-0 | ACTIVE | ctlplane=192.168.255.44 | overcloud-full | ceph-storage |
+--------------------------------------+-------------------------+--------+-------------------------+----------------+--------------+
(undercloud) [stack@undercloud ~]$
(undercloud) [stack@undercloud ~]$ source overcloudrc
(overcloud) [stack@undercloud ~]$
(overcloud) [stack@undercloud ~]$ openstack project list
+----------------------------------+---------+
| ID                               | Name    |
+----------------------------------+---------+
| 4eed7d0f06544625857d51cd77c5bd4c | admin   |
| ee1c68758bde41eaa9912c81dc67dad8 | service |
+----------------------------------+---------+
(overcloud) [stack@undercloud ~]$
(overcloud) [stack@undercloud ~]$
(overcloud) [stack@undercloud ~]$ openstack network agent list
+--------------------------------------+--------------------+-------------------------------------+-------------------+-------+-------+---------------------------+
| ID                                   | Agent Type         | Host                                | Availability Zone | Alive | State | Binary                    |
+--------------------------------------+--------------------+-------------------------------------+-------------------+-------+-------+---------------------------+
| 10495de9-ba4b-41fe-b30a-b90ec3f8728b | Open vSwitch agent | overcloud-novacompute-1.localdomain | None              | :-)   | UP    | neutron-openvswitch-agent |
| 1515ad4a-5972-46c3-af5f-e5446dff7ac7 | L3 agent           | overcloud-controller-0.localdomain  | nova              | :-)   | UP    | neutron-l3-agent          |
| 322e62ca-1e5a-479e-9a96-4f26d09abdd7 | DHCP agent         | overcloud-controller-0.localdomain  | nova              | :-)   | UP    | neutron-dhcp-agent        |
| 9c1de2f9-bac5-400e-998d-4360f04fc533 | Open vSwitch agent | overcloud-novacompute-0.localdomain | None              | :-)   | UP    | neutron-openvswitch-agent |
| d99c5657-851e-4d3c-bef6-f1e3bb1acfb0 | Open vSwitch agent | overcloud-controller-0.localdomain  | None              | :-)   | UP    | neutron-openvswitch-agent |
| ff85fae6-5543-45fb-a301-19c57b62d836 | Metadata agent     | overcloud-controller-0.localdomain  | None              | :-)   | UP    | neutron-metadata-agent    |
+--------------------------------------+--------------------+-------------------------------------+-------------------+-------+-------+---------------------------+
(overcloud) [stack@undercloud ~]$
En mi instalación, se requiere un pequeño paso adicional: agregar una ruta en el controlador, ya que la máquina con la que estoy trabajando se encuentra en otra red. Para ello, iniciaremos sesión en control-1 con la cuenta heat-admin y añadiremos la ruta.
(undercloud) [stack@undercloud ~]$ ssh heat-admin@192.168.255.15
Último inicio de sesión: Vie 14 de agosto 09:47:40 2020 desde 192.168.255.1
[heat-admin@overcloud-controller-0 ~]$
[heat-admin@overcloud-controller-0 ~]$
[heat-admin@overcloud-controller-0 ~]$ sudo ip route add 10.169.0.0/16 via 192.168.255.254
Y ahora puedes acceder al horizonte. Toda la información — direcciones, nombre de usuario y contraseña — se encuentra en el archivo /home/stack/overcloudrc. El esquema final se ve así:
Por cierto, en nuestra instalación, las direcciones de las máquinas fueron asignadas a través de DHCP y, como puedes ver, se asignan de manera aleatoria. Puedes especificar estrictamente en la plantilla qué dirección debe asignarse a qué máquina durante el despliegue, si es necesario.
¿Cómo circula el tráfico entre las máquinas virtuales?
En este artículo, analizaremos tres variantes del tránsito del tráfico
- Dos máquinas en un mismo hipervisor en una red L2
- Dos máquinas en diferentes hipervisores en una red L2
- Dos máquinas en diferentes redes (rutado entre redes)
Casos de salida al mundo exterior a través de la red externa, utilizando direcciones flotantes, así como el enrutamiento distribuido se tratarán la próxima vez, por ahora nos detendremos en el tráfico interno.
Para la verificación, construiremos este esquema:
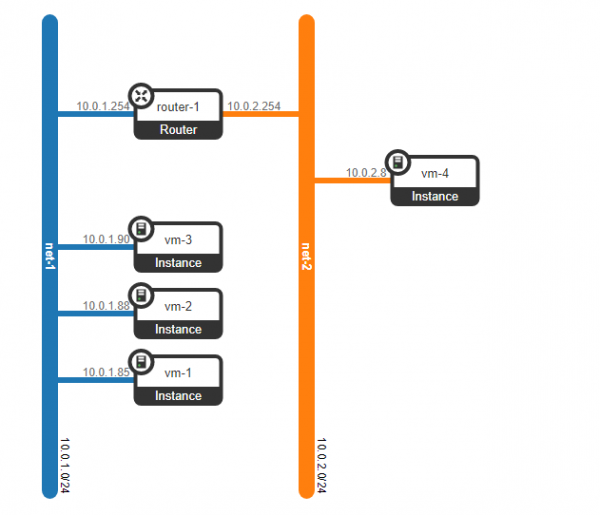
Hemos creado 4 máquinas virtuales: 3 en una misma red L2 — net-1, y 1 más en la red net-2
(overcloud) [stack@undercloud ~]$ nova list --tenant 5e18ce8ec9594e00b155485f19895e6c
+--------------------------------------+------+----------------------------------+--------+------------+-------------+-----------------+
| ID                                   | Nombre | ID de inquilino                | Estado | Estado de tarea | Estado de energía | Redes          |
+--------------------------------------+------+----------------------------------+--------+------------+-------------+-----------------+
| f53b37b5-2204-46cc-aef0-dba84bf970c0 | vm-1 | 5e18ce8ec9594e00b155485f19895e6c | ACTIVO | -          | En ejecución | net-1=10.0.1.85 |
| fc8b6722-0231-49b0-b2fa-041115bef34a | vm-2 | 5e18ce8ec9594e00b155485f19895e6c | ACTIVO | -          | En ejecución | net-1=10.0.1.88 |
| 3cd74455-b9b7-467a-abe3-bd6ff765c83c | vm-3 | 5e18ce8ec9594e00b155485f19895e6c | ACTIVO | -          | En ejecución | net-1=10.0.1.90 |
| 7e836338-6772-46b0-9950-f7f06dbe91a8 | vm-4 | 5e18ce8ec9594e00b155485f19895e6c | ACTIVO | -          | En ejecución | net-2=10.0.2.8  |
+--------------------------------------+------+----------------------------------+--------+------------+-------------+-----------------+
(overcloud) [stack@undercloud ~]$
Veamos en qué hipervisores se encuentran las máquinas creadas:
(overcloud) [stack@undercloud ~]$ nova show f53b37b5-2204-46cc-aef0-dba84bf970c0 | egrep "hypervisor_hostname|instance_name|hostname"
| OS-EXT-SRV-ATTR:hostname             | vm-1                                                     |
| OS-EXT-SRV-ATTR:hypervisor_hostname  | overcloud-novacompute-0.localdomain                      |
| OS-EXT-SRV-ATTR:instance_name        | instance-00000001                                        |
(nube) [stack@undercloud ~]$ nova show fc8b6722-0231-49b0-b2fa-041115bef34a | egrep "hypervisor_hostname|instance_name|hostname"
| OS-EXT-SRV-ATTR:hostname | vm-2 |
| OS-EXT-SRV-ATTR:hypervisor_hostname | overcloud-novacompute-1.localdomain |
| OS-EXT-SRV-ATTR:instance_name | instance-00000002 |(nube) [stack@undercloud ~]$ nova show 3cd74455-b9b7-467a-abe3-bd6ff765c83c | egrep "hypervisor_hostname|instance_name|hostname"
| OS-EXT-SRV-ATTR:hostname | vm-3 |
| OS-EXT-SRV-ATTR:hypervisor_hostname | overcloud-novacompute-0.localdomain |
| OS-EXT-SRV-ATTR:instance_name | instance-00000003 |(nube) [stack@undercloud ~]$ nova show 7e836338-6772-46b0-9950-f7f06dbe91a8 | egrep "hypervisor_hostname|instance_name|hostname"
| OS-EXT-SRV-ATTR:hostname | vm-4 |
| OS-EXT-SRV-ATTR:hypervisor_hostname | overcloud-novacompute-1.localdomain |
| OS-EXT-SRV-ATTR:instance_name | instance-00000004 | (nube) [stack@undercloud ~]$
Las máquinas vm-1 y vm-3 están ubicadas en compute-0, mientras que las máquinas vm-2 y vm-4 están en la nodo compute-1.
Además, se creó un enrutador virtual para permitir el enrutamiento entre las redes especificadas:
(nube) [stack@undercloud ~]$ openstack router list  --project 5e18ce8ec9594e00b155485f19895e6c
+--------------------------------------+----------+--------+-------+-------------+-------+----------------------------------+
| ID                                   | Name     | Status | State | Distributed | HA    | Project                          |
+--------------------------------------+----------+--------+-------+-------------+-------+----------------------------------+
| 0a4d2420-4b9c-46bd-aec1-86a1ef299abe | router-1 | ACTIVE | UP    | False       | False | 5e18ce8ec9594e00b155485f19895e6c |
+--------------------------------------+----------+--------+-------+-------------+-------+----------------------------------+
(nube) [stack@undercloud ~]$
El enrutador tiene dos puertos virtuales que actúan como puertas de enlace para las redes:
(nube) [stack@undercloud ~]$ openstack router show 0a4d2420-4b9c-46bd-aec1-86a1ef299abe | grep interface
| interfaces_info         | [{"subnet_id": "2529ad1a-6b97-49cd-8515-cbdcbe5e3daa", "ip_address": "10.0.1.254", "port_id": "0c52b15f-8fcc-4801-bf52-7dacc72a5201"}, {"subnet_id": "335552dd-b35b-456b-9df0-5aac36a3ca13", "ip_address": "10.0.2.254", "port_id": "92fa49b5-5406-499f-ab8d-ddf28cc1a76c"}] |
(nube) [stack@undercloud ~]$
Pero antes de ver cómo se mueve el tráfico, analicemos qué tenemos actualmente en el nodo de control (que también es un nodo de red) y en el nodo compute. Comencemos con el nodo compute.
[heat-admin@overcloud-novacompute-0 ~]$ sudo ovs-vsctl show
[heat-admin@overcloud-novacompute-0 ~]$ sudo sudo ovs-appctl dpif/show
system@ovs-system: hit:3 missed:3
  br-ex:
    br-ex 65534/1: (internal)
    phy-br-ex 1/none: (patch: peer=int-br-ex)
  br-int:
    br-int 65534/2: (internal)
    int-br-ex 1/none: (patch: peer=phy-br-ex)
    patch-tun 2/none: (patch: peer=patch-int)
  br-tun:
    br-tun 65534/3: (internal)
    patch-int 1/none: (patch: peer=patch-tun)
    vxlan-c0a8ff0f 3/4: (vxlan: egress_pkt_mark=0, key=flow, local_ip=192.168.255.19, remote_ip=192.168.255.15)
    vxlan-c0a8ff1a 2/4: (vxlan: egress_pkt_mark=0, key=flow, local_ip=192.168.255.19, remote_ip=192.168.255.26)
[heat-admin@overcloud-novacompute-0 ~]$
En este momento, en el nodo hay tres puentes OVS: br-int, br-tun y br-ex. Entre ellos, como podemos ver, hay un conjunto de interfaces. Para facilitar la comprensión, representemos todos estos interfaces en un esquema y veamos qué obtenemos.
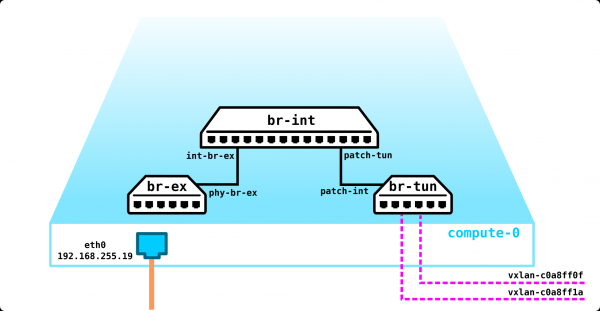
En las direcciones donde están levantados los túneles VxLAN, se puede ver que un túnel está activo en compute-1 (192.168.255.26) y el segundo túnel se conecta a control-1 (192.168.255.15). Pero lo más interesante es que br-ex no tiene interfaces físicas; y si miramos cuáles son las configuraciones de flujo, se puede ver que este puente actualmente solo puede descartar tráfico.
[heat-admin@overcloud-novacompute-0 ~]$ ifconfig eth0
eth0: flags=4163  mtu 1450
        inet 192.168.255.19  netmask 255.255.255.0  broadcast 192.168.255.255
        inet6 fe80::5054:ff:fe6a:eabe  prefixlen 64  scopeid 0x20
        ether 52:54:00:6a:ea:be  txqueuelen 1000  (Ethernet)
        RX packets 2909669  bytes 4608201000 (4.2 GiB)
        RX errors 0  dropped 0  overruns 0  frame 0
        TX packets 1821057  bytes 349198520 (333.0 MiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0

[heat-admin@overcloud-novacompute-0 ~]$
Como se puede ver en la salida, la dirección está conectada directamente al puerto físico, y no a la interfaz de puente virtual.
[heat-admin@overcloud-novacompute-0 ~]$  sudo ovs-appctl fdb/show br-ex
 port  VLAN  MAC                Age
[heat-admin@overcloud-novacompute-0 ~]$  sudo ovs-ofctl dump-flows br-ex
 cookie=0x9169eae8f7fe5bb2, duration=216686.864s, table=0, n_packets=303, n_bytes=26035, priority=2,in_port="phy-br-ex" actions=drop
 cookie=0x9169eae8f7fe5bb2, duration=216686.887s, table=0, n_packets=0, n_bytes=0, priority=0 actions=NORMAL
[heat-admin@overcloud-novacompute-0 ~]$
De acuerdo con la primera regla, todo lo que venga del puerto phy-br-ex debe ser descartado.
En el puente actual, el tráfico no puede provenir de ninguna otra parte, excepto de esta interfaz (conexión con br-int), y de acuerdo con los descartes, ya ha llegado tráfico BUM al puente.
Es decir, desde este nodo el tráfico solo puede salir a través de un túnel VxLAN y de ninguna otra manera. Sin embargo, si activamos DVR, la situación cambiará, pero eso lo resolveremos en otra ocasión. Al utilizar la isolación de redes, por ejemplo, a través de VLANs, no tendrá una sola interfaz L3 en la VLAN 0, sino varias interfaces. Sin embargo, el tráfico VxLAN saldrá del nodo exactamente de la misma manera, pero encapsulado también en alguna VLAN dedicada.
Ya hemos tratado con el nodo de cómputo, pasemos al nodo de control.
[heat-admin@overcloud-controller-0 ~]$ sudo ovs-appctl dpif/show
system@ovs-system: hit:930491 missed:825
  br-ex:
    br-ex 65534/1: (internal)
    eth0 1/2: (system)
    phy-br-ex 2/none: (patch: peer=int-br-ex)
  br-int:
    br-int 65534/3: (internal)
    int-br-ex 1/none: (patch: peer=phy-br-ex)
    patch-tun 2/none: (patch: peer=patch-int)
  br-tun:
    br-tun 65534/4: (internal)
    patch-int 1/none: (patch: peer=patch-tun)
    vxlan-c0a8ff13 3/5: (vxlan: egress_pkt_mark=0, key=flow, local_ip=192.168.255.15, remote_ip=192.168.255.19)
    vxlan-c0a8ff1a 2/5: (vxlan: egress_pkt_mark=0, key=flow, local_ip=192.168.255.15, remote_ip=192.168.255.26)
[heat-admin@overcloud-controller-0 ~]$
De hecho, se puede decir que todo es exactamente lo mismo, pero la dirección IP ya no está en la interfaz física, sino en el puente virtual. Esto se debe a que este puerto es el puerto a través del cual el tráfico saldrá al mundo exterior.
[heat-admin@overcloud-controller-0 ~]$ ifconfig br-ex
br-ex: flags=4163  mtu 1450
        inet 192.168.255.15  netmask 255.255.255.0  broadcast 192.168.255.255
        inet6 fe80::5054:ff:fe20:a22f  prefixlen 64  scopeid 0x20
        ether 52:54:00:20:a2:2f  txqueuelen 1000  (Ethernet)
        RX packets 803859  bytes 1732616116 (1.6 GiB)
        RX errors 0  dropped 63  overruns 0  frame 0
        TX packets 808475  bytes 121652156 (116.0 MiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0

[heat-admin@overcloud-controller-0 ~]$
[heat-admin@overcloud-controller-0 ~]$ sudo ovs-appctl fdb/show br-ex
 port  VLAN  MAC                Age
    3   100  28:c0:da:00:4d:d3   35
    1     0  28:c0:da:00:4d:d3   35
    1     0  52:54:00:98:e9:d6    0
LOCAL     0  52:54:00:20:a2:2f    0
    1     0  52:54:00:2c:08:9e    0
    3   100  52:54:00:20:a2:2f    0
    1     0  52:54:00:6a:ea:be    0
[heat-admin@overcloud-controller-0 ~]$
Este puerto está vinculado al puente br-ex y dado que no tiene ninguna etiqueta de VLAN, este puerto es un puerto trunco en el que se permiten todas las VLANs, actualmente el tráfico sale sin etiqueta, como lo indica el vlan-id 0 en la salida anterior.
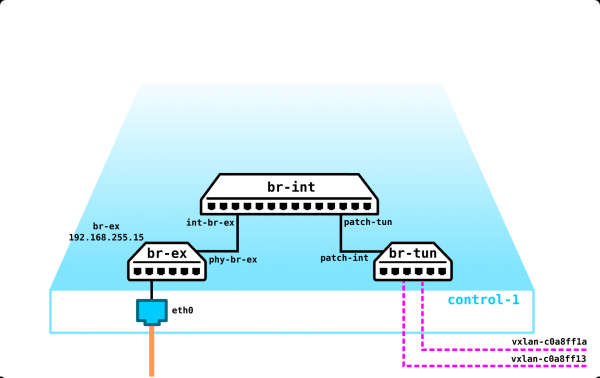
Todo lo demás en este momento es similar al nodo de cómputo: los mismos puentes, los mismos túneles que van hacia dos nodos de cómputo.
No vamos a considerar los nodos de almacenamiento en este artículo, pero para entender es necesario decir que la parte de red de esos nodos es increíblemente simple. En nuestro caso, hay solo un puerto físico (eth0) con una dirección IP asignada y ya está. No hay túneles VxLAN, puentes de túneles, etc. — no hay OVS en absoluto, ya que no tiene sentido. Al usar aislamiento de redes, en este nodo habrá dos interfaces (puertos físicos, bondados, o simplemente dos VLANs — no importa — depende de lo que quieras) — una para la gestión y la otra para el tráfico (escritura en el disco de la VM, lectura del disco, etc.).
Ya tenemos claro lo que hay en los nodos en ausencia de cualquier servicio. Ahora lanzaremos 4 máquinas virtuales y veremos cómo cambia el esquema descrito anteriormente — deberían aparecer puertos, enrutadores virtuales, etc.
Por ahora, nuestra red se ve así:
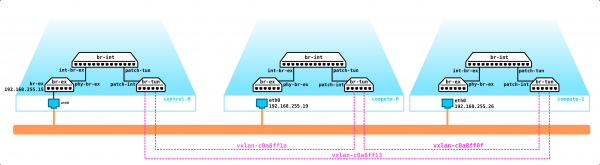
Tenemos dos máquinas virtuales en cada nodo de computación. Tomemos el ejemplo de compute-0 para ver cómo está todo conectado.
[heat-admin@overcloud-novacompute-0 ~]$ sudo virsh list
 Id    Name                           State
----------------------------------------------------
 1     instance-00000001              running
 3     instance-00000003              running

[heat-admin@overcloud-novacompute-0 ~]$
La máquina tiene solo una interfaz virtual — tap95d96a75-a0:
[heat-admin@overcloud-novacompute-0 ~]$ sudo virsh domiflist instance-00000001
Interface  Type       Source     Model       MAC
-------------------------------------------------------
tap95d96a75-a0 bridge     qbr95d96a75-a0 virtio      fa:16:3e:44:98:20

[heat-admin@overcloud-novacompute-0 ~]$
Esta interfaz se conecta al puente de linux:
[heat-admin@overcloud-novacompute-0 ~]$ sudo brctl show
bridge name     bridge id               STP enabled     interfaces
docker0         8000.0242904c92a8       no
qbr5bd37136-47          8000.5e4e05841423       no              qvb5bd37136-47
                                                        tap5bd37136-47
qbr95d96a75-a0          8000.de076cb850f6       no              qvb95d96a75-a0
                                                        tap95d96a75-a0
[heat-admin@overcloud-novacompute-0 ~]$
Como se puede ver en la salida, hay solo dos interfaces en el puente — tap95d96a75-a0 y qvb95d96a75-a0.
Aquí vale la pena detenerse un momento en los tipos de dispositivos de red virtual en OpenStack:
vtap — interfaz virtual conectada a la instancia (VM)
qbr — puente de Linux
qvb y qvo — pares vEth, conectados al puente de Linux y al puente Open vSwitch
br-int, br-tun, br-vlan — puentes de Open vSwitch
patch-, int-br-, phy-br- — interfaces de parche de Open vSwitch que conectan puentes
qg, qr, ha, fg, sg — puertos de Open vSwitch utilizados por dispositivos virtuales para conectarse a OVS
Como entendemos, si tenemos en el puente un puerto qvb95d96a75-a0, que es un par vEth, entonces debe haber un lado correspondiente que lógicamente debe llamarse qvo95d96a75-a0. Veamos qué puertos hay en OVS.
[heat-admin@overcloud-novacompute-0 ~]$ sudo sudo ovs-appctl dpif/show
system@ovs-system: hit:526 missed:91
  br-ex:
    br-ex 65534/1: (interno)
    phy-br-ex 1/none: (patch: peer=int-br-ex)
  br-int:
    br-int 65534/2: (interno)
    int-br-ex 1/none: (patch: peer=phy-br-ex)
    patch-tun 2/none: (patch: peer=patch-int)
    qvo5bd37136-47 6/6: (sistema)
    qvo95d96a75-a0 3/5: (sistema)
  br-tun:
    br-tun 65534/3: (interno)
    patch-int 1/none: (patch: peer=patch-tun)
    vxlan-c0a8ff0f 3/4: (vxlan: egress_pkt_mark=0, key=flow, local_ip=192.168.255.19, remote_ip=192.168.255.15)
    vxlan-c0a8ff1a 2/4: (vxlan: egress_pkt_mark=0, key=flow, local_ip=192.168.255.19, remote_ip=192.168.255.26)
[heat-admin@overcloud-novacompute-0 ~]$
Como podemos ver, el puerto está en br-int. Br-int actúa como un conmutador, terminando los puertos de las máquinas virtuales. Además de qvo95d96a75-a0, en la salida se puede ver el puerto qvo5bd37136-47. Este puerto es para la segunda máquina virtual. En resumen, nuestro esquema ahora se ve así:
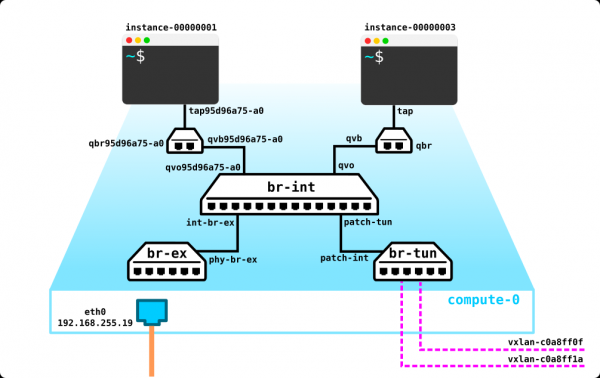
La pregunta que debería intrigar inmediatamente a un lector atento es, ¿por qué hay un puente de Linux entre el puerto de la máquina virtual y el puerto de OVS? La razón es que para proteger la máquina se utilizan grupos de seguridad, que no son más que iptables. OVS no trabaja con iptables, por lo que se ideó esta "solución". Sin embargo, está quedándose obsoleta, y se está reemplazando por conntrack en las nuevas versiones.
Es decir, en última instancia, el esquema se ve así:
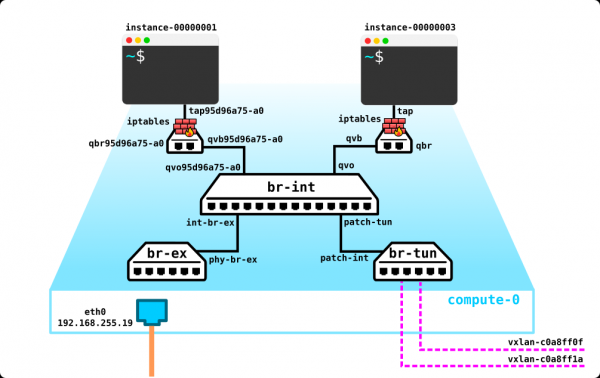
Dos máquinas en un mismo hipervisor en una red L2
Dado que estas dos máquinas virtuales están en la misma red L2 y en el mismo hypervisor, el tráfico entre ellas se moverá localmente a través de br-int, ya que ambas máquinas estarán en la misma VLAN:
[heat-admin@overcloud-novacompute-0 ~]$ sudo virsh domiflist instance-00000001
Interface  Tipo       Fuente     Modelo       MAC
-------------------------------------------------------
tap95d96a75-a0 puente     qbr95d96a75-a0 virtio      fa:16:3e:44:98:20

[heat-admin@overcloud-novacompute-0 ~]$
[heat-admin@overcloud-novacompute-0 ~]$
[heat-admin@overcloud-novacompute-0 ~]$ sudo virsh domiflist instance-00000003
Interface  Tipo       Fuente     Modelo       MAC
-------------------------------------------------------
tap5bd37136-47 puente     qbr5bd37136-47 virtio      fa:16:3e:83:ad:a4

[heat-admin@overcloud-novacompute-0 ~]$
[heat-admin@overcloud-novacompute-0 ~]$ sudo ovs-appctl fdb/show br-int
 puerto  VLAN  MAC                Edad
    6     1  fa:16:3e:83:ad:a4    0
    3     1  fa:16:3e:44:98:20    0
[heat-admin@overcloud-novacompute-0 ~]$
Dos máquinas en diferentes hipervisores en una red L2
Ahora veamos cómo fluirá el tráfico entre dos máquinas en una misma red L2, pero situadas en diferentes hypervisores. Si somos honestos, no cambiará mucho, simplemente el tráfico entre los hypervisores se moverá a través del túnel vxlan. Veamos un ejemplo.
Direcciones de máquinas virtuales entre las que observaremos el tráfico:
[heat-admin@overcloud-novacompute-0 ~]$ sudo virsh domiflist instance-00000001
Interface  Type       Source     Model       MAC
-------------------------------------------------------
tap95d96a75-a0 bridge     qbr95d96a75-a0 virtio      fa:16:3e:44:98:20

[heat-admin@overcloud-novacompute-0 ~]$
[heat-admin@overcloud-novacompute-1 ~]$ sudo virsh domiflist instance-00000002
Interfaz  Tipo       Fuente     Modelo       MAC
-------------------------------------------------------
tape7e23f1b-07 bridge     qbre7e23f1b-07 virtio      fa:16:3e:72:ad:53

[heat-admin@overcloud-novacompute-1 ~]$
Observamos la tabla de reenvío en br-int en compute-0:
[heat-admin@overcloud-novacompute-0 ~]$  sudo ovs-appctl fdb/show br-int | grep fa:16:3e:72:ad:53
    2     1  fa:16:3e:72:ad:53    1
[heat-admin@overcloud-novacompute-0 ~]
El tráfico debe ir al puerto 2, veamos qué puerto es:
[heat-admin@overcloud-novacompute-0 ~]$ sudo ovs-ofctl show br-int | grep addr
 1(int-br-ex): addr:7e:7f:28:1f:bd:54
 2(patch-tun): addr:0a:bd:07:69:58:d9
 3(qvo95d96a75-a0): addr:ea:50:9a:3d:69:58
 6(qvo5bd37136-47): addr:9a:d1:03:50:3d:96
 LOCAL(br-int): addr:1a:0f:53:97:b1:49
[heat-admin@overcloud-novacompute-0 ~]$
Este es patch-tun, es decir, la interfaz en br-tun. Veamos qué sucede con el paquete en br-tun:
[heat-admin@overcloud-novacompute-0 ~]$ sudo ovs-ofctl dump-flows br-tun | grep fa:16:3e:72:ad:53
 cookie=0x8759a56536b67a8e, duration=1387.959s, table=20, n_packets=1460, n_bytes=138880, hard_timeout=300, idle_age=0, hard_age=0, priority=1,vlan_tci=0x0001/0x0fff,dl_dst=fa:16:3e:72:ad:53 actions=load:0->NXM_OF_VLAN_TCI[],load:0x16->NXM_NX_TUN_ID[],output:2
[heat-admin@overcloud-novacompute-0 ~]$
El paquete se empaqueta en VxLAN y se envía al puerto 2. Veamos a dónde va el puerto 2:
[heat-admin@overcloud-novacompute-0 ~]$ sudo ovs-ofctl show br-tun | grep addr
 1(patch-int): addr:b2:d1:f8:21:96:66
 2(vxlan-c0a8ff1a): addr:be:64:1f:75:78:a7
 3(vxlan-c0a8ff0f): addr:76:6f:b9:3c:3f:1c
 LOCAL(br-tun): addr:a2:5b:6d:4f:94:47
[heat-admin@overcloud-novacompute-0 ~]$
Este es un túnel vxlan en compute-1:
[heat-admin@overcloud-novacompute-0 ~]$ sudo ovs-appctl dpif/show | egrep vxlan-c0a8ff1a
    vxlan-c0a8ff1a 2/4: (vxlan: egress_pkt_mark=0, key=flow, local_ip=192.168.255.19, remote_ip=192.168.255.26)
[heat-admin@overcloud-novacompute-0 ~]$
Vamos a compute-1 y vemos qué sucede luego con el paquete:
[heat-admin@overcloud-novacompute-1 ~]$ sudo ovs-appctl fdb/show br-int | egrep fa:16:3e:44:98:20
    2     1  fa:16:3e:44:98:20    1
[heat-admin@overcloud-novacompute-1 ~]$
La MAC está en la tabla de reenvío br-int en compute-1, y como se puede ver en la salida anterior, se puede ver a través del puerto 2, que es el puerto hacia br-tun:
[heat-admin@overcloud-novacompute-1 ~]$ sudo ovs-ofctl show br-int | grep addr
 1(int-br-ex): addr:8a:d7:f9:ad:8c:1d
 2(patch-tun): addr:46:cc:40:bd:20:da
 3(qvoe7e23f1b-07): addr:12:78:2e:34:6a:c7
 4(qvo3210e8ec-c0): addr:7a:5f:59:75:40:85
 LOCAL(br-int): addr:e2:27:b2:ed:14:46
Y luego vemos que en br-int en compute-1 hay una MAC de destino:
[heat-admin@overcloud-novacompute-1 ~]$ sudo ovs-appctl fdb/show br-int | egrep fa:16:3e:72:ad:53
    3     1  fa:16:3e:72:ad:53    0
[heat-admin@overcloud-novacompute-1 ~]$
Es decir, el paquete recibido se irá al puerto 3, detrás del cual se encuentra la máquina virtual instance-00000003.
Toda la belleza de implementar OpenStack para estudiar en una infraestructura virtual radica en que podemos capturar el tráfico entre hipervisores sin problemas y ver lo que está sucediendo con él. Esto es lo que haremos ahora, ejecutaremos tcpdump en el puerto vnet hacia compute-0:
[root@hp-gen9 bormoglotx]# tcpdump -vvv -i vnet3
tcpdump: escuchando en vnet3, tipo de enlace EN10MB (Ethernet), tamaño de captura 262144 bytes

*****************omitido*******************

04:39:04.583459 IP (tos 0x0, ttl 64, id 16868, offset 0, flags [DF], proto UDP (17), longitud 134)
    192.168.255.19.39096 > 192.168.255.26.4789: [sin cksum] VXLAN, flags [I] (0x08), vni 22
IP (tos 0x0, ttl 64, id 8012, offset 0, flags [DF], proto ICMP (1), longitud 84)
    10.0.1.85 > 10.0.1.88: solicitud de eco ICMP, id 5634, seq 16, longitud 64
04:39:04.584449 IP (tos 0x0, ttl 64, id 35181, offset 0, flags [DF], proto UDP (17), longitud 134)
    192.168.255.26.speedtrace-disc > 192.168.255.19.4789: [sin cksum] VXLAN, flags [I] (0x08), vni 22
IP (tos 0x0, ttl 64, id 59124, offset 0, flags [ninguna], proto ICMP (1), longitud 84)
    10.0.1.88 > 10.0.1.85: respuesta de eco ICMP, id 5634, seq 16, longitud 64

*****************omitido*******************
La primera línea muestra que el paquete con dirección 10.0.1.85 va a la dirección 10.0.1.88 (tráfico ICMP), y que está encapsulado en un paquete VxLAN con vni 22, y el paquete proviene del host 192.168.255.19 (compute-0) hacia el host 192.168.255.26 (compute-1). Podemos verificar que el VNI corresponde al que se indica en ovs.
Regresamos a esta línea actions=load:0->NXM_OF_VLAN_TCI[],load:0x16->NXM_NX_TUN_ID[],output:2. 0x16 es el vni en sistema hexadecimal. Vamos a convertir este número al sistema decimal:
16 = 6*16^0+1*16^1 = 6+16 = 22Es decir, el vni es correcto.
La segunda línea muestra el tráfico inverso, no es necesario explicarlo, ya está todo claro.
Dos máquinas en diferentes redes (rutina entre redes)
El último caso de hoy es la rutina entre redes dentro de un mismo proyecto utilizando un enrutador virtual. Consideramos el caso sin DVR (lo abordaremos en otro artículo), por lo que la rutina ocurre en el nodo de red. En nuestro caso, el nodo de red no está separado en una entidad distinta y se encuentra en el nodo de control.
Primero, veamos si la rutina funciona:
$ ping 10.0.2.8
PING 10.0.2.8 (10.0.2.8): 56 bytes de datos
64 bytes de 10.0.2.8: seq=0 ttl=63 tiempo=7.727 ms
64 bytes de 10.0.2.8: seq=1 ttl=63 tiempo=3.832 ms
^C
--- estadísticas de ping de 10.0.2.8 ---
2 paquetes transmitidos, 2 paquetes recibidos, 0% pérdida de paquetes
tiempo de ida y vuelta min/prom/máx = 3.832/5.779/7.727 ms
Dado que en este caso el paquete debe ir hacia la puerta de enlace y allí ser enrutado, necesitamos conocer la dirección MAC de la puerta de enlace, por lo que consultaremos la tabla ARP en la instancia:
$ arp
host-10-0-1-254.openstacklocal (10.0.1.254) en fa:16:3e:c4:64:70 [ether]  en eth0
host-10-0-1-1.openstacklocal (10.0.1.1) en fa:16:3e:e6:2c:5c [ether]  en eth0
host-10-0-1-90.openstacklocal (10.0.1.90) en fa:16:3e:83:ad:a4 [ether]  en eth0
host-10-0-1-88.openstacklocal (10.0.1.88) en fa:16:3e:72:ad:53 [ether]  en eth0
Ahora veamos a dónde debe ser enviado el tráfico con destino (10.0.1.254) fa:16:3e:c4:64:70:
[heat-admin@overcloud-novacompute-0 ~]$ sudo ovs-appctl fdb/show br-int | egrep fa:16:3e:c4:64:70
    2     1  fa:16:3e:c4:64:70    0
[heat-admin@overcloud-novacompute-0 ~]$
Veamos a dónde conduce el puerto 2:
[heat-admin@overcloud-novacompute-0 ~]$ sudo ovs-ofctl show br-int | grep addr
 1(int-br-ex): addr:7e:7f:28:1f:bd:54
 2(patch-tun): addr:0a:bd:07:69:58:d9
 3(qvo95d96a75-a0): addr:ea:50:9a:3d:69:58
 6(qvo5bd37136-47): addr:9a:d1:03:50:3d:96
 LOCAL(br-int): addr:1a:0f:53:97:b1:49
[heat-admin@overcloud-novacompute-0 ~]$
Todo tiene sentido, el tráfico se dirige a br-tun. Veamos en qué túnel vxlan será encapsulado:
[heat-admin@overcloud-novacompute-0 ~]$ sudo ovs-ofctl dump-flows br-tun | grep fa:16:3e:c4:64:70
 cookie=0x8759a56536b67a8e, duration=3514.566s, table=20, n_packets=3368, n_bytes=317072, hard_timeout=300, idle_age=0, hard_age=0, priority=1,vlan_tci=0x0001/0x0fff,dl_dst=fa:16:3e:c4:64:70 actions=load:0->NXM_OF_VLAN_TCI[],load:0x16->NXM_NX_TUN_ID[],output:3
[heat-admin@overcloud-novacompute-0 ~]$
El tercer puerto es el túnel vxlan:
[heat-admin@overcloud-controller-0 ~]$ sudo ovs-ofctl show br-tun | grep addr
 1(patch-int): addr:a2:69:00:c5:fa:ba
 2(vxlan-c0a8ff1a): addr:86:f0:ce:d0:e8:ea
 3(vxlan-c0a8ff13): addr:72:aa:73:2c:2e:5b
 LOCAL(br-tun): addr:a6:cb:cd:72:1c:45
[heat-admin@overcloud-controller-0 ~]$
Que mira hacia el nodo de control:
[heat-admin@overcloud-controller-0 ~]$ sudo sudo ovs-appctl dpif/show | grep vxlan-c0a8ff1a
    vxlan-c0a8ff1a 2/5: (vxlan: egress_pkt_mark=0, key=flow, local_ip=192.168.255.15, remote_ip=192.168.255.26)
[heat-admin@overcloud-controller-0 ~]$
El tráfico ha llegado al nodo de control, así que necesitamos acceder a él y ver cómo se llevará a cabo el enrutamiento.
Como ustedes recordarán, el nodo de control tenía la misma estructura que el nodo de cómputo: los mismos tres puente, solo que br-ex tenía un puerto físico a través del cual el nodo podría enviar tráfico al exterior. La creación de instancias modificó la configuración en los nodos de cómputo: se agregaron bridges linux, iptables e interfaces a los nodos. La creación de redes y un enrutador virtual también dejó su huella en la configuración del nodo de control.
Por lo tanto, es obvio que la dirección MAC del gateway debe estar en la tabla de reenvío de br-int en el nodo de control. Verifiquemos que ahí esté y a dónde apunta:
[heat-admin@overcloud-controller-0 ~]$ sudo ovs-appctl fdb/show br-int | grep fa:16:3e:c4:64:70
    5     1  fa:16:3e:c4:64:70    1
[heat-admin@overcloud-controller-0 ~]$
[heat-admin@overcloud-controller-0 ~]$  sudo ovs-ofctl show br-int | grep addr
 1(int-br-ex): addr:2e:58:b6:db:d5:de
 2(patch-tun): addr:06:41:90:f0:9e:56
 3(tapca25a97e-64): addr:fa:16:3e:e6:2c:5c
 4(tap22015e46-0b): addr:fa:16:3e:76:c2:11
 5(qr-0c52b15f-8f): addr:fa:16:3e:c4:64:70
 6(qr-92fa49b5-54): addr:fa:16:3e:80:13:72
 LOCAL(br-int): addr:06:de:5d:ed:44:44
[heat-admin@overcloud-controller-0 ~]$
El MAC es visible desde el puerto qr-0c52b15f-8f. Si regresamos a la lista de puertos virtuales en Openstack, este tipo de puerto se utiliza para conectar varios dispositivos virtuales a OVS. Para ser más precisos, qr es el puerto hacia el enrutador virtual, que se presenta en forma de namespace.
Veamos qué namespaces hay en el servidor:
[heat-admin@overcloud-controller-0 ~]$ sudo  ip netns
qrouter-0a4d2420-4b9c-46bd-aec1-86a1ef299abe (id: 2)
qdhcp-7d541e74-1c36-4e1d-a7c4-0968c8dbc638 (id: 1)
qdhcp-67a3798c-32c0-4c18-8502-2531247e3cc2 (id: 0)
[heat-admin@overcloud-controller-0 ~]$
Hay tres instancias en total. Pero por los nombres podemos inferir la función de cada una de ellas. Regresaremos a las instancias con ID 0 y 1 más tarde, ahora nos interesa el namespace qrouter-0a4d2420-4b9c-46bd-aec1-86a1ef299abe:
[heat-admin@overcloud-controller-0 ~]$ sudo  ip netns exec qrouter-0a4d2420-4b9c-46bd-aec1-86a1ef299abe ip route
10.0.1.0/24 dev qr-0c52b15f-8f proto kernel scope link src 10.0.1.254
10.0.2.0/24 dev qr-92fa49b5-54 proto kernel scope link src 10.0.2.254
[heat-admin@overcloud-controller-0 ~]$
En este namespace hay dos interfaces internas que creamos anteriormente. Ambos puertos virtuales se han agregado a br-int. Verificaremos la dirección MAC del puerto qr-0c52b15f-8f, ya que el tráfico, según la dirección MAC de destino, iba precisamente a esta interfaz.
[heat-admin@overcloud-controller-0 ~]$ sudo  ip netns exec qrouter-0a4d2420-4b9c-46bd-aec1-86a1ef299abe ifconfig qr-0c52b15f-8f
qr-0c52b15f-8f: flags=4163  mtu 1450
        inet 10.0.1.254  netmask 255.255.255.0  broadcast 10.0.1.255
        inet6 fe80::f816:3eff:fec4:6470  prefixlen 64  scopeid 0x20
        ether fa:16:3e:c4:64:70  txqueuelen 1000  (Ethernet)
        RX packets 5356  bytes 427305 (417.2 KiB)
        RX errors 0  dropped 0  overruns 0  frame 0
        TX packets 5195  bytes 490603 (479.1 KiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0

[heat-admin@overcloud-controller-0 ~]$
Es decir, en este caso todo funciona según las leyes de la ruta estándar. Como el tráfico está destinado al host 10.0.2.8, debe salir a través de la segunda interfaz qr-92fa49b5-54 y pasar a través del túnel vxlan hacia el nodo de cómputo:
[heat-admin@overcloud-controller-0 ~]$ sudo  ip netns exec qrouter-0a4d2420-4b9c-46bd-aec1-86a1ef299abe arp
Address                  HWtype  HWaddress           Flags Mask            Iface
10.0.1.88                ether   fa:16:3e:72:ad:53   C                     qr-0c52b15f-8f
10.0.1.90                ether   fa:16:3e:83:ad:a4   C                     qr-0c52b15f-8f
10.0.2.8                 ether   fa:16:3e:6c:ad:9c   C                     qr-92fa49b5-54
10.0.2.42                ether   fa:16:3e:f5:0b:29   C                     qr-92fa49b5-54
10.0.1.85                ether   fa:16:3e:44:98:20   C                     qr-0c52b15f-8f
[heat-admin@overcloud-controller-0 ~]$
Todo es lógico, ningún sorpresivo. Veamos de dónde se ve la dirección MAC del host 10.0.2.8 en br-int:
[heat-admin@overcloud-controller-0 ~]$ sudo ovs-appctl fdb/show br-int | grep fa:16:3e:6c:ad:9c
    2     2  fa:16:3e:6c:ad:9c    1
[heat-admin@overcloud-controller-0 ~]$
[heat-admin@overcloud-controller-0 ~]$ sudo ovs-ofctl show br-int | grep addr
 1(int-br-ex): addr:2e:58:b6:db:d5:de
 2(patch-tun): addr:06:41:90:f0:9e:56
 3(tapca25a97e-64): addr:fa:16:3e:e6:2c:5c
 4(tap22015e46-0b): addr:fa:16:3e:76:c2:11
 5(qr-0c52b15f-8f): addr:fa:16:3e:c4:64:70
 6(qr-92fa49b5-54): addr:fa:16:3e:80:13:72
 LOCAL(br-int): addr:06:de:5d:ed:44:44
[heat-admin@overcloud-controller-0 ~]$
Como debería ser, el tráfico va a br-tun, veamos a qué túnel irá el tráfico a continuación:
[heat-admin@overcloud-controller-0 ~]$ sudo ovs-ofctl dump-flows br-tun | grep fa:16:3e:6c:ad:9c
 cookie=0x2ab04bf27114410e, duration=5346.829s, table=20, n_packets=5248, n_bytes=498512, hard_timeout=300, idle_age=0, hard_age=0, priority=1,vlan_tci=0x0002/0x0fff,dl_dst=fa:16:3e:6c:ad:9c actions=load:0->NXM_OF_VLAN_TCI[],load:0x63->NXM_NX_TUN_ID[],output:2
[heat-admin@overcloud-controller-0 ~]$
[heat-admin@overcloud-controller-0 ~]$ sudo ovs-ofctl show br-tun | grep addr
 1(patch-int): addr:a2:69:00:c5:fa:ba
 2(vxlan-c0a8ff1a): addr:86:f0:ce:d0:e8:ea
 3(vxlan-c0a8ff13): addr:72:aa:73:2c:2e:5b
 LOCAL(br-tun): addr:a6:cb:cd:72:1c:45
[heat-admin@overcloud-controller-0 ~]$
[heat-admin@overcloud-controller-0 ~]$ sudo sudo ovs-appctl dpif/show | grep vxlan-c0a8ff1a
    vxlan-c0a8ff1a 2/5: (vxlan: egress_pkt_mark=0, key=flow, local_ip=192.168.255.15, remote_ip=192.168.255.26)
[heat-admin@overcloud-controller-0 ~]$
El tráfico sale hacia el túnel hasta compute-1. Y en compute-1 todo es simple: desde br-tun el paquete pasa a br-int y de allí a la interfaz de la máquina virtual:
[heat-admin@overcloud-controller-0 ~]$ sudo sudo ovs-appctl dpif/show | grep vxlan-c0a8ff1a
    vxlan-c0a8ff1a 2/5: (vxlan: egress_pkt_mark=0, key=flow, local_ip=192.168.255.15, remote_ip=192.168.255.26)
[heat-admin@overcloud-controller-0 ~]$
[heat-admin@overcloud-novacompute-1 ~]$ sudo ovs-appctl fdb/show br-int | grep fa:16:3e:6c:ad:9c
    4     2  fa:16:3e:6c:ad:9c    1
[heat-admin@overcloud-novacompute-1 ~]$ sudo ovs-ofctl show br-int | grep addr
 1(int-br-ex): addr:8a:d7:f9:ad:8c:1d
 2(patch-tun): addr:46:cc:40:bd:20:da
 3(qvoe7e23f1b-07): addr:12:78:2e:34:6a:c7
 4(qvo3210e8ec-c0): addr:7a:5f:59:75:40:85
 LOCAL(br-int): addr:e2:27:b2:ed:14:46
[heat-admin@overcloud-novacompute-1 ~]$
Verifiquemos que esta es realmente la interfaz correcta:
[heat-admin@overcloud-novacompute-1 ~]$ brctl show
bridge name     bridge id               STP enabled     interfaces
docker0         8000.02429c001e1c       no
qbr3210e8ec-c0          8000.ea27f45358be       no              qvb3210e8ec-c0
                                                        tap3210e8ec-c0
qbre7e23f1b-07          8000.b26ac0eded8a       no              qvbe7e23f1b-07
                                                        tape7e23f1b-07
[heat-admin@overcloud-novacompute-1 ~]$
[heat-admin@overcloud-novacompute-1 ~]$ sudo virsh domiflist instance-00000004
Interface  Type       Source     Model       MAC
-------------------------------------------------------
tap3210e8ec-c0 bridge     qbr3210e8ec-c0 virtio      fa:16:3e:6c:ad:9c

[heat-admin@overcloud-novacompute-1 ~]$
En realidad hemos seguido todo el camino del paquete. Creo que han notado que el tráfico circulaba a través de diferentes túneles vxlan y salía con diferentes VNI. Vamos a ver cuáles son esos VNI, y luego capturaremos un volcado en el puerto del nodo de control para asegurarnos de que el tráfico se mueve exactamente como se describió anteriormente.
Así que, el túnel hasta compute-0 tiene la siguiente actions=load:0->NXM_OF_VLAN_TCI[],load:0x16->NXM_NX_TUN_ID[],output:3. Convirtamos 0x16 a decimal:
0x16 = 6*16^0+1*16^1 = 6+16 = 22El túnel hasta compute-1 tiene el siguiente VNI: actions=load:0->NXM_OF_VLAN_TCI[],load:0x63->NXM_NX_TUN_ID[],output:2. Convirtamos 0x63 a decimal:
0x63 = 3*16^0+6*16^1 = 3+96 = 99Y ahora veamos el volcado:
[root@hp-gen9 bormoglotx]# tcpdump -vvv -i vnet4
tcpdump: escuchando en vnet4, tipo de enlace EN10MB (Ethernet), tamaño de captura 262144 bytes

*****************omitido*******************

04:35:18.709949 IP (tos 0x0, ttl 64, id 48650, offset 0, flags [DF], proto UDP (17), length 134)
    192.168.255.19.41591 > 192.168.255.15.4789: [sin cksum] VXLAN, flags [I] (0x08), vni 22
IP (tos 0x0, ttl 64, id 49042, offset 0, flags [DF], proto ICMP (1), length 84)
    10.0.1.85 > 10.0.2.8: solicitud de eco ICMP, id 5378, seq 9, length 64
04:35:18.710159 IP (tos 0x0, ttl 64, id 23360, offset 0, flags [DF], proto UDP (17), length 134)
    192.168.255.15.38983 > 192.168.255.26.4789: [sin cksum] VXLAN, flags [I] (0x08), vni 99
IP (tos 0x0, ttl 63, id 49042, offset 0, flags [DF], proto ICMP (1), length 84)
    10.0.1.85 > 10.0.2.8: solicitud de eco ICMP, id 5378, seq 9, length 64
04:35:18.711292 IP (tos 0x0, ttl 64, id 43596, offset 0, flags [DF], proto UDP (17), length 134)
    192.168.255.26.42588 > 192.168.255.15.4789: [sin cksum] VXLAN, flags [I] (0x08), vni 99
IP (tos 0x0, ttl 64, id 55103, offset 0, flags [none], proto ICMP (1), length 84)
    10.0.2.8 > 10.0.1.85: respuesta de eco ICMP, id 5378, seq 9, length 64
04:35:18.711531 IP (tos 0x0, ttl 64, id 8555, offset 0, flags [DF], proto UDP (17), length 134)
    192.168.255.15.38983 > 192.168.255.19.4789: [sin cksum] VXLAN, flags [I] (0x08), vni 22
IP (tos 0x0, ttl 63, id 55103, offset 0, flags [none], proto ICMP (1), length 84)
    10.0.2.8 > 10.0.1.85: respuesta de eco ICMP, id 5378, seq 9, length 64

*****************omitido*******************
El primer paquete es un paquete VXLAN desde el host 192.168.255.19 (compute-0) hacia el host 192.168.255.15 (control-1) con vni 22, dentro del cual hay un paquete ICMP desde el host 10.0.1.85 hacia el host 10.0.2.8. Como calculamos anteriormente, el vni corresponde a lo que vimos en las salidas.
El segundo paquete es un paquete VXLAN desde el host 192.168.255.15 (control-1) hacia el host 192.168.255.26 (compute-1) con vni 99, dentro del cual hay un paquete ICMP desde el host 10.0.1.85 hacia el host 10.0.2.8. Como calculamos anteriormente, el vni corresponde a lo que vimos en las salidas.
Los dos siguientes paquetes son el tráfico inverso desde 10.0.2.8 a 10.0.1.85.
Por lo tanto, al final tenemos este esquema del nodo de control:
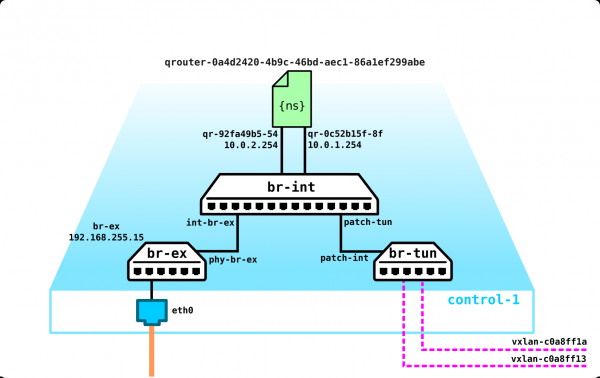
¿Parece que está todo? Olvidamos mencionar dos namespaces:
[heat-admin@overcloud-controller-0 ~]$ sudo  ip netns
qrouter-0a4d2420-4b9c-46bd-aec1-86a1ef299abe (id: 2)
qdhcp-7d541e74-1c36-4e1d-a7c4-0968c8dbc638 (id: 1)
qdhcp-67a3798c-32c0-4c18-8502-2531247e3cc2 (id: 0)
[heat-admin@overcloud-controller-0 ~]$
Como mencionamos sobre la arquitectura de la plataforma en la nube, sería ideal que las máquinas obtuvieran direcciones automáticamente desde el servidor DHCP. Estos son los dos servidores DHCP para nuestras dos redes 10.0.1.0/24 y 10.0.2.0/24.
Verifiquemos que esto sea correcto. En este namespace, solo hay una dirección: 10.0.1.1, que es la dirección del propio servidor DHCP, y también está incluida en br-int:
[heat-admin@overcloud-controller-0 ~]$ sudo ip netns exec qdhcp-67a3798c-32c0-4c18-8502-2531247e3cc2 ifconfig
lo: flags=73  mtu 65536
        inet 127.0.0.1  netmask 255.0.0.0
        inet6 ::1  prefixlen 128  scopeid 0x10
        loop  txqueuelen 1000  (Local Loopback)
        RX packets 1  bytes 28 (28.0 B)
        RX errors 0  dropped 0  overruns 0  frame 0
        TX packets 1  bytes 28 (28.0 B)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0

tapca25a97e-64: flags=4163  mtu 1450
        inet 10.0.1.1  netmask 255.255.255.0  broadcast 10.0.1.255
        inet6 fe80::f816:3eff:fee6:2c5c  prefixlen 64  scopeid 0x20
        ether fa:16:3e:e6:2c:5c  txqueuelen 1000  (Ethernet)
        RX packets 129  bytes 9372 (9.1 KiB)
        RX errors 0  dropped 0  overruns 0  frame 0
        TX packets 49  bytes 6154 (6.0 KiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
Veamos los procesos que contienen en su nombre qdhcp-67a3798c-32c0-4c18-8502-2531247e3cc2 en el nodo de control:
[heat-admin@overcloud-controller-0 ~]$ ps -aux | egrep qdhcp-7d541e74-1c36-4e1d-a7c4-0968c8dbc638
root      640420  0.0  0.0   4220   348 ?        Ss   11:31   0:00 dumb-init --single-child -- ip netns exec qdhcp-7d541e74-1c36-4e1d-a7c4-0968c8dbc638 /usr/sbin/dnsmasq -k --no-hosts --no-resolv --pid-file=/var/lib/neutron/dhcp/7d541e74-1c36-4e1d-a7c4-0968c8dbc638/pid --dhcp-hostsfile=/var/lib/neutron/dhcp/7d541e74-1c36-4e1d-a7c4-0968c8dbc638/host --addn-hosts=/var/lib/neutron/dhcp/7d541e74-1c36-4e1d-a7c4-0968c8dbc638/addn_hosts --dhcp-optsfile=/var/lib/neutron/dhcp/7d541e74-1c36-4e1d-a7c4-0968c8dbc638/opts --dhcp-leasefile=/var/lib/neutron/dhcp/7d541e74-1c36-4e1d-a7c4-0968c8dbc638/leases --dhcp-match=set:ipxe,175 --local-service --bind-dynamic --dhcp-range=set:subnet-335552dd-b35b-456b-9df0-5aac36a3ca13,10.0.2.0,static,255.255.255.0,86400s --dhcp-option-force=option:mtu,1450 --dhcp-lease-max=256 --conf-file= --domain=openstacklocal
heat-ad+  951620  0.0  0.0 112944   980 pts/0    S+   18:50   0:00 grep -E --color=auto qdhcp-7d541e74-1c36-4e1d-a7c4-0968c8dbc638
[heat-admin@overcloud-controller-0 ~]$
Hay un proceso así y basándonos en la información presentada en la salida anterior, podemos, por ejemplo, ver qué tenemos arrendado en este momento:
[heat-admin@overcloud-controller-0 ~]$ cat /var/lib/neutron/dhcp/7d541e74-1c36-4e1d-a7c4-0968c8dbc638/leases
1597492111 fa:16:3e:6c:ad:9c 10.0.2.8 host-10-0-2-8 01:fa:16:3e:6c:ad:9c
1597491115 fa:16:3e:76:c2:11 10.0.2.1 host-10-0-2-1 *
[heat-admin@overcloud-controller-0 ~]$
En resumen, obtenemos este conjunto de servicios en el nodo de control:
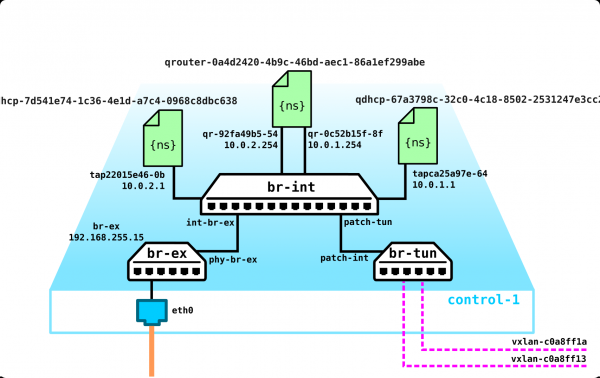
Y tengan en cuenta que esto es solo un ejemplo: 4 máquinas, 2 redes internas y un enrutador virtual... Actualmente no tenemos redes externas, ni una multitud de proyectos, cada uno con sus propias redes (que se cruzan), y tenemos apagado el enrutador distribuido. Al final, en el banco de pruebas, solo había un nodo de control (para la alta disponibilidad, debería haber un quórum de tres nodos). Es lógico que en el comercio todo sea "un poco" más complicado, pero en este simple ejemplo entendemos cómo debería funcionar: tener 3 o 300 namespaces es sin duda importante, pero desde el punto de vista del funcionamiento de toda la estructura, realmente no cambiará nada... a menos que conecten algún SDN de un proveedor. Pero esa es otra historia por completo.
Espero que haya sido interesante. Si hay comentarios/adiciones o si en algún lugar he mentido abiertamente (soy humano y mi opinión siempre será subjetiva) — envíen lo que necesitan corregir/agregar — lo corregiremos/agregaremos todo.
En conclusión, me gustaría decir unas palabras sobre la comparación de OpenStack (tanto en su versión básica como en las de los proveedores) con la solución en la nube de la empresa VMWare — muchas personas me han hecho esta pregunta en los últimos años y, sinceramente, ya estoy cansado de ella, pero aun así. En mi opinión, comparar estas dos soluciones es muy complicado, pero se puede afirmar inequívocamente que hay desventajas en ambas soluciones y al elegir alguna de ellas hay que sopesar todos los pros y los contras.
Si OpenStack es una solución impulsada por la comunidad, VMWare tiene derecho a hacer solo lo que quiere (es decir, lo que le beneficia) y esto es lógico, ya que es una empresa comercial que está acostumbrada a ganar dinero con sus clientes. Pero aquí hay un gran PERO: puedes salir de OpenStack, por ejemplo, de Nokia y pasar sin complicaciones a una solución de, por ejemplo, Juniper (Contrail Cloud), pero salir de VMWare probablemente no lo podrás lograr. Para mí, estas dos soluciones se ven así: OpenStack (del proveedor) es una simple jaula en la que te encierran, pero tienes la llave y puedes salir en cualquier momento. VMWare es una jaula dorada, la llave de la jaula está en manos del dueño y te costará muy caro.
No estoy abogando por uno u otro producto; ustedes eligen lo que necesitan. Pero si tuviera que elegir, optaría por ambas soluciones: VMWare para la nube de TI (cargas pequeñas, gestión conveniente) y OpenStack de algún proveedor (Nokia y Juniper ofrecen soluciones bastante buenas llave en mano) para la nube de telecomunicaciones. No usaría OpenStack para TI puro; es como usar un cañón para cazar gorriones, pero no veo contraindicación en su uso, salvo la redundancia. Sin embargo, usar VMWare en telecomunicaciones es como transportar grava en un Ford Raptor: se ve bien, pero el conductor tiene que hacer diez viajes en lugar de uno.
En mi opinión, la mayor desventaja de VMWare es su completo hermetismo: la compañía no te proporciona información sobre cómo funciona, por ejemplo, vSAN o qué hay en el núcleo del hipervisor; simplemente no le conviene. Eso significa que nunca te convertirás en un experto en VMWare; sin el apoyo del proveedor, estás condenado (frecuentemente encuentro expertos en VMWare que se quedan atascados con preguntas sencillas). Para mí, VMWare es como comprar un coche con el capó completamente cerrado: sí, puede que tengas especialistas que podrían cambiar la correa del motor, pero solo quien te vendió esta solución puede abrir el capó. Personalmente, no me gustan las soluciones en las que no puedo intervenir. Dirás que tal vez no tendrás que mirar bajo el capó. Eso podría ser, pero te miraré cuando necesites ensamblar una gran función en la nube con 20-30 máquinas virtuales, 40-50 redes, la mitad de las cuales quieren salir al exterior y la otra mitad solicita aceleración SR-IOV, de lo contrario necesitarás unas cuantas docenas más de esas máquinas, ya que el rendimiento no será suficiente.
Existen otras opiniones, por lo que solo tú decides qué elegir y lo más importante: tú serás responsable de tu elección. Esta es solo mi opinión, la de alguien que ha visto y tocado al menos cuatro productos: Nokia, Juniper, Red Hat y VMWare. Es decir, tengo con qué comparar.
Fuente: habr.com
