

Hola, primero un poco de lírica. A veces envidio a mis colegas que trabajan de forma remota, porque es maravilloso tener la posibilidad de trabajar desde cualquier rincón del mundo conectado a Internet, vacaciones en cualquier momento, responsabilidad por proyectos y plazos, en lugar de estar en la oficina de 8 a 5. Mi posición y responsabilidades laborales prácticamente excluyen la posibilidad de estar ausente mucho tiempo en el centro de datos. Sin embargo, de vez en cuando suceden casos interesantes, como el que se describe a continuación, y entiendo que hay pocas posiciones con tanto espacio para la expresión creativa de un solucionador de problemas interno.
Un pequeño descargo de responsabilidad: en el momento de escribir este artículo, el caso no está completamente resuelto, pero dado el ritmo de respuesta de los proveedores, la solución completa puede tardar meses, y quiero compartir mis hallazgos ahora. Espero, estimados lectores, que me perdonen por esta premura. Pero suficiente de preámbulos, ¿qué pasa con el caso?
Primero, una introducción: hay una empresa (donde trabajo como ingeniero de redes) que aloja soluciones para clientes en una nube privada de VMWare. La mayoría de las nuevas soluciones se conectan a segmentos VXLAN, que son gestionados por NSX-V. No voy a evaluar cuánto tiempo me ha dado esta solución, en breve, ha sido mucho. Incluso logré capacitar a mis colegas en la configuración de NSX ESG y pequeñas soluciones para clientes se despliegan sin mi participación. Un apunte importante: el plano de control tiene replicación unicast. Los hipervisores están conectados de manera redundante con dos interfaces a diferentes conmutadores físicos Juniper QFX5100 (construidos en un Virtual Chassis) y una política de temporización basada en el puerto virtual de origen, para completar el panorama.
Las soluciones para clientes son muy diversas: desde Windows IIS, donde todos los componentes del servidor web están instalados en una sola máquina, hasta configuraciones bastante grandes, como los frentes web de Apache balanceados por carga + LB MariaDB en Galera + servidores compartidos sincronizados mediante GlusterFS. Prácticamente cada servidor debe ser monitoreado por separado, y no todos los componentes tienen direcciones públicas. Si te has encontrado con esta tarea y tienes una solución más elegante, estaré encantado de recibir tus consejos.
Mi solución de monitoreo consiste en «conectar» un firewall (Fortigate) a cada red interna de clientes (+SNAT y, por supuesto, estrictas restricciones sobre el tipo de tráfico permitido) y observar las direcciones internas; de esta manera se logra una cierta unificación y simplificación del monitoreo. El monitoreo se realiza desde un clúster de servidores PRTG. El esquema de monitoreo es aproximadamente el siguiente:
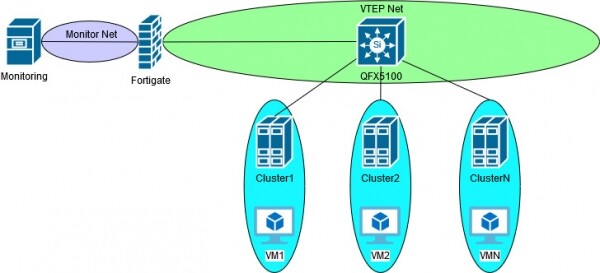
Mientras operamos solo con VLAN, todo funcionaba de manera bastante normal y predecible, como un reloj. Después de implementar NSX-V y VXLAN, nos encontramos con la pregunta: ¿se puede seguir monitoreando de la forma antigua? En el momento de esta pregunta, la solución «más rápida» fue desplegar NSX ESG y conectar la interfaz trunk VXLAN en la red VTEP. Rápido entre comillas, ya que usar la GUI para configurar redes de clientes, SNAT y reglas del firewall puede unificar la gestión en una única interfaz de vSphere, pero en mi opinión es bastante engorroso y, además, limita el conjunto de herramientas para solucionar problemas. Aquellos que han utilizado NSX ESG como reemplazo de un firewall «real», creo que estarán de acuerdo. Aunque, probablemente, tal solución sería más estable, ya que todo ocurre dentro de un único vendedor.
Otra solución es utilizar NSX DLR en modo puente entre VLAN y VXLAN. Aquí creo que todo está claro: se pierde la ventaja de aplicar VXLAN, ya que en este caso aún es necesario extender VLAN a la instalación de monitoreo. Por cierto, durante el desarrollo de esta solución me encontré con un problema cuando el puente DLR no enviaba paquetes a la máquina virtual con la que estaba en el mismo host. Lo sé, lo sé: en los libros y guías sobre NSX-V se dice que NSX Edge debe tener un clúster separado, pero eso está en los libros... De una forma u otra, después de un par de meses con soporte, no resolvimos el problema. En esencia, entendí la lógica de funcionamiento: el módulo del núcleo del hipervisor responsable de la encapsulación de VXLAN no se activó si el DLR y el servidor observado estaban en el mismo host, ya que el tráfico no sale del host y, lógicamente, debería estar conectado al segmento VXLAN: la encapsulación no es necesaria. Con el soporte nos detuvimos en la interfaz virtual vdrPort, que lógicamente combina los uplinks y también realiza el puenteo/encapsulación: ahí se observó una discrepancia en el tráfico entrante, que tomé para trabajar en el caso actual. Pero como se dijo, no terminé este caso porque fui transferido a otro proyecto y además la rama era originalmente un callejón sin salida y no había mucho deseo de desarrollarla. Si no me equivoco, el problema se observó en las versiones NSX 6.1.4 y 6.2.
Y aquí, ¡bingo! Fortinet anuncia el soporte nativo . Y no solo point-to-point o VXLAN-over-IPSec, no es un puente de software VLAN-VXLAN: todo esto comenzó a implementarse desde la versión 5.4 (y se presenta en otros ), y el soporte real para el plano de control unicast. Al implementar la solución, me encontré con otro problema: los servidores monitorizados a veces «desaparecían» y luego aparecían en la supervisión, aunque la máquina virtual estaba viva. La razón, como resultó, fue que olvidé habilitar el Ping en la interfaz VXLAN. Durante el proceso de equilibrado de clústeres, las máquinas virtuales se movían, y el vMotion finalizaba con un Ping para indicar el nuevo host ESXI al que se había trasladado la máquina. Fue un error mío, pero este problema socavó nuevamente mi confianza en el soporte del fabricante — en este caso, Fortinet. Ni siquiera hablo de que cada caso relacionado con VXLAN comienza con la pregunta «¿dónde está en su configuración el softswitch VLAN-VXLAN?» Esta vez me recomendaron cambiar el MTU — es para el Ping, que es de 32 bytes. Luego «juega» con tcp-send-mss y tcp-receive-mss en la política — para VXLAN, que se encapsula en UDP. Uff, disculpa — necesitaba sacarlo. En resumen, resolví este problema por mi cuenta.
Después de probar el tráfico de prueba, se decidió implementar esta solución. Y en producción, resultó que después de uno o dos días, todo lo que estaba monitorizado a través de VXLAN se desconectaba gradualmente. La desactivación/activación de la interfaz ayudaba, pero solo temporalmente. Recordando la lentitud del soporte del fabricante, me ocupé de la solución de problemas por mi cuenta — después de todo, mi empresa, mi red — mi responsabilidad.
Bajo el spoiler está el progreso de la solución de problemas. Quien esté cansado de letras y jactancias — salte y pase al análisis posterior.
Progreso de la solución de problemasGracias por continuar leyendo — ¡sigamos!
Así que, la supervisión funciona un tiempo, luego se desconecta sola. Esto significa que probablemente no hay problemas en las políticas del firewall. Sin embargo, dado que me he encontrado con el problema de procesos del sistema que se quedan colgados en Fortigate versiones 5.6+, primero miramos «diagnose debug flow» — como era de esperar, el tráfico se permite y se envía desde la interfaz y, como era de esperar, no llega nada en respuesta. Así que seguimos profundizando en la pila. Lamentablemente, tendré que ocultar las direcciones, aunque sean RFC1918, pero espero proporcionar suficiente descripción del proceso para la comprensión. El servidor dentro de VXLAN tiene la dirección x.x.x.15, la interfaz de Fortigate x.x.x.254, todas las demás direcciones pertenecen a la red VTEP.
Para la transmisión exitosa de paquetes encapsulados en VXLAN, es necesario contar con información correcta en varias tablas. Para el overlay, esto implica ARP y OVSDB; para el underlay, ARP y CAM. En el caso de Fortigate, VXLAN FDB es OVSDB. Empezaremos por ahí:
 fortigate (root) #diag sys vxlan fdb list vxlan-LS
mac=00:50:56:8f:3f:5a state=0x0002 flags=0x00 remote_ip=ú.ú.ú.47 port=4789 vni=5008 ifindex=7
Aquí todo es bastante simple: la dirección MAC de la máquina virtual debe estar en el VTEP con la dirección ú.ú.ú.47. Al revisar el contenido y la configuración del clúster ESXI, encuentro que la MAC de la máquina virtual es correcta, y también lo es la dirección del VTEP. Verifico la tabla CAM/ARP en el Fortigate, y de nuevo todo coincide con la configuración del host ESXI:
fortigate (root) #get sys arp | grep ú.ú.ú.47
ú.ú.ú.47 0 00:50:56:65:f6:2c dmz
Las tablas son correctas y el tráfico se envía; ¿podría ser que el problema no esté en el Fortigate? Intencionalmente he omitido el análisis de la conmutación de tráfico en Juniper — siguiendo la lógica, ahí debería realizarse el siguiente paso de solución de problemas, pero mi red es simple: solo un VLAN para VTEP y todos los componentes están conectados directamente. Además, recuerdo un caso con un puente DLR, VDR y tráfico perdido; voy a sniffear en el host ESXI, y al mismo tiempo creo un caso por separado con VMware. A continuación, la MAC "97:6e" pertenece al Fortigate, vmnic1 es la interfaz que tiene el VTEP con dirección ú.ú.ú.47, sniffamos en ambas direcciones "—dir 2":
pktcap-uw --uplink vmnic1 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
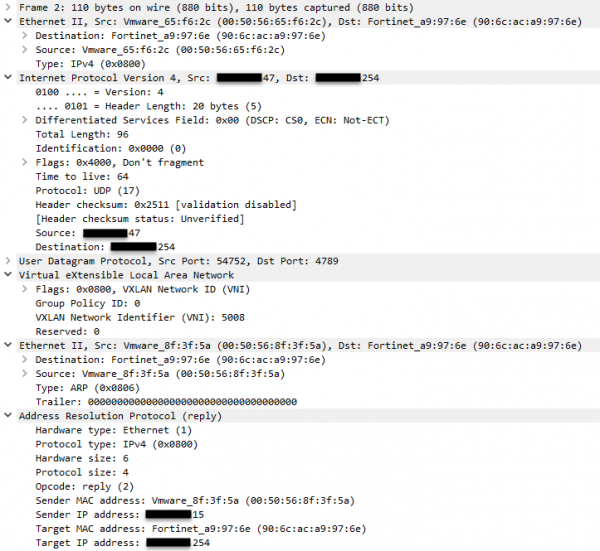
Progreso: en el sniff veo una solicitud ARP y la respuesta que llega. Solo presento la respuesta ARP y ahí todo es correcto. No mencioné que durante todo este tiempo el servidor de monitoreo está haciendo ping a la dirección x.x.x.15 — ¿dónde está el tráfico ICMP? Recuerdo que tengo dos uplinks. Aquí se puede debatir y decir que el puerto virtual de origen es el mismo (mi política de teaming), es decir, para un mismo vNIC se debe seleccionar el mismo uplink, pero ya que estoy en el host, verificar el otro uplink no es un problema:
pktcap-uw --uplink vmnic4 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
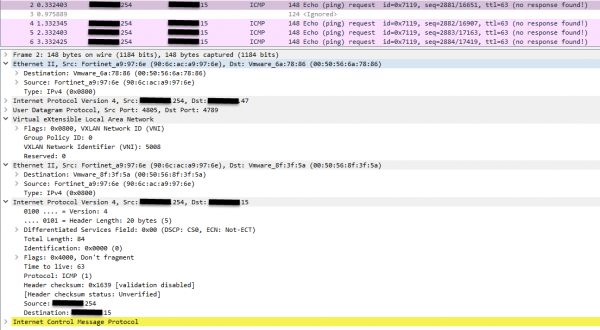
Recibo solicitudes del Fortigate, pero no hay respuesta. Es decir, el problema no está en el Fortigate. Bueno, eso creo, otra vez el mismo problema de la pérdida de tráfico en el VDR, de nuevo unos meses dirigiendo el caso en la dirección correcta. Después de un par de días, calmándome y sin querer aceptar el estancamiento, decidí recopilar más sniffs para el soporte y así acelerar el proceso. Y aquí, 'accidentalmente', mi mirada cae en la encapsulación de Ethernet underlay. El rey no es real y la dirección MAC del VTEP no coincide con su IP. Restablezco a cero, hago sniffs, investigo—resulta que no es correcto. Colocaré la tabla ARP al lado para que sea más fácil comparar. Preste atención a la primera encapsulación de Ethernet en la imagen de arriba:
fortigate (root) #get sys arp | grep x.x.x.47
x.x.x.47 0 00:50:56:65:f6:2c dmz
fortigate (root) #get sys arp | grep x.x.x.42
x.x.x.42 0 00:50:56:6a:78:86 dmz
Entonces, ¿qué tenemos en total? — Después de la migración de la máquina virtual, el Fortigate intenta enviar tráfico al VTEP desde (correcta) VXLAN FDB, pero usa una MAC DST incorrecta y el tráfico se descarta, como era de esperar, por el interfaz receptor del hipervisor. De hecho, en uno de cada cuatro casos esta MAC pertenecía al hipervisor original desde el que comenzamos la migración de la máquina.
Ayer recibí un correo del soporte técnico de Fortinet — han abierto un bug 615586 para mi caso. No sé si sentirme feliz o triste: por un lado, el problema no está en la configuración, por el otro, la solución llegará solo con la actualización del firmware, en el mejor de los casos, en la próxima. Mi ego también se alimenta de otro bug que descubrí el mes pasado, aunque esta vez en el GUI HTML5 de vSphere. Es como tener un departamento local de QA en los proveedores...
Me arriesgo a suponer lo siguiente:
1 — es probable que el plano de control multicast no esté sujeto al problema descrito — ya que las direcciones MAC del VTEP se obtienen de la dirección IP del grupo al que está suscrito el interfaz.
2 — probablemente el problema de Fortigate esté en la descarga de sesiones en el Procesador de Red (aproximadamente análogo al CEF) — si cada paquete pasa por la CPU, se utilizarán las tablas que contienen la información correcta, al menos visualmente. A favor de esta suposición está el hecho de que ayuda cerrar/abrir el interfaz o esperar un tiempo — más de 5 minutos.
3 — cambiar la política de equipo, por ejemplo, a failover explícito, o implementar LAG no resolverá el problema, ya que se observó un 'atasco' de la MAC del hipervisor original en los paquetes encapsulados.
A la luz de esto, puedo compartir que recientemente descubrí , donde en uno de los artículos se afirmaba que los firewalls stateful y los métodos de transmisión de datos en caché son parches. Bueno, no tengo suficiente experiencia en TI para afirmar lo contrario, además no estoy de acuerdo de inmediato con todas las afirmaciones de los artículos del blog. Sin embargo, algo me dice que hay algo de verdad en las palabras de Iván.
¡Gracias por su atención! Estaré encantado de responder a preguntas y escuchar críticas constructivas.
Fuente: habr.com
