

Zabbix es un sistema de monitoreo. Al igual que cualquier otro sistema, enfrenta tres problemas principales comunes a todos los sistemas de monitoreo: recopilación y procesamiento de datos, almacenamiento de historial y su limpieza.
Las etapas de obtención, procesamiento y grabación de datos llevan tiempo. Un poco, pero para un sistema grande puede traducirse en grandes retrasos. El problema del almacenamiento es una cuestión de acceso a los datos. Se utilizan para informes, verificaciones y disparadores. Los retrasos en el acceso a los datos también afectan el rendimiento. A medida que las bases de datos crecen, los datos obsoletos deben eliminarse. La eliminación es una operación pesada que también consume parte de los recursos.
Los problemas de retrasos en la recopilación y almacenamiento en Zabbix se resuelven mediante la caché: varios tipos de cachés, caché en la base de datos. Para solucionar el tercer problema, la caché no es adecuada, por lo que en Zabbix se ha utilizado TimescaleDB. De esto hablará Andrey Gushchin — ingeniero de soporte técnico . Andrey tiene más de 6 años en el soporte de Zabbix y se enfrenta directamente al rendimiento.
¿Cómo funciona TimescaleDB? ¿Qué rendimiento puede ofrecer en comparación con PostgreSQL común? ¿Qué papel juega Zabbix para las bases de datos de TimescaleDB? ¿Cómo iniciar desde cero y cómo migrar desde PostgreSQL y qué configuración rinde mejor? Sobre todo esto, a continuación.

Desafíos de rendimiento
Cada sistema de monitoreo se enfrenta a desafíos de rendimiento específicos. Hablaré sobre tres de ellos: recopilación y procesamiento de datos, almacenamiento, limpieza del historial.
Recopilación y procesamiento de datos rápidos. Un buen sistema de monitoreo debe recibir todos los datos rápidamente y procesarlos según las expresiones de disparo — segun sus criterios. Después del procesamiento, el sistema también debe guardar estos datos en la base de datos de manera rápida para su posterior uso.
Almacenamiento del historial. Un buen sistema de monitoreo debe almacenar el historial en la base de datos y proporcionar acceso conveniente a las métricas. El historial es necesario para utilizarlo en informes, gráficos, disparadores, umbrales y elementos de datos calculados para alertas.
Limpieza del historial. A veces llega el día en que no necesitas almacenar métricas. ¿Para qué necesitas datos recopilados hace 5 años, un mes o dos? Algunos nodos han sido eliminados, algunos anfitriones o métricas ya no son necesarios porque están obsoletos y dejaron de recopilarse. Un buen sistema de monitoreo debe almacenar datos históricos y eliminarlos de vez en cuando para que la base de datos no crezca descontroladamente.
La limpieza de datos obsoletos es un tema crítico que impacta significativamente en el rendimiento de la base de datos.
Caching en Zabbix
En Zabbix, el primer y segundo llamado se resuelven mediante caching. Para la recopilación y procesamiento de datos se utiliza la memoria RAM. Para el almacenamiento — historia en disparadores, gráficos y elementos de datos computados. En el lado de la base de datos hay cierto caching para las principales consultas, por ejemplo, gráficos.
El caching en el propio servidor Zabbix es:
- ConfigurationCache;
- ValueCache;
- HistoryCache;
- TrendsCache.
Veamos esto en detalle.
ConfigurationCache
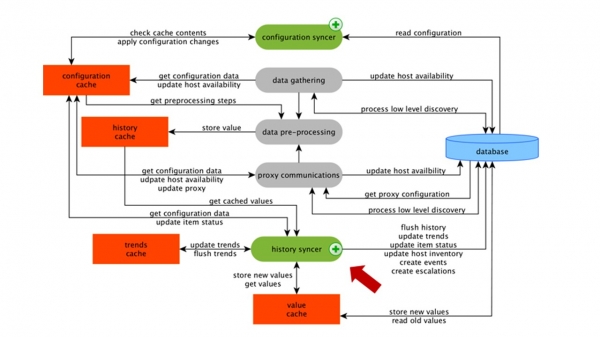
Este es el cache principal donde almacenamos métricas, anfitriones, elementos de datos, disparadores — todo lo necesario para el PreProcessing y la recopilación de datos.
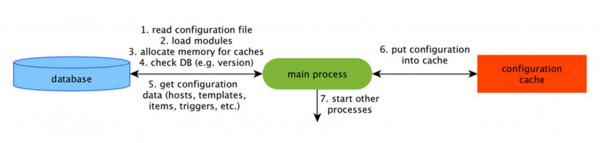
Todo esto se almacena en ConfigurationCache para evitar crear solicitudes innecesarias en la base de datos. Después de iniciar el servidor, actualizamos este cache, creamos y actualizamos configuraciones periódicamente.
Recopilación de datos
El esquema es bastante grande, pero lo principal en él es los recolectores. Son varios "pollers" — procesos de recopilación. Son responsables de diferentes tipos de recopilación: recopilan datos a través de SNMP, IPMI, y transmiten todo esto al PreProcessing.
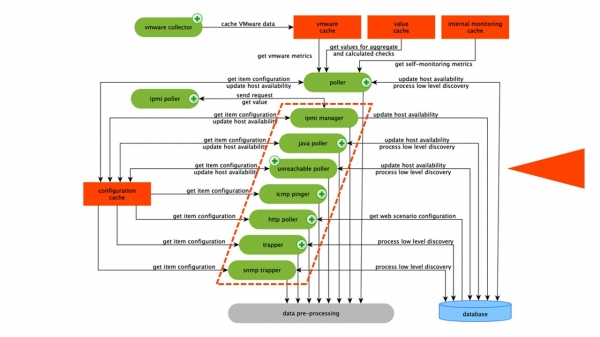 Los recolectores están delimitados por una línea naranja.
En Zabbix hay elementos de datos de agregación computados que son necesarios para agregar verificaciones. Si los tenemos, tomamos los datos para ellos directamente de ValueCache.
PreProcessing HistoryCache
Todos los recolectores utilizan ConfigurationCache para obtener tareas. Luego las pasan al PreProcessing.
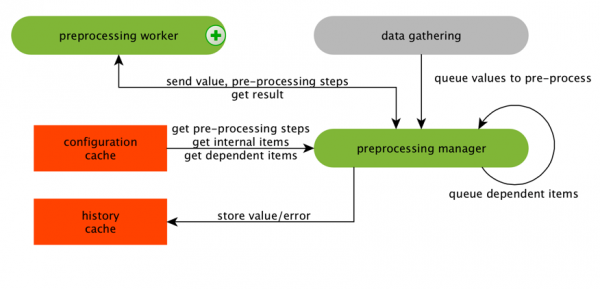
El PreProcessing utiliza ConfigurationCache para obtener los pasos de PreProcessing. Procesa estos datos de diversas maneras.
Después de procesar los datos mediante PreProcessing, los guardamos en HistoryCache para ser procesados. En este punto finaliza la recopilación de datos y pasamos al proceso principal en Zabbix — history syncer, dado que esta es una arquitectura monolítica.
Nota: El PreProcessing es una operación bastante pesada. A partir de la versión 4.2, se ha trasladado al proxy. Si tienes un Zabbix muy grande con una gran cantidad de elementos de datos y frecuencia de recopilación, esto facilita mucho el trabajo.
ValueCache, historial y tendencias de caché
El sincronizador de historial es el proceso principal que procesa atómicamente cada elemento de datos, es decir, cada valor.
El sincronizador de historial toma valores de HistoryCache y verifica la existencia de disparadores en la Configuración para cálculos. Si los hay, los calcula.
El sincronizador de historial crea un evento, una escalación, para generar alertas, si es necesario según la configuración, y lo registra. Si hay disparadores para un procesamiento posterior, recuerda este valor en ValueCache para no consultar la tabla de historial. Así, ValueCache se llena con los datos necesarios para el cálculo de disparadores y elementos calculados.
El sincronizador de historial registra todos los datos en la base de datos, y esta en el disco. El proceso de procesamiento termina aquí.
Caché en la base de datos
Del lado de la base de datos hay varios cachés cuando deseas ver gráficos o informes sobre eventos:
Innodb_buffer_pooldel lado de MySQL;shared_buffersdel lado de PostgreSQL;effective_cache_sizedel lado de Oracle;shared_pooldel lado de DB2.
Hay muchos otros cachés, pero estos son los principales para todas las bases de datos. Permiten mantener en memoria los datos que son necesarios frecuentemente para las consultas. Tienen sus propias tecnologías para ello.
El rendimiento de la base de datos es críticamente importante
El servidor Zabbix recopila constantemente datos y los registra. Al reiniciarse, también lee desde el historial para llenar el ValueCache. Utiliza scripts e informes Zabbix API, que se basa en la interfaz web. Zabbix API consulta la base de datos y obtiene los datos necesarios para gráficos, informes, listas de eventos y problemas recientes.
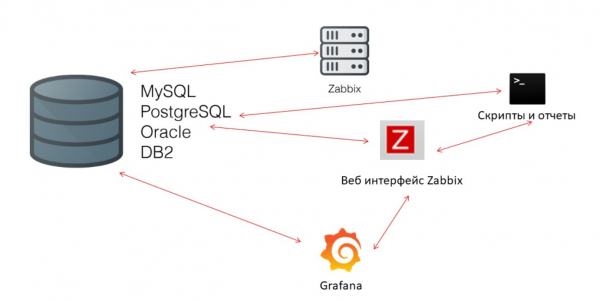
Para visualización — Grafana. Entre nuestros usuarios, esta es una solución popular. Puede enviar directamente consultas a través de Zabbix API y en la base de datos, creando cierta concurrencia para obtener datos. Por lo tanto, se necesita una configuración más matizada y adecuada de la base de datos para cumplir con la rápida entrega de resultados y pruebas.
Housekeeper
La tercera llamada de rendimiento en Zabbix es la limpieza de historial a través de Housekeeper. Cumple con todas las configuraciones — en los elementos de datos se indica cuántos días almacenar la dinámica de cambios (tendencias).
TrendsCache lo calculamos al instante. Cuando llegan datos, los agregamos durante una hora y los registramos en tablas para la dinámica de cambios en tendencias.
Housekeeper se inicia y elimina información de la base de datos mediante consultas «select». Esto no siempre es eficiente, como se puede ver en los gráficos de rendimiento de los procesos internos.
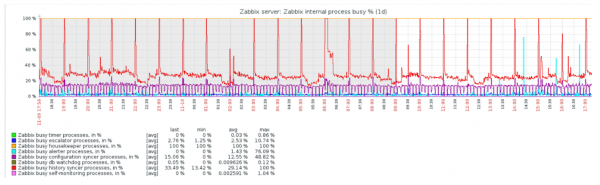
El gráfico rojo muestra que el History syncer está constantemente ocupado. El gráfico naranja en la parte superior es el Housekeeper, que se inicia constantemente. Está esperando que la base de datos elimine todas las filas que ha solicitado.
¿Cuándo debería desactivar el Housekeeper? Por ejemplo, si hay un «Item ID» y se necesitan eliminar las últimas 5,000 filas de un periodo determinado. Por supuesto, esto ocurre a través de los índices. Pero generalmente, el conjunto de datos es muy grande y la base de datos sigue leyendo desde el disco y cargando en caché. Esta siempre es una operación muy costosa para la base de datos y, dependiendo del tamaño de la misma, puede causar problemas de rendimiento.
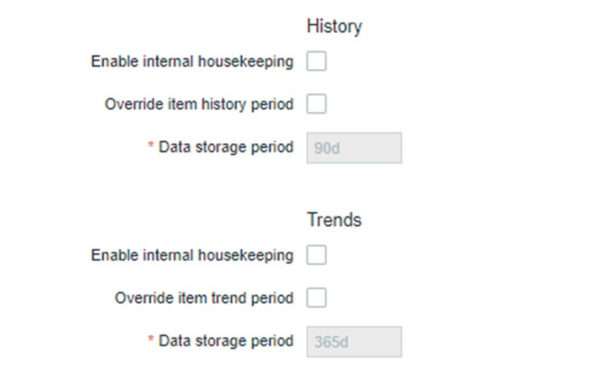
Se puede desactivar fácilmente el Housekeeper. En la interfaz web hay una configuración en «Administración general» para el Housekeeper. Desactivamos el mantenimiento interno para el historial interno de tendencias y este ya no lo gestiona.
Se desactivó el Housekeeper, los gráficos se alinearon. ¿Cuáles podrían ser los problemas en este caso y qué podría ayudar a resolver la tercera llamada de rendimiento?
Partitioning — particionamiento o seccionamiento
Generalmente, el particionamiento se configura de diversas maneras en cada base de datos relacional que he mencionado. Cada una tiene su propia tecnología, pero son similares, en términos generales. Crear una nueva partición a menudo conlleva ciertos problemas.
Generalmente, las particiones se configuran según el «setup» — la cantidad de datos que se generan por día. Por lo general, el Partitioning se establece para un día, que es el mínimo. Para las tendencias, una nueva partición se establece por un mes.
Los valores pueden variar en caso de un «setup» muy grande. Si un «setup» pequeño es de hasta 5,000 nvps (nuevos valores por segundo), mediano es de 5,000 a 25,000, entonces grande es superior a 25,000 nvps. Estas son instalaciones grandes y muy grandes que requieren una cuidadosa configuración de la base de datos.
En instalaciones muy grandes, un segmento de un día puede no ser óptimo. He visto en MySQL particiones de 40 GB o más por día. Este es un volumen de datos muy grande que puede causar problemas y debe reducirse.
¿Qué ofrece el Partitioning?
Particionamiento de tablas. A menudo, estos son archivos separados en el disco. El plan de consultas selecciona de manera más óptima una partición. Por lo general, la partición se utiliza por rango, lo que también es cierto para Zabbix. Allí utilizamos "timestamp" — tiempo desde el inicio de la era. Para nosotros, son números comunes. Usted establece el inicio y el final del día — esta es la partición.
Eliminación rápida — ELIMINAR. Se selecciona un archivo/subtabla, en lugar de una selección de filas para eliminar.
Acelera notablemente la selección de datos SELECCIONAR — utiliza una o más particiones, no toda la tabla. Si solicita datos de hace dos días, se seleccionan de la base de datos más rápido, porque solo se debe cargar en caché y entregar un solo archivo, en lugar de una gran tabla.
A menudo, muchas bases de datos también aceleran INSERTAR — inserciones en la subtabla hija.
TimescaleDB
Para v 4.2 hemos prestado atención a TimescaleDB. Es una extensión para PostgreSQL con una interfaz nativa. La extensión trabaja de manera eficaz con datos de series temporales, sin perder las ventajas de las bases de datos relacionales. TimescaleDB también particiona automáticamente.
En TimescaleDB existe el concepto de hiper tabla (hypertable), que usted crea. En ella se encuentran fragmentos — particiones. Los fragmentos son partes de la hiper tabla gestionadas automáticamente, lo que no afecta a otros fragmentos. Cada fragmento tiene su propio rango temporal.
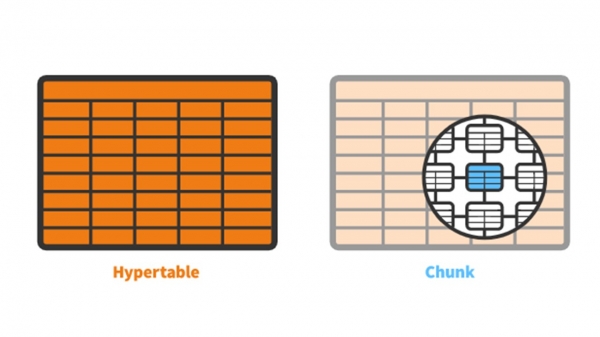
TimescaleDB vs PostgreSQL
TimescaleDB realmente funciona de manera eficiente. Los creadores de la extensión afirman que utilizan un algoritmo de procesamiento de consultas más adecuado, en particular, inserts. Cuando aumentan los tamaños de los conjuntos de datos de inserción, el algoritmo mantiene un rendimiento constante.
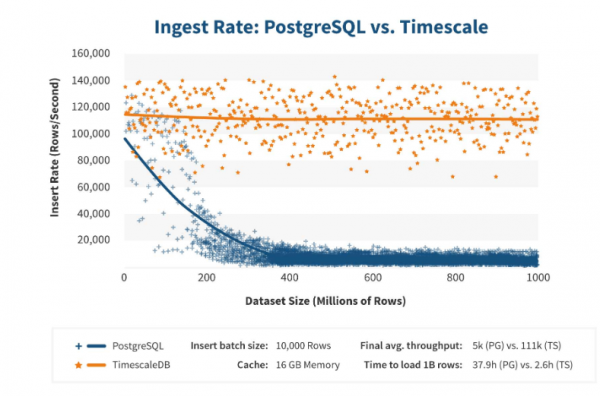
Después de 200 millones de filas, PostgreSQL generalmente comienza a decaer significativamente y pierde rendimiento hasta 0. TimescaleDB permite insertar "inserts" de manera eficiente sin importar el volumen de datos.
Instalación
Instalar TimescaleDB es bastante simple para cualquier paquete. En se describe todo en detalle — depende de los paquetes oficiales de PostgreSQL. TimescaleDB también se puede construir y compilar manualmente.
Para la base de datos Zabbix, simplemente activamos la extensión:
echo "CREATE EXTENSION IF NOT EXISTS timescaledb CASCADE;" | sudo -u postgres psql zabbix Usted activa la extensión y la crea para la base de datos Zabbix. El último paso es crear la hiper tabla.
Migración de tablas de historial a TimescaleDB
Para esto hay una función especial create_hypertable:
SELECT create_hypertable('history', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_unit', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_log', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_text', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('history_str', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('trends', 'clock', chunk_time_interval => 86400, migrate_data => true);
SELECT create_hypertable('trends_unit', 'clock', chunk_time_interval => 86400, migrate_data => true);
UPDATE config SET db_extension='timescaledb', hk_history_global=1, hk_trends_global=1
La función tiene tres parámetros. Primero — la tabla en la base de datos, para la que se necesita crear la hiperatabla. Segundo — el campo, por el que se debe crear chunk_time_interval — el intervalo de chunk de las particiones a utilizar. En mi caso, el intervalo es de un día — 86,400.
El tercer parámetro — migrar_datos. Si se establece true, todos los datos existentes se trasladan a los chunks creados de antemano. Yo mismo utilicé migrar_datos. Tenía alrededor de 1 TB, lo que tomó más de una hora. Incluso en algunos casos, durante las pruebas, eliminé datos históricos de tipo carácter innecesarios para no transferirlos.
El último paso — ACTUALIZAR: en db_extension colocamos timescaledb, para que la base de datos entienda que existe esta extensión. Zabbix la activa y utiliza correctamente la sintaxis y las consultas hacia la base de datos — las funciones necesarias para TimescaleDB.
Configuración de hardware
Utilicé dos servidores. Primero — una máquina VMware. Es bastante pequeña: 20 procesadores Intel® Xeon® CPU E5-2630 v 4 @ 2.20GHz, 16 GB de RAM y un disco SSD de 200 GB.
Instalé PostgreSQL 10.8 en ella con el sistema operativo Debian 10.8-1.pgdg90+1 y el sistema de archivos xfs. Todo configuré de forma mínima para utilizar exactamente esta base de datos, excepto lo que usará Zabbix.
En esta misma máquina se encontraba el servidor de Zabbix, PostgreSQL y los agentes de carga. Tenía 50 agentes activos que utilizaban LoadableModule, para generar rápidamente diferentes resultados: números, cadenas. Llené la base de datos con una gran cantidad de datos.
Inicialmente, la configuración contenía 5,000 elementos de datos por cada host. Casi cada elemento contenía un disparador, para que se pareciera a instalaciones reales. En algunos casos había más de un disparador. Por cada nodo de la red había 3,000-7,000 disparadores..
El intervalo de actualización de los elementos de datos — 4-7 segundos.. Regule la carga utilizando no solo 50 agentes, sino que también añadí más. Además, mediante elementos de datos dinámicos, regulé la carga y reduje el intervalo de actualización a 4 s.
PostgreSQL. 35,000 nvps
El primer inicio en este hardware fue con PostgreSQL en limpio — 35,000 valores por segundo. Como se puede ver, la inserción de datos toma fracciones de segundo — todo va bien y rápido. La única desventaja es que el disco SSD de 200 GB se llena rápidamente.
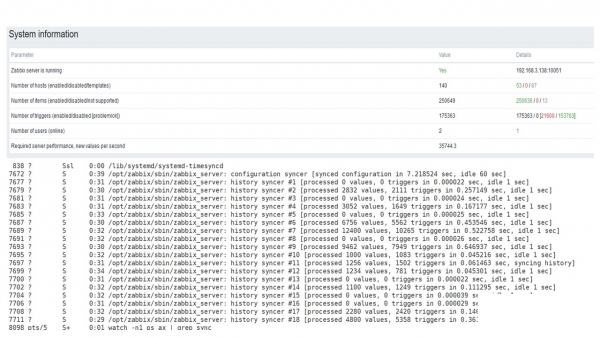
Este es el dashboard de rendimiento estándar de Zabbix — servidores.
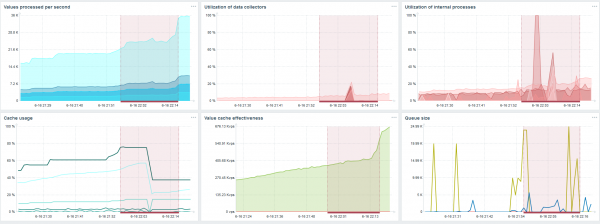
La primera gráfica azul muestra la cantidad de valores por segundo. La segunda gráfica a la derecha muestra la carga de procesos de recopilación. La tercera — carga de procesos internos de recopilación: history syncers y Housekeeper, que aquí se ejecutó durante suficiente tiempo.
La cuarta gráfica muestra el uso de HistoryCache. Este es un tipo de buffer antes de la inserción en la base de datos. La quinta gráfica verde muestra el uso de ValueCache, es decir, cuántos hits de ValueCache para disparadores — esto son varios miles de valores por segundo.
PostgreSQL. 50,000 nvps
Luego aumenté la carga a 50,000 valores por segundo en el mismo hardware.
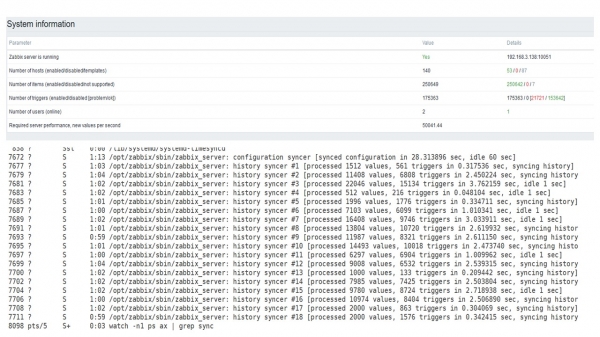
Al cargar con Housekeeper, la inserción de 10,000 valores se registró en 2-3 s.
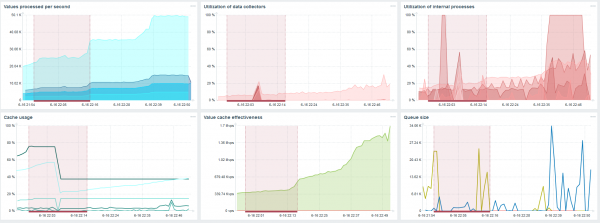
Housekeeper ya está empezando a interferir en el trabajo.
En la tercera gráfica se puede ver que, en general, la carga de los trapper y history syncers todavía está en el 60%. En la cuarta gráfica, HistoryCache durante el trabajo de Housekeeper ya comienza a llenarse activamente. Se llenó en un 20% — esto es alrededor de 0.5 GB.
PostgreSQL. 80,000 nvps
Luego aumenté la carga a 80,000 valores por segundo. Esto son aproximadamente 400,000 elementos de datos y 280,000 disparadores.
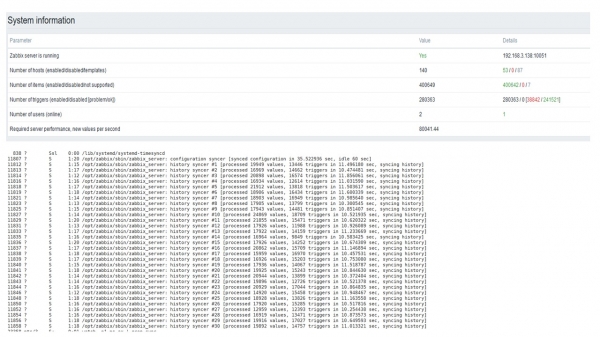
La inserción con la carga de treinta history syncers ya es bastante alta.
También aumenté varios parámetros: history syncers, caches.
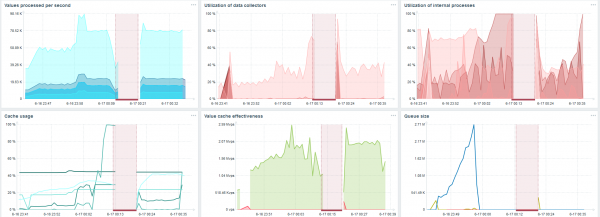
En mi hardware, la carga de history syncers aumentó al máximo. HistoryCache se llenó rápidamente de datos — se acumularon datos en el buffer para su procesamiento.
Durante todo este tiempo observé cómo se utilizaba la CPU, la memoria RAM y otros parámetros del sistema, y descubrí que la utilización de los discos era máxima.
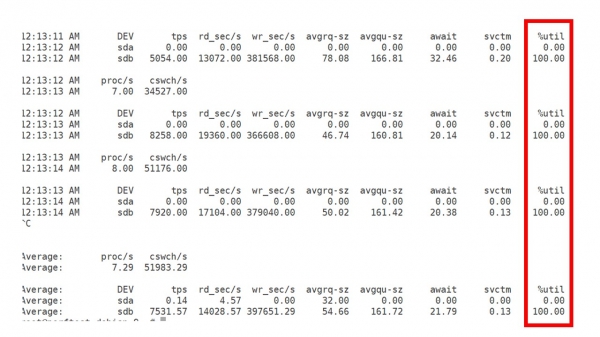
Logré utilizar las capacidades máximas del disco en este hardware y en esta máquina virtual. Con tal intensidad, PostgreSQL comenzó a descartar datos de manera activa, y el disco ya no podía seguir trabajando en la escritura y lectura.
Segundo servidor
Tomé otro servidor que ya tenía 48 procesadores y 128 GB de memoria RAM. Lo ajusté y le puse 60 history syncers, logrando un rendimiento aceptable.
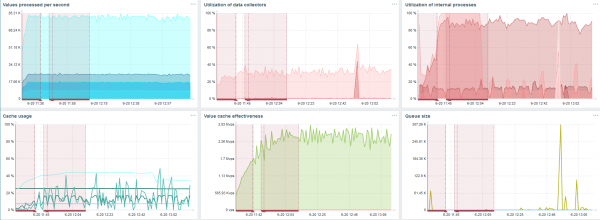
De hecho, esto ya es el límite de rendimiento, donde se necesita hacer algo.
TimescaleDB. 80,000 nvps
Mi principal tarea es probar las capacidades de TimescaleDB bajo la carga de Zabbix. 80 mil valores por segundo es mucho, la frecuencia de recolección de métricas (excepto Yandex, por supuesto) y es un 'setup' bastante grande.
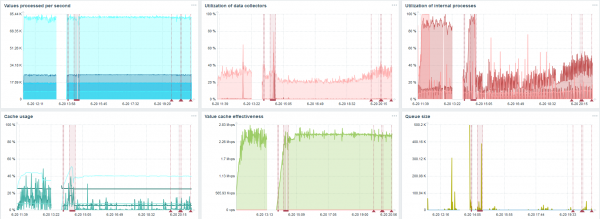
En cada gráfico hay un bajón, que es justo durante la migración de datos. Después de los bajones en el servidor Zabbix, el perfil de carga del history syncer cambió drásticamente: cayó tres veces.
TimescaleDB permite insertar datos prácticamente tres veces más rápido y utilizar menos HistoryCache.
Por lo tanto, los datos se entregarán a tiempo.
TimescaleDB. 120,000 nvps
Luego aumenté la cantidad de elementos de datos a 500 mil. La tarea principal era probar las capacidades de TimescaleDB, obtuve un valor calculado de 125 mil valores por segundo.
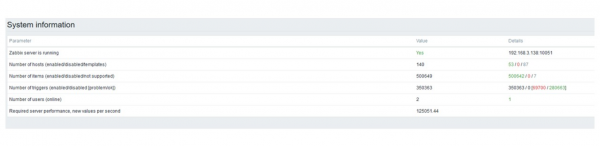
Este es un 'setup' funcional que puede operar durante mucho tiempo. Pero dado que mi disco era solo de 1.5 TB, lo llené en un par de días.
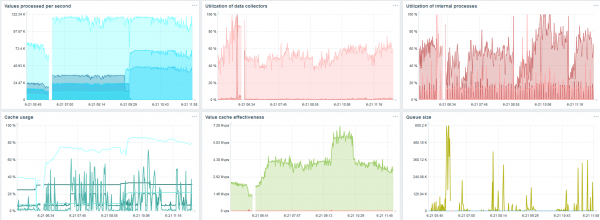
Lo más importante es que al mismo tiempo se estaban creando nuevas particiones en TimescaleDB.
Para el rendimiento, esto es completamente imperceptible. Cuando se crean particiones en MySQL, por ejemplo, todo es diferente. Por lo general, sucede por la noche, porque bloquea la inserción general, el trabajo con tablas y puede causar degradación del servicio. En el caso de TimescaleDB, esto no ocurre.
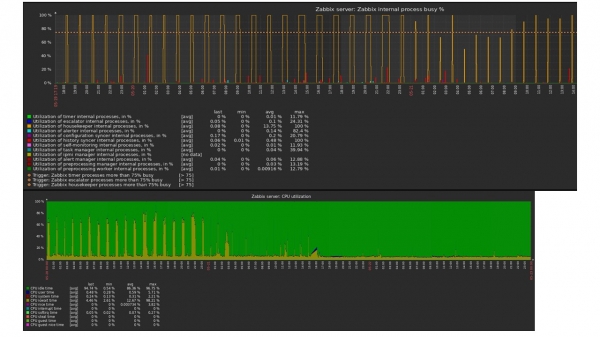
Como ejemplo, mostraré un gráfico de los muchos en la comunidad. En la imagen, TimescaleDB está habilitado, gracias a ello la carga por uso de io.weight en el procesador ha disminuido. El uso de los elementos de procesos internos también ha bajado. De hecho, es una máquina virtual estándar con discos tradicionales, no SSD.
Conclusiones
TimescaleDB es una buena solución para pequeños 'setups', que se ven limitados por el rendimiento del disco. Permite seguir funcionando bien hasta la migración de la base de datos a un hardware más rápido.
TimescaleDB es fácil de configurar, proporciona un aumento de rendimiento, funciona bien con Zabbix y tiene ventajas sobre PostgreSQL..
Si usas PostgreSQL y no planeas cambiarlo, te recomiendo usar PostgreSQL con la extensión TimescaleDB junto con Zabbix.Esta solución funciona eficazmente hasta 'setups' medianos.
Cuando decimos 'alto rendimiento', nos referimos a . No falta mucho para conocer las tecnologías y prácticas que permiten a los servicios atender a millones de usuarios. Lista para los días 7 y 8 de noviembre ya hemos preparado, pero aún se pueden proponer.
Suscríbanse a nuestro y , en el que revelamos detalles sobre la próxima conferencia y descubran cómo obtener el máximo beneficio.
Fuente: habr.com
