

VictoriaMetrics, TimescaleDB e InfluxDB se compararon en un conjunto de datos con mil millones de puntos de datos pertenecientes a 40K series temporales únicas.
Hace unos años, existía la era de Zabbix. Cada servidor bare metal tenía no más de unos pocos indicadores: uso de CPU, uso de memoria, uso de disco y uso de red. Así, las métricas de miles de servidores podían caber en 40 mil series temporales únicas, y Zabbix podía usar MySQL como backend para esos datos 🙂
Actualmente, un con configuraciones por defecto proporciona más de 500 métricas en un host promedio. Hay numerosos para diversas bases de datos, servidores web, sistemas de hardware, etc. Todos ellos proporcionan una gran cantidad de métricas útiles. Cada vez comienzan a exponer diversas métricas sobre sí mismas. Está Kubernetes con clústeres y pods que revelan múltiples métricas. Esto lleva a que los servidores expongan miles de métricas únicas en el host. Por lo tanto, una serie temporal única de 40K ya no es un gran desafío. Se convierte en algo común que debe ser fácilmente manejado por cualquier TSDB moderna en un solo servidor.
¿Qué significa tener una gran cantidad de series temporales únicas en este momento? ¿Quizás 400K o 4M? ¿O 40M? Vamos a comparar las TSDB modernas con estas cifras.
Establecer un punto de referencia
es una excelente herramienta de benchmarking para las TSDB. Permite generar una cantidad arbitraria de métricas al pasar el número necesario de series temporales, dividido por 10 — el flag (anteriormente -scale-var). 10 es el número de dimensiones (métricas) generadas en cada host, servidor. Los siguientes conjuntos de datos fueron creados con TSBS para el benchmarking:
- 400K series temporales únicas, intervalo de 60 segundos entre puntos de datos, los datos abarcan un total de 3 días, ~1.7B total de puntos de datos.
- 4M series temporales únicas, intervalo de 600 segundos, los datos abarcan un total de 3 días, ~1.7B total de puntos de datos.
- 40M series temporales únicas, intervalo de 1 hora, los datos abarcan un total de 3 días, ~2.8B total de puntos de datos.
El cliente y el servidor se ejecutaron en instancias dedicadas en la nube de Google. Estas instancias tenían las siguientes configuraciones:
- vCPUs: 16
- RAM: 60 GB
- Almacenamiento: disco duro estándar de 1 TB. Proporciona un ancho de banda de lectura/escritura de 120 Mbit/s, 750 lecturas por segundo y 1,5K escrituras por segundo.
Los TSDB fueron extraídos de imágenes oficiales de docker y ejecutados en docker con las siguientes configuraciones:
VictoriaMetrics:
docker run -it --rm -v /mnt/disks/storage/vmetrics-data:/victoria-metrics-data -p 8080:8080 valyala/victoria-metricsLos valores de InfluxDB (-e son necesarios para mantener un alto rendimiento. Para más detalles, consulte ):
docker run -it --rm -p 8086:8086
-e INFLUXDB_DATA_MAX_VALUES_PER_TAG=4000000
-e INFLUXDB_DATA_CACHE_MAX_MEMORY_SIZE=100g
-e INFLUXDB_DATA_MAX_SERIES_PER_DATABASE=0
-v /mnt/disks/storage/influx-data:/var/lib/influxdb influxdb
TimescaleDB (la configuración fue tomada de el archivo):
MEM=`free -m | grep "Mem" | awk ‘{print $7}’`
let "SHARED=$MEM/4"
let "CACHE=2*$MEM/3"
let "WORK=($MEM-$SHARED)/30"
let "MAINT=$MEM/16"
let "WAL=$MEM/16"
docker run -it --rm -p 5432:5432
--shm-size=${SHARED}MB
-v /mnt/disks/storage/timescaledb-data:/var/lib/postgresql/data timescale/timescaledb:latest-pg10 postgres
-cmax_wal_size=${WAL}MB
-clog_line_prefix="%m [%p]: [%x] %u@%d"
-clogging_collector=off
-csynchronous_commit=off
-cshared_buffers=${SHARED}MB
-ceffective_cache_size=${CACHE}MB
-cwork_mem=${WORK}MB
-cmaintenance_work_mem=${MAINT}MB
-cmax_files_per_process=100
El cargador de datos se ejecutó con 16 hilos en paralelo.
Este artículo contiene solo los resultados de métricas de inserción. Los resultados de la evaluación de referencia de muestreo se publicarán en un artículo separado.
400K series temporales únicas
Comencemos con los elementos simples: 400K. Resultados de la referencia:
- VictoriaMetrics: 2,6M puntos de datos por segundo; uso de memoria: 3 GB; tamaño final de los datos en disco: 965 MB
- InfluxDB: 1.2M puntos de datos por segundo; uso de memoria: 8.5 GB; tamaño final de los datos en disco: 1.6 GB
- Timescale: 849K puntos de datos por segundo; uso de memoria: 2,5 GB; tamaño final de los datos en disco: 50 GB
Como se puede ver en los resultados anteriores, VictoriaMetrics gana en rendimiento de inserción y grado de compresión. Timescale gana en uso de memoria, pero utiliza mucho espacio en disco: 29 bytes por punto de datos.
A continuación se muestran gráficos de uso de CPU para cada uno de los TSDB durante la evaluación de referencia:
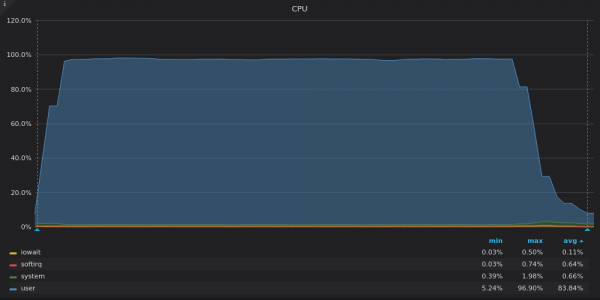
Captura de pantalla anterior: VictoriaMetrics — Carga de CPU durante la prueba de inserción para la métrica única 400K.
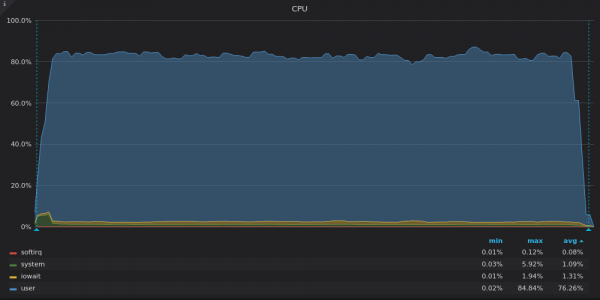
Captura de pantalla anterior: InfluxDB — Carga de CPU durante la prueba de inserción para la métrica única 400K.
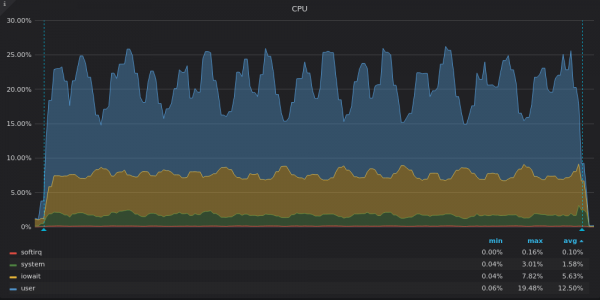
Captura de pantalla anterior: TimescaleDB — Carga de CPU durante la prueba de inserción para la métrica única 400K.
VictoriaMetrics utiliza todos los vCPUs disponibles, mientras que InfluxDB utiliza insuficientemente aproximadamente 2 de 16 vCPUs.
Timescale utiliza solo 3-4 de 16 vCPUs. Las altas proporciones de iowait y system en el gráfico de TimescaleDB indican un cuello de botella en el subsistema de entrada/salida (I/O). Veamos los gráficos de uso de ancho de banda del disco:
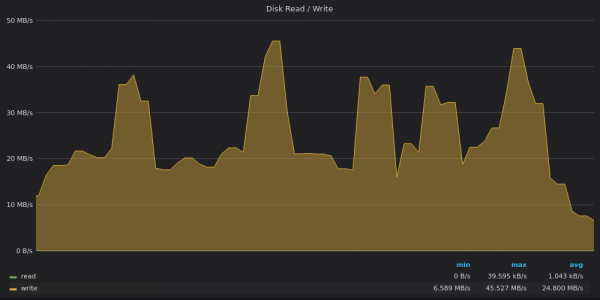
Captura de pantalla anterior: VictoriaMetrics — Uso de ancho de banda del disco en la prueba de inserción para métricas únicas de 400K.
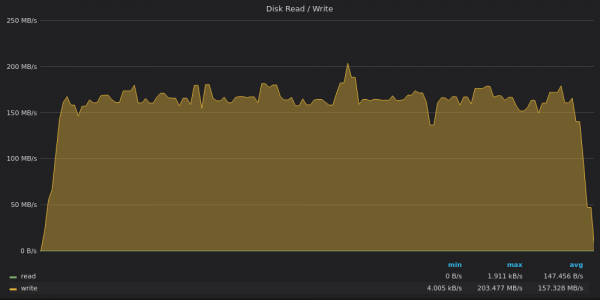
Captura de pantalla anterior: InfluxDB — Uso de ancho de banda del disco en la prueba de inserción para métricas únicas de 400K.
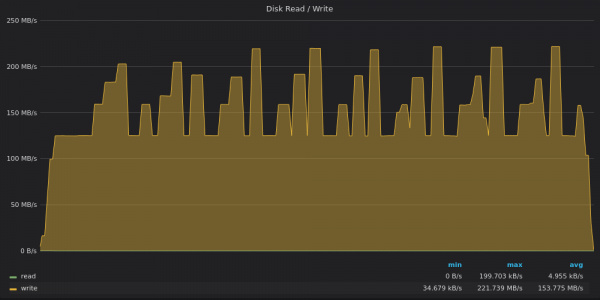
Captura de pantalla anterior: TimescaleDB — Uso de ancho de banda del disco en la prueba de inserción para métricas únicas de 400K.
VictoriaMetrics escribe datos a una velocidad de 20 Mbps con picos de hasta 45 Mbps. Los picos corresponden a grandes fusiones parciales en el árbol .
InfluxDB escribe datos a una velocidad de 160 MB/s, mientras que un disco de 1 TB a una capacidad de escritura de 120 MB/s.
TimescaleDB está limitada a una capacidad de escritura de 120 Mbps, pero a veces supera este límite alcanzando 220 Mbps en picos. Estos picos corresponden a caídas de carga de CPU insuficiente en el gráfico anterior.
Veamos los gráficos de uso de entrada/salida (I/O):
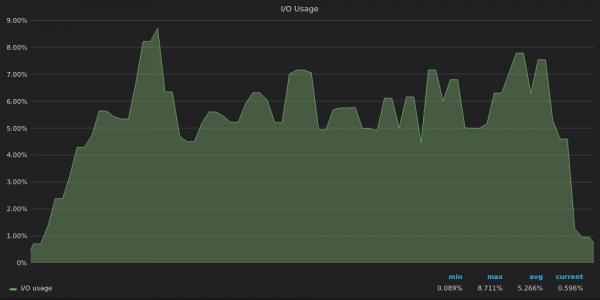
Captura de pantalla anterior: VictoriaMetrics — Uso de entrada/salida en la prueba de inserción para 400K métricas únicas.
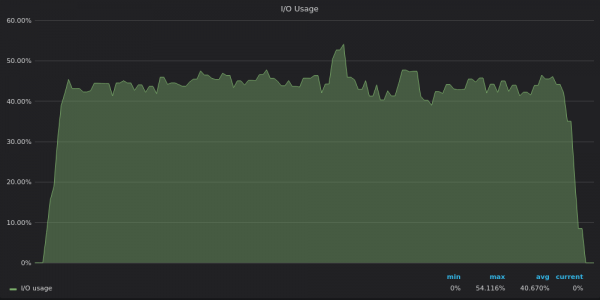
Captura de pantalla anterior: InfluxDB — Uso de entrada/salida en la prueba de inserción para 400K métricas únicas.
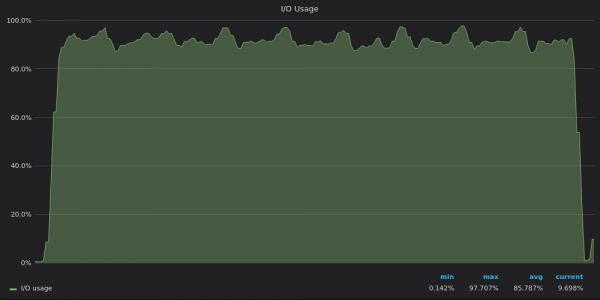
Captura de pantalla anterior: TimescaleDB — Uso de entrada/salida en la prueba de inserción para 400K métricas únicas.
Ahora está claro que TimescaleDB alcanza el límite de entrada/salida, por lo tanto, no puede utilizar los 12 vCPUs restantes.
4M series temporales únicas
4M series temporales parecen un poco desafiantes. Pero nuestros competidores pasan este examen con éxito. Resultados de la evaluación de rendimiento:
- VictoriaMetrics: 2,2M puntos de datos por segundo; uso de memoria: 6 GB; tamaño final de los datos en disco: 3 GB.
- InfluxDB: 330K puntos de datos por segundo; uso de memoria: 20,5 GB; tamaño final de los datos en disco: 18,4 GB.
- TimescaleDB: 480K puntos de datos por segundo; uso de memoria: 2,5 GB; tamaño final de los datos en disco: 52 GB.
El rendimiento de InfluxDB ha caído de 1,2 millones de puntos de datos por segundo para 400K series temporales a 330 mil puntos de datos por segundo para 4M series temporales. Esta es una pérdida de rendimiento significativa en comparación con otros competidores. Veamos los gráficos de uso de CPU para entender la causa raíz de esta pérdida:
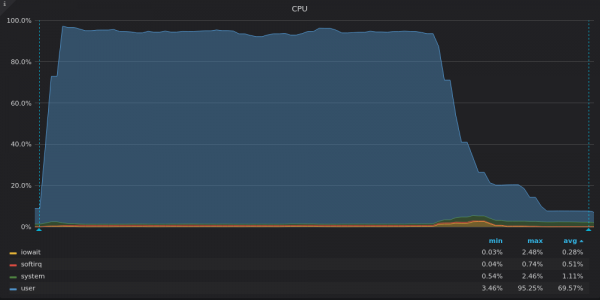
Captura de pantalla anterior: VictoriaMetrics — Uso de CPU en la prueba de inserción para una serie temporal única de 4M.
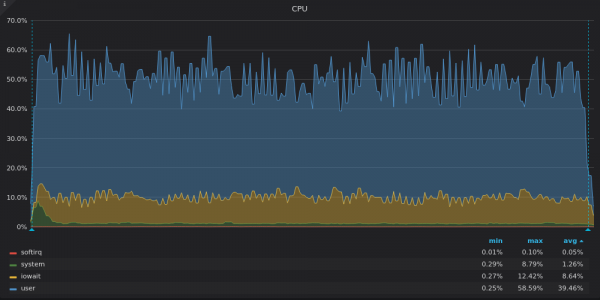
Captura de pantalla anterior: InfluxDB — Uso de CPU en la prueba de inserción para una serie temporal única de 4M.
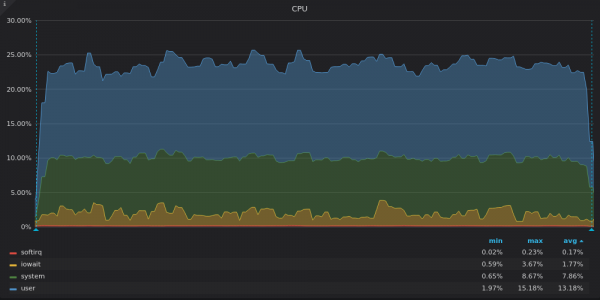
Captura de pantalla anterior: TimescaleDB — Uso de CPU en la prueba de inserción para una serie temporal única de 4M.
VictoriaMetrics utiliza casi toda la potencia de la CPU. La caída al final corresponde a las fusiones de LSM restantes después de insertar todos los datos.
InfluxDB utiliza solo 8 de 16 vCPUs, mientras que TimescaleDB utiliza 4 de 16 vCPUs. ¿Qué tienen en común sus gráficos? Una alta proporción de iowait, lo que nuevamente indica un cuello de botella de entrada/salida.
TimescaleDB tiene una alta proporción de system. Creemos que la alta carga ha llevado a muchas llamadas al sistema o a muchos .
Veamos los gráficos de rendimiento del disco:
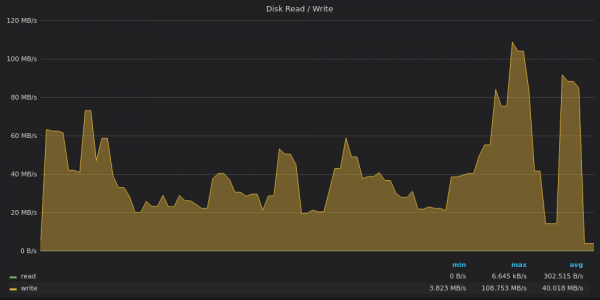
Captura de pantalla anterior: VictoriaMetrics — Uso del ancho de banda del disco para insertar 4M métricas únicas.
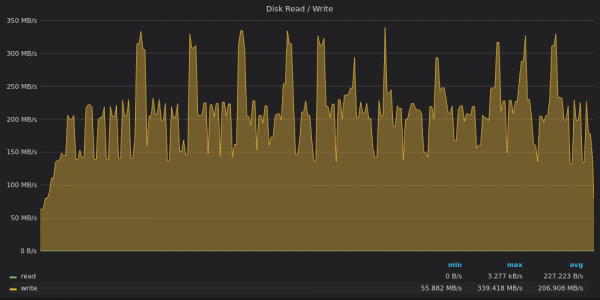
Captura de pantalla anterior: InfluxDB — Uso del ancho de banda del disco para insertar 4M métricas únicas.
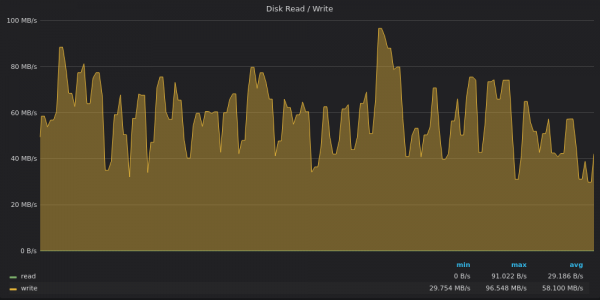
Captura de pantalla anterior: TimescaleDB — Uso del ancho de banda del disco para insertar 4M métricas únicas.
VictoriaMetrics alcanzó un límite de 120 MB/s en picos, mientras que la velocidad de escritura promedio fue de 40 MB/s. Probablemente, durante el pico se realizaron varias fusiones pesadas de LSM.
InfluxDB nuevamente logra una capacidad promedio de escritura de 200 MB/s con picos de hasta 340 MB/s en un disco con un límite de escritura de 120 MB/s 🙂
TimescaleDB ya no está limitado por el disco. Parece que está restringido por algo más relacionado con la alta proporción de carga sistema de CPU.
Veamos los gráficos de uso de IO:
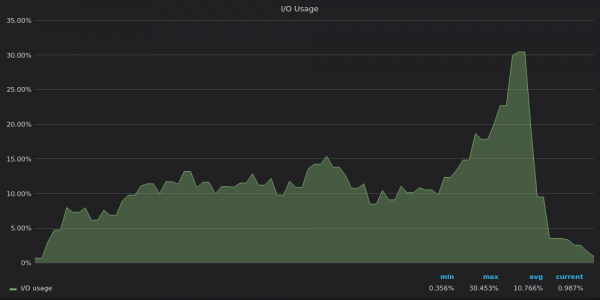
Captura de pantalla anterior: VictoriaMetrics — Uso de entrada/salida durante la prueba de inserción para una serie temporal única de 4M.
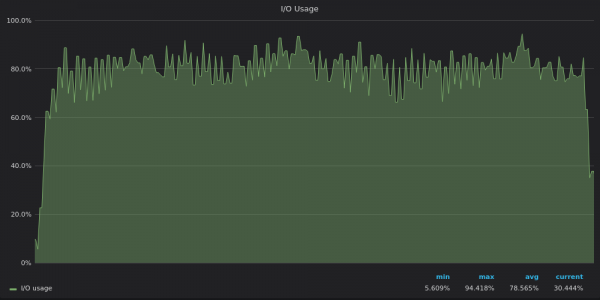
Captura de pantalla anterior: InfluxDB — Uso de entrada/salida durante la prueba de inserción para una serie temporal única de 4M.
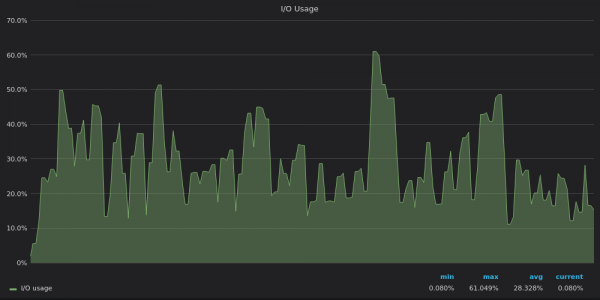
Captura de pantalla anterior: TimescaleDB — Uso de entrada/salida durante la prueba de inserción para una serie temporal única de 4M.
Los gráficos de uso de IO replican los gráficos de uso del ancho de banda del disco: InfluxDB está limitado en IO, mientras que VictoriaMetrics y TimescaleDB cuentan con recursos de entrada y salida de IO disponibles.
40M series temporales únicas
40M series temporales únicas fueron demasiado grandes para InfluxDB 🙁
Resultados de la prueba de rendimiento:
- VictoriaMetrics: 1.7M puntos de datos por segundo; uso de memoria: 29 GB; uso de espacio en disco: 17 GB.
- InfluxDB: no finalizó porque requirió más de 60 GB de memoria RAM.
- TimescaleDB: 330K puntos de datos por segundo; uso de memoria: 2.5 GB; uso de espacio en disco: 84 GB.
TimescaleDB muestra un uso de memoria excepcionalmente bajo y estable: 2.5 GB, lo mismo que para métricas únicas de 4M y 400K.
VictoriaMetrics aumentaba lentamente a 100 mil puntos de datos por segundo hasta que se procesaron todos los 40M nombres de métricas con etiquetas. Luego alcanzó una velocidad de inserción estable de 1.5-2.0M puntos de datos por segundo, así que el resultado final fue de 1.7M puntos de datos por segundo.
Los gráficos para 40M series temporales únicas son similares a los gráficos para 4M series temporales únicas, así que los omitiremos.
Conclusiones
- Los TSDB modernos pueden manejar inserciones para millones de series temporales únicas en un solo servidor. En el próximo artículo, analizaremos qué tan bien los TSDB realizan consultas sobre millones de series temporales únicas.
- La baja carga de CPU generalmente indica un cuello de botella en la entrada y salida. Además, esto puede indicar un bloqueo demasiado grosero, donde solo unos pocos hilos pueden ejecutarse a la vez.
- El cuello de botella de E/S realmente existe, especialmente en almacenamiento sin SSD, como dispositivos de bloque virtualizados de proveedores de nube.
- VictoriaMetrics proporciona la mejor optimización para almacenamiento lento con bajo rendimiento de E/S. Ofrece la mejor velocidad y el mejor nivel de compresión.
Descargue y pruébelo con sus datos. El archivo binario estático correspondiente está disponible en .
Para más información sobre VictoriaMetrics, consulte este .
Actualización: se ha publicado un con resultados reproducibles.
Actualización #2: Lee también .
Actualización #3: !
Chat de Telegram:
Fuente: habr.com
