

Hola, me dedico a la creación de aplicaciones para bases de datos. — es una plataforma desarrollada por Mail.ru Group que combina una base de datos de alto rendimiento con un servidor de aplicaciones en el lenguaje Lua. La alta velocidad de funcionamiento de las soluciones basadas en Tarantool se logra, en particular, gracias al soporte del modo en memoria de la base de datos y la posibilidad de ejecutar la lógica de negocio de la aplicación en un único espacio de direcciones junto con los datos. Además, se garantiza la persistencia de los datos mediante transacciones ACID (se mantiene un registro WAL en el disco). Tarantool cuenta con soporte integrado para replicación y sharding. Desde la versión 2.1, se admiten consultas en lenguaje SQL. Tarantool tiene código abierto y se distribuye bajo la licencia Simplified BSD. También existe una versión comercial Enterprise.
¡Siente el poder! (…es decir, disfruta del rendimiento)
Todo lo anterior hace de Tarantool una plataforma atractiva para la creación de aplicaciones de alta carga que trabajan con bases de datos. En tales aplicaciones, a menudo surge la necesidad de replicar datos.
Como se mencionó anteriormente, Tarantool tiene replicación de datos integrada. Su principio de funcionamiento consiste en la ejecución secuencial en las réplicas de todas las transacciones que se contienen en el registro del maestro (WAL). Normalmente, dicha replicación (que a partir de ahora llamaremos de nivel bajo) se utiliza para garantizar la resistencia a fallos de la aplicación y/o para distribuir la carga de lectura entre los nodos del clúster.
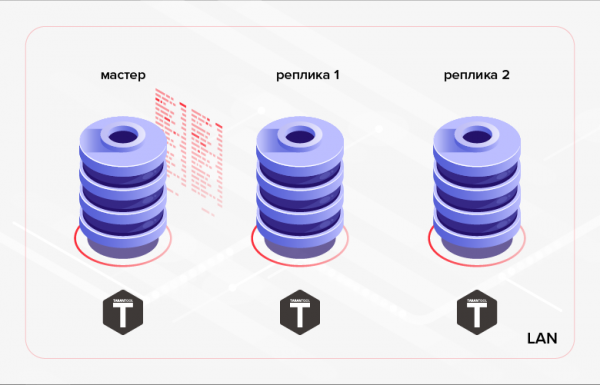
Fig. 1. Replicación dentro del clúster
Un ejemplo de un escenario alternativo puede ser la transferencia de datos creados en una base de datos a otra base de datos para su procesamiento/monitorización. En este último caso, una solución más conveniente podría ser el uso de replicación de alto nivel — replicación de datos a nivel de la lógica de negocio de la aplicación. Es decir, no utilizamos una solución lista integrada en la base de datos, sino que implementamos la replicación dentro de nuestra propia aplicación. Este enfoque tiene tanto ventajas como desventajas. Enumeremos los pros.
1. Ahorro de tráfico:
- se pueden transferir no todos los datos, sino solo una parte de ellos (por ejemplo, se pueden transferir solo algunas tablas, algunas de sus columnas o registros que cumplan ciertos criterios);
- A diferencia de la replicación de bajo nivel, que se realiza de manera continua en modo asincrónico (implementado en la versión actual de Tarantool — 1.10) o sincrónico (que se implementará en versiones posteriores de Tarantool), la replicación de alto nivel se puede realizar en sesiones (es decir, la aplicación primero sincroniza los datos — una sesión de intercambio de datos, luego hay una pausa en la replicación, después de la cual ocurre la siguiente sesión de intercambio, etc.).
- Si un registro ha cambiado varias veces, solo se puede transmitir su última versión (a diferencia de la replicación de bajo nivel, donde todos los cambios realizados en el maestro se reproducen secuencialmente en las réplicas).
2. No hay complicaciones con la implementación del intercambio a través de HTTP, lo que permite sincronizar bases de datos remotas.
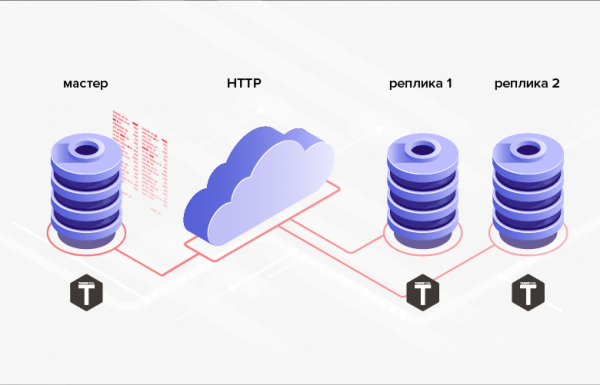
Fig. 2. Replicación a través de HTTP
3. Las estructuras de base de datos entre las que se transmiten los datos no necesitan ser idénticas (de hecho, en general, es posible incluso utilizar diferentes sistemas de bases de datos, lenguajes de programación, plataformas, etc.).
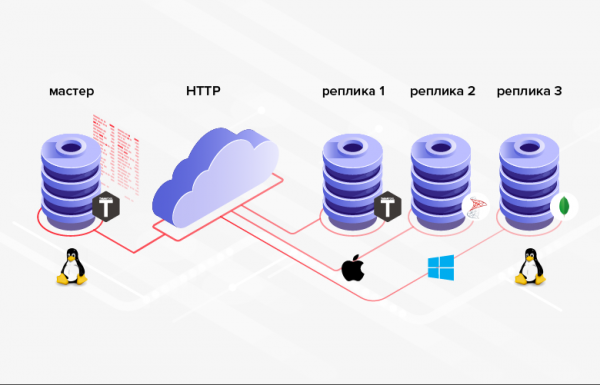
Fig. 3. Replicación en sistemas heterogéneos
La desventaja es que, en promedio, la programación es más difícil/costosa que la configuración, y en lugar de ajustar la funcionalidad integrada, se debe implementar la propia.
Si en su situación, los beneficios mencionados son decisivos (o son un requisito necesario), entonces tiene sentido utilizar la replicación de alto nivel. Consideremos algunas formas de implementar la replicación de alto nivel de datos en la base de datos Tarantool.
Minimización del tráfico
Por lo tanto, una de las ventajas de la replicación de alto nivel es el ahorro de tráfico. Para que esta ventaja se manifieste plenamente, es necesario minimizar la cantidad de datos transmitidos en cada sesión de intercambio. Por supuesto, no debemos olvidar que al final de la sesión, el receptor de los datos debe estar sincronizado con la fuente (al menos en la parte de los datos que participa en la replicación).
¿Cómo minimizar la cantidad de datos transmitidos en la replicación de alto nivel? Una solución simple podría ser seleccionar datos por fecha y hora. Para ello, se puede utilizar un campo de fecha y hora ya existente en la tabla (si lo hay). Por ejemplo, un documento de "pedido" puede tener un campo de "fecha y hora de ejecución requerida" — tiempo_de_entrega. El problema de esta solución es que los valores en este campo no necesariamente deben estar dispuestos en un orden que corresponda a la creación de pedidos. Así, no podemos recordar el valor máximo del campo tiempo_de_entrega, transmitido durante la sesión de intercambio anterior, y en la siguiente sesión de intercambio seleccionar todos los registros con un valor de campo más alto tiempo_de_entrega. Entre las sesiones de intercambio, podrían haberse añadido registros con un valor de campo menor tiempo_de_entrega. Además, el pedido podría haber cambiado, aunque esto no afectase al campo tiempo_de_entrega. En ambos casos, las modificaciones no se transmitirán del origen al receptor. Para resolver estos problemas, necesitaremos transmitir datos "superpuestos". Es decir, en cada sesión de intercambio, transmitiremos todos los datos con un valor de campo tiempo_de_entrega, que supere un cierto momento en el pasado (por ejemplo, N horas desde el momento actual). Sin embargo, es evidente que para sistemas grandes este enfoque es bastante redundante y puede anular el ahorro de tráfico que buscamos. Además, en la tabla transmitida puede no haber un campo relacionado con la fecha-hora.
Otra solución, más complicada en términos de implementación, consiste en confirmar la recepción de datos. En este caso, en cada sesión de intercambio se envían todos los datos cuya recepción no ha sido confirmada por el receptor. Para implementarlo, será necesario agregar una columna booleana a la tabla de origen (por ejemplo, is_transferred). Si el receptor confirma la recepción de un registro, el campo correspondiente toma el valor true, tras lo cual el registro no participa más en los intercambios. Esta variante de implementación tiene las siguientes desventajas. En primer lugar, para cada registro transmitido es necesario generar y enviar una confirmación. Grosso modo, esto puede ser comparable a duplicar la cantidad de datos transmitidos y llevar a duplicar la cantidad de viajes de ida y vuelta. En segundo lugar, no existe la posibilidad de enviar el mismo registro a varios receptores (el primer receptor que lo reciba confirmará la recepción en su nombre y en el de todos los demás).
Un método libre de los inconvenientes mencionados anteriormente consiste en agregar a la tabla transmitida una columna para rastrear los cambios en sus filas. Esta columna puede tener un tipo de fecha y hora y debe ser establecida/actualizada por la aplicación al tiempo actual cada vez que se añadan/cambien registros (de manera atómica con la adición/cambio). Tomemos como ejemplo la columna update_time. Al guardar el valor máximo del campo de esta columna para los registros transmitidos, podremos comenzar la siguiente sesión de intercambio a partir de ese valor (extraer registros con un valor de campo update_time, que supere el valor guardado anteriormente). El problema con este último enfoque es que los cambios en los datos pueden ocurrir de manera masiva. Como resultado, los valores en el campo de la columna update_time pueden no ser únicos. Por lo tanto, esta columna no puede ser utilizada para una entrega incremental (paginada) de datos. Para la entrega paginada de datos, será necesario inventar mecanismos adicionales, que probablemente tendrán una eficiencia muy baja (por ejemplo, extrayendo de la base de datos todos los registros con un valor update_time superior al especificado y entregando una cantidad determinada de registros, comenzando desde un cierto desplazamiento desde el inicio de la selección).
Se puede aumentar la eficiencia de la transmisión de datos mejorando ligeramente el enfoque anterior. Para esto, usaremos un tipo entero (entero largo) como valores de campo para la columna de rastreo de cambios. Llamaremos a esta columna row_ver. El valor del campo de esta columna aún debe ser establecido/actualizado cada vez que se crea/cambia un registro. Pero en este caso, el campo no obtendrá la fecha y hora actuales, sino un valor de algún contador, incrementado en uno. Como resultado, la columna row_ver contendrá valores únicos y podrá ser utilizada no solo para la entrega de "delta" de datos (datos que se añadieron/cambiaron después de finalizar la sesión de intercambio anterior), sino también para una segmentación simple y eficiente en páginas.
El último método propuesto para minimizar la cantidad de datos transmitidos en el marco de la replicación de alto nivel me parece el más óptimo y versátil. Detengámonos en él con más detalle.
La transmisión de datos utilizando contador de versiones de filas
Implementación de la parte del servidor / maestro
En MS SQL Server, para implementar un enfoque similar, existe un tipo de columna especial — rowversion. Cada base de datos tiene un contador que aumenta en uno cada vez que se añade o modifica un registro en la tabla que tiene una columna del tipo rowversion. El valor de este contador se asigna automáticamente al campo de esta columna en el registro añadido o modificado. La base de datos Tarantool no tiene un mecanismo incorporado similar. Sin embargo, en Tarantool, se puede implementar fácilmente de manera manual. Veamos cómo se hace.
Primero, un poco de terminología: las tablas en Tarantool se llaman espacios (space), y los registros — tuplas (tuple). En Tarantool se pueden crear secuencias (sequence). Las secuencias son generadores nombrados de valores enteros ordenados. Es decir, es justo lo que necesitamos para nuestros fines. A continuación, crearemos tal secuencia.
Antes de realizar cualquier operación en la base de datos en Tarantool, es necesario ejecutar el siguiente comando:
box.cfg{}Como resultado, Tarantool comenzará a grabar en el directorio actual las instantáneas de la base de datos (snapshot) y el registro de transacciones.
Crearemos una secuencia row_version:
box.schema.sequence.create('row_version',
    { if_not_exists = true })
La opción if_not_exists permite ejecutar el script de creación múltiples veces: si el objeto existe, Tarantool no intentará crearlo de nuevo. Esta opción se usará en todos los comandos DDL posteriores.
Crearemos un espacio como ejemplo.
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        },
        {
            name = 'row_ver',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})
Aquí hemos establecido el nombre del espacio (goods), los nombres de los campos y sus tipos.
Los campos de auto-incremento en Tarantool también se crean mediante secuencias. Crearemos una clave primaria de auto-incremento a través del campo id:
box.schema.sequence.create('goods_id',
    { if_not_exists = true })
box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Tarantool admite varios tipos de índices. Los tipos más comúnmente utilizados son los índices de tipo TREE y HASH, basados en estructuras correspondientes a sus nombres. TREE es el tipo de índice más versátil. Permite extraer datos en un orden específico. Sin embargo, para selecciones de igualdad, HASH es más adecuado. En consecuencia, es recomendable usar HASH para la clave primaria (lo cual hicimos).
Para usar la columna row_ver para transmitir datos modificados, es necesario vincular a los campos de esta columna valores de la secuencia row_ver. Sin embargo, a diferencia de la clave primaria, el valor del campo de la columna row_ver debe incrementarse en uno no solo al agregar nuevos registros, sino también al modificar registros existentes. Para esto, se pueden utilizar triggers. En Tarantool hay dos tipos de triggers para espacios: before_replace y on_replace. Los triggers se activan con cada cambio en los datos del espacio (para cada tupla afectada por los cambios, se ejecuta la función del trigger). A diferencia de on_replace, before_replace-los triggers permiten modificar los datos de la tupla para la cual se ejecuta el trigger. Por lo tanto, el último tipo de triggers es el que nos conviene.
box.space.goods:before_replace(function(old, new)
    return box.tuple.new({new[1], new[2], new[3],
        box.sequence.row_version:next()})
end)
El trigger anterior reemplaza el valor del campo row_ver de la tupla almacenada por el siguiente valor de la secuencia row_version.
Para poder extraer datos del espacio goods por la columna row_ver, crearemos un índice:
box.space.goods:create_index('row_ver', {
    parts = { 'row_ver' },
    unique = true,
    type = 'TREE',
    if_not_exists = true
})
El tipo de índice es árbol (TREE), ya que necesitaremos extraer los datos en orden ascendente de los valores en la columna. row_ver.
Agregaremos algunos datos al espacio:
box.space.goods:insert{nil, 'pen', 123}
box.space.goods:insert{nil, 'pencil', 321}
box.space.goods:insert{nil, 'brush', 100}
box.space.goods:insert{nil, 'watercolour', 456}
box.space.goods:insert{nil, 'album', 101}
box.space.goods:insert{nil, 'notebook', 800}
box.space.goods:insert{nil, 'rubber', 531}
box.space.goods:insert{nil, 'ruler', 135}
Dado que el primer campo es un contador de auto-incremento, pasamos nil en su lugar. Tarantool insertará automáticamente el siguiente valor. De manera similar, para los valores de los campos de la columna row_ver se puede pasar nil, o no especificar un valor en absoluto, ya que esta columna ocupa la última posición en el espacio.
Verifiquemos el resultado de la inserción:
tarantool> box.space.goods:select()
---
- - [1, 'bolígrafo', 123, 1]
  - [2, 'lápiz', 321, 2]
  - [3, 'pincel', 100, 3]
  - [4, 'acuarela', 456, 4]
  - [5, 'álbum', 101, 5]
  - [6, 'libreta', 800, 6]
  - [7, 'borrador', 531, 7]
  - [8, 'regla', 135, 8]
...
Como podemos ver, el primer y el último campo se completaron automáticamente. Ahora no será difícil escribir una función para la carga paginada de cambios en el espacio. goods:
local page_size = 5
local function get_goods(row_ver)
    local index = box.space.goods.index.row_ver
    local goods = {}
    local counter = 0
    for _, tuple in index:pairs(row_ver, {
        iterator = 'GT' }) do
        local obj = tuple:tomap({ names_only = true })
        table.insert(goods, obj)
        counter = counter + 1
        if counter >= page_size then
            break
        end
    end
    return goods
end
La función toma como parámetro el valor row_ver, a partir del cual se deben extraer los cambios, y devuelve un lote de datos modificados.
La selección de datos en Tarantool se realiza a través de índices. La función get_goods utiliza un iterador por índice row_ver para obtener los datos modificados. El tipo de iterador es GT (Greater Than, mayor que). Esto significa que el iterador recorrerá secuencialmente los valores del índice a partir de la clave proporcionada (valor del campo row_ver).
El iterador devuelve tuplas. Para poder transmitir los datos por HTTP, es necesario convertir las tuplas a una estructura que sea conveniente para la posterior serialización. En el ejemplo, se utiliza la función estándar tomap. En lugar de usar tomap se puede escribir una función propia. Por ejemplo, podemos querer renombrar el campo name, no transmitir el campo code y agregar el campo comentario:
local function unflatten_goods(tuple)
    local obj = {}
    obj.id = tuple.id
    obj.goods_name = tuple.name
    obj.comment = 'algun comentario'
    obj.row_ver = tuple.row_ver
    return obj
end
El tamaño de la página de datos devueltos (número de registros en una porción) se determina por la variable page_size. En el ejemplo, el valor page_size Igual a 5. En un programa real, el tamaño de la página suele ser más significativo. Depende del tamaño promedio de la tupla del espacio. El tamaño óptimo de página se puede determinar experimentalmente, midiendo el tiempo de transferencia de datos. Cuanto mayor sea el tamaño de la página, menor será el número de idas y vueltas entre el lado emisor y el receptor. Esto puede reducir el tiempo total de descarga de cambios. Sin embargo, si el tamaño de la página es demasiado grande, el servidor tardará demasiado en serializar la consulta. Como resultado, puede haber retrasos en el procesamiento de otras solicitudes que lleguen al servidor. El parámetro page_size se puede cargar desde el archivo de configuración. Para cada espacio transmitido, se puede establecer su propio valor. Aún así, para la mayoría de los espacios, un valor predeterminado (por ejemplo, 100) puede ser adecuado.
Ejecutemos la función get_goods:
tarantool> get_goods(0)

---
- - row_ver: 1
    code: 123
    name: bolígrafo
    id: 1
  - row_ver: 2
    code: 321
    name: lápiz
    id: 2
  - row_ver: 3
    code: 100
    name: brocha
    id: 3
  - row_ver: 4
    code: 456
    name: acuarela
    id: 4
  - row_ver: 5
    code: 101
    name: álbum
    id: 5
...
Tomemos el valor del campo row_ver de la última fila y volvamos a llamar a la función:
tarantool> get_goods(5)

---
- - row_ver: 6
    code: 800
    name: cuaderno
    id: 6
  - row_ver: 7
    code: 531
    name: goma
    id: 7
  - row_ver: 8
    code: 135
    name: regla
    id: 8
...
Y una vez más:
tarantool> get_goods(8)
---
- []
...
Como vemos, con este uso la función devuelve todas las entradas del espacio por páginas. goodsDespués de la última página, sigue una selección vacía.
Hagamos cambios en el espacio:
box.space.goods:update(4, {{'=', 6, 'cuaderno'}})
box.space.goods:insert{nil, 'clip', 234}
box.space.goods:insert{nil, 'carpeta', 432}
Hemos cambiado el valor del campo name para una entrada y hemos añadido dos nuevas entradas.
Repitamos la última llamada a la función:
tarantool> get_goods(8)
---


- - row_ver: 9
    code: 800
    name: cuaderno
    id: 6
  - row_ver: 10
    code: 234
    name: clip
    id: 9
  - row_ver: 11
    code: 432
    name: carpeta
    id: 10
...
La función devolvió las entradas modificadas y las añadidas. Así, la función get_goods permite obtener datos que han cambiado desde la última vez que se llamó, lo que es la base del método de replicación considerado.
Dejaremos la entrega de resultados por HTTP en forma de JSON fuera del alcance de este artículo. Se puede leer sobre esto aquí:
Implementación de la parte cliente/esclavo
Veamos cómo es la implementación del lado receptor. Crearemos en el lado receptor un espacio para almacenar los datos cargados:
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})

box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
La estructura del espacio es similar a la del espacio en la fuente. Pero dado que no planeamos enviar los datos obtenidos a ningún otro lugar, la columna row_ver en el espacio del receptor está ausente. En el campo id se registrarán los identificadores de la fuente. Por lo tanto, no es necesario hacerla auto-incremental en el lado del receptor.
Además, necesitaremos un espacio para almacenar los valores row_ver:
box.schema.space.create('row_ver', {
    format = {
        {
            name = 'space_name',
            type = 'string'

        },
        {
            name = 'value',
            type = 'string'

        }
    },
    if_not_exists = true
})

box.space.row_ver:create_index('primary', {
    parts = { 'space_name' },
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Para cada espacio cargado (campo space_name) almacenaremos aquí el último valor cargado row_ver (campo value). La columna space_name.
actuará como clave primaria. goods Crearemos una función para cargar datos del espacio
a través de HTTP. Para esto, necesitaremos una biblioteca que implemente el cliente HTTP. La siguiente línea carga la biblioteca y crea una instancia del cliente HTTP:local http_client = require('http.client').new()
También necesitaremos una biblioteca para deserializar json:local json = require('json')
Esto es suficiente para crear la función de carga de datos: local function load_data(url, row_ver) local url = ('%s?rowVer=%s'):format(url, tostring(row_ver)) local body = nil local data = http_client:request('GET', url, body, { keepalive_idle = 1, keepalive_interval = 1 }) return json.decode(data.body) end row_ver La función realiza una solicitud HTTP a la dirección url, pasando en ella
como parámetro y devuelve el resultado deserializado de la solicitud.
La función para guardar los datos obtenidos se ve de la siguiente manera: local function save_goods(goods) local n = #goods box.atomic(function() for i = 1, n do local obj = goods[i] box.space.goods:put( obj.id, obj.name, obj.code) end end) end goods El ciclo de guardado de datos en el espacio se coloca en una transacción (para esto se utiliza la función) para reducir la cantidad de operaciones con el disco.
Finalmente, la función para sincronizar el espacio local goods con la fuente se puede implementar así:
local function sync_goods()
    local tuple = box.space.row_ver:get('goods')
    local row_ver = tuple and tuple.value or 0

    —— set your url here:
    local url = 'http://127.0.0.1:81/test/goods/list'

    while true do
        local goods = load_goods(url, row_ver)

        local count = #goods
        if count == 0 then
            return
        end

        save_goods(goods)

        row_ver = goods[count].rowVer
        box.space.row_ver:put({'goods', row_ver})
    end
end
Primero leemos el valor guardado anteriormente row_ver para el espacio goods. Si está ausente (primera sesión de intercambio), tomamos como row_ver cero. Luego, en el ciclo, realizamos la carga paginada de los datos modificados desde la fuente a través de la URL indicada. En cada iteración, guardamos los datos obtenidos en el espacio local correspondiente y actualizamos el valor. row_ver (en el espacio row_ver y en la variable row_ver) — tomamos el valor row_ver de la última fila de los datos cargados.
Para protegerse contra un bucle accidental (en caso de error en el programa), el ciclo while se puede reemplazar por para:
for _ = 1, max_req do ... Como resultado de la ejecución de la función sync_goods el espacio goods en el receptor contendrá las últimas versiones de todos los registros del espacio goods en la fuente.
Es evidente que de esta manera no se puede transmitir la eliminación de datos. Si existe tal necesidad, se puede utilizar la marcación para eliminación. Agregamos en el espacio goods un campo booleano is_deleted y en lugar de eliminar físicamente el registro, utilizamos la eliminación lógica: asignamos el valor del campo is_deleted en true. A veces, en lugar de un campo booleano, is_deleted es más conveniente usar un campo deletedque almacena la fecha y hora de la eliminación lógica del registro. Después de realizar la eliminación lógica, el registro marcado para eliminación se transferirá de la fuente al receptor (según la lógica discutida anteriormente).
La secuencia row_ver se puede usar para transferir datos de otros espacios: no es necesario crear una secuencia separada para cada espacio transferido.
Hemos considerado un método efectivo para la replicación de datos de alto nivel en aplicaciones que utilizan la base de datos Tarantool.
Conclusiones
- La base de datos Tarantool es un producto atractivo y prometedor para crear aplicaciones de alta carga.
- La replicación de datos de alto nivel tiene una serie de ventajas sobre la replicación de bajo nivel.
- El método de replicación de alto nivel presentado en el artículo permite minimizar la cantidad de datos transmitidos al transferir solo aquellos registros que han cambiado desde la última sesión de intercambio.
Fuente: habr.com
