

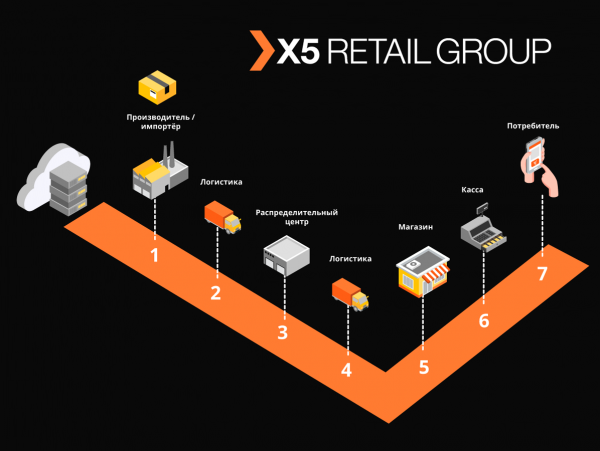
Desde 2019, en Rusia se aplica una ley sobre la obligación de marcar. Esta ley no se aplica a todos los grupos de productos, y las fechas de entrada en vigor de la obligación de marcar varían según los grupos de productos. Los primeros en estar sujetos a la obligación de marcar son el tabaco, el calzado y los medicamentos; posteriormente se agregarán otros productos, como perfumes, textiles y leche. Esta innovación legislativa ha impulsado el desarrollo de nuevas soluciones informáticas que permitirán rastrear toda la cadena de vida del producto desde su producción hasta la compra por parte del consumidor final, involucrando a todos los participantes del proceso: tanto el Estado como todas las organizaciones que venden productos sujetos a marcado.
En X5, el sistema que rastreará los productos marcados y intercambiará datos con el Estado y los proveedores se llama “Marcus”. Hablaremos por orden sobre cómo y quién lo ha desarrollado, cuál es su stack tecnológico y por qué podemos sentirnos orgullosos.
Un verdadero HighLoad
“Marcus” resuelve múltiples tareas, la principal de las cuales es la interacción de integración entre los sistemas de información de X5 y el sistema de información estatal de productos marcados (GIS MP) para rastrear el movimiento de productos marcados. Además, la plataforma almacena todos los códigos de marcado que recibimos y toda la historia del movimiento de esos códigos a través de los objetos, ayudando a eliminar los errores de clasificación de los productos marcados. Por ejemplo, en el caso de los productos de tabaco, que fueron incluidos en los primeros grupos de productos marcados, solo un camión de cigarrillos contiene alrededor de 600,000 paquetes, cada uno con su código único. La tarea de nuestro sistema es rastrear y verificar la legalidad de los movimientos de cada uno de esos paquetes entre almacenes y tiendas, y, en última instancia, comprobar la admisibilidad de su venta al consumidor final. Además, registramos alrededor de 125,000 operaciones de caja por hora, y aún hay que registrar cómo cada uno de esos paquetes llegó a la tienda. Así, considerando todos los movimientos entre los objetos, esperamos decenas de miles de millones de registros al año.
El equipo M
A pesar de que "Markus" se considera un proyecto dentro de X5, se implementa con un enfoque de producto. El equipo trabaja bajo la metodología Scrum. El proyecto comenzó en el verano del año pasado, pero los primeros resultados llegaron solo en octubre: se formó completamente un equipo propio, se desarrolló la arquitectura del sistema y se compró el equipo necesario. Actualmente, el equipo está compuesto por 16 personas, de las cuales seis se dedican al desarrollo de backend y frontend, y tres al análisis sistemático. Otros seis se ocupan de pruebas manuales, de carga, automatizadas y del soporte del producto. Además, contamos con un especialista en SRE.
En nuestro equipo, no solo los desarrolladores escriben código, prácticamente todos saben programar y crean pruebas automatizadas, scripts de carga y scripts de automatización. Prestamos especial atención a esto, ya que incluso el soporte del producto requiere un alto nivel de automatización. Siempre intentamos asesorar y ayudar a los colegas que antes no programaban, dándoles pequeñas tareas a realizar.
Debido a la pandemia de coronavirus, trasladamos a todo el equipo al trabajo remoto; la disponibilidad de todas las herramientas de gestión del desarrollo, y el flujo de trabajo establecido en Jira y GitLab, nos permitieron superar fácilmente esta etapa. Los meses transcurridos en la modalidad remota demostraron que la productividad del equipo no se vio afectada, y para muchos, el confort en el trabajo aumentó, lo único que falta es la comunicación cara a cara.
Reunión del equipo antes del trabajo remoto
Reuniones durante el trabajo remoto
Stack tecnológico de la solución
El repositorio y herramienta estándar de CI/CD para X5 es GitLab. Lo utilizamos para almacenar el código, realizar pruebas continuas y desplegar en los servidores de pruebas y productivos. También practicamos la revisión de código, donde al menos 2 colegas deben aprobar los cambios en el código propuestos por el desarrollador. Los analizadores de código estático SonarQube y JaCoCo nos ayudan a mantener el código limpio y garantizar el nivel requerido de cobertura con pruebas unitarias. Todos los cambios en el código deben pasar necesariamente por estas verificaciones. Todos los escenarios de prueba que se ejecutan manualmente se automatizan posteriormente.
Para el exitoso cumplimiento de los procesos comerciales de 'Markus', tuvimos que resolver una serie de desafíos tecnológicos, uno a uno.
Tarea 1. La necesidad de escalabilidad horizontal del sistema
Para abordar esta tarea, elegimos un enfoque microservicioso para la arquitectura. Era crucial entender las áreas de responsabilidad de los servicios. Intentamos dividirlos según las operaciones comerciales, teniendo en cuenta la especificidad de los procesos. Por ejemplo, la recepción en el almacén es una operación no muy frecuente, pero muy intensiva, en la que es necesario obtener lo más rápido posible del regulador estatal información sobre las unidades de productos aceptadas, cuya cantidad en un solo envío puede alcanzar hasta 600,000, verificar la aceptabilidad de la recepción de ese producto en el almacén y proporcionar toda la información necesaria al sistema de automatización del almacén. Por otro lado, la carga desde los almacenes tiene una intensidad mucho mayor, pero opera con volúmenes de datos menores.
Todos los servicios los implementamos en un principio sin estado (stateless) y, incluso, intentamos dividir las operaciones internas en pasos, utilizando lo que llamamos, self-temas de Kafka. Esto es cuando un microservicio envía un mensaje a sí mismo, lo que permite equilibrar la carga en operaciones que demandan más recursos y simplifica el mantenimiento del producto, pero hablaremos de esto más adelante.
Decidimos separar en servicios individuales los módulos de interacción con sistemas externos. Esto permitió resolver el problema de las API externas que cambian con frecuencia, prácticamente sin afectar a los servicios con funcionalidad comercial.
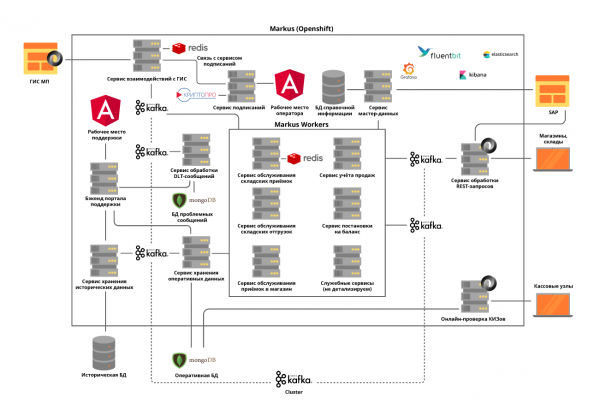
Todos los microservicios se despliegan en un clúster de OpenShift, que resuelve tanto el problema de escalar cada microservicio como nos permite no utilizar herramientas externas de descubrimiento de servicios.
Tarea 2. La necesidad de mantener una alta carga y un intercambio de datos muy intenso entre los servicios de la plataforma: solo en la fase de lanzamiento del proyecto se realizan alrededor de 600 operaciones por segundo. Esperamos que este valor aumente a 5000 op/sec a medida que se conecten los objetos comerciales a nuestra plataforma.
Esta tarea se resolvió implementando un clúster de Kafka y prácticamente abandonando la interacción sincrónica entre los microservicios de la plataforma. Esto requiere un análisis muy cuidadoso de los requisitos del sistema, ya que no todas las operaciones pueden ser asíncronas. Al mismo tiempo, no solo transmitimos eventos a través del corredor, sino que también enviamos en el mensaje toda la información empresarial necesaria. Así, el tamaño del mensaje puede alcanzar varios cientos de kilobytes. La limitación en el tamaño de los mensajes en Kafka nos exige prever con precisión el tamaño de los mensajes, y, si es necesario, los dividimos, pero esta división es lógica y está relacionada con las operaciones comerciales.
Por ejemplo, el producto que llega en vehículo lo dividimos por cajas. Para las operaciones sincrónicas se asignan microservicios separados y se lleva a cabo una rigurosa prueba de carga. El uso de Kafka nos presentó otro desafío: verificar el funcionamiento de nuestro servicio teniendo en cuenta que la integración con Kafka hace que todas nuestras pruebas unitarias sean asíncronas. Para resolver esta tarea, escribimos nuestros propios métodos utilitarios utilizando Embedded Kafka Broker. Esto no elimina la necesidad de escribir pruebas unitarias para métodos individuales, pero preferimos probar casos complejos utilizando Kafka.
Se prestó mucha atención al seguimiento de logs, para que sus TraceId no se perdieran al ocurrir excepciones durante la ejecución de los servicios o al trabajar con Kafka batch. Y si en el primer caso no surgieron preguntas especiales, en el segundo caso tuvimos que registrar en el log todos los TraceId con los que llegó el batch y elegir uno para continuar la trazabilidad. Así, al buscar por el TraceId original, el usuario puede descubrir fácilmente con cuál se continuó la trazabilidad.
Tarea 3. Necesidad de almacenar una gran cantidad de datos: más de 1 mil millones de marcas al año solo en tabaco entran a X5. Se requiere acceso constante y rápido a ellos. En total, el sistema debe procesar alrededor de 10 mil millones de registros sobre el historial de movimiento de productos marcados.
Para abordar el tercer desafío, se eligió la base de datos NoSQL MongoDB. Hemos construido un shard de 5 nodos y en cada nodo un Replica Set de 3 servidores. Esto permite escalar el sistema horizontalmente, añadiendo nuevos servidores en clúster y garantizar su resistencia a fallos. Aquí nos enfrentamos a otro problema: asegurar la transaccionalidad en el clúster de mongo, teniendo en cuenta el uso de microservicios escalables horizontalmente. Por ejemplo, una de las tareas de nuestro sistema es detectar intentos de reventa de productos con códigos de marcado idénticos. Aquí surgen confusiones con escaneos erróneos o con operaciones equivocadas de los cajeros. Descubrimos que estos duplicados pueden surgir tanto dentro de un batch procesado por Kafka como entre dos batches procesados en paralelo. Así, la verificación de duplicados mediante consultas a la base de datos no era efectiva. Para cada uno de los microservicios resolvimos el problema por separado, según la lógica empresarial de ese servicio. Por ejemplo, para los recibos, añadimos una verificación dentro del batch y un procesamiento separado para detectar duplicados al insertar.
Para que la interacción de los usuarios con el historial de operaciones no afectara lo más importante: el funcionamiento de nuestros procesos de negocio, separamos todos los datos históricos en un servicio independiente con su propia base de datos, que también recibe información a través de Kafka. De esta manera, los usuarios trabajan con un servicio aislado, sin influir en los servicios que procesan datos de operaciones actuales.
Tarea 4. Reprocesamiento de colas y monitoreo:
En los sistemas distribuidos, inevitablemente surgen problemas y errores de disponibilidad de bases de datos, colas y fuentes externas de datos. En el caso de 'Markus', la fuente de tales errores es la integración con sistemas externos. Era necesario encontrar una solución que permitiera hacer reintentos de las solicitudes con respuestas erróneas después de un tiempo de espera determinado, pero sin detener el procesamiento de solicitudes exitosas en la cola principal. Para ello, se eligió el concepto denominado 'retry basado en tópicos'. Para cada tópico principal se crea uno o varios tópicos de reintentos, a los cuales se envían los mensajes con errores, excluyendo así la demora en el procesamiento de mensajes del tópico principal. El esquema de interacción es -
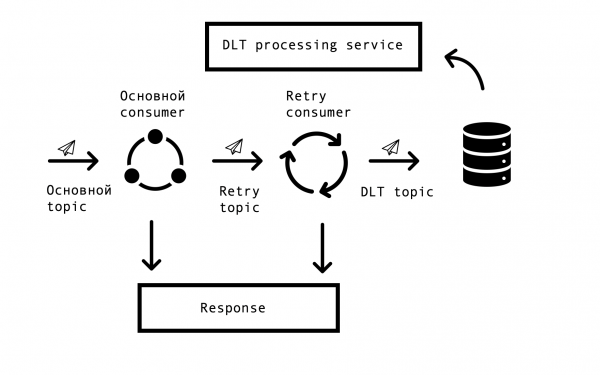
Para implementar este esquema, necesitábamos lo siguiente: integrar esta solución con Spring y evitar la duplicación de código. En la red, encontramos una solución similar basada en Spring BeanPostProcessor, pero nos pareció demasiado engorrosa. Nuestro equipo desarrolló una solución más simple que permite integrarse en el ciclo de creación de consumidores de Spring y agregar consumidores con Retry además. Proporcionamos a la comunidad de Spring un prototipo de nuestra solución, que se puede ver . La cantidad de consumidores Retry y el número de intentos de cada consumidor se configuran a través de parámetros, dependiendo de las necesidades del proceso de negocio, y para que todo funcione, solo queda aplicar la conocida anotación org.springframework.kafka.annotation.KafkaListener.
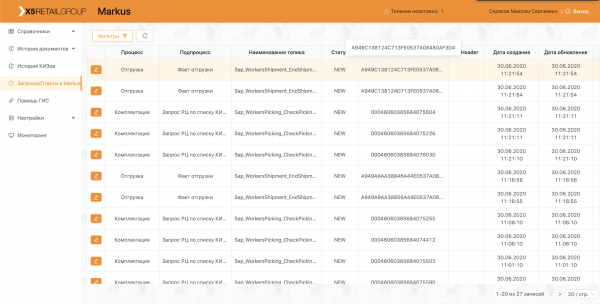
En caso de que un mensaje no se pueda procesar después de todos los intentos de retry, se envía al DLT (dead letter topic) mediante Spring DeadLetterPublishingRecoverer. A petición del soporte, expandimos esta funcionalidad e hicimos un servicio separado que permite ver los mensajes que llegaron al DLT, el stackTrace, el traceId y otra información útil relacionada. Además, se añadieron monitorizaciones y alertas en todos los tópicos DLT, por lo que, actualmente, la aparición de un mensaje en el tópico DLT es un motivo para investigar y registrar un defecto. Esto es muy conveniente: por el nombre del tópico entendemos inmediatamente en qué etapa del proceso surgió el problema, lo que acelera significativamente la búsqueda de su causa raíz.
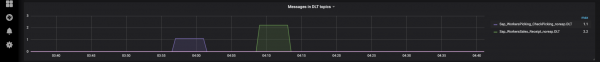
Recientemente implementamos una interfaz que permite reenviar mensajes mediante nuestro soporte, después de corregir sus causas (por ejemplo, restaurar la funcionalidad de un sistema externo) y, por supuesto, registrar el correspondiente defecto para análisis. Aquí fueron útiles nuestros self-tópicos, de modo que, en lugar de reiniciar toda la cadena de procesamiento, se puede reiniciar desde el paso necesario.
Explotación de la plataforma
La plataforma ya está en operación productiva, realizamos entregas y envíos todos los días, conectamos nuevos centros de distribución y tiendas. En el marco del piloto, el sistema trabaja con grupos de productos "Tabacos" y "Calzado".
Todo nuestro equipo participa en la realización de pilotos, analiza los problemas que surgen y presenta propuestas para mejorar nuestro producto, desde la mejora de los logs hasta cambios en los procesos.
Para no repetir mis errores, todos los casos encontrados durante la fase piloto se reflejan en las pruebas automatizadas. La gran cantidad de pruebas automatizadas y pruebas unitarias permiten realizar pruebas de regresión y aplicar hotfixes en cuestión de horas.
En este momento, seguimos desarrollando y perfeccionando nuestra plataforma, enfrentándonos constantemente a nuevos desafíos. Si te interesa, te contaremos sobre nuestras soluciones en los próximos artículos.
Fuente: habr.com
