

El 27 de mayo en la sala principal de la conferencia DevOpsConf 2019, que se lleva a cabo dentro del festival , en la sección 'Entrega Continua', se presentó la charla 'werf — nuestra herramienta para CI/CD en Kubernetes'. En ella se habla de los problemas y desafíos que cada uno enfrenta al desplegar en Kubernetes, así como de los matices que pueden no ser evidentes de inmediato. Al desglosar las posibles soluciones, mostramos cómo se implementa en una herramienta de código abierto .
Desde la presentación, nuestra utilidad (anteriormente conocida como dapp) ha superado la marca histórica de 1000 estrellas en GitHub — esperamos que la creciente comunidad de usuarios facilite la vida a muchos ingenieros DevOps.
Así que, presentamos (~47 minutos, mucho más informativo que un artículo) y un resumen escrito de ello. ¡Vamos!
Entrega de código en Kubernetes
En la charla se hablará más sobre CI/CD en Kubernetes, entendiendo que nuestro software está empaquetado en contenedores Docker (sobre esto hablé en ), y K8s será utilizado para su ejecución en producción (esto — en ).
¿Cómo se ve la entrega en Kubernetes?
- Hay un repositorio Git con el código y las instrucciones para su compilación. La aplicación se compila en una imagen Docker y se publica en el Docker Registry.
- En el mismo repositorio hay instrucciones sobre cómo desplegar y ejecutar la aplicación. En la etapa de despliegue, estas instrucciones se envían a Kubernetes, que recibe la imagen necesaria del registry y la ejecuta.
- Además, normalmente hay pruebas. Algunas de ellas se pueden ejecutar al publicar la imagen. También se puede (según las mismas instrucciones) desplegar una copia de la aplicación (en un espacio de nombres K8s separado o en un clúster separado) y ejecutar pruebas allí.
- Finalmente, se necesita un sistema CI que reciba eventos de Git (o pulsaciones de botones) y ejecute todas las etapas designadas: compilación, publicación, despliegue, prueba.
Aquí hay algunas observaciones importantes:
- Dado que tenemos infraestructura inmutable (immutable infrastructure), la imagen de la aplicación, que se utiliza en todas las etapas (staging, producción, etc.), debe ser una sola. Sobre esto y con ejemplos hablé .
- Dado que seguimos el enfoque de infraestructura como código (IaC), el código de la aplicación, las instrucciones para su compilación y ejecución deben estar justo en un solo repositorio. Sobre esto — véase en .
- Cadena de entrega (delivery) normalmente vemos así: se ensambló la aplicación, se probó, se lanzó etapa de release y eso es todo: la entrega ocurrió. Pero en realidad, el usuario recibe lo que ustedes implementaron no en el momento que lo entregaron a producción, y cuando pudo acceder a la producción y esta funcionó. Por eso creo que la cadena de entrega termina solo en la etapa de operación ejecución, y si hablamos con más precisión, incluso en el momento en que se retiró el código de producción (sustituyéndolo por uno nuevo).
Volvamos al esquema de entrega mencionado anteriormente en Kubernetes: no solo lo inventamos nosotros, sino prácticamente todos los que han lidiado con este problema. De hecho, este patrón ahora se llama GitOps (puedes leer más sobre el término y las ideas que lo respaldan ). Veamos las etapas del esquema.
Etapa de construcción
Aparentemente, ¿qué se puede contar en 2019 sobre la construcción de imágenes Docker, cuando todos saben escribir Dockerfiles y ejecutarlos? docker build?.. Вот нюансы, на которые хотелось бы обратить внимание:
- El peso de la imagen es importante, así que usa , para dejar en la imagen solo lo realmente necesario para el funcionamiento de la aplicación.
- El número de capas debe minimizarse, combinando cadenas de
RUNcomandos por significado. - Sin embargo, esto añade problemas en la depuración, ya que al fallar la construcción hay que buscar el comando específico en la cadena que causó el problema.
- La velocidad de construcción es importante, porque queremos implementar cambios rápidamente y ver el resultado. Por ejemplo, no queremos volver a compilar dependencias en bibliotecas del lenguaje en cada construcción de la aplicación.
- A menudo, de un solo repositorio de Git se requieren muchas imágenes, que se puede solucionar con un conjunto de Dockerfiles (o etapas nombradas en un solo archivo) y un script de Bash para su construcción secuencial.
Esto fue solo la punta del iceberg con la que todos se enfrentan. Pero hay otros problemas, en particular:
- A menudo, en la etapa de construcción necesitamos algo montar (por ejemplo, almacenar en caché el resultado de un comando tipo apt en un directorio externo).
- Queremos Ansible en lugar de escribir en shell.
- Queremos construir sin Docker (¿por qué necesitar una máquina virtual adicional en la que hay que configurar todo esto cuando ya hay un clúster de Kubernetes donde se pueden ejecutar contenedores?).
- Construcción paralela, que se puede interpretar de diferentes maneras: diferentes comandos de Dockerfile (si se utiliza multi-stage), varios commits de un mismo repositorio, varios Dockerfile.
- Construcción distribuida: queremos construir algo en pods, que son "efímeros", ya que pierden la caché, lo que significa que debe almacenarse en otro lugar.
- Finalmente, llamé al pináculo de los deseos automagia: sería ideal entrar en el repositorio, escribir un comando y obtener una imagen lista, compilada con el entendimiento de cómo y qué hacer correctamente. Sin embargo, personalmente no estoy seguro de que se puedan prever todos los matices de esta manera.
Y aquí hay proyectos:
- — compilador de la compañía Docker Inc (ya integrado en las versiones actuales de Docker), que intenta resolver todos estos problemas;
- — compilador de Google, que permite construir sin Docker;
- — intento de la CNCF de hacer automagia y, en particular, una solución interesante con rebase para capas;
- y un montón de otras utilidades, como , …
… y mira cuántas estrellas tienen en GitHub. Es decir, por un lado, docker build hay y puede hacer algo, pero en realidad la cuestión no está completamente resuelta — como prueba de esto está el desarrollo paralelo de compiladores alternativos, cada uno de los cuales resuelve algún problema específico.
Construcción en werf
Así llegamos a (anteriormente como dapp) — utilidad de código abierto de la empresa "Flant", que hemos estado desarrollando durante muchos años. Comenzó hace 5 años con scripts de Bash, optimizando la construcción de Dockerfile, y en los últimos 3 años ha estado en un desarrollo completo dentro de un solo proyecto con su propio repositorio Git (primero en Ruby, y luego en Go, y de paso también renombrado). ¿Qué cuestiones de construcción se resuelven en werf?
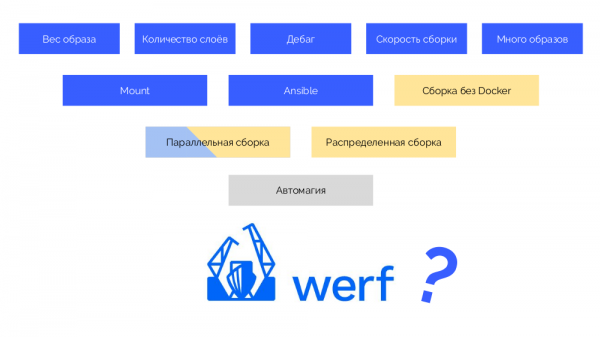
Los problemas marcados en azul ya están implementados, la construcción paralela se ha realizado en un solo host, y las cuestiones destacadas en amarillo planeamos finalizar para finales de verano.
Etapa de publicación en el registro (publish)
Escribimos docker push… — ¿qué puede ser complicado en subir una imagen al registro? Y aquí surge la pregunta: "¿Qué etiqueta se debe poner a la imagen?" Surge por el hecho de que tenemos Gitflow (u otra estrategia de Git) y Kubernetes, y la industria tiende a que lo que sucede en Kubernetes siga lo que se hace en Git. Después de todo, Git es nuestra única fuente de verdad.
¿Qué hay de complicado en esto? Garantizar la reproducibilidad: del commit en Git, que por su naturaleza es inmutable (inmutable), hasta la imagen de Docker, que debe mantenerse igual.
También es importante para nosotros definir el origen, porque queremos entender de qué commit se construyó la aplicación que se ejecuta en Kubernetes (así podremos hacer diffs y cosas similares).
Estrategias de etiquetado
La primera es un simple git tag. Tenemos un registro con una imagen etiquetada como 1.0. En Kubernetes hay un stage y producción, donde esta imagen ha sido desplegada. En Git hacemos commits y en algún momento ponemos una etiqueta 2.0. La construimos siguiendo las instrucciones del repositorio y la colocamos en el registro con la etiqueta 2.0. Desplegamos en stage y, si todo está bien, luego en producción.
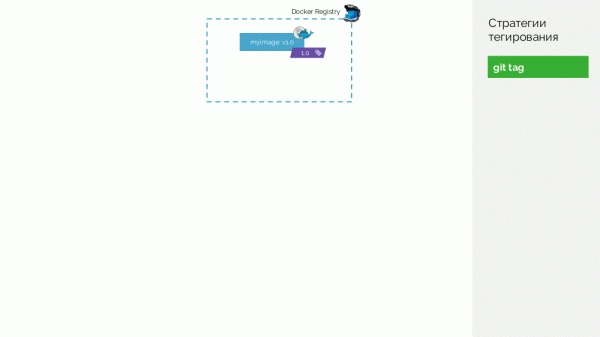
El problema de este enfoque es que primero pusimos la etiqueta y solo después probamos y desplegamos. ¿Por qué? En primer lugar, es simplemente ilógico: estamos entregando una versión de software que ni siquiera hemos revisado (no podemos hacer de otra manera, ya que para verificar es necesario poner una etiqueta). En segundo lugar, este camino no se alinea con Gitflow.
La segunda opción es git commit + tag. En la rama master hay una etiqueta 1.0; para ello en el registro hay una imagen desplegada en producción. Además, en el clúster de Kubernetes hay contornos de vista previa y staging. Luego seguimos Gitflow: en la rama principal para el desarrollo (develop) hacemos nuevas características, lo que resulta en un commit con el identificador #c1. Lo construimos y lo publicamos en el registro, utilizando este identificador (#c1). Con el mismo identificador desplegamos en vista previa. Hacemos lo mismo con los commits #c2 y #c3.
Cuando entendemos que hay suficientes características, comenzamos a estabilizar todo. En Git creamos una rama release_1.1 (basado en #c3 de develop). No será necesario construir esta versión, ya que se ha hecho en la etapa anterior. Por lo tanto, simplemente podemos desplegarla en staging. Corregimos los errores en #c4 y también los desplegamos en staging. Paralelamente, al mismo tiempo se está desarrollando en develop, donde periódicamente se traen cambios de release_1.1. En algún momento, obtenemos un commit construido y desplegado en staging, con el cual estamos satisfechos (#c25).
Entonces hacemos merge (con fast-forward) de la rama de lanzamiento (release_1.1) en master. Ponemos en este commit una etiqueta con la nueva versión (1.1). Pero esta imagen ya está construida en el registro, por lo que, para no construirla nuevamente, simplemente añadimos una segunda etiqueta a la imagen existente (ahora tiene etiquetas en el registro #c25 y 1.1). Después de esto, la desplegamos en producción.
Hay una desventaja, que en staging se ha desplegado una imagen (#c25), mientras que en producción, sería como otra (1.1), pero sabemos que «físicamente» es la misma imagen del registro.
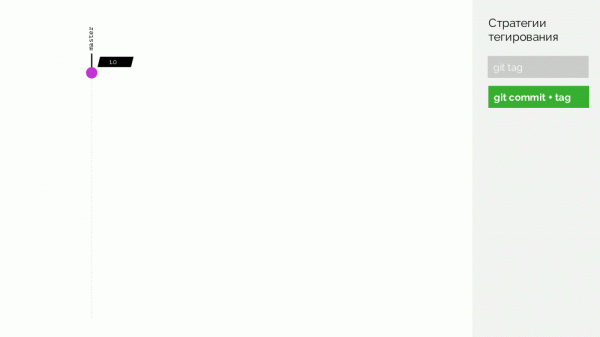
El verdadero inconveniente es que no hay soporte para commits de fusión, hay que hacer un avance rápido.
Podemos ir un paso más allá y hacer un truco… Consideremos el ejemplo de un Dockerfile simple:
FROM ruby:2.3 as assets
RUN mkdir -p /app
WORKDIR /app
COPY . ./
RUN gem install bundler && bundle install
RUN bundle exec rake assets:precompile
CMD bundle exec puma -C config/puma.rb

FROM nginx:alpine
COPY --from=assets /app/public /usr/share/nginx/www/public
Construiremos un archivo según el siguiente principio, es decir, tomaremos:
- SHA256 de los identificadores de las imágenes utilizadas (
ruby:2.3ynginx:alpine), que son los hashes de su contenido; - todas las instrucciones (
RUN,CMDetc.); - SHA256 de los archivos que se añadieron.
… y tomaremos el hash (nuevamente SHA256) de dicho archivo. Esta es la firma de todo lo que define el contenido de la imagen de Docker.
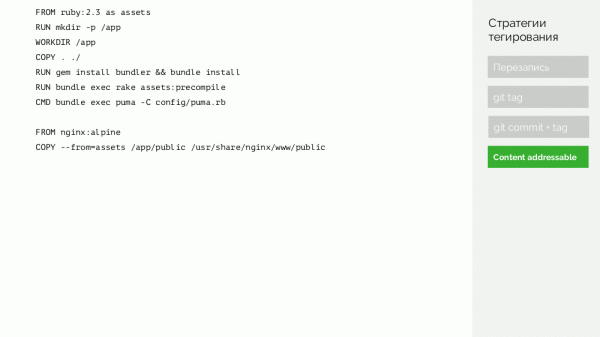
Volvamos al esquema y en lugar de commits utilizaremos estas firmas, es decir, etiquetaremos las imágenes con firmas.
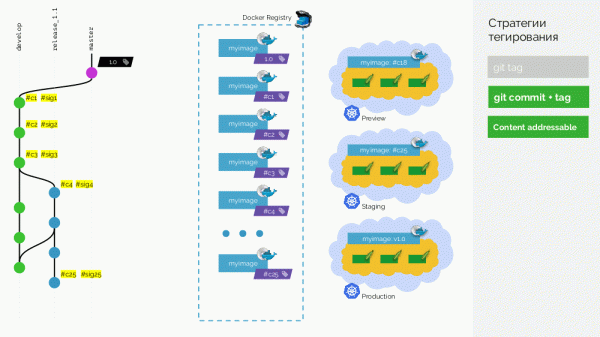
Ahora, cuando necesitemos, por ejemplo, fusionar cambios de la versión en master, podemos hacer un verdadero commit de fusión: tendrá un identificador diferente, pero la misma firma. Con el mismo identificador implementaremos la imagen en producción.
La desventaja es que ahora no se podrá determinar qué commit se ha implementado en producción: los hashes solo funcionan en una dirección. Este problema se soluciona con una capa adicional de metadatos, de la que hablaré más adelante.
Etiquetado en werf
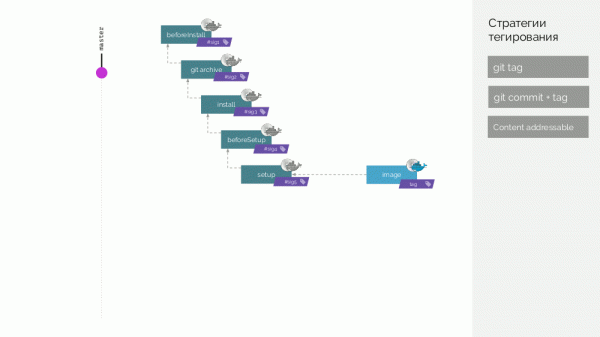
En werf hemos ido un paso más allá y nos estamos preparando para hacer una compilación distribuida con una caché que no se almacena en una sola máquina… Así que, tenemos imágenes de Docker de dos tipos, las llamamos stage y image.
En el repositorio de Git de werf se almacenan instrucciones específicas para la compilación que describen diferentes etapas de la misma (beforeInstall, install, beforeSetup, configuración). La primera imagen de etapa la generamos con una firma definida como el hash de los primeros pasos. Luego añadimos el código fuente, para la nueva imagen de etapa consideramos su hash… Estas operaciones se repiten para todas las etapas, lo que nos permite obtener un conjunto de imágenes de etapa. Luego realizamos la imagen final, que también contiene metadatos sobre su origen. Y esta imagen la etiquetamos de varias maneras (más detalles más adelante).
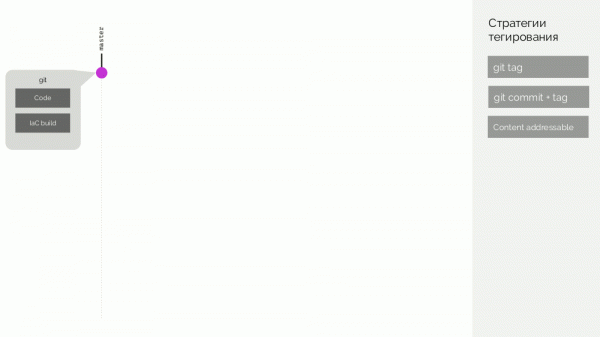
Supongamos que después de esto aparece un nuevo commit que solo cambió el código de la aplicación. ¿Qué sucederá? Se creará un patch para los cambios en el código y se preparará una nueva imagen de stage. Su firma será determinada como el checksum de la antigua imagen de stage y del nuevo patch. De esta imagen se formará una nueva imagen final.
Por lo tanto, las imágenes de stage son un caché que se puede almacenar de manera distribuida, y las imágenes que se crean a partir de ellas se cargan en el Docker Registry.
Limpieza del registry
No se trata de eliminar capas que quedan colgando después de etiquetas eliminadas, esto es una función estándar del propio Docker Registry. Se trata de la situación en la que se acumulan muchas etiquetas de Docker y entendemos que una parte de ellas ya no es necesaria, pero ocupan espacio (y/o estamos pagando por ello).
¿Cuáles son las estrategias de limpieza?
- Se puede simplemente no hacer nada no limpiar. A veces realmente es más fácil pagar un poco más por el espacio extra que desenredar un gran enredo de etiquetas. Pero esto solo funciona hasta cierto punto.
- Restablecimiento completo. Si se eliminan todas las imágenes y se vuelven a construir solo las actuales en el sistema CI, puede surgir un problema. Si se reinicia un contenedor en producción, se cargará una nueva imagen que no ha sido probada por nadie. Esto arruina la idea de infraestructura inmutable.
- Blue-green. Un registry comenzó a sobrecargarse: cargamos imágenes en otro. El mismo problema que en el método anterior: ¿en qué momento se puede limpiar ese registry que comenzó a sobrecargarse?
- Por tiempo. ¿Eliminar todas las imágenes que tengan más de 1 mes? Pero seguramente habrá un servicio que no se ha actualizado en todo un mes...
- De forma manual determinar qué se puede eliminar.
Realmente hay dos opciones viables: no limpiar o una combinación de blue-green + manual. En este último caso, cuando entiendes que es hora de limpiar el registry, creas uno nuevo y añades todas las nuevas imágenes a él durante, por ejemplo, un mes. Y después de un mes, miras qué pods en Kubernetes todavía utilizan el antiguo registry y los trasladas también al nuevo registry.
¿A dónde llegamos en werf? Мы собираем:
- Git head: todas las etiquetas, todas las ramas, asumiendo que todo lo que está etiquetado en Git lo necesitamos también en las imágenes (y si no, hay que eliminarlo en Git);
- todos los pods que están descargándose ahora en Kubernetes;
- los antiguos ReplicaSets (lo que se ha descargado recientemente), y también planeamos escanear lanzamientos de Helm y seleccionar las últimas imágenes allí.
… y hacemos de este conjunto una lista blanca — lista de imágenes que no vamos a eliminar. Todo lo demás se limpia, después de lo cual encontramos imágenes de stage huérfanas y también las eliminamos.
Etapa de despliegue
Declaratividad confiable
El primer punto al que queremos llamar la atención en el despliegue es la implementación de la configuración actualizada de recursos, declarada de forma declarativa. El documento YAML original con la descripción de los recursos de Kubernetes siempre difiere significativamente del resultado que realmente funciona en el clúster. Esto se debe a que Kubernetes agrega a la configuración:
- identificadores;
- información de servicio;
- múltiples valores por defecto;
- sección con el estado actual;
- cambios realizados en el marco del trabajo del webhook de admission;
- resultado del trabajo de varios controladores (y programador).
Por lo tanto, cuando aparece una nueva configuración de recurso (nuevo), no podemos simplemente tomarla y sobrescribir la configuración actual, "viva", (live). Para esto, necesitamos comparar nuevo con la configuración aplicada anteriormente (last-applied) y aplicar live el parche obtenido.
Este enfoque se llama fusión en 2 vías. Se utiliza, por ejemplo, en Helm.
También existe la fusión en 3 vías, que se diferencia en que:
- al comparar last-applied y nuevo, observamos lo que se ha eliminado;
- al comparar nuevo y live, observamos lo que se ha añadido o cambiado;
- aplicamos el parche sumado a live.
Desplegamos más de 1000 aplicaciones con Helm, por lo que, en realidad, vivimos con la fusión en 2 vías. Sin embargo, tiene una serie de problemas que hemos resuelto con nuestros parches, ayudando a Helm a funcionar correctamente.
Estado real de la implementación
Después de que, en un evento correspondiente, nuestro sistema CI generó una nueva configuración para Kubernetes, la envía para aplicar (apply) en el clúster — usando Helm o kubectl apply. Luego ocurre la fusión en N vías ya descrita, a lo que la API de Kubernetes responde favorablemente a la sistema CI, y esta a su usuario.
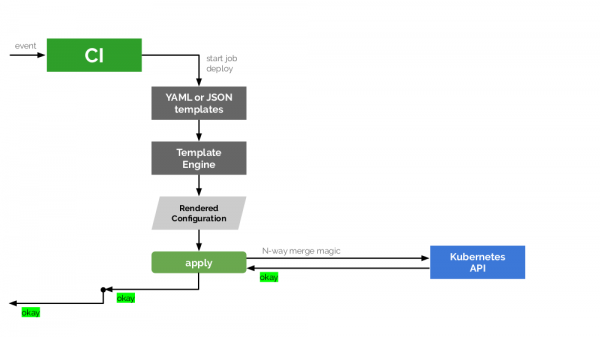
Sin embargo, hay un gran problema: ya que una aplicación exitosa no significa una implementación exitosa.Si Kubernetes entendió qué cambios deben aplicarse, los aplica — aún no sabemos qué resultará de esto. Por ejemplo, puede que la actualización y el reinicio de pods en el frontend se realicen con éxito, mientras que en el backend no, y obtendremos diferentes versiones de las imágenes de la aplicación en ejecución.
Para hacer todo correctamente, en este esquema se sugiere un eslabón adicional: un rastreador especial que recibe información del estado de la API de Kubernetes y la envía para un análisis posterior de la situación real. Hemos creado una biblioteca Open Source en Go — (ver su anuncio ), — que resuelve este problema y está integrada en werf.
El comportamiento de este rastreador a nivel de werf se configura mediante anotaciones que se colocan en Deployments o StatefulSets. La principal anotación es fail-mode — entiende los siguientes valores:
-
IgnoreAndContinueDeployProcess— ignoramos los problemas de implementación de este componente y continuamos con el despliegue; -
FailWholeDeployProcessImmediately— un error en este componente detiene el proceso de despliegue; -
HopeUntilEndOfDeployProcess— esperamos que este componente funcione para el final del despliegue.
Por ejemplo, tal combinación de recursos y valores de anotación fail-mode:
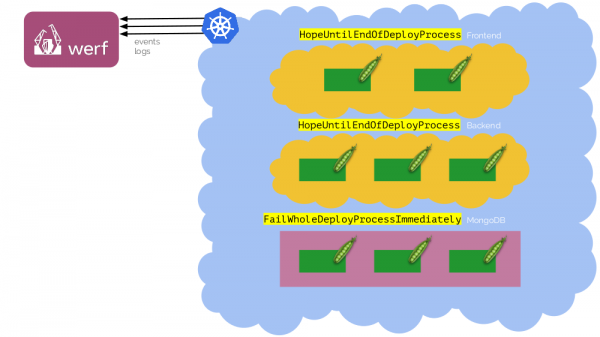
Cuando desplegamos por primera vez, la base de datos (MongoDB) puede no estar lista, los Deployments fallarán. Pero podemos esperar el momento en que se inicie, y el despliegue pasará de todos modos.
Hay otras dos anotaciones para kubedog en werf:
-
failures-allowed-per-replica— número de fallos permitidos por cada réplica; -
show-logs-until— regula el momento hasta el cual werf muestra (en stdout) los registros de todos los pods en implementación. Por defecto esPodIsReady(para ignorar mensajes que probablemente no necesitamos cuando comienza a llegar tráfico al pod), sin embargo, también son válidos los valoresControllerIsReadyyEndOfDeploy.
¿Qué más queremos del despliegue?
Además de los dos puntos ya mencionados, nos gustaría:
- ver registros — pero solo los necesarios, no todos de una vez;
- seguir el progreso, porque si el trabajo se queda "silencioso" durante varios minutos, es importante entender qué está sucediendo;
- tener una reversión automática en caso de que algo salga mal (por lo que es crítico conocer el estado real del despliegue). La implementación debe ser atómica: o se completa, o todo vuelve a su estado anterior.
Resultados
Para nosotros, como empresa, para implementar todos los matices descritos en diferentes etapas de entrega (build, publish, deploy), es suficiente con un sistema CI y una utilidad .
En conclusión:
Con werf hemos avanzado significativamente en la resolución de numerosos problemas de los ingenieros DevOps, y nos complace que una comunidad más amplia al menos pruebe esta utilidad en acción. Será más fácil lograr buenos resultados juntos.
Videos y presentaciones
Vídeo de la presentación (~47 minutos):
Presentación de la charla:
P.D.
Otros informes sobre Kubernetes en nuestro blog:
- «» (Dmitry Stolyarov; 27 de abril de 2019 en «Stachka»);
- «» (Andrey Polovov; 8 de abril de 2019 en Saint HighLoad++);
- «» (Dmitry Stolyarov; 8 de noviembre de 2018 en HighLoad++);
- «» (Dmitry Stolyarov; 28 de mayo de 2018 en RootConf);
- «» (Dmitry Stolyarov; 7 de noviembre de 2017 en HighLoad++);
- «» (Dmitry Stolyarov; 6 de junio de 2017 en RootConf).
Fuente: habr.com
