

Los registros son una parte importante del sistema que permite entender si funciona (o no) como se espera. En un entorno de arquitectura de microservicios, trabajar con registros se convierte en una disciplina propia de una olimpiada especial. Hay que resolver una serie de preguntas:
- ¿cómo redactar registros desde la aplicación?
- ¿dónde escribir los registros?
- ¿cómo enviar los registros para su almacenamiento y procesamiento?
- ¿cómo procesar y almacenar los registros?
La aplicación de tecnologías de contenedorización actualmente populares añade complejidad a la búsqueda de soluciones a este problema.
De esto habla la presentación de Yuri Bushmelev "Mapa de obstáculos en el campo de recolección y entrega de registros".
A quienes les interese, les invito a leer más.
Me llamo Yuri Bushmelev. Trabajo en Lazada. Hoy hablaré sobre cómo manejamos nuestros registros, cómo los recolectamos y qué escribimos en ellos.
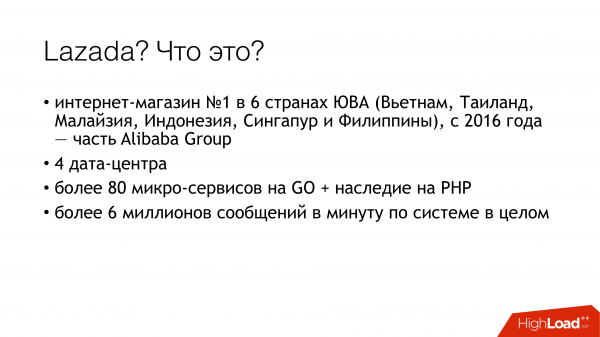
¿De dónde somos? ¿Quiénes somos? Lazada es la tienda en línea número 1 en seis países del sudeste asiático. Todos estos países están representados en nuestros centros de datos. Actualmente tenemos 4 centros de datos. ¿Por qué es importante? Porque algunas decisiones se deben a que hay un enlace muy débil entre los centros. Nuestra arquitectura es de microservicios. Me sorprendió descubrir que ya tenemos 80 microservicios. Cuando comencé con la tarea de los registros, solo había 20. Además, hay una gran parte de legado en PHP con la que también tenemos que convivir. Todo esto genera en este momento más de 6 millones de mensajes por minuto en todo el sistema. A continuación, mostraré cómo intentamos manejar esto y por qué es así.
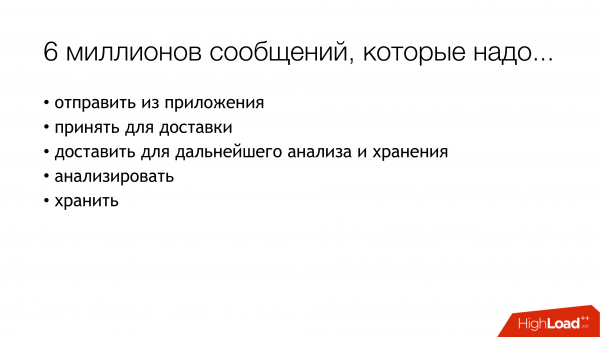
Hay que vivir con estos 6 millones de mensajes. ¿Qué debemos hacer con ellos? 6 millones de mensajes que hay que:
- enviar desde la aplicación
- recibir para la entrega
- entregar para análisis y almacenamiento.
- analizar
- almacenar de alguna manera.
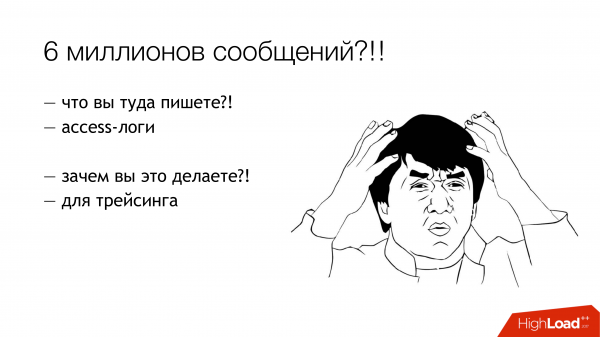
Cuando aparecieron tres millones de mensajes, tenía una expresión más o menos similar. Porque empezamos desde unas pocas monedas. Es obvio que se escriben registros de las aplicaciones. Por ejemplo, no se pudo conectar a la base de datos, se pudo conectar a la base de datos, pero no se pudo leer algo. Pero además de eso, cada uno de nuestros microservicios escribe también un registro de acceso. Cada solicitud que llega al microservicio se registra. ¿Por qué hacemos esto? Los desarrolladores quieren tener la capacidad de rastrear. En cada registro de acceso hay un campo traceid, a partir del cual una interfaz especial descompone toda la cadena y muestra el trazado de manera ordenada. El trazado muestra cómo pasó la solicitud y esto ayuda a nuestros desarrolladores a lidiar más rápidamente con cualquier cosa indeseada.
¿Cómo vivir con esto? Ahora les contaré brevemente sobre las opciones: cómo se resuelve en general este problema. Cómo abordar la tarea de recopilación, transmisión y almacenamiento de registros.
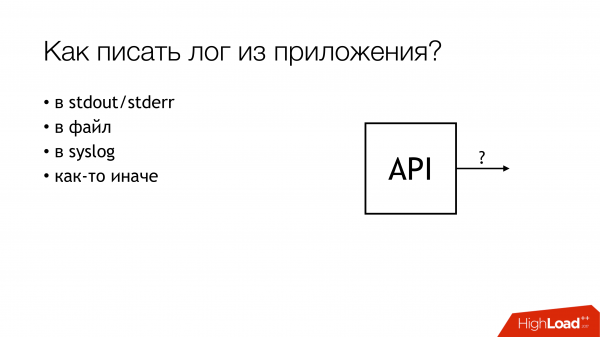
¿Cómo escribir desde la aplicación? Es obvio que hay diferentes formas. En particular, hay mejores prácticas, según nos cuentan los compañeros de moda. Hay el método tradicional en dos variantes, como solían contar nuestros abuelos. Existen otros métodos.
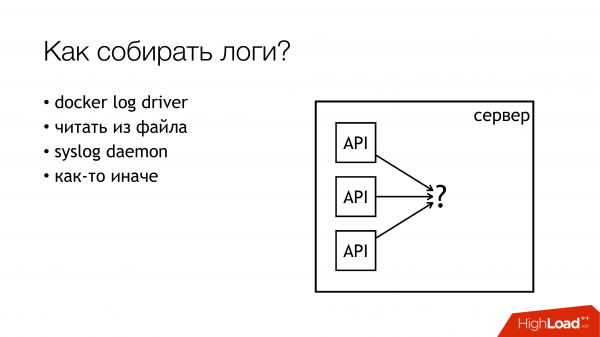
La situación con la recopilación de registros es bastante similar. No hay muchas opciones para resolver esta parte concreta. Ya hay más, pero todavía no son muchas.
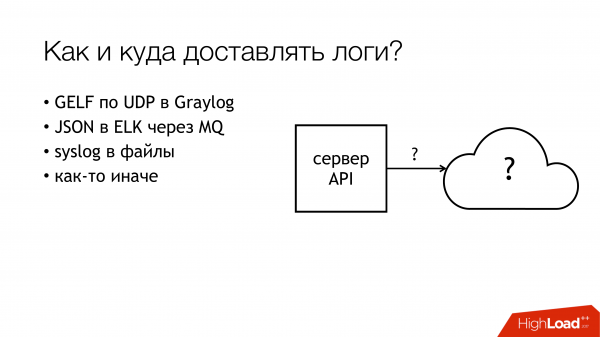
Pero con la entrega y el posterior análisis, la cantidad de variaciones comienza a explotar. No describiré cada variante ahora. Creo que las opciones principales son conocidas por todos los que han estado interesados en el tema.
Mostraré cómo hicimos esto en Lazada y cómo comenzó todo esto.
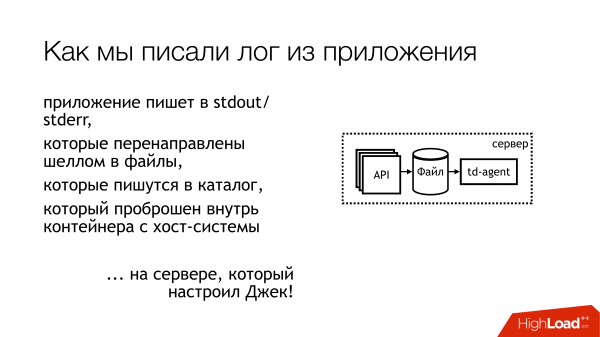
Hace un año llegué a Lazada y me enviaron al proyecto sobre registros. Así era más o menos. El registro de la aplicación se escribía en stdout y stderr. Todos lo hicimos a la moda. Pero luego los desarrolladores lo sacaron de los flujos estándar, y después los especialistas en infraestructura se encargarán de ello. Entre los especialistas en infraestructura y los desarrolladores hay también los responsables de las versiones, que dijeron: 'Eh... bueno, simplemente encapsulemos esto en un archivo usando shell y ya está'. Y dado que todo esto está en un contenedor, se encapsuló directamente dentro del contenedor, mapeamos el directorio y lo pusimos allí. Creo que a todos les resulta más o menos obvio qué salió de esto.
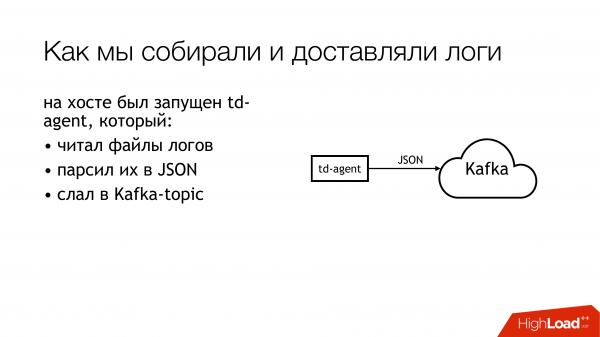
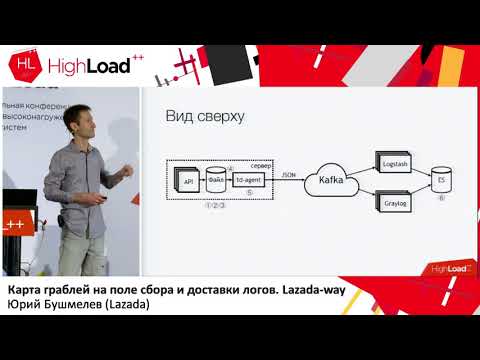
Veamos un poco más lejos. Cómo entregábamos estos registros. Alguien eligió td-agent, que en realidad es fluentd, pero no exactamente fluentd. No entendí la relación entre estos dos proyectos, pero parecen tratar sobre lo mismo. Y este fluentd, escrito en Ruby, leía archivos de registro, los analizaba en JSON mediante algunas expresiones regulares. Luego los enviaba a Kafka. De hecho, en Kafka teníamos 4 temas separados para cada API. ¿Por qué 4? Porque hay live, hay staging, y porque hay stdout y stderr. Los desarrolladores los generan, y los del equipo de infraestructura deben crearlos en Kafka. Además, Kafka era controlada por otro departamento. Por lo tanto, tenías que crear un ticket para que ellos crearan 4 temas para cada API. Todos se olvidaban de esto. En resumen, fue un desastre total.
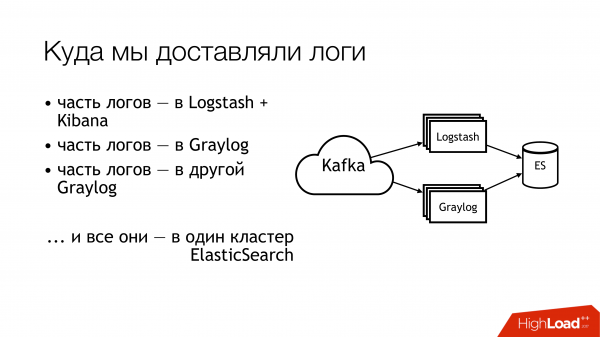
¿Qué hicimos luego con esto? Lo enviamos a Kafka. Luego, de Kafka, la mitad de los registros iban a Logstash. La otra mitad de los registros se dividían. Una parte iba a un Graylog, y la otra a otro Graylog. Al final, todo esto terminaba en un clúster de Elasticsearch. Así que, todo este desorden acababa ahí. ¡No se debe hacer así!
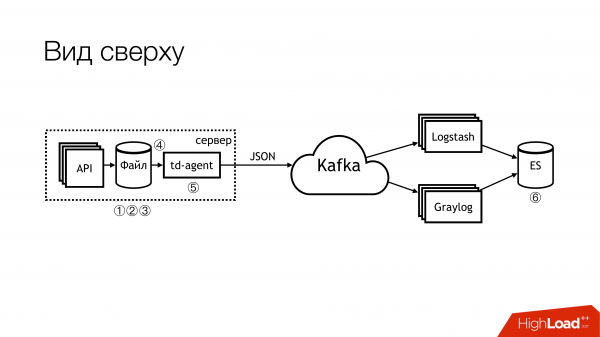
Así es como se ve, si lo miramos de manera general. ¡No se debe hacer así! Aquí, de inmediato, los lugares problemáticos están marcados con números. En realidad, hay más, pero 6 son los realmente problemáticos, con los que hay que hacer algo. Ahora les hablaré de ellos por separado.
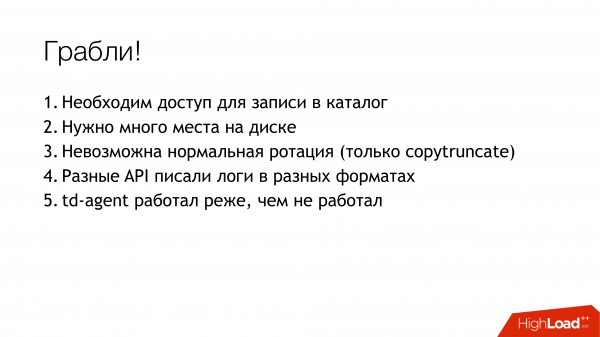
Aquí (1,2,3) se están escribiendo archivos y, por lo tanto, aquí hay tres dificultades de inmediato.
Primero (1) — necesitamos escribirlos en alguna parte. No siempre quisiéramos dar a la API la posibilidad de escribir directamente en un archivo. Sería deseable que la API estuviera aislada en un contenedor, y aún mejor, que fuera de solo lectura. Soy administrador de sistemas, así que tengo una perspectiva un poco alternativa sobre estas cosas.
El segundo punto (2,3) es que recibimos muchas solicitudes en la API. La API escribe muchos datos en un archivo. Los archivos crecen. Necesitamos rotarlos. De lo contrario, no habrá suficientes discos. Rotarlos es problemático porque están redirigidos a través de shell a un directorio. No podemos rotarlos de ninguna manera. No podemos decirle a la aplicación que vuelva a abrir los descriptores. Porque los desarrolladores te mirarían como si fueras un tonto: "¿Qué descriptores? Nosotros simplemente escribimos en stdout". Los administradores de infraestructura implementaron copytruncate en logrotate, que simplemente hace una copia del archivo y trunca el original. Así que, entre esos procesos de copia, generalmente se termina el espacio en disco.
(4) Tuvimos diferentes formatos en diferentes API. Eran un poco distintos, pero había que escribir regex distintos. Dado que todo esto se gestionaba con Puppet, había un gran conjunto de clases con sus propios problemas. Además, td-agent podría consumir memoria la mayor parte del tiempo, volverse lento, y simplemente podría hacer como si estuviera funcionando sin hacer nada. Desde afuera, era imposible notar que no estaba haciendo nada. En el mejor de los casos, se caía y alguien lo levantaba después. Más bien, llegaba una alerta y alguien tenía que reiniciarlo manualmente.
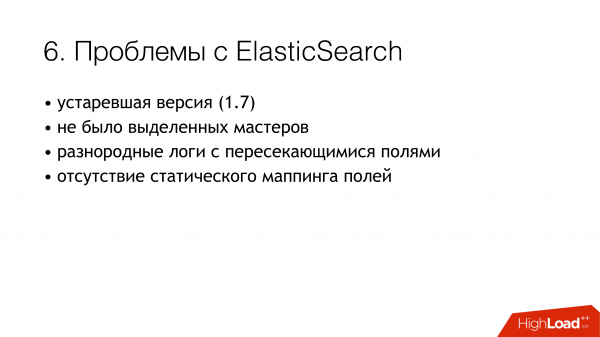
(6) Y el desastre total fue elasticsearch. Porque era una versión antigua. En ese momento no teníamos maestros dedicados. Teníamos registros heterogéneos cuyos campos podían superponerse. Diferentes registros de diferentes aplicaciones podían tener nombres de campos idénticos, pero los datos dentro podían ser diferentes. Es decir, un registro llegaba con un Integer en el campo, por ejemplo, level. Otro registro llegaba con un String en el campo level. En ausencia de un mapeo estático, esto podía causar problemas. Si después de rotar el índice en elasticsearch, el primer mensaje que llega es una cadena, todo funciona bien. Pero si el primero es un Integer, todos los mensajes posteriores que llegan con String simplemente son descartados. Porque el tipo de campo no coincide.
Comenzamos a hacernos estas preguntas. Decidimos no buscar culpables.
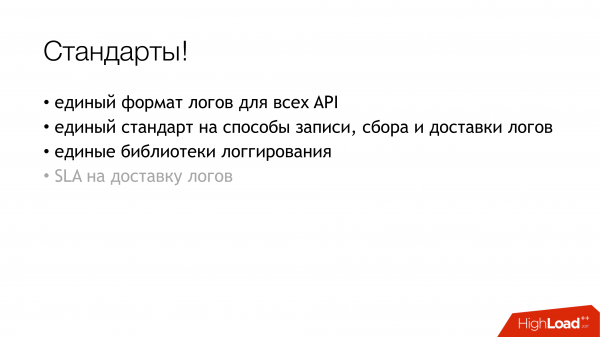
¡Pero hay que hacer algo! Es obvio que necesitamos establecer estándares. Ya teníamos algunos estándares. Algunos se establecieron un poco más tarde. Afortunadamente, en ese momento ya se aprobó un formato unificado de registros para todas las API. Está especificado en los estándares de interacción de los servicios. Por lo tanto, aquellos que quieran recibir registros deben escribirlos en este formato. Si alguien no escribe registros en este formato, significa que no garantizamos nada.
Además, nos gustaría establecer un estándar único para los métodos de grabación, entrega y recolección de registros. Básicamente, dónde escribirlos y cómo entregarlos. La situación ideal es cuando en los proyectos se utiliza la misma biblioteca. Hay una biblioteca de registro separada para Go, otra para PHP. Todos los que tenemos deben usarlas. En este momento diría que tenemos un 80% de éxito en esto. Pero algunos siguen teniendo problemas.
Y ahí (en la diapositiva) apenas comienza a aparecer el 'SLA para la entrega de registros'. Aún no lo tenemos, pero estamos trabajando en ello. Porque es muy conveniente cuando la infraestructura dice que si escribes en un formato determinado en un lugar específico y no más de N mensajes por segundo, entonces lo entregaremos con cierta probabilidad a tal lado. Esto elimina muchos dolores de cabeza. Si hay un SLA, ¡eso es realmente genial!
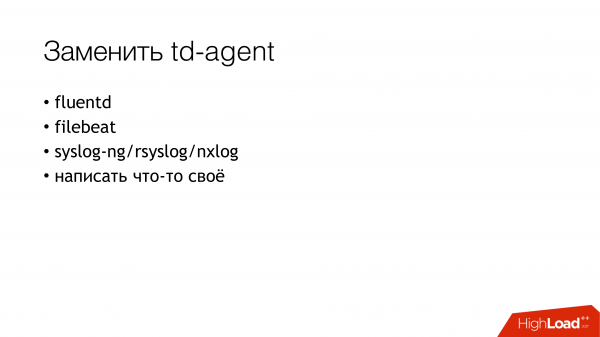
¿Cómo comenzamos a resolver el problema? El principal obstáculo era el td-agent. No estaba claro a dónde iban nuestros registros. ¿Se están entregando? ¿Se están recolectando? ¿Dónde están, en realidad? Por lo tanto, el primer paso fue decidir reemplazar el td-agent. He bosquejado brevemente las opciones para lo que se puede usar como sustituto.
Fluentd. En primer lugar, lo había encontrado en mi trabajo anterior, y allí también se caía periódicamente. En segundo lugar, es prácticamente lo mismo, pero más adaptado.
Filebeat. ¿Por qué era conveniente para nosotros? Porque está hecho en Go, y tenemos una gran experiencia en Go. Por lo tanto, si fuera necesario, podríamos adaptarlo de alguna manera. Así que no lo elegimos. Para no caer en la tentación de reescribirlo para nosotros.
La solución obvia para los administradores de sistemas son varios syslogs en esta cantidad (syslog-ng/rsyslog/nxlog).
O escribir algo propio, pero descartamos eso, al igual que filebeat. Si vamos a escribir algo, lo mejor es que sea algo útil para el negocio. Para la entrega de registros, es mejor elegir algo ya existente.
Por lo tanto, la elección se redujo a elegir entre syslog-ng y rsyslog. Me incliné por rsyslog simplemente porque ya teníamos clases para rsyslog en Puppet, y no encontré diferencias evidentes entre ellos. No importa si es syslog aquí o allá. Sí, la documentación de algunos es peor, la de otros es mejor. Uno lo hace de una manera, el otro de otra.
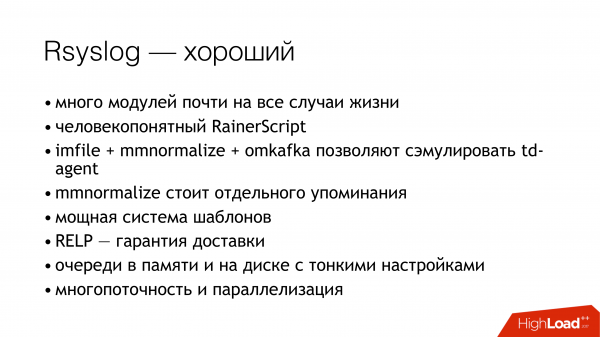
Y un poco sobre rsyslog. En primer lugar, es genial porque tiene muchos módulos. Tiene un RainerScript comprensible para los humanos (un lenguaje de configuración moderno). Un gran bono es que pudimos simular el comportamiento de td-agent con medios estándar, y para las aplicaciones no hubo cambios. Es decir, cambiamos td-agent por rsyslog, y todo lo demás permanece sin cambios. Y de inmediato obtenemos una entrega funcional. Además, mmnormalize es algo impresionante en rsyslog. Permite parsear logs, pero no usando Grok y regexp. Hace un árbol de sintaxis abstracta. Parsea los logs más o menos como un compilador parsea el código fuente. Esto permite trabajar muy rápido, consumir poco CPU y, en general, es algo realmente genial. Hay muchas otras ventajas. No me detendré en ellas.
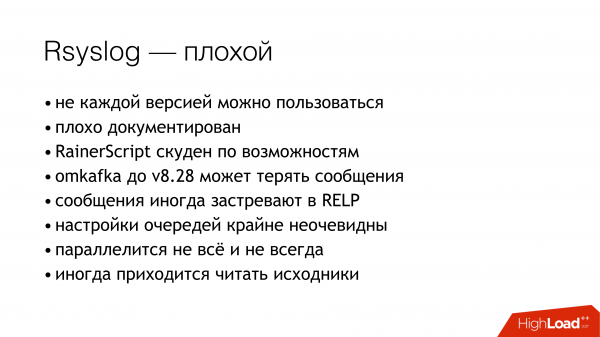
Rsyslog también tiene muchos inconvenientes. Son aproximadamente los mismos que los beneficios. Los principales problemas son que hay que saber configurarlo y hay que elegir la versión adecuada.
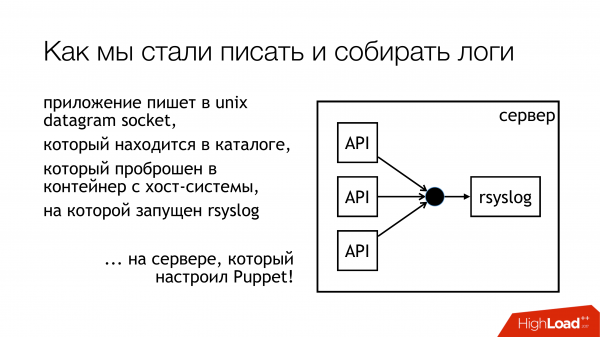
Decidimos que escribiríamos logs en un socket unix. No en /dev/log, porque ahí hay un lío de logs del sistema, con journald en esa canalización. Por lo tanto, escribamos en un socket personalizado. Lo conectaremos a un conjunto de reglas separado. No mezclaremos nada. Todo será transparente y claro. Así lo hicimos. El directorio con estos sockets está estandarizado y se pasa a todos los contenedores. Los contenedores pueden ver el socket que necesitan, abrirlo y escribir en él.
¿Por qué no un archivo? Porque todos leyeron , que intentaba pasar un archivo en docker y descubría que después de reiniciar rsyslog, el descriptor de archivo cambiaba y docker perdía ese archivo. Mantiene abierto algo diferente, pero ya no el socket al que se escribe. Decidimos que evitaríamos este problema y, de paso, evitaríamos el problema del bloqueo.
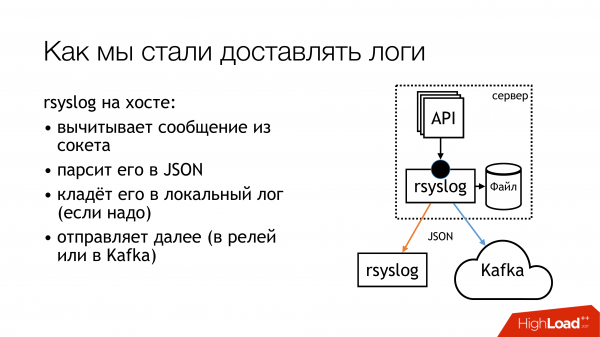
Rsyslog realiza las acciones indicadas en la diapositiva y envía los logs ya sea a un relay o a Kafka. Kafka corresponde al antiguo método. El relay es que intenté utilizar rsyslog puro para la entrega de logs. Sin Message Queue, con los medios estándar de rsyslog. En principio, esto funciona.
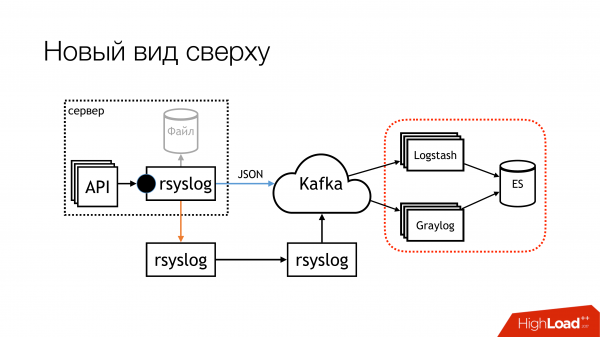
Pero hay matices sobre cómo introducirlos en esta parte (Logstash/Graylog/ES). Esta parte (rsyslog-rsyslog) se utiliza entre los centros de datos. Aquí hay un enlace TCP comprimido que permite ahorrar ancho de banda y, por lo tanto, aumentar la probabilidad de que recibamos algunos registros del otro centro de datos en condiciones en las que el canal está saturado. Porque tenemos Indonesia, donde todo va mal. Allí hay un problema constante.
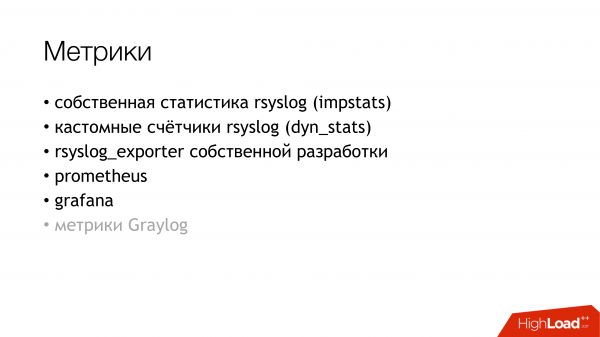
Nos preguntamos cómo controlar la probabilidad de que los registros que hemos grabado desde la aplicación lleguen a su destino. Decidimos establecer métricas. Rsyslog tiene su propio módulo de recopilación de estadísticas, que tiene algunos contadores. Por ejemplo, puede mostrar el tamaño de la cola o cuántos mensajes llegaron a una acción determinada. De ahí se puede extraer algo. Además, tiene contadores personalizados que se pueden configurar, y te mostrará, por ejemplo, la cantidad de mensajes que ha registrado una API determinada. Luego, escribí rsyslog_exporter en Python, y enviamos todo esto a Prometheus y construimos gráficos. Las métricas de Graylog eran muy deseadas, pero aún no hemos tenido tiempo para configurarlas.
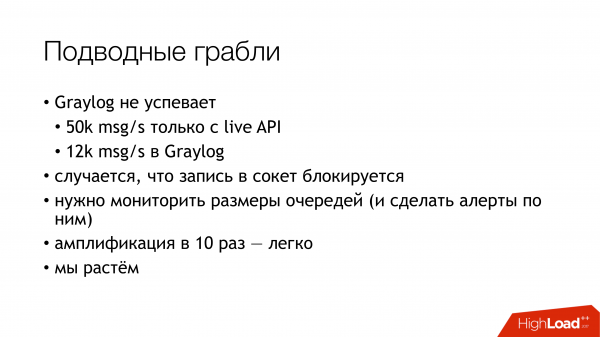
¿Cuáles fueron los problemas? Los problemas surgieron porque descubrimos (¡SORPRESA!) que nuestras API en vivo están escribiendo 50k mensajes por segundo. Eso es solo para las API en vivo, sin contar el staging. Y Graylog solo nos muestra 12 mil mensajes por segundo. Y se planteó la pregunta razonable, ¿dónde están los demás? De lo que dedujimos que Graylog simplemente no puede manejarlo. Miramos y, efectivamente, Graylog con Elasticsearch no podía procesar este flujo.
A continuación, otros descubrimientos que hicimos en el proceso.
Las escrituras en el socket se bloquean. ¿Cómo ocurrió esto? Cuando usé rsyslog para la entrega, en algún momento se rompió el canal entre los centros de datos. La entrega se detuvo en un lugar y luego en otro. Todo esto llegó a la máquina con la API que escribe en el socket de rsyslog. Se llenó la cola. Luego se llenó la cola para escribir en el socket unix, que por defecto tiene un límite de 128 paquetes. Y la siguiente write() en la aplicación se bloquea. Cuando revisamos la biblioteca que usamos en las aplicaciones de Go, decía que la escritura en el socket se realiza en modo no bloqueante. Estábamos seguros de que nada se bloqueaba. Porque leímos. , que escribió sobre esto. Pero hay un detalle. Alrededor de esta llamada había un ciclo infinito, donde constantemente se intentaba enviar un mensaje al socket. Eso no lo notamos. Tuvimos que reescribir la biblioteca. Desde entonces ha cambiado varias veces, pero ahora hemos eliminado los bloqueos en todos los subsistemas. Por lo tanto, se puede detener rsyslog y no fallará nada.
Es necesario monitorear el tamaño de las colas, lo que ayuda a evitar cometer estos errores. En primer lugar, podemos monitorear cuándo comenzamos a perder mensajes. En segundo lugar, podemos monitorear si en general tenemos problemas con la entrega.
Y hay otro punto desagradable: la amplificación de 10 veces en una arquitectura de microservicios es muy fácil. No tenemos muchas solicitudes entrantes, pero debido al grafo por el que circulan estos mensajes, debido a los registros de acceso, realmente aumentamos la carga en los registros aproximadamente diez veces. Lamentablemente, no tuve tiempo de calcular cifras exactas, pero los microservicios son así. Hay que tenerlo en cuenta. Por lo tanto, en este momento, el subsistema de recopilación de registros es el más sobrecargado en Lazada.
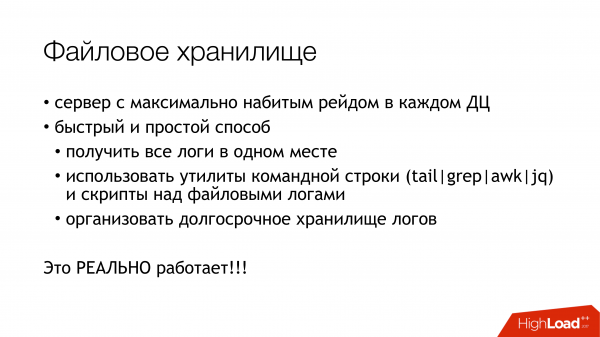
¿Cómo solucionar el problema de elasticsearch? Si necesita obtener rápidamente los registros en un solo lugar, para no tener que ir a todas las máquinas y recogerlos allí, use un almacenamiento de archivos. Eso funciona garantizado. Se puede hacer desde cualquier servidor. Solo necesita colocar discos allí y configurar syslog. Después de eso, tendrá todos los registros garantizados en un solo lugar. Luego podrá configurar elasticsearch, graylog o algo más a su ritmo. Pero ya tendrá todos los registros y, de hecho, podrá almacenarlos tanto como los arrays de disco lo permitan.
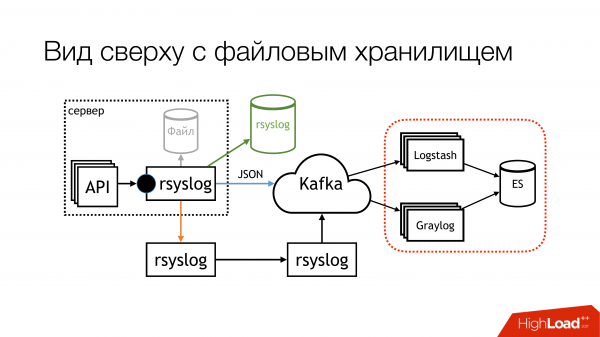
En el momento de mi presentación, el esquema se veía así. Prácticamente hemos dejado de escribir en archivos. Ahora, probablemente, desconectaremos los remanentes. En las máquinas locales donde se ejecutan las API, dejaremos de escribir en archivos. En primer lugar, hay un almacenamiento de archivos que funciona muy bien. En segundo lugar, en estas máquinas, el espacio se llena constantemente, hay que monitorearlo continuamente.
Esta parte con Logstash y Graylog realmente está generando problemas. Por eso hay que deshacerse de ella. Hay que elegir una de las dos.
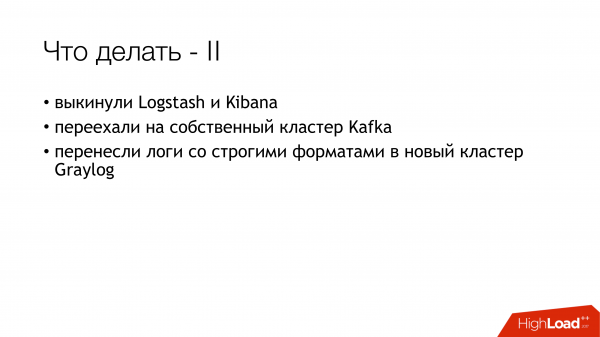
Decidimos dejar de lado Logstash y Kibana. Porque tenemos un departamento de seguridad. ¿Cuál es la conexión? La conexión es que Kibana, sin X-Pack y sin Shield, no permite diferenciar los derechos de acceso a los registros. Por eso optamos por Graylog. Tiene todo esto. No me gusta, pero funciona. Compramos nuevo hardware, instalamos Graylog fresco y trasladamos todos los registros con formatos estrictos a un Graylog separado. Resolvímos el problema de diferentes tipos de campos iguales de manera organizativa.
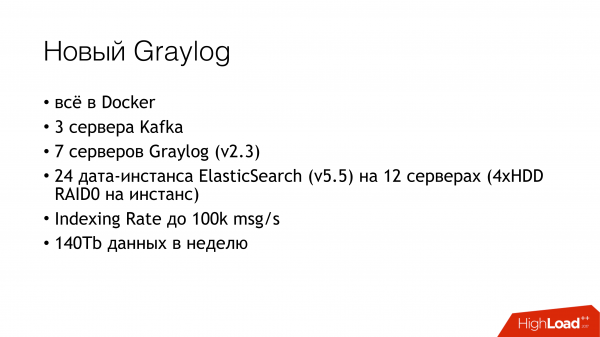
¿Qué incluye realmente el nuevo Graylog? Simplemente lo grabamos todo en Docker. Tomamos un montón de servidores, desplegamos tres instancias de Kafka y 7 servidores de Graylog versión 2.3 (porque queríamos Elasticsearch versión 5). Todo esto lo levantamos en RAID de HDD. Vimos una tasa de indexación de hasta 100 mil mensajes por segundo. Vimos la cifra de que 140 terabytes de datos por semana.
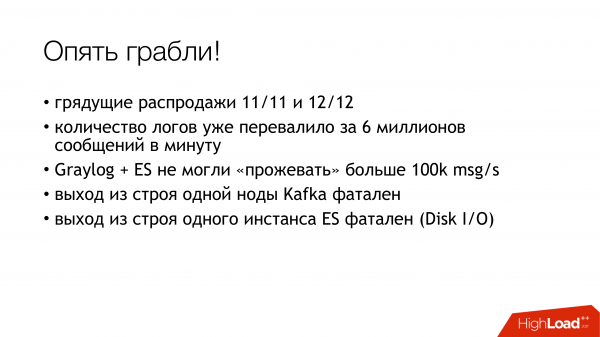
¡Y nuevamente tropiezos! Se avecinan dos ventas. Nos mudamos por 6 millones de mensajes. Graylog no logra procesar todo. De alguna manera, tenemos que sobrevivir nuevamente.
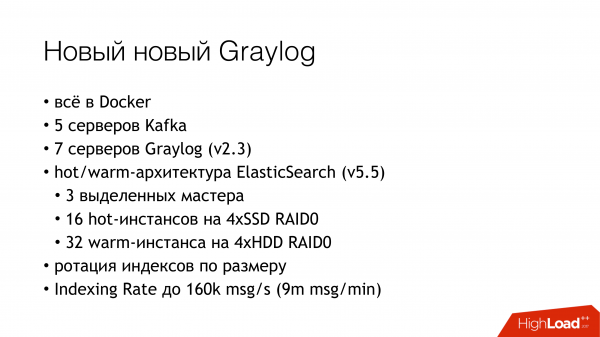
Sobrevivimos de esta manera. Agregamos un poco más de servidores y SSD. En este momento, vivimos de esta forma. Ahora procesamos ya 160 mil mensajes por segundo. Aún no hemos llegado al límite, por lo que por ahora no está claro cuánto realmente podremos extraer de esto.
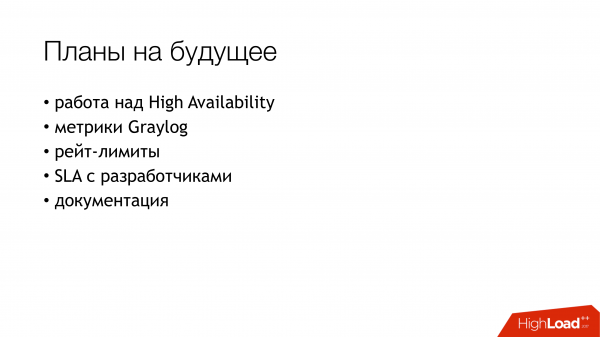
Estos son nuestros planes para el futuro. De ellos, realmente, lo más importante, probablemente, sea la alta disponibilidad. Aún no la tenemos. Algunas máquinas están configuradas de la misma manera, pero todo pasa por una sola máquina. Necesitamos dedicar tiempo a configurar el failover entre ellas.
Recoger métricas de Graylog.
Hacer un rate limit para que nuestra API, que se volvió loca, no nos destruya el bandwidth y todo lo demás.
Y finalmente, firmar algún SLA con los desarrolladores, indicando que podemos atender hasta esta cantidad. Si ustedes escriben más, lo sentimos.
Y escribir documentación.
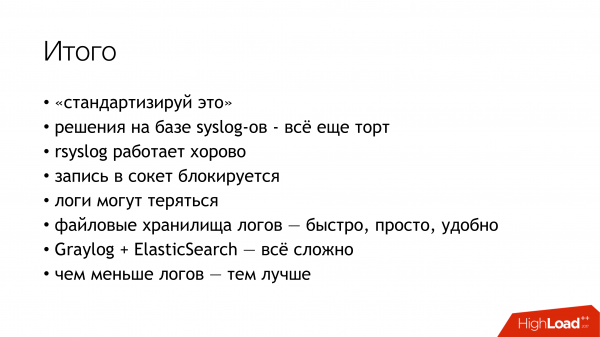
En resumen, los resultados de todo lo que hemos vivido. Primero, estándares. Segundo, syslog — una delicia. Tercero, rsyslog funciona exactamente como se indica en la diapositiva. Y pasemos a las preguntas.
Preguntas.
Pregunta: ¿Por qué decidieron no usar… (filebeat?)
Respuesta: Necesitamos escribir en un archivo. No quería hacerlo en absoluto. Cuando tu API escribe miles de mensajes por segundo, incluso si rotas una vez por hora, sigue sin ser una opción. Se puede escribir en un pipe. A lo que los desarrolladores me preguntaron: «¿Qué pasará si el proceso al que estamos escribiendo se cae?» Simplemente no encontré qué responderles y dije: «Bueno, está bien, no lo hagamos».
Pregunta: ¿Por qué no escriben los registros directamente en HDFS?
Respuesta: Este es el siguiente paso. Lo pensamos desde un principio, pero, como en este momento no hay recursos para trabajar en ello, queda como una solución a largo plazo.
Pregunta: Un formato columnar sería más adecuado.
Respuesta: Entiendo todo. Estamos a favor con ambas manos.
Pregunta: Escriben en rsyslog. Ahí se puede usar TCP y UDP. Pero si es UDP, ¿cómo garantizan la entrega?
Respuesta: Hay dos puntos. Primero, les digo desde el principio que no garantizamos la entrega de los registros. Porque cuando los desarrolladores vienen y dicen: 'Vamos a empezar a escribir datos financieros ahí, y ustedes los almacenarán en algún lugar por si algo sucede', nosotros les respondemos '¡Genial! Vamos a hacer que se bloqueen en la escritura en el socket y a hacer esto en transacciones, para que nos aseguren que lo han puesto en el socket y verifiquen que lo recibimos por el otro lado.' En ese momento, a todos se les quita el interés. Y si no están interesados, ¿cuáles son nuestras preguntas? Si no quieren garantizar la escritura en el socket, ¿por qué debemos garantizar la entrega? Hacemos un esfuerzo máximo. Realmente intentamos entregar tanto como sea posible y lo mejor que podamos, pero no damos garantías del 100%. Así que no deben escribir datos financieros ahí. Para eso hay bases de datos con transacciones.
Pregunta: Cuando una API genera algún mensaje en el registro y pasa el control a los microservicios, ¿no han tenido el problema de que los mensajes de diferentes microservicios llegan en un orden incorrecto? Esto causa confusión.
Respuesta: Es normal que lleguen en diferente orden. Hay que estar preparados para ello. Porque cualquier entrega a través de la red no garantiza el orden, o hay que gastar recursos específicamente para eso. Si tomamos los almacenes de archivos, cada API guarda los registros en su propio archivo. Más bien, rsyslog los distribuye en carpetas. Cada API tiene sus propios registros a los que se puede acceder y luego se pueden correlacionar por timestamp en ese registro. Si van a ver en Graylog, allí están ordenados por timestamp. Todo estará bien.
Pregunta: El timestamp puede diferir en milisegundos.
Respuesta: El timestamp lo genera la API misma. Esa es la esencia. Nosotros tenemos NTP. La API genera el timestamp ya en el propio mensaje. No lo agrega rsyslog.
Pregunta: No está muy claro cómo interactúan los centros de datos. Dentro de un centro de datos se entiende cómo se recopilan y procesan los logs. ¿Cómo se produce la interacción entre los centros de datos? ¿O cada centro de datos vive su propia vida?
Respuesta: Casi. Cada país está en algún centro de datos específico. No tenemos, en este momento, una dispersión de un país a varios centros de datos. Así que no es necesario fusionarlos. Dentro de cada centro hay un Log Relay. Es un servidor Rsyslog. En realidad, hay dos máquinas de gestión. Están configuradas de la misma manera. Pero, por ahora, el tráfico solo pasa por una de ellas. Esta agrega todos los logs. Tiene una cola en disco por si acaso. Comprime los logs y los envía al centro de datos central (el de Singapur), donde luego se envían a Graylog. Y en cada centro de datos hay su propio almacenamiento de archivos. En caso de que perdamos la conexión, tenemos todos los logs ahí. Permanecerán allí. Serán guardados.
Pregunta: ¿Recibes logs de ahí en situaciones excepcionales?
Respuesta: Se puede ir allí (al almacenamiento de archivos) y revisar.
Pregunta: ¿Cómo monitorean para asegurarse de que no pierden logs?
Respuesta: En realidad, los perdemos, y lo estamos monitoreando. Iniciamos el monitoreo hace un mes. En la biblioteca que utiliza la API de Go, hay métricas. Puede contar cuántas veces no pudo escribir en el socket. Actualmente, hay una heurística inteligente. Hay un búfer. Intenta escribir mensajes en el socket desde él. Si el búfer se llena, comienza a descartarlos. Y cuenta cuántos ha descartado. Si los contadores comienzan a llenarse, nos enteramos. Ahora llegan a Prometheus y se pueden ver gráficos en Grafana. Se pueden configurar alertas. Pero por ahora no está claro a quién enviarlas.
Pregunta: En Elasticsearch almacenar logs con redundancia. ¿Cuántas réplicas tienen?
Respuesta: Una réplica.
Pregunta: ¿Es solo una réplica?
Respuesta: Es un maestro y una réplica. Los datos se almacenan en dos instancias.
Pregunta: ¿Has ajustado de alguna manera el tamaño del búfer de rsyslog?
Respuesta: Estamos escribiendo datagramas en un socket unix personalizado. Esto nos impone de inmediato una limitación de 128 kilobytes. No podemos escribir más que eso. Lo hemos establecido en el estándar. Aquellos que quieren acceder a los storages, escriben 128 kilobytes. Las bibliotecas, de hecho, recortan y colocan una bandera indicando que el mensaje fue recortado. En nuestro estándar del propio mensaje hay un campo especial que muestra si fue recortado al escribir o no. Así que tenemos la capacidad de rastrear ese aspecto.
Pregunta: ¿Escriben JSON dañados?
Respuesta: El JSON dañado será descartado ya sea durante el relay, porque el paquete es demasiado grande, o será descartado por Graylog, ya que no podrá parsear el JSON. Pero aquí hay matices que deben corregirse, y la mayoría de ellos están relacionados con rsyslog. Ya he registrado allí varios problemas que aún debemos abordar.
Pregunta: ¿Por qué Kafka? ¿Han probado RabbitMQ? ¿Graylog no se desempeña bien bajo tales cargas?
Respuesta: No tenemos buena experiencia con Graylog. Con él realmente es problemático. Es una cosa peculiar. Y, en realidad, no lo necesitamos. Preferiría escribir directamente desde rsyslog a Elasticsearch y luego ver en Kibana. Pero necesitamos resolver el tema con los de seguridad. Esta es una posible dirección de nuestro desarrollo, cuando desecharemos Graylog y usaremos Kibana. No tiene sentido usar Logstash. Porque puedo hacer exactamente lo mismo con rsyslog. Y tiene un módulo para escribir en Elasticsearch. Estamos tratando de lidiar con Graylog. Incluso lo hemos afinado un poco. Pero aún hay espacio para mejoras.
Sobre Kafka. Históricamente, así ha sido. Cuando llegué, ya existía y se estaban registrando logs en ella. Simplemente levantamos nuestro clúster y trasladamos los logs a él. Lo gestionamos, sabemos cómo está funcionando. En cuanto a RabbitMQ... no nos llevamos bien con RabbitMQ. Pero con RabbitMQ tenemos una buena relación. Lo tenemos en producción y tuvimos problemas con él. Poco antes de las rebajas le hicimos ajustes y empezó a funcionar bien. Pero antes de eso, no estaba listo para ponerlo en producción. Hay otro aspecto. Graylog puede leer la versión AMQP 0.9, mientras que rsyslog puede escribir la versión AMQP 1.0. No hay solución alguna que maneje ambos. Solo hay una o la otra. Por lo tanto, por el momento, solo Kafka. Pero también tiene sus matices. Porque omkafka de la versión de rsyslog que usamos puede perder todo el buffer de mensajes que ha recopilado de rsyslog. Por ahora, tenemos que vivir con eso.
Pregunta: ¿Utilizan Kafka porque ya la tenían? ¿No se utiliza para otros propósitos?
Respuesta: La Kafka que tenían está siendo utilizada por el equipo de Data Science. Es un proyecto completamente separado, del que, lamentablemente, no puedo decir mucho. No estoy al tanto. Estaba bajo la responsabilidad del equipo de Data Science. Decidieron usarla al empezar a registrar logs, para no instalar otra. Ahora hemos actualizado Graylog y hemos perdido la compatibilidad porque hay una versión antigua de Kafka. Tuvimos que establecer la nuestra. Además, nos deshicimos de esos cuatro tópicos para cada API. Creamos un único tópico ancho para todos los live, un tópico ancho para todos los staging y simple y sencillamente estamos enviando todos los logs allí. Graylog está recogiendo todo eso en paralelo.
Pregunta: ¿Por qué es necesario este tipo de ajustes con los sockets? ¿Han probado utilizar el controlador de logs syslog para los contenedores?
Respuesta: En el momento en que estábamos abordando este tema, nuestra relación con Docker era tensa. Era Docker 1.0 o 0.9. Docker en sí era extraño. En segundo lugar, si encima se intentaban meter los logs... Tengo una sospecha no comprobada de que pasa todos los logs a través de su demonio. Si una de nuestras APIs se vuelve loca, las otras APIs se atascan porque no pueden enviar stdout y stderr. No sé a dónde conducirá esto. Tengo una sospecha, a nivel de intuición, de que no deberíamos usar el controlador syslog de Docker en este lugar. Nuestro departamento de pruebas funcionales tiene su propio pequeño clúster de Graylog para los logs. Ellos usan los controladores de logs de Docker y, al parecer, les va bastante bien. Pero ellos escriben directamente en Graylog utilizando GELF. En ese momento, cuando comenzamos con todo esto, solo necesitábamos que funcionara. Quizás más adelante, cuando alguien venga y diga que ya lleva funcionando bien un tiempo, lo intentaremos.
Pregunta: Hacen la entrega entre centros de datos con rsyslog. ¿Por qué no con Kafka?
Respuesta: Hacemos ambas cosas, en realidad. Por dos razones. Si el canal está completamente dañado, ni siquiera todos nuestros logs en versión comprimida pasan a través de él. Kafka nos permite simplemente perderlos en el proceso. De esta manera, evitamos que esos logs se queden atascados. En este caso, usamos Kafka directamente. Si el canal es bueno y queremos liberarlo, utilizamos rsyslog. Pero en realidad, podría configurarse para que eliminara automáticamente lo que no pudo pasar. Actualmente, usamos rsyslog directamente en algunos lugares y Kafka en otros.
Fuente: habr.com
