

Comparto desde mi experiencia personal lo que ha sido útil, dónde y cuándo. De manera general y concisa, para que quede claro qué y dónde se puede indagar más, aunque esto se basa exclusivamente en mi experiencia subjetiva; puede que para usted sea completamente diferente.
¿Por qué es importante conocer y saber manejar los lenguajes de consulta? En esencia, hay varias etapas cruciales en el trabajo de Data Science, y la primera y más importante (sin la cual nada funcionará) es la adquisición o extracción de datos. Por lo general, los datos se encuentran en algún lugar y es necesario 'sacarlos' de allí.
¡Los lenguajes de consulta son precisamente lo que permite extraer esos datos! Hoy les hablaré de los lenguajes de consulta que me han sido útiles y les mostraré dónde y cómo exactamente — por qué son necesarios para el aprendizaje.
En total, habrá tres bloques principales de tipos de consultas a datos que analizaremos en este artículo:
- Lenguajes de consulta 'estándar' — lo que normalmente pensamos cuando hablamos de un lenguaje de consulta, como la álgebra relacional o SQL.
- Lenguajes de consulta de scripting: por ejemplo, las herramientas de Python como pandas, numpy o scripting de shell.
- Lenguajes de consulta para grafos de conocimiento y bases de datos de grafos.
Todo lo que se ha escrito aquí es simplemente una experiencia personal sobre lo que ha sido útil, con descripciones de situaciones y 'por qué fue necesario' — cada uno puede ver cuán similares podrían ser estas situaciones para ustedes y tratar de prepararse de antemano, familiarizándose con estos lenguajes antes de que tengan que aplicarlos (con urgencia) en un proyecto o incluso tener que entrar a un proyecto donde se requieran.
Lenguajes de consulta 'estándar'
Los lenguajes de consulta estándar en el sentido de que casi siempre pensamos en ellos cuando hablamos de consultas.
Álgebra relacional
¿Por qué es necesaria la álgebra relacional hoy? Para tener una buena comprensión de por qué los lenguajes de consulta están estructurados de cierta manera y usar conscientemente, hay que entender el núcleo subyacente.
¿Qué es la álgebra relacional?
La definición formal es la siguiente: la álgebra relacional es un sistema cerrado de operaciones sobre relaciones en el modelo relacional de datos. En términos más comprensibles, es un sistema de operaciones sobre tablas, de tal manera que el resultado siempre es también una tabla.
Consulta todas las operaciones relacionales en el artículo de Habr; aquí describimos por qué es importante saber y dónde se aplica.
¿Por qué?
Comienzas a entender de qué se componen realmente los lenguajes de consulta y qué operaciones están detrás de las expresiones de lenguajes de consulta específicos; esto a menudo proporciona una comprensión más profunda de lo que y cómo funcionan los lenguajes de consulta.
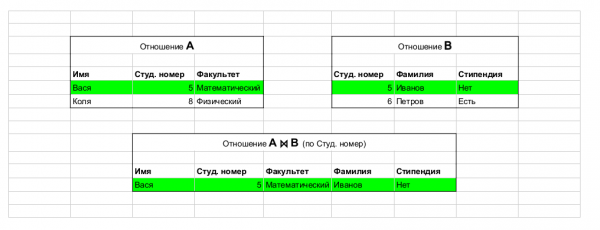
Tomado de el artículo. Ejemplo de operación: join, que une tablas.
Materiales para estudiar:
. En general, hay muchos materiales sobre álgebra relacional y teoría: Coursera, Udacity. También hay una gran cantidad de materiales en línea, incluidos buenos . Mi consejo personal: es fundamental entender muy bien el álgebra relacional; es la base de todo.
SQL
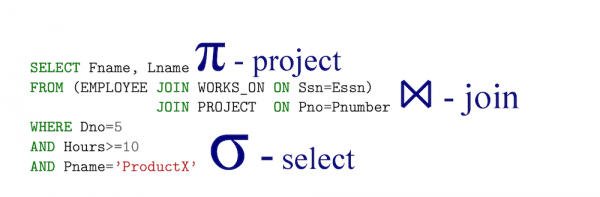
Tomado de artículo.
SQL es, en esencia, una implementación del álgebra relacional, con la importante advertencia de que SQL es declarativo. Es decir, al escribir una consulta en el lenguaje del álgebra relacional, estás indicando cómo se debe calcular; con SQL, por otro lado, especificas qué deseas extraer, y luego el SGBD genera (efectivamente) expresiones en el lenguaje del álgebra relacional (su equivalencia es conocida como ).
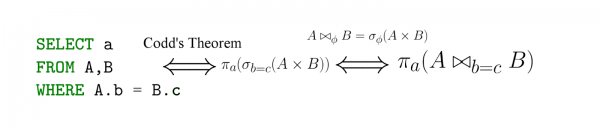
Tomado de artículo.
¿Por qué?
Las bases de datos relacionales: Oracle, Postgres, SQL Server, etc. siguen estando prácticamente en todas partes y hay una enorme probabilidad de que debas interactuar con ellas, lo que significa que tendrás que leer SQL (lo cual es muy probable) o escribir en él (también no es poco probable).
Qué leer y estudiar
En los mismos enlaces anteriores (sobre álgebra relacional), hay una cantidad increíble de material, por ejemplo, .
Por cierto, ¿qué es NoSQL?
«Es importante recalcar nuevamente que el término “NoSQL” tiene un origen absolutamente espontáneo y no cuenta con una definición reconocida ni con una institución científica respaldándolo.» Correspondiente en Habr.
En esencia, las personas se dieron cuenta de que el modelo relacional completo no es necesario para resolver muchos problemas, especialmente aquellos donde, por ejemplo, la productividad es crucial y predominan ciertas consultas simples con agregación; allí es crítico calcular métricas rápidamente y escribirlas en la base, y la mayoría de las características relacionales resultaron no solo innecesarias, sino perjudiciales: ¿por qué normalizar algo si va a afectar negativamente lo más importante para nosotros (para una tarea concreta) — la productividad?
A menudo se requieren esquemas flexibles en lugar de esquemas matemáticos fijos del modelo relacional clásico, lo que simplifica enormemente el desarrollo de aplicaciones cuando es crítico desplegar un sistema y comenzar a trabajar rápidamente procesando resultados; o el esquema y los tipos de datos almacenados no son tan importantes.
Por ejemplo, estamos creando un sistema experto y queremos almacenar información sobre un dominio específico junto con cierta metainformación; podemos no conocer todos los campos y simplemente almacenar JSON para cada registro, lo que nos proporciona un entorno muy flexible para ampliar el modelo de datos y iterar rápidamente. Por lo tanto, en este caso, NoSQL será incluso preferible y más legible. Un ejemplo de registro (de uno de mis proyectos, donde NoSQL fue justo donde se necesitaba).
{"en_wikipedia_url":"https://en.wikipedia.org/wiki/Johnny_Cash",
"ru_wikipedia_url":"https://ru.wikipedia.org/wiki/?curid=301643",
"ru_wiki_pagecount":149616,
"entity":[42775,"Джонни Кэш","ru"],
"en_wiki_pagecount":2338861}
Se puede leer más sobre NoSQL.
¿Qué estudiar?
Aquí es más bien necesario analizar bien su tarea, cuáles son sus propiedades y qué sistemas NoSQL que se adapten a esta descripción existen, para luego dedicarte a estudiar ese sistema.
Lenguajes de consulta de scripts
Primero, parece, ¿qué tiene que ver Python aquí? — es un lenguaje de programación, y no trata sobre consultas en absoluto.
- Pandas es como el cuchillo suizo de la Ciencia de Datos, una gran cantidad de transformaciones de datos, agregaciones, etc. se realizan en él.
- Numpy — cálculos vectoriales, matrices y álgebra lineal están ahí.
- Scipy — mucha matemática en este paquete, especialmente estadísticas.
- Jupyter lab — mucho análisis exploratorio de datos se adapta bien a los cuadernos, es útil saberlo.
- Requests — trabajo con red.
- Pyspark — muy popular entre ingenieros de datos, probablemente tendrás que interactuar con esto o con Spark, simplemente por su popularidad.
- *Selenium — muy útil para la recolección de datos de sitios web y recursos, a veces simplemente no hay otra manera de obtener datos.
Mi consejo principal: ¡aprende Python!
Pandas
Tomemos como ejemplo el siguiente código:
import pandas as pd
df = pd.read_csv("data/dataset.csv")
# Calcular y renombrar agregaciones
all_together = (df[df['trip_type'] == "return"]
    .groupby(['start_station_name','end_station_name'])
                            .agg({'trip_duration_seconds': [np.size, np.mean, np.min, np.max]})
                           .rename(columns={'size': 'num_trips',
           'mean': 'avg_duration_seconds',
           'amin': 'min_duration_seconds',
           'amax': 'max_duration_seconds'}))
En esencia, vemos que el código se ajusta a un patrón clásico de SQL.
SELECT start_station_name, end_station_name, count(trip_duration_seconds) as size, …..
FROM dataset
WHERE trip_type = 'return'
GROUP BY start_station_name, end_station_name
Pero lo importante es que este código es parte de un script y un pipeline; de hecho, estamos integrando consultas en el pipeline de Python. En esta situación, el lenguaje de consultas proviene de bibliotecas como Pandas o pySpark.
En general, en pySpark vemos un tipo similar de transformación de datos a través del lenguaje de consultas al estilo de:
df.filter(df.trip_type == 'return')
  .groupby('day')
  .agg({duration: 'mean'})
  .sort()
Dónde y qué leer
Sobre Python en general encontrar materiales para estudiar. Hay una gran cantidad de tutoriales en línea sobre , y cursos sobre (así como sobre el mismo ). En general, aquí los materiales se googlean muy bien y si tuviera que elegir un paquete en el que concentrarse, sería pandas, por supuesto. Hay también .
Shell como lenguaje de consultas
Numerosos proyectos de procesamiento y análisis de datos con los que he trabajado son, de hecho, scripts de shell que llaman código en Python, en Java y, propiamente, comandos shell. Por lo tanto, se pueden considerar los pipelines en bash/zsh/etc. como una especie de consulta de alto nivel (puedes incluir ciclos, claro, pero no es típico para el código de DS en lenguajes shell). Pongamos un ejemplo simple: necesitaba hacer el mapeo de QID de Wikidata y el enlace completo a las versiones en ruso e inglés de Wikipedia, para ello escribí una simple consulta de comandos en bash y, para la salida, escribí un simple script en Python que junté de esta manera:
pv 'data/latest-all.json.gz' |
unpigz -c |
jq --stream $JQ_QUERY |
python3 scripts/post_process.py 'output.csv'
donde
JQ_QUERY = 'select((.[0][1] == "sitelinks" and (.[0][2]=="enwiki" or .[0][2] =="ruwiki") and .[0][3] =="title") or .[0][1] == "id")' Ese fue, en esencia, todo el pipeline que creó el mapeo necesario; como vemos, todo funcionó en modo streaming:
- pv filepath — da una barra de progreso basada en el tamaño del archivo y pasa su contenido a continuación
- unpigz -c leía parte del archivo comprimido y lo pasaba a jq
- jq con la opción —stream proporcionaba inmediatamente el resultado y lo pasaba al procesador posterior (igual que en el primer ejemplo) en Python
- dentro del procesador posterior — es una simple máquina de estados que formatea la salida
En resumen, un pipeline complejo que trabaja en modo de flujo con grandes datos (0.5TB), sin recursos significativos y construido a partir de un pipeline simple y algunas herramientas.
Otro consejo importante: asegúrate de trabajar bien y de forma eficaz en la terminal y de escribir en bash/zsh/etc.
¿Dónde es útil? Casi en todas partes: hay MUCHOS materiales para estudiar en línea. En particular, aquí está mi artículo anterior.
Programación en R
Una vez más, el lector puede exclamar: ¡pero eso es todo un lenguaje de programación! Y por supuesto, tendría razón. Sin embargo, generalmente me ha tocado encontrarme con R en un contexto donde, en esencia, se asemejaba a un lenguaje de consultas.
R es un entorno de cálculos estadísticos y un lenguaje de cálculos y visualización estadística (según ).
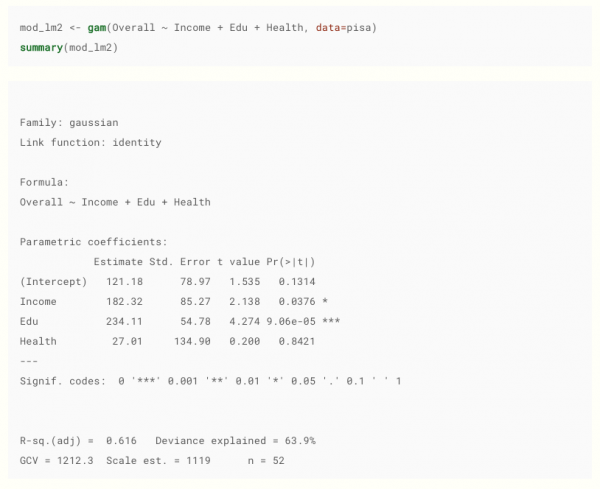
Tomado de . Por cierto, lo recomiendo, es un buen material.
¿Por qué un científico de datos debería conocer R? Al menos, porque hay un gran número de personas fuera de IT que realizan análisis de datos en R. Lo he encontrado en los siguientes ámbitos:
- El sector farmacéutico.
- Biólogos.
- El sector financiero.
- Personas con formación matemática pura que se dedican a la estadística.
- Modelos estadísticos especializados y modelos de aprendizaje automático (que a menudo solo se pueden encontrar en versiones autorales en forma de paquetes de R).
¿Por qué es en realidad un lenguaje de consultas? En la forma en que a menudo se encuentra, es en realidad una consulta para crear un modelo, incluyendo la lectura de datos y la fijación de parámetros de consulta (del modelo), así como la visualización de datos en paquetes como ggplot2; esto también es una forma de escribir consultas.
Ejemplo de consultas para visualización
ggplot(data = beav,
       aes(x = id, y = temp,
           group = activ, color = activ)) +
  geom_line() +
  geom_point() +
  scale_color_manual(values = c("red", "blue"))
En general, muchas ideas de R se han trasladado a paquetes de python, como pandas, numpy o scipy, como marcos de datos y vectorización de datos; por lo tanto, muchas cosas en R te parecerán familiares y cómodas.
Hay muchas fuentes para estudiar, por ejemplo, .
Gráficos de conocimiento (Knowledge graph)
Aquí tengo una experiencia un poco inusual, porque a menudo tengo que trabajar con gráficos de conocimiento y lenguajes de consultas para gráficos. Por lo tanto, solo pasaremos brevemente sobre las bases, ya que esta parte es un poco más exótica.
En bases de datos relacionales clásicas, tenemos un esquema fijo; aquí, sin embargo, el esquema es flexible, cada predicado es en esencia "una columna" e incluso más.
Imagina que modelaras a una persona y quisieras describir cosas clave; tomemos como ejemplo a una persona concreta, Douglas Adams, y basémonos en esta descripción.
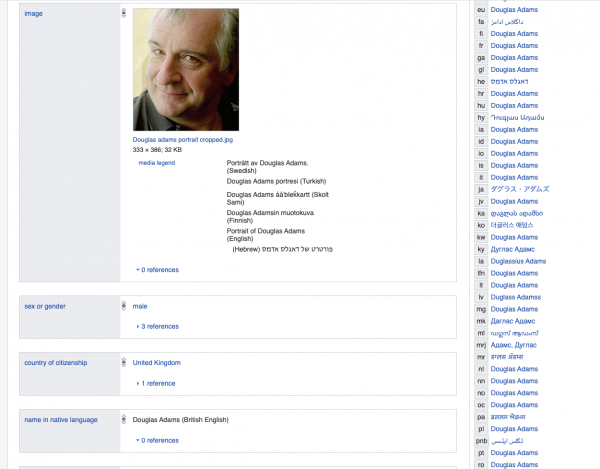
Si utilizáramos una base de datos relacional, tendríamos que crear una gran tabla o tablas con muchas columnas, la mayoría de las cuales serían NULL o llenas de algún valor predeterminado False; por ejemplo, seguramente muchos de nosotros no tenemos un registro en la biblioteca nacional de Corea. Por supuesto, podríamos sacarlas a tablas separadas, pero eso en última instancia sería un intento de modelar un esquema lógico flexible con predicados mediante relaciones fijas.
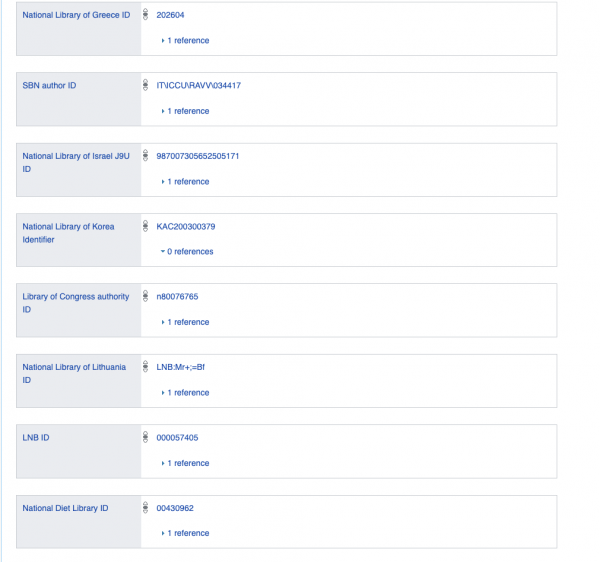
Por lo tanto, imagina que todos los datos se almacenan en forma de grafo o en expresiones lógicas binarias y unarias.
¿Dónde puedes encontrarte con esto? Primero, trabajando con , así como con cualquier base de datos gráfica o datos relacionados.
A continuación se presentan los principales lenguajes de consulta que he tenido que aplicar y con los que he trabajado.
SPARQL
Wiki:
SPARQL ( desde SPARQL Protocol and RDF Query Language) — , presentados en modelo , así como para transmitir estas consultas y respuestas. SPARQL es una recomendación del y una de las tecnologías de .
En realidad, es un lenguaje de consulta para predicados lógicos unarios y binarios. Simplemente se indica de manera condicional qué es fijo en la expresión lógica y qué no, de manera muy simplificada.
La propia base RDF (Marco de Descripción de Recursos), sobre la que se realizan las consultas SPARQL, es una tripleta objeto, predicado, sujeto — y la consulta selecciona las tripletas que cumplen con las restricciones especificadas en el sentido de: encontrar tal X, que p_55(X, q_33) sea cierto; donde, por supuesto, p_55 es alguna relación con ID 55 y q_33 es el objeto con ID 33 (y eso es todo, nuevamente omitiendo todo tipo de detalles).
Ejemplo de representación de datos:
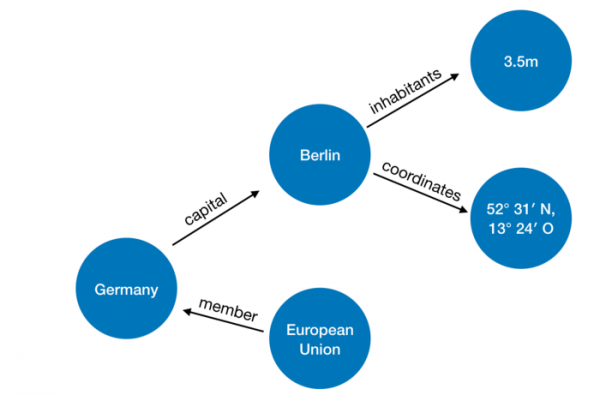
Imágenes y un ejemplo con países aquí .
Ejemplo de una consulta básica
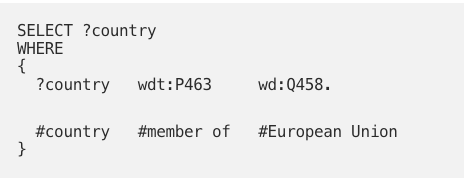
De hecho, queremos encontrar el valor de la variable ?country, tal que para el predicado
member_of, sea cierto que member_of(?country,q458), y q458 es el ID de la Unión Europea.
Ejemplo de una consulta SPARQL real dentro del motor python:
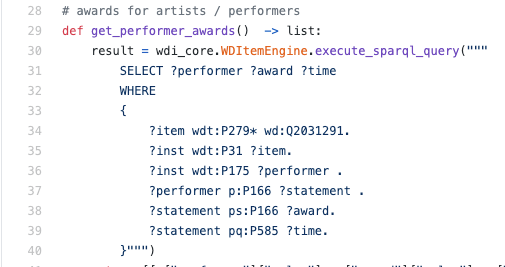
Por lo general, solía leer SPARQL en lugar de escribir; en esta situación, probablemente será útil comprender el lenguaje al menos a un nivel básico para entender cómo exactamente se extraen los datos.
Hay muchos materiales en línea para estudiar: por ejemplo, aquí y . Normalmente busco en Google construcciones y ejemplos específicos y por ahora es suficiente.
Lenguajes de consulta lógicos
Puedes leer más sobre el tema en mi artículo . Aquí, solo vamos a examinar brevemente por qué los lenguajes lógicos son muy adecuados para escribir consultas. En esencia, RDF es simplemente un conjunto de declaraciones lógicas del tipo p(X) y h(X,Y), mientras que una consulta lógica tiene la siguiente forma:
output(X) :- country(X), member_of(X,"EU").
Aquí estamos hablando de la creación de un nuevo predicado output/1 (el /1 significa que es unario), bajo la condición de que para X se cumpla que country(X) — es decir, X es un país y también member_of(X, "EU").
Esto significa que tanto los datos como las reglas en este caso están representados de la misma manera, lo que permite modelar tareas de manera muy fácil y eficaz.
Dónde se ha encontrado en la industria: un gran proyecto con una empresa que escribe consultas en este lenguaje, así como en el proyecto actual en el núcleo del sistema — parece ser algo bastante exótico, pero a veces se encuentra.
Ejemplo de un fragmento de código en un lenguaje lógico que procesa wikidata:
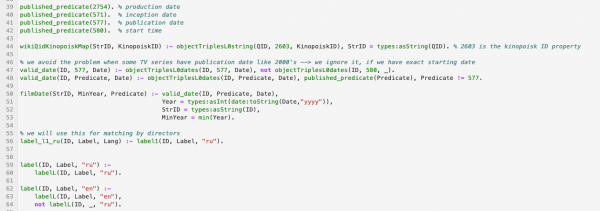
Materiales: aquí daré un par de enlaces al moderno lenguaje de programación lógico Answer Set Programming — recomiendo estudiar precisamente este:
Fuente: habr.com
