

En mi trabajo, a menudo me encuentro con nuevas soluciones técnicas o productos de software, sobre los cuales hay bastante poca información en Internet en ruso. Con este artículo, intentaré llenar uno de esos vacíos con un ejemplo de mi reciente práctica, cuando fue necesario configurar el envío de eventos CDC desde dos sistemas de bases de datos populares (PostgreSQL y MongoDB) a un clúster de Kafka mediante Debezium. Espero que este artículo de revisión, que surge a raíz del trabajo realizado, resulte útil también para otros.
¿Qué es Debezium y, en general, CDC?
es un representante de la categoría de software CDC (), y más concretamente, es un conjunto de conectores para diversas bases de datos compatibles con el marco de trabajo Apache Kafka Connect.
Es que utiliza la licencia Apache License v2.0 y es patrocinado por la compañía Red Hat. El desarrollo comenzó en 2016 y, hasta el momento, cuenta con soporte oficial para las siguientes bases de datos: MySQL, PostgreSQL, MongoDB y SQL Server. También hay conectores para Cassandra y Oracle, pero actualmente están en estado de 'acceso anticipado', y no se garantiza la compatibilidad hacia atrás en las nuevas versiones.
Si se compara CDC con el enfoque tradicional (donde la aplicación lee datos directamente de la base de datos), sus principales ventajas son la implementación del streaming de cambios de datos a nivel de filas con baja latencia, alta fiabilidad y disponibilidad. Estos dos últimos puntos se logran utilizando un clúster de Kafka como almacenamiento de eventos CDC.
También se puede mencionar como una ventaja el hecho de que se utiliza un modelo único para almacenar eventos, por lo que la aplicación final no tendrá que preocuparse por los matices del uso de diferentes bases de datos.
Finalmente, gracias al uso de un corredor de mensajes, se abre un campo para la escalabilidad horizontal de las aplicaciones que supervisan los cambios en los datos. Al mismo tiempo, el impacto en la fuente de datos se minimiza, ya que la obtención de datos no se realiza directamente de la base de datos, sino desde el clúster de Kafka.
Sobre la arquitectura de Debezium
El uso de Debezium se resume en un esquema tan sencillo como este:
Base de datos (como fuente de datos) → conector en Kafka Connect → Apache Kafka → consumidor
Como ilustración, presento el esquema del sitio del proyecto:
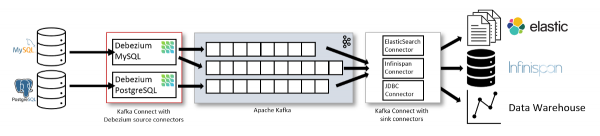
Sin embargo, no me gusta mucho este esquema, ya que da la impresión de que solo es posible usar un conector de sink.
En realidad, la situación es diferente: la infraestructura de su Data Lake (el último eslabón en el esquema anterior) — no es la única manera de aplicar Debezium. Los eventos enviados a Apache Kafka pueden ser utilizados por sus aplicaciones para abordar diversas situaciones. Por ejemplo:
- eliminación de datos obsoletos de la caché;
- envío de notificaciones;
- actualizaciones de índices de búsqueda;
- una especie de registros de auditoría;
- …
Si tiene una aplicación en Java y no tiene la necesidad/oportunidad de usar un clúster Kafka, también existe la opción de trabajar a través del . La ventaja obvia es que puede prescindir de infraestructura adicional (en forma de conector y Kafka). Sin embargo, esta solución se declaró obsoleta (deprecated) a partir de la versión 1.1 y ya no se recomienda su uso (en las futuras versiones su soporte podría ser eliminado).
En este artículo se discutirá la arquitectura recomendada por los desarrolladores, que garantiza la resiliencia y la capacidad de escalado.
Configuración del conector
Para comenzar a rastrear los cambios en la principal riqueza — los datos — necesitaremos:
- una fuente de datos, que puede ser MySQL a partir de la versión 5.7, PostgreSQL 9.6+, MongoDB 3.2+ ();
- clúster de Apache Kafka;
- instancia de Kafka Connect (versiones 1.x, 2.x);
- conector Debezium configurado.
El trabajo de los dos primeros puntos, es decir, el proceso de instalación de la base de datos y Apache Kafka, queda fuera del alcance del artículo. Sin embargo, para aquellos que desean implementar todo en un entorno de sandbox, en el repositorio oficial de ejemplos hay un .
Nos detendremos en detalle en los dos últimos puntos.
0. Kafka Connect
Aquí y en adelante en el artículo, todos los ejemplos de configuración se consideran en el contexto de la imagen de Docker distribuida por los desarrolladores de Debezium. Contiene todos los archivos de plugins necesarios (conectores) y permite la configuración de Kafka Connect mediante variables de entorno.
Si se prevé utilizar Kafka Connect de Confluent, será necesario agregar manualmente los plugins de los conectores requeridos en el directorio especificado en plugin.path o definido a través de la variable de entorno CLASSPATH. La configuración del worker de Kafka Connect y los conectores se determina a través de archivos de configuración, que se pasan como argumentos al comando de inicio del worker. Más detalles en. .
Todo el proceso de configuración de Debezium con conector se lleva a cabo en dos etapas. Veamos cada una de ellas:
1. Configuración del marco de trabajo Kafka Connect
Para la transmisión de datos en un clúster Apache Kafka, se deben especificar parámetros específicos en el marco de trabajo Kafka Connect, tales como:
- parámetros de conexión al clúster,
- nombres de los tópicos donde se almacenará la configuración del conector,
- nombre del grupo en el que se ejecuta el conector (en caso de usar modo distribuido).
La imagen oficial de Docker del proyecto admite la configuración mediante variables de entorno, y eso es lo que utilizaremos. Entonces, descargamos la imagen:
docker pull debezium/connectEl conjunto mínimo de variables de entorno necesarias para ejecutar el conector es el siguiente:
-
BOOTSTRAP_SERVERS=kafka-1:9092,kafka-2:9092,kafka-3:9092— lista inicial de servidores del clúster Kafka para obtener la lista completa de miembros del clúster; -
OFFSET_STORAGE_TOPIC=connector-offsets— tópico para almacenar las posiciones actuales del conector; -
CONNECT_STATUS_STORAGE_TOPIC=connector-status— tópico para almacenar el estado del conector y sus tareas; -
CONFIG_STORAGE_TOPIC=connector-config— tópico para almacenar los datos de configuración del conector y sus tareas; -
GROUP_ID=1— identificador del grupo de trabajadores en el que puede ejecutarse la tarea del conector; necesario al usar modo distribuido (distributed) modo.
Iniciamos el contenedor con estas variables:
docker run
  -e BOOTSTRAP_SERVERS='kafka-1:9092,kafka-2:9092,kafka-3:9092'
  -e GROUP_ID=1
  -e CONFIG_STORAGE_TOPIC=my_connect_configs
  -e OFFSET_STORAGE_TOPIC=my_connect_offsets
  -e STATUS_STORAGE_TOPIC=my_connect_statuses  debezium/connect:1.2
Nota sobre Avro
Por defecto, Debezium escribe datos en formato JSON, lo cual es aceptable para entornos de desarrollo y volúmenes de datos pequeños, pero puede convertirse en un problema en bases de datos de alto rendimiento. Una alternativa al convertidor JSON es la serialización de mensajes usando en formato binario, lo que ayuda a reducir la carga en el subsistema de I/O en Apache Kafka.
Para utilizar Avro, es necesario implementar un (para almacenar esquemas). Las variables para el convertidor se verán de la siguiente manera:
name: CONNECT_VALUE_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: CONNECT_KEY_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: VALUE_CONVERTER
value: io.confluent.connect.avro.AvroConverter
Los detalles sobre el uso de Avro y la configuración del registro se salen del alcance de este artículo; a continuación, para mayor claridad, usaremos JSON.
2. Configuración del conector
Ahora podemos pasar directamente a la configuración del conector, que leerá datos de la fuente.
Consideraremos, como ejemplo, los conectores para dos bases de datos: PostgreSQL y MongoDB, sobre las cuales tengo experiencia y hay diferencias (aunque sean pequeñas, ¡en algunos casos son significativas!).
La configuración se describe en la notación JSON y se carga en Kafka Connect mediante una solicitud POST.
2.1. PostgreSQL
Ejemplo de configuración del conector para PostgreSQL:
{
  "name": "pg-connector",
  "config": {
    "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
    "plugin.name": "pgoutput",
    "database.hostname": "127.0.0.1",
    "database.port": "5432",
    "database.user": "debezium",
    "database.password": "definitelynotpassword",
    "database.dbname" : "dbname",
    "database.server.name": "pg-dev",
    "table.include.list": "public.(.*)",
    "heartbeat.interval.ms": "5000",
    "slot.name": "dbname_debezium",
    "publication.name": "dbname_publication",
    "transforms": "AddPrefix",
    "transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
    "transforms.AddPrefix.regex": "pg-dev.public.(.*)",
    "transforms.AddPrefix.replacement": "data.cdc.dbname"
  }
}
El principio de funcionamiento del conector después de esta configuración es bastante simple:
- Al iniciar por primera vez, se conecta a la base de datos especificada en la configuración y se ejecuta en modo instantánea inicial, enviando a Kafka un conjunto inicial de datos obtenidos con el comando
SELECT * FROM table_name. - Una vez que se completa la inicialización, el conector cambia al modo de lectura de cambios desde los archivos WAL de PostgreSQL.
Sobre las opciones utilizadas:
-
name— nombre del conector, para el cual se usa la configuración que se describe a continuación; este nombre se utiliza posteriormente para interactuar con el conector (es decir, revisar el estado/reiniciar/actualizar la configuración) a través de la API REST de Kafka Connect; -
connector.class— clase del conector de la base de datos, que será utilizada por el conector configurable; -
plugin.name— nombre del plugin para la decodificación lógica de datos desde los archivos WAL. Las opciones disponibles sonwal2json,decoderbuffsypgoutput. Los dos primeros requieren la instalación de las extensiones correspondientes en la base de datos, ypgoutputpara PostgreSQL versión 10 y superior no requieren manipulaciones adicionales; -
database.*— opciones para conectarse a la base de datos, dondedatabase.server.name— nombre de la instancia de PostgreSQL, utilizado para formar el nombre del tema en el clúster de Kafka; -
table.include.list— lista de tablas de las que queremos rastrear los cambios; se especifica en el formatoschema.table_name; no se puede usar junto contable.exclude.list; -
heartbeat.interval.ms— intervalo (en milisegundos) con el que el conector envía mensajes heartbeat a un tema especial; -
heartbeat.action.query— consulta que se ejecutará al enviar cada mensaje heartbeat (esta opción apareció a partir de la versión 1.1); -
slot.name— nombre del slot de replicación que utilizará el conector; publication.name— nombre en PostgreSQL que utiliza el conector. Si no existe, Debezium intentará crearla. Si el usuario que se conecta no tiene suficientes permisos para esta acción, el conector finalizará con un error;-
transformsdefine cómo se modificará el nombre del tema objetivo:-
transforms.AddPrefix.typeindica que utilizaremos expresiones regulares; -
transforms.AddPrefix.regex— máscara por la cual se redefine el nombre del tema objetivo; -
transforms.AddPrefix.replacement— lo que realmente estamos redefiniendo.
-
Más sobre heartbeat y transforms
Por defecto, el conector envía datos a Kafka por cada transacción confirmada y su LSN (Log Sequence Number) se registra en un tema de servicio offset. Pero, ¿qué ocurrirá si el conector está configurado para leer solo una parte de sus tablas (donde la actualización de datos no se produce con frecuencia)?
- El conector leerá archivos WAL y no encontrará en ellos confirmaciones de transacciones en las tablas que está monitoreando.
- Por lo tanto, no actualizará su posición actual ni en el tema ni en el slot de replicación.
- Esto, a su vez, llevará a la «retención» de archivos WAL en el disco y a la posible falta de espacio en disco.
Y aquí es donde entran en juego las opciones heartbeat.interval.ms y heartbeat.action.query. Usar estas opciones en conjunto permite que cada vez que se envía un mensaje heartbeat se ejecute una consulta para modificar datos en una tabla separada. Así, se actualiza constantemente el LSN en el que se encuentra actualmente el conector (en el slot de replicación). Esto permite que la base de datos elimine los archivos WAL que ya no son necesarios. Puedes aprender más sobre el funcionamiento de las opciones en .
Otra opción que merece más atención es transforms. Aunque es más sobre comodidad y estética...
Por defecto, Debezium crea temas siguiendo la siguiente política de nomenclatura: serverName.schemaName.tableName. Esto no siempre puede ser conveniente. Las opciones transforms se pueden utilizar expresiones regulares para definir la lista de tablas cuyos eventos deben ser enrutados a un tema con un nombre específico.
En nuestra configuración, gracias a Al final de la descripción de la configuración del conector para PostgreSQL, es importante mencionar las siguientes características/restricciones de su funcionamiento: Entonces, carguemos nuestra configuración en el conector: Verificamos que la carga se realizó correctamente y que el conector se ha iniciado: Genial: está configurado y listo para trabajar. Ahora actuemos como consumidores y conectémonos a Kafka, después añadiremos y modificamos un registro en la tabla: En nuestro tema se reflejará de la siguiente manera: JSON muy extenso con nuestros cambios En ambos casos, los registros constan de la clave (PK) del registro que se ha modificado y del contenido mismo de los cambios: cómo era el registro antes y cómo es después. Este conector utiliza el mecanismo estándar de replicación de MongoDB, leyendo información del oplog del nodo primario de la base de datos. De manera similar al conector ya descrito para PgSQL, aquí también, al iniciar por primera vez se toma la instantánea primaria de los datos, después de lo cual el conector cambia al modo de lectura del oplog. Ejemplo de configuración: Como se puede notar, aquí no hay nuevas opciones en comparación con el ejemplo anterior, pero se ha reducido solo el número de opciones relacionadas con la conexión a la base de datos y sus prefijos. Configuraciones La cuestión de la resistencia a fallos y alta disponibilidad en nuestros días es más crítica que nunca, especialmente cuando hablamos de datos y transacciones, y el seguimiento de los cambios en los datos no se queda al margen. Consideremos qué puede salir mal en principio y qué le sucederá a Debezium en cada caso. Hay tres opciones de fallo: Sin embargo, hay excepciones. Si el conector ha estado inactivo durante un tiempo prolongado (o no ha podido comunicarse con la instancia de MongoDB), y el oplog ha sido rotado durante ese tiempo, al restablecer la conexión el conector comenzará a leer los datos desde la primera posición disponible, lo que hará que parte de los datos en Kafka no se pierda. Debezium es mi primera experiencia con sistemas CDC y en general ha sido positiva. El proyecto se destaca por el soporte de las principales bases de datos, la facilidad de configuración, el soporte de la clustering y una comunidad activa. Recomiendo a los interesados en la práctica que revisen las guías para y . En comparación con el conector JDBC para Kafka Connect, la principal ventaja de Debezium es que los cambios se leen de los registros de la base de datos, lo que permite obtener datos con una latencia mínima. El conector JDBC (que viene con Kafka Connect) realiza consultas a la tabla monitoreada a intervalos fijos y (por esta razón) no genera mensajes al eliminar datos (¿cómo se pueden solicitar datos que no existen?). Para abordar tareas similares, se pueden considerar las siguientes soluciones (además de Debezium): También puedes leer en nuestro blog: Fuente: habr.comtransforms sucede lo siguiente: todos los eventos CDC de la base de datos monitoreada serán enviados al tema llamado data.cdc.dbname. De lo contrario (sin estas configuraciones), Debezium por defecto crearía un tema para cada tabla del tipo: pg-dev.public..
Restricciones del conector
Aplicación de la configuración
curl -i -X POST -H "Accept:application/json"
-H "Content-Type:application/json" http://localhost:8083/connectors/
-d @pg-con.json$ curl -i http://localhost:8083/connectors/pg-connector/status
HTTP/1.1 200 OK
Date: Thu, 17 Sep 2020 20:19:40 GMT
Content-Type: application/json
Content-Length: 175
Server: Jetty(9.4.20.v20190813)
{"name":"pg-connector","connector":{"state":"RUNNING","worker_id":"172.24.0.5:8083"},"tasks":[{"id":0,"state":"RUNNING","worker_id":"172.24.0.5:8083"}],"type":"source"}$ kafka/bin/kafka-console-consumer.sh
--bootstrap-server kafka:9092
--from-beginning
--property print.key=true
--topic data.cdc.dbname
postgres=# insert into customers (id, first_name, last_name, email) values (1005, 'foo', 'bar', 'foo@bar.com');
INSERT 0 1
postgres=# update customers set first_name = 'egg' where id = 1005;
UPDATE 1{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":null,
"after":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600374991648,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":602,
"lsn":34088472,
"xmin":null
},
"op":"c",
"ts_ms":1600374991762,
"transaction":null
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"after":{
"id":1005,
"first_name":"egg",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600375609365,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":603,
"lsn":34089688,
"xmin":null
},
"op":"u",
"ts_ms":1600375609778,
"transaction":null
}
}
INSERTAR: el valor anterior (before) es igual a null, y después es la cadena que se ha insertado. ACTUALIZAR: en payload.before muestra el estado anterior de la fila, y en payload.after — el nuevo con el contenido de los cambios.2.2 MongoDB
{
"name": "mp-k8s-mongo-connector",
"config": {
"connector.class": "io.debezium.connector.mongodb.MongoDbConnector",
"tasks.max": "1",
"mongodb.hosts": "MainRepSet/mongo:27017",
"mongodb.name": "mongo",
"mongodb.user": "debezium",
"mongodb.password": "dbname",
"database.whitelist": "db_1,db_2",
"transforms": "AddPrefix",
"transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
"transforms.AddPrefix.regex": "mongo.([a-zA-Z_0-9]*).([a-zA-Z_0-9]*)",
"transforms.AddPrefix.replacement": "data.cdc.mongo_$1"
}
}transforms en esta ocasión hacen lo siguiente: convierten el nombre del tema objetivo de la siguiente manera <server_name>.<db_name>.<collection_name> en data.cdc.mongo_<db_name>.Tolerancia a fallos
Conclusión
P.D.
