

En Hemos compartido con ustedes las nuevas características de la actualización 4 lanzada en enero para Veeam Backup & Replication 9.5 (VBR), donde intencionalmente no mencionamos las copias de seguridad en cinta magnética. Hablar sobre este tema merece un artículo aparte, porque realmente hubo muchas novedades.
– ¿Chicos de QA, escribirán un artículo?
– ¿Por qué no!
Almacenamiento en cinta en el siglo XXI
El almacenamiento de datos en cintas magnéticas (cartuchos, “tapes”, como les llamamos en I+D) no se limita a la computadora ZX-Spectrum del pasado, cuyo juego podía cargarse en la memoria RAM de 48 kb desde durante varios minutos. En un cuarto de siglo, las velocidades y capacidades de las cintas han aumentado en 6-7 órdenes de magnitud. Esta no es una comparación del todo precisa, y según estándar no se mantiene al ritmo. Sin embargo, las tecnologías modernas permiten grabar 12 terabytes de datos en una cinta de un kilómetro (hasta 30 terabytes en modo de compresión), por lo tanto, un dispositivo de 160 dólares deja atrás a la competencia en costo de almacenamiento a largo plazo de grandes volúmenes de datos, incluso considerando las inversiones en equipos de lectura/escritura. Los datos en estas cintas se pueden almacenar de forma segura durante 15-30 años.
Miremos desde otra perspectiva. En tiempos recientes, han alcanzado un nuevo nivel. Pueden esperar su momento dentro de la infraestructura de una gran empresa durante semanas o meses, y con la aparición de una nueva vulnerabilidad de día cero, pueden destruir (no sin la ayuda de una persona, ya que hay grandes sumas de dinero en juego) no solo todos los datos, sino también todas las copias de seguridad a las que puedan acceder. Aquí hay , cuando una empresa tuvo que pagar a los extorsionistas. Los llamados air gap, es decir, copias de seguridad físicamente aisladas de la infraestructura, se han convertido, en esencia, en el único salvavidas confiable contra tales historias. La cinta magnética aquí es una de las soluciones que no se vuelven obsoletas.
Pero solo con especificaciones y novedades tecnológicas en componentes de hierro y bario-ferrito de los principales fabricantes (IBM, HPE, Oracle, Dell) no es suficiente para proteger los datos de manera confiable; también se necesita buen software. En Veeam, tenemos todo un equipo dedicado a las copias de seguridad en cinta, alrededor de 10 personas analizan, planifican, investigan, desarrollan y prueban a diario. Los resultados de este trabajo los han visto en artículos anteriores (, ). ¿Qué se ha logrado en el último año?
Glosario
Surge la elección entre libertades con respecto al idioma nativo y los formalismos que dificultan la lectura. Prefiero lo primero, por lo que me disculpo de antemano si algunas jerga de la lista a continuación resultan incómodas a la vista. Aquí, recordaré brevemente qué significa cada término.
Los expertos en VBR pueden saltarse esta parteJob – job – tarea de copia de seguridad. En esencia, todo VBR se basa en jobs. Además de la copia de seguridad y la replicación, esto puede ser también la copia a cinta magnética (backup to tape job, tape job). Cabe mencionar que la restauración desde una copia de seguridad (restore) también es un job, pero en este artículo, se entenderá por este término específicamente la copia de seguridad.
Storage – storage – un nombre que ha perdurado históricamente. Son archivos en el repositorio (repository – repositorio), que contienen copias de seguridad – operaciones y incrementales. En un storage puede haber tanto una como varias máquinas virtuales.
Cadena – chain – secuencia de storages relacionados entre sí. Para restaurar datos de un determinado storage incremental n, se requieren todos los anteriores desde (n-1) hasta 1 y el storage completo al que se refiere el primer incremental.
Source, Target – source, target. Source es la entidad original que procesa el job. En el caso de copias de seguridad/replicas, generalmente es una máquina virtual en el hipervisor. En el caso de tape job, el source es el propio job de copia de seguridad (o los archivos en el caso de un file to tape job). Target para el job de copia de seguridad es el repositorio donde se almacenan las copias de seguridad. Para el tape job, es el media pool.
Media pool – – grupo de medios, en nuestro caso – cintas. Contenedor lógico, creado por el usuario y que contiene cintas de una o varias bibliotecas. Así, un tape job siempre tiene un media pool como target, es decir, los datos no se escriben en una cinta específica ni en cualquier cinta de la biblioteca, sino en un conjunto determinado de ellas. El media pool tiene una configuración de tiempo de retención de datos, después de la cual la cinta puede ser sobrescrita. El usuario puede crear pools estándar (standard) y . Cada uno de estos tipos ahora puede ser WORM y no-WORM, sobre esto a continuación.
Media set – – un conjunto de cintas en un pool de medios, en las que se escriben continuamente copias de seguridad/archivos. Para los pools GFS, los conjuntos de medios también están vinculados a un intervalo (por ejemplo, anual – yearly), las cintas solo se rotan dentro de su intervalo.
– elementos de la biblioteca de cintas. La unidad lee y rebobina la cinta, el cambiador – es un robot que mueve las cintas entre los slots de almacenamiento, slots de descarga y la unidad. También hay unidades independientes (standalone – independiente), aquí la función de cambiador la realiza una persona. Para la unidad es obligatorio tener instalado el controlador correcto del fabricante en una máquina Windows, a la que está conectada la biblioteca; con el cambiador podemos trabajar incluso sin controladores, utilizando SCSI nativo.
Inquilino a cinta. Proveedor protegido – clientes protegidos
Pongamos las cartas sobre la mesa. La característica más significativa de nuestra actualización, diseñada para , que utilizan VBR en su infraestructura. El desarrollo comenzó hace dos años. Pronto nos dimos cuenta de que no podríamos abordar una tarea tan seria para la próxima versión, tomamos una pequeña pausa y finalmente lanzamos la función en la actualización 9.5 Update 4.
En resumen, ahora los proveedores tienen la posibilidad de copiar las copias de seguridad de sus clientes en cintas mediante trabajos de cinta en pool GFS. Esto les da a los proveedores – que son clientes grandes y muy valiosos para nuestro corazón y departamento comercial – dos posibilidades:
- proteger a sus clientes (inquilinos, inquilino – arrendatario) de la pérdida de datos debido a eliminaciones accidentales o problemas de infraestructura ("inundación en el servidor");
- ofrecer a los inquilinos un servicio adicional para restaurar datos a partir de una copia de seguridad antigua, que ya ha sido eliminada del repositorio en la nube según la política de retención de datos, pero que todavía permanece en las cintas.
Desde el punto de vista del marketing, la funcionalidad es muy "sabrosa", desde el nuestro – no menos complicada de implementar.
Desarrollo
El principal problema que surgió fue el cifrado de datos. La mayoría de las copias de seguridad en la nube están cifradas; la estadística indica que ⅔ del total. Para nosotros, esta cifra fue una sorpresa, pensábamos que casi todo estaba cifrado, pero no – muchos clientes, al parecer, confían ciegamente en sus proveedores.
La parábola es sencilla: el proveedor no debe ser capaz de descifrar los datos de sus inquilinos. Aun así, en el marco de una nueva función, es necesario abrir los almacenamientos con copias de seguridad desde el lado del proveedor. Esto se hace para poder transferir bloques de datos, por ejemplo, para crear . Lo principal es que esto debe hacerse independientemente del inquilino, cuando las claves necesarias no se transmiten al proveedor durante la ejecución del trabajo.
La solución a este problema, que se utiliza, por cierto, en otra característica muy importante de la actualización reciente – – consiste en añadir una clave de cifrado adicional. La clave de archivo (Archive key) se almacena en la base del proveedor de forma cifrada. A través de un ingenioso esquema, en el lado del proveedor se puede abrir el almacenamiento, mover y volver a cifrar bloques de datos entre almacenamientos (pues cada uno tiene su propia clave), pero no se pueden descifrar los propios datos.
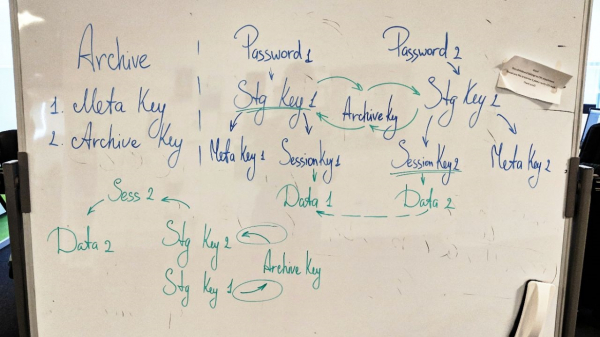
Esquema ingenioso (opción de trabajo)
Agrego que todos los ingenieros en I+D aman el cifrado en nuestro producto, aunque nadie sabe en todos los detalles cómo funciona. (Aquí había una broma sobre «y por qué funciona en absoluto», pero los editores no la dejaron pasar.)
Pruebas
Se registraron cientos de errores en la característica. Las áreas más complejas son el cifrado, la interfaz de usuario y los problemas durante la restauración.
Desde el punto de vista de las pruebas, la dificultad radicaba en la gran variabilidad, la «combinatoria» de tipos y clases de trabajos inquilinos y repositorios – me refiero tanto a la fuente como al objetivo al restaurar las copias de seguridad en la infraestructura. Todo esto se entrelaza con la lógica en el marco de (incluyendo el nuevo – paralelismo y conjuntos de medios diarios, de esto hablaré más adelante), y en general a una especificidad de nube no habitual para los tipos. No olviden agregar generosamente cifrado. Si continuamos con la metáfora, hemos comido bien de este plato – pero también lo hemos disfrutado por todos lados.
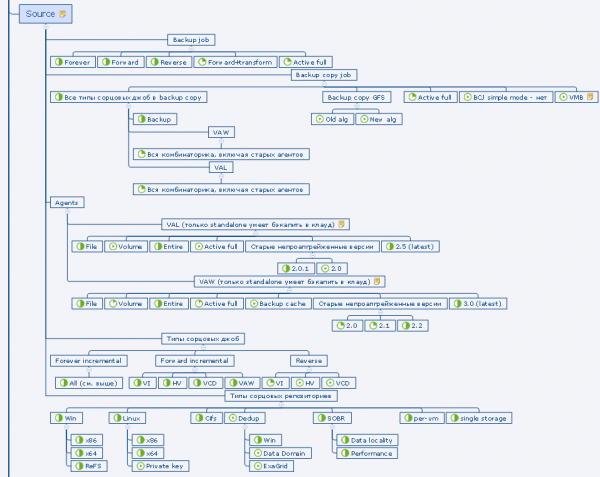
Fragmento del plan de pruebas
Como resultado
Una descripción detallada se puede encontrar en (por ahora en inglés): , . Me detendré en los aspectos principales.
Copia de seguridad
El proveedor agrega inquilinos a la tarea de tipo con un pool GFS como objetivo. Al tener una licencia en la nube, en el segundo paso del asistente se encuentra disponible la opción TenantsSe pueden agregar todos los inquilinos a la vez o individualmente, y se puede seleccionar solo una cuota específica (pero no una subcuota) de un inquilino específico. No se pueden mezclar copias de seguridad de inquilinos y copias de seguridad locales normales en un mismo trabajo.
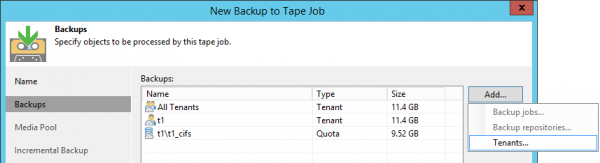
Las demás configuraciones son casi completamente idénticas a un trabajo normal en el grupo GFS.
La restauración de datos es posible tanto del lado del proveedor como del mismo inquilino.
Restauración del lado del proveedor
Se realiza a través de un nuevo asistente. Aquí ya se puede bajar a un trabajo específico, restaurándose toda la cadena que estaba en el repositorio en un día determinado.
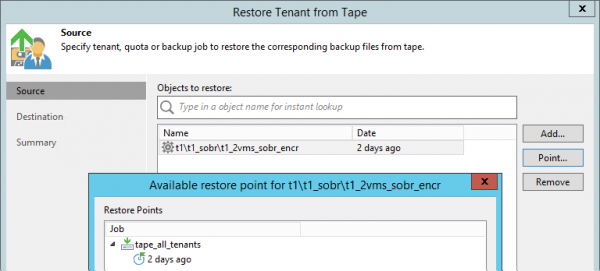
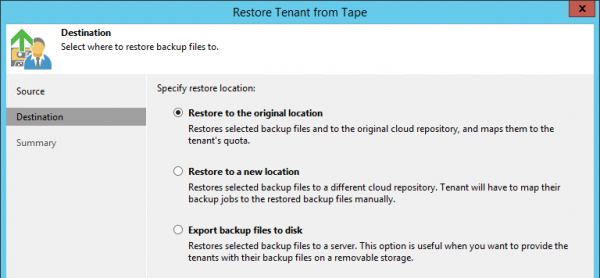
Hay tres opciones de restauración:
- A la ubicación original. En este caso, la copia de seguridad original, si existe, se elimina; los trabajos del inquilino se reconfiguran automáticamente a la cadena restaurada. Se supone que esta restauración será completamente indetectable para el cliente, solo estará desconectado del repositorio en la nube por un corto período.
- A una nueva cuota/repositorio. El proveedor puede, por ejemplo, crear para este propósito una cuenta temporal separada, que luego se eliminará. La copia de seguridad aparece en la infraestructura del inquilino después de sincronizarse con la base del proveedor.
- Simplemente en el disco de un servidor Linux o Windows, registrado en la infraestructura del proveedor. Luego, esta cadena se puede grabar en una memoria USB y enviarse al inquilino.
Restauración del lado del inquilino
Esta opción implica que el cliente tiene su propia infraestructura de cintas y un gran volumen de datos para restaurar. El proveedor puede enviar físicamente la cinta con las copias de seguridad grabadas al cliente por un servicio de entrega, quien la catalogará en su propio equipo, descifrará las cintas y las copias de seguridad y trabajará con las copias de seguridad como si él mismo las hubiera grabado en la cinta. Esta es una forma de evitar descargar terabytes a través de WAN.
Mejoras significativas en el grupo GFS
-los grupos de medios aparecieron en VBR hace dos años, en la versión 9.5. En la actualización reciente, tanto por la aparición de la función Tenant to tape como por las solicitudes de los usuarios, hemos mejorado significativamente esta funcionalidad.
Conjuntos de medios diarios
Ha aparecido un nuevo conjunto diario (diario) conjunto de medios. Ahora en el pool GFS se pueden almacenar copias de seguridad de cada día, no solo completas, sino también incrementales. Las últimas ocupan considerablemente menos espacio, y esto se ha hecho con el fin de ahorrar en cinta. Se supone que estas cintas están en constante rotación en la biblioteca y no se llevan a almacenamiento remoto. Para restaurar desde la copia incremental se necesitarán cintas de uno de los conjuntos de medios de nivel superior (semanal, mensual, trimestral o anual). No se puede activar el conjunto de medios diario sin activar el semanal, ya que en la mayoría de los casos, para la recuperación desde la copia incremental, se requieren específicamente las cintas semanales. Estas siempre están en la biblioteca o se almacenan en un almacén no tan remoto.
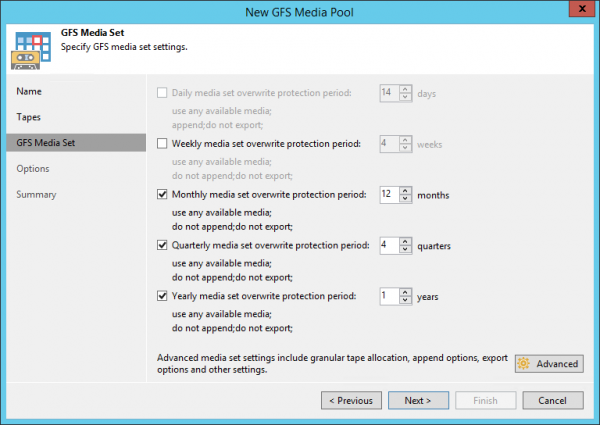
Lógica de operación de las jobs de cinta en el pool de medios GFS , los escritores técnicos no me dejarán mentir. En pocas palabras, omitiendo detalles, en los conjuntos de medios semanales y superiores solo se copian copias de seguridad completas (incluidas las copias de seguridad completas virtuales), una por cada fecha, mientras que en el diario se copian todas las copias de seguridad que están en el repositorio por el día actual, ya que la job de copia de seguridad puede iniciarse más de una vez al día.
Paralelismo, tiempo de inicio y espera en los pools GFS
Ahora es posible la escritura paralela de múltiples cadenas o jobs en varios drives de la biblioteca también en los pools de medios GFS (antes solo en los normales). Se activa en el paso Opciones del pool de medios.
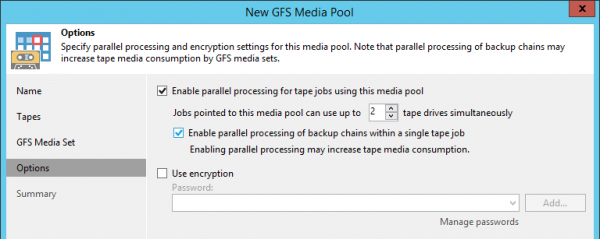
Aclaración importante: un mismo archivo siempre se escribe en un solo flujo, por lo que en caso de varias máquinas virtuales grandes se recomienda activar , para que la copia de seguridad consista en varias cadenas.
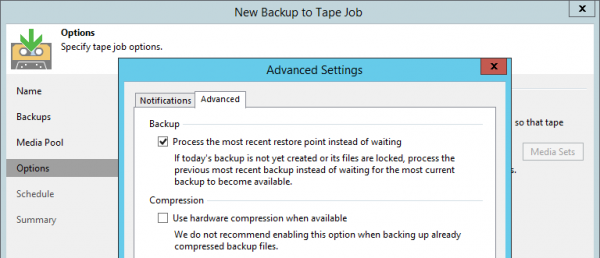
Además de esto, ahora es posible elegir el tiempo de inicio del job GFS en sí. A muchos usuarios no les gustaba el inicio a medianoche y la espera posterior de casi un día completo hasta que la job de source se complete. Ahora se puede programar, por ejemplo, para una tarde tardía, cuando ya hay algo que copiar en la cinta. Además, a petición de los usuarios, hemos trasladado a la configuración avanzada una opción que antes solo se podía activar mediante una clave del registro. Basta con seleccionar Procesar el punto de restauración más reciente en lugar de esperar Y en la cinta se copia lo que hay en el repositorio en el momento de inicio del trabajo de tape (punto del día de ayer, por ejemplo), no hay espera en absoluto.
Trabajo mejorado con múltiples bibliotecas
Se hablará de la situación en la que se ha añadido más de una biblioteca a un pool de medios. Ya lo hemos soportado antes, pero de vez en cuando recibíamos quejas de clientes sobre un comportamiento no del todo predecible.
Era
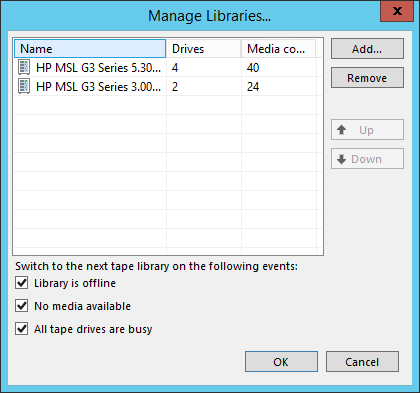
Por ejemplo, se inició un trabajo de tape que ocupó dos unidades en la primera biblioteca, pero la configuración de paralelismo le permite utilizar hasta 4 unidades simultáneamente. ¿Debería este trabajo cambiar a la segunda biblioteca del pool de medios y utilizarla también, o esto sería un desperdicio de recursos?
Otro caso. Se ha seleccionado la opción de cambiar bajo la condición 'sin cintas disponibles', en la primera biblioteca solo hay una cinta, pero potencialmente puede albergar todos los datos. Sin embargo, la configuración permite escribir en paralelo en dos cintas. ¿Debería en este caso involucrarse la segunda biblioteca?
Decidimos organizar esta área, permitiendo configurar el comportamiento de manera explícita.
Se volvió
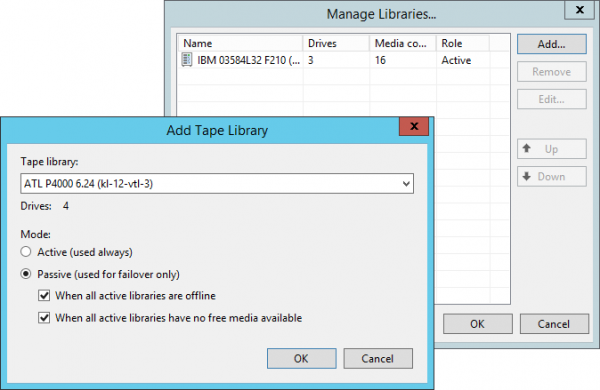
tienen roles – activa y pasiva. Y el propio pool de medios tiene dos modos: tolerante a fallos, o failover (failover) y grabación paralela (paralelismo). Ahora, según los requisitos, se puede configurar el pool de medios de diferentes maneras.
- Si tiene varias bibliotecas iguales y necesita paralelizar la grabación en ellas, active el modo de grabación paralela, para lo cual todas las bibliotecas deben tener roles activos. En este caso, las nuevas cintas y unidades se utilizarán de inmediato, tan pronto como surja la necesidad, independientemente de en qué biblioteca se encuentren. Aún hay prioridades: primero intentaremos encontrar recursos en la biblioteca situada más arriba en la lista.
- Si hay una biblioteca principal y una unidad antigua o un disco de reserva, active el modo de failover, colocando la biblioteca principal en la parte superior de la lista y eligiendo un rol pasivo para los dispositivos de reserva. La conmutación a tal dispositivo solo ocurrirá cuando sea realmente necesario, para que el trabajo funcione de alguna manera. Esta situación se considerará una falla, sobre la cual se enviará una notificación por correo electrónico.
Hay una situación más compleja que actualmente no soportamos: varias bibliotecas activas junto con pasivas. La retroalimentación mostrará si hay necesidad de tales configuraciones y si es necesario 'mejorar' la función en el futuro. Práctica estándar.
Soporte WORM
WORM – Write Once Read Many – cintas que no se pueden borrar ni reescribir , solo se pueden agregar datos. Su uso obligatorio está regulado por las reglas de algunas organizaciones, como las que operan en el ámbito médico. El principal problema con tales cintas antes era que VBR durante o grababa un encabezado que luego no se podía eliminar, y los trabajos de cinta fallaban con un error al intentar hacerlo.
En 9.5 Update 4 se implementó un soporte completo para estas cintas. Se añadieron grupos de medios WORM, normales y GFS, donde solo se pueden colocar cintas de este tipo.
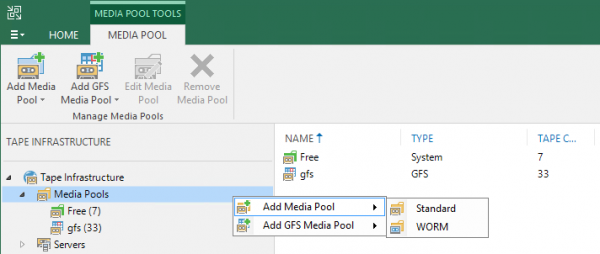
Las nuevas cintas tienen un ícono azul, 'congelado'. Desde el punto de vista del usuario, trabajar con cintas WORM no se diferencia de trabajar con cintas normales.
La 'WORMidad' de las cintas se determina inicialmente por el sufijo , si el código de barras que tienen es normal o ilegible, la información la proporciona el controlador al insertar la cinta por primera vez. No se podrá colocar cintas WORM en un grupo de medios normal y escribir en ellas. Curiosamente, ya se han encontrado usuarios que pegaron códigos de barras WORM en cintas normales y se sorprendieron por los cambios en su infraestructura después de la actualización.
Chip de la cinta
Al mismo tiempo que se implementaban cintas no regrabables, comenzamos a trabajar con . Los atributos estándar en el chip antes no se utilizaban, ahora escribimos y leemos en algunos de ellos, pero no los percibimos como la fuente principal de datos. La principal referencia sigue siendo el encabezado de la cinta. Esta decisión resultó ser correcta: un mes después del lanzamiento, observamos cómo el 'zoológico' de hardware de los usuarios sorprende en términos de trabajo con el chip.
Respaldo de volúmenes NDMP en cinta
En conclusión, sobre la característica más solicitada en términos de comentarios de esta actualización. Ahora está disponible el respaldo de volúmenes NDMP en cintas. En la infraestructura de VBR es necesario , después de lo cual en el trabajo de cinta de archivos se podrá seleccionar volúmenes de este host. Se almacenan en cintas en forma de archivos con un atributo especial para diferenciarlos de los normales al catalogar.
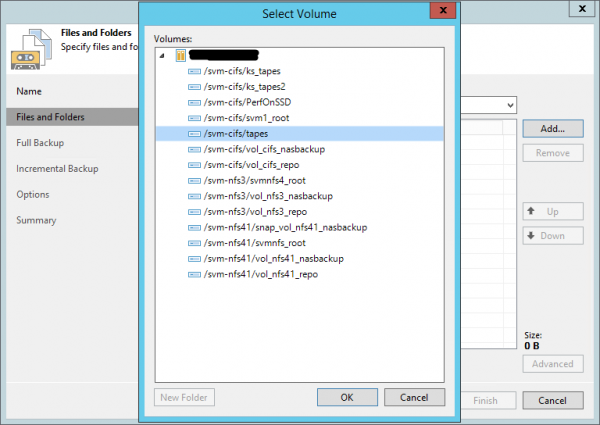
En la primera implementación hay ciertas limitaciones: no se admiten extensiones, además la copia de seguridad y la restauración solo son posibles para el volumen completo, no para archivos individuales. La copia de seguridad se realiza a través de (en el caso de NetApp – ), aquí hay algunas particularidades: el número máximo de puntos incrementales es 9, después de lo cual se fuerza una copia de seguridad completa.
En conclusión
Estas fueron solo las principales innovaciones en el ámbito de las copias de seguridad en cintas magnéticas en VBR 9.5 Update 4. Otras modificaciones se listan a continuación:
- possibilidad de establecer el orden de trabajos de origen y archivos en los trabajos de cinta;
- se ha añadido el rol de Operador de Cinta (el usuario puede hacer todo menos la restauración de la cinta – eso lo puede hacer el Operador de Restauración);
- se han añadido máscaras completas de inclusión/exclusión en el trabajo de cinta de archivos (excepto NDMP);
- se ha mejorado la recuperación en el trabajo de cinta de archivos (la carpeta se recupera con los archivos que estaban allí en el momento de la copia de seguridad, no con todos los que han estado allí a lo largo de toda su historia de copias de seguridad – una característica muy demandada, por cierto);
- se ha incrementado la velocidad de recuperación de un gran número de archivos desde cintas;
- se ha mejorado el algoritmo para seleccionar la próxima cinta para grabar, en particular, con igualdad de condiciones se tiene en cuenta el volumen de datos grabados/leídos a lo largo de su vida, tomando la más reciente;
- se ha mejorado la estabilidad del producto.
Enlaces útiles
Para variar, comparto algunos enlaces a recursos en ruso:
- Y regresamos al lugar anterior, videos informativos 'Cómo funciona esto' (aunque, por ahora, en inglés) – se puede ver . Se habla de cintas en las diapositivas 95 – 102.
Fuente: habr.com
