

En 2010, la empresa tenía 50 servidores y un modelo de red simple: backend, frontend y firewall. El número de servidores creció, el modelo se complicó: staging, VLANs aisladas con ACL, luego VPN con VRF, VLAN con ACL en L2, VRF con ACL en L3. ¿Te estás mareando? Lo que viene será más entretenido.
Cuando el número de servidores llegó a 16,000, trabajar sin lágrimas con tanta cantidad de segmentos heterogéneos se volvió imposible. Por eso, se ideó otra solución. Se utilizó la pila Netfilter, se añadió Consul como fuente de datos, y se obtuvo un firewall distribuido rápido. Se reemplazaron las ACL en los routers y se utilizó como firewall externo e interno. Para la gestión dinámica de la herramienta, se desarrolló el sistema BEFW, que se aplicó en todas partes: desde la gestión del acceso de usuarios a la red de producción hasta la aislamiento de segmentos de red entre sí.
Cómo funciona todo esto y por qué deberías considerar este sistema, lo contará Iván Agarvok () — líder del grupo de seguridad de infraestructura del departamento de Mantenimiento en el centro de desarrollo de Minsk de la empresa. Iván es un fanático de SELinux, le gusta Perl y escribe código. Como jefe del grupo de seguridad, trabaja regularmente con logs, backups y I+D para proteger a Wargaming de hackers y asegurar que todos los servidores de juego de la empresa funcionen correctamente.
Nota histórica
Antes de contar cómo lo hicimos, explicaré cómo llegamos a esto y por qué era necesario. Para ello, retrocedamos 9 años: 2010, cuando aparecieron por primera vez World of Tanks. La empresa Wargaming tenía aproximadamente 50 servidores.
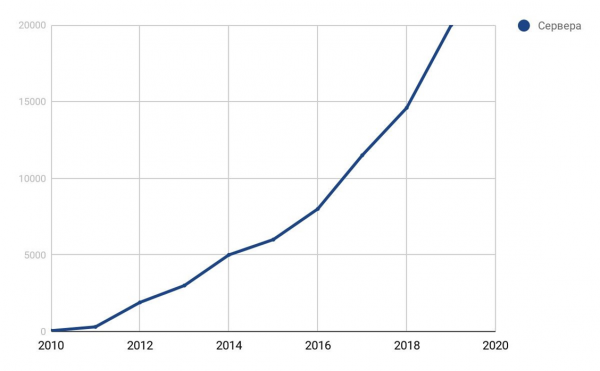
Gráfica de crecimiento de servidores de la empresa.
Teníamos un modelo de red. Para esa época, era óptimo.
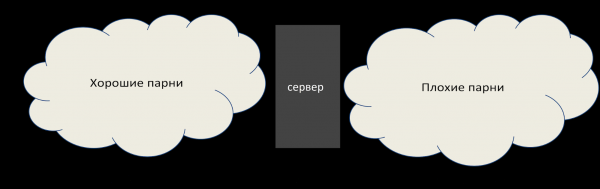
Modelo de red en 2010.
En el frontend viven los malos que quieren rompernos, pero hay un firewall. En el backend no hay firewall, pero hay 50 servidores que todos conocemos. Todo funciona bien.
En 4 años, el parque de servidores creció 100 veces, hasta 5,000. Aparecieron las primeras redes aisladas: stagings, que no pueden ir a producción, y ahí frecuentemente había elementos que podían ser peligrosos.
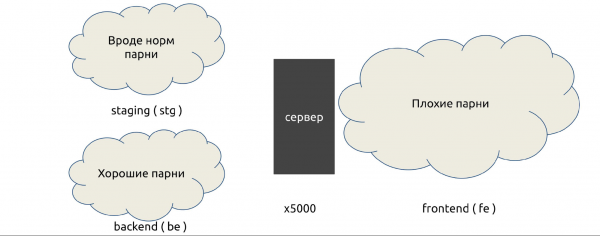
Modelo de red en 2014.
Por inercia, se siguieron utilizando los mismos equipos, y todo el trabajo se llevó a cabo en VLANs aisladas: a las VLANs se les escriben ACL que permiten o prohíben alguna conexión.
En 2016, el número de servidores alcanzó los 8000. Wargaming adquirió otros estudios, y surgieron redes de socios adicionales. Son como nuestros, pero no del todo: para los socios, VLAN a menudo no funciona, es necesario usar VPN con VRF, las aislamientos se complican. La mezcla de aislamientos ACL creció.
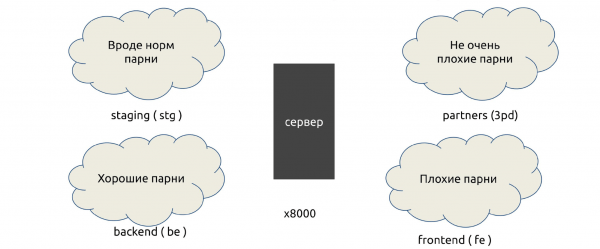
Modelo de red en 2016.
A principios de 2018, la flota de máquinas creció a 16,000. Había 6 segmentos y no contamos los demás, incluidos los cerrados, donde se almacenaban datos financieros. Surgieron redes de contenedores (Kubernetes), DevOps, redes en la nube conectadas por VPN, por ejemplo, desde el IСС. Había muchas reglas, era doloroso.
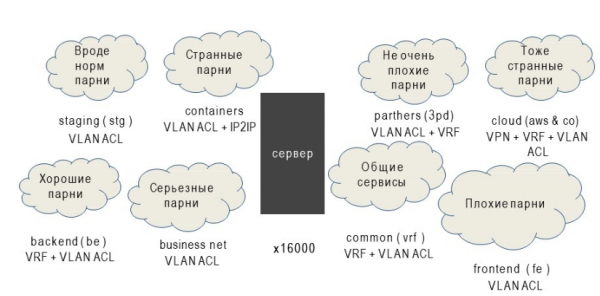
Modelo de red y métodos de aislamiento en 2018.
Para el aislamiento utilizamos: VLAN con ACL en L2, VRF con ACL en L3, VPN y muchas otras cosas. Demasiadas.
Problemas
Todos viven con ACL y VLAN. ¿Qué está mal? Esta pregunta la responderá Harold, ocultando su dolor.
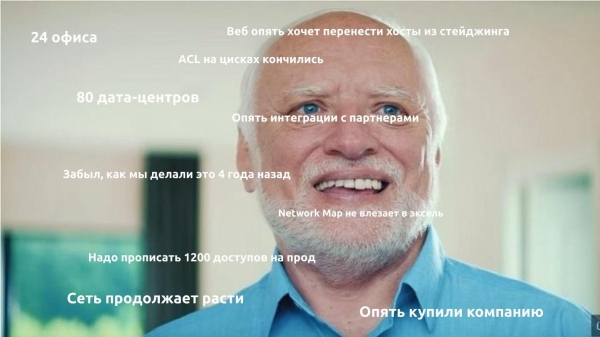
Hubo muchos problemas, pero a gran escala, cinco.
- Crecimiento geométrico de precios para las nuevas reglas. Cada nueva regla tardaba más en añadirse que la anterior, porque primero había que revisar si ya existía una regla similar.
- No hay firewall dentro de los segmentos. Los segmentos se separaron de alguna manera, pero ya no hay suficientes recursos en su interior.
- Las reglas se aplicaban lentamente. A mano, un operador podía escribir una regla local en una hora. Una global tomaba varios días.
- Dificultades con la auditoría de reglas. Más bien, no era posible. Las primeras reglas se escribieron en 2010, y la mayoría de sus autores ya no trabajaban en la empresa.
- Bajo nivel de control sobre la infraestructura. Este es el principal problema: no sabíamos bien qué estaba sucediendo.
Así se veía un ingeniero de red en 2018, cuando escuchaba: 'Necesitamos un poco más de ACL.'
Soluciones
A principios de 2018, se decidió que había que hacer algo al respecto.
El costo de las integraciones sigue aumentando. El punto de partida fue que los grandes centros de datos dejaron de soportar VLAN y ACL aisladas, ya que se quedó sin memoria en los dispositivos.
Solución: eliminar el factor humano y automatizar al máximo la provisión de acceso.
Nuevas reglas se aplican lentamente. Solución: acelerar la aplicación de reglas, hacerla distribuida y paralela. Para ello, se necesita un sistema distribuido para que las reglas se entreguen por sí solas, sin rsync o SFTP en mil sistemas.
Falta de firewall dentro de los segmentos. El firewall dentro de los segmentos comenzó a llegar a nosotros cuando aparecieron diferentes servicios dentro de una misma red. Solución: usar un firewall a nivel de host — firewalls basados en host. Prácticamente en todas partes tenemos Linux, y en todas partes hay iptables, no es un problema.
Dificultades con la auditoría de las reglas. Solución: almacenar todas las reglas en un solo lugar para revisión y gestión, así podremos auditar todo.
Bajo nivel de control sobre la infraestructura. Solución: hacer un inventario de todos los servicios y accesos entre ellos.
Es más un proceso administrativo que técnico. A veces tenemos de 200 a 300 nuevos lanzamientos por semana, especialmente durante promociones y fiestas. Esto solo para un equipo de nuestros DevOps. Con tal cantidad de lanzamientos es imposible ver o entender qué puertos, IP, integraciones son necesarias. Por eso necesitamos gerentes de servicio especialmente capacitados, que entrevistaran a los equipos: "¿Qué hay y por qué lo han levantado?"
Después de todo lo que lanzamos, el ingeniero de redes en 2019 ya se veía así.
Consul
Decidimos que todo lo que encontramos con la ayuda de los gerentes de servicio lo pondríamos en Consul y desde allí escribiríamos reglas de iptables.
¿Cómo decidimos hacerlo?
- Reuniremos todos los servicios, redes y usuarios.
- Crearemos reglas de iptables basadas en ellos.
- Automatizaremos el control.
- ….
- PROFITS.
Consul no es una API remota, puede funcionar en cada nodo y escribir en iptables. Solo queda idear medios automáticos de control que eliminen lo innecesario, ¡y la mayor parte de los problemas estará resuelta! Lo demás lo resolveremos en el proceso.
¿Por qué Consul?
Ha demostrado ser eficaz. En 2014-15 lo utilizamos como backend para Vault, donde almacenamos contraseñas.
No pierde datos.. Durante el tiempo que hemos usado Consul, no ha perdido datos en ningún accidente. Esto es una gran ventaja para el sistema de gestión del firewall.
Las conexiones P2P aceleran la propagación de cambios.. Con P2P todos los cambios llegan rápidamente, no hay que esperar horas.
API REST conveniente. También consideramos Apache ZooKeeper, pero no tiene API REST, tendríamos que poner costuras.
Funciona tanto como almacenamiento de claves (KV) como catálogo (Descubrimiento de Servicios).. Se pueden almacenar servicios, catálogos y centros de datos al mismo tiempo. Esto es conveniente no solo para nosotros, sino también para equipos vecinos, porque al construir un servicio global, pensamos de manera amplia.
Escrito en Go, que forma parte del stack de Wargaming. Amamos este lenguaje, tenemos muchos desarrolladores de Go.
Sistema ACL potente. Con ACL en Consul se puede gestionar quién y qué puede escribir. Garantizamos que las reglas del firewall no se cruzarán con nada más y no tendremos problemas con esto.
Pero Consul también tiene desventajas.
- No se escala dentro del centro de datos, a menos que tenga la versión de empresa. Solo se escala a través de federaciones.
- Es muy dependiente de la calidad de la red y de la carga de los servidores. Consul no funcionará bien como servidor en un servidor cargado si hay lag en la red, por ejemplo, velocidad inestable. Esto se relaciona con conexiones P2P y modelos de propagación de actualizaciones.
- Dificultades con el monitoreo de la disponibilidad. El estado de Consul puede indicar que todo está bien, mientras que en realidad ya ha fallado.
La mayoría de estos problemas los resolvimos durante la operación de Consul, por eso lo elegimos. La empresa tiene planes para un backend alternativo, pero hemos aprendido a lidiar con los problemas y, por ahora, vivimos con Consul.
Cómo funciona Consul
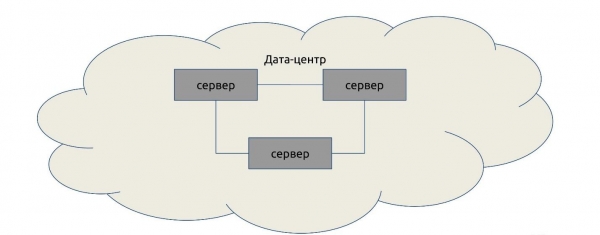
En un centro de datos hipotético, instalaremos servidores: de tres a cinco. Uno o dos servidores no son suficientes: no podrán organizar el quórum y decidir quién tiene razón y quién no cuando los datos no coinciden. Más de cinco no tiene sentido, el rendimiento disminuirá.
Los clientes se conectan a los servidores en cualquier orden: son los mismos agentes, solo con la bandera server = false.
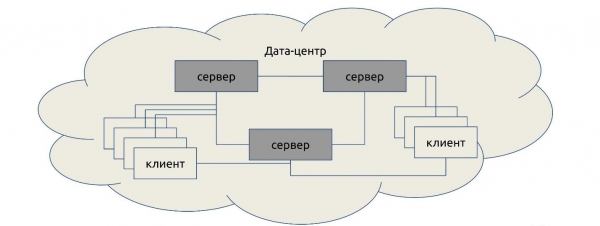
. Después de esto, los clientes obtienen una lista de conexiones P2P y establecen relaciones entre ellos.
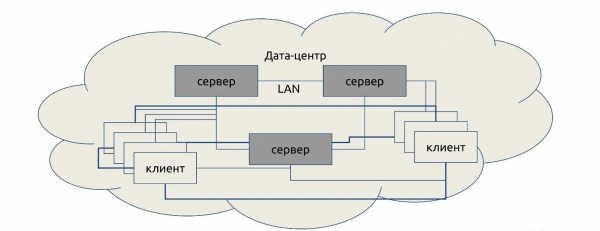
A nivel global, conectamos varios centros de datos entre sí. También se conectan de manera P2P y se comunican.
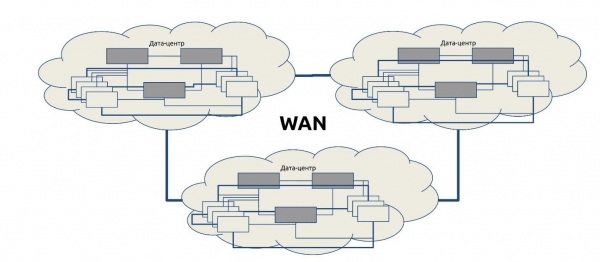
Cuando queremos obtener datos de otro centro de datos, la solicitud va de servidor a servidor. Este esquema se llama protocolo Serf. El protocolo Serf, al igual que Consul, es un desarrollo de HashiCorp.
Algunos hechos importantes sobre Consul
Consul tiene documentación que describe su funcionamiento. Solo mencionaré algunos hechos selectos que vale la pena conocer.
Los servidores de Consul eligen un maestro entre los votantes. Consul elige un maestro de la lista de servidores para cada centro de datos, y todas las solicitudes van solo a él, independientemente del número de servidores. La interrupción del maestro no conduce a nuevas elecciones. Si no se elige un maestro, las solicitudes no son atendidas.
¿Querías escalado horizontal? Lo siento, no.
La solicitud a otro centro de datos va de maestro a maestro, sin importar a qué servidor ha llegado. El maestro seleccionado recibe el 100% de la carga, excepto la carga de las solicitudes forward. Todos los servidores del centro de datos tienen una copia actual de los datos, pero solo uno responde.
La única forma de escalar es activar el modo stale en el cliente.
En modo stale se puede responder sin quórum. Este es un modo en el que renunciamos a la consistencia de los datos, pero leemos un poco más rápido de lo habitual, y cualquier servidor puede responder. Naturalmente, la escritura solo es a través del maestro.
Consul no copia datos entre centros de datos. Al recolectar la federación, cada servidor tendrá solo sus propios datos. Para los otros, siempre se consulta a alguien más.
La atomicidad de las operaciones no está garantizada fuera de la transacción. Recuerde que no solo usted puede cambiar algo. Si desea hacerlo de otra manera, realice una transacción con bloqueo.
Las operaciones bloqueantes no garantizan el bloqueo. La solicitud va de maestro a maestro, y no directamente, así que no hay garantías de que el bloqueo funcione cuando realice el bloqueo, por ejemplo, en otro centro de datos.
ACL tampoco garantiza el acceso (en muchos casos). La ACL puede no funcionar porque se almacena en un centro de datos de la federación: en el centro de datos de ACL (DC Primario). Si el DC no responde, la ACL no funcionará.
Un maestro atascado provocará que toda la federación se quede atascada. Por ejemplo, en una federación de 10 centros de datos, y en uno hay una mala red, y un maestro se cae. Todos los que interactúan con él quedarán atascados en un ciclo: se envía una solicitud, no hay respuesta, el hilo se queda atascado. No será posible saber cuándo ocurrirá, simplemente, después de una hora o dos, toda la federación caerá. No podrá hacer nada al respecto.
El estado, el quórum y las elecciones son procesados por un hilo separado. No habrá reevaluación, el estado no mostrará nada. Usted cree que su Consul está activo, hace una solicitud y no pasa nada; no hay respuesta. A pesar de esto, el estado muestra que todo está bien.
Nos hemos enfrentado a este problema, hemos tenido que reconstruir partes específicas de los centros de datos para evitarlo.
En la versión empresarial de Consul Enterprise no hay algunas de las desventajas mencionadas anteriormente.Tiene muchas funciones útiles: selección de votantes, distribución, escalabilidad. Solo hay un 'pero': el sistema de licencias para un sistema distribuido es muy costoso.
Consejo útil: rm -rf /var/lib/consul — una medicina para todos los males del agente. Si algo no funciona, simplemente elimina tus datos y carga los datos de una copia. Lo más probable es que Consul funcione.
BEFW
Ahora hablemos de lo que hemos agregado a Consul.
— es un acrónimo de BackEndFireWall. Tenía que nombrar el producto cuando creé el repositorio para poner los primeros commits de prueba. Ese nombre se mantuvo.
Plantillas de reglas
Las reglas están escritas en sintaxis de iptables.
- -N BEFW
- -P INPUT DROP
- -A INPUT -m state --state RELATED,ESTABLISHED -j ACCEPT
- -A INPUT -i lo -j ACCEPT
- -A INPUT -j BEFW
Todo se dirige a la cadena BEFW, excepto ESTABLISHED, RELATED y localhost. La plantilla puede ser cualquier cosa, este es solo un ejemplo.
¿Qué utilidad tiene BEFW?
Servicios
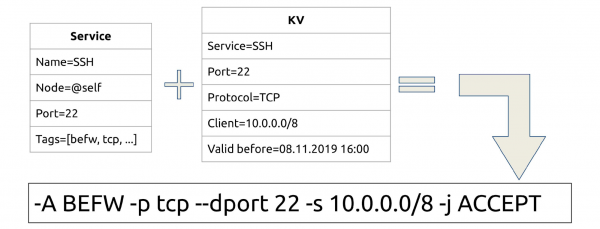
Tenemos un servicio, siempre hay un puerto, el nodo en el que se ejecuta. Desde nuestro nodo podemos preguntar localmente al agente y averiguar que tenemos algún servicio. También se pueden asignar etiquetas.
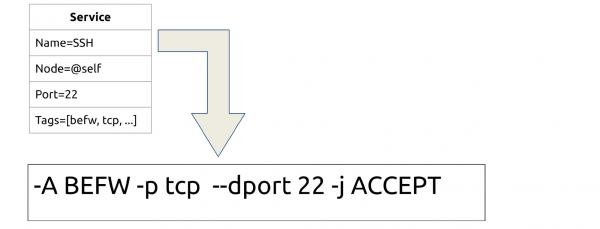
Cualquier servicio que esté en funcionamiento y registrado en Consul se convierte en una regla iptables. Tenemos SSH — abrimos el puerto 22. El script Bash es simple: curl e iptables, no se necesita nada más.
Clientes
¿Cómo brindar acceso no a todos, sino selectivamente? Almacenar listas de IP en el almacenamiento KV por el nombre del servicio.
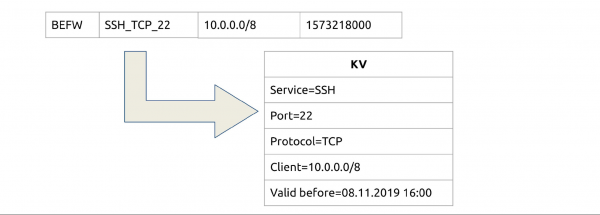
Por ejemplo, queremos que todos de la décima red puedan acceder al servicio SSH_TCP_22. Agregamos un pequeño campo TTL? y ahora tenemos permisos temporales, por ejemplo, por un día.
Accesos
Conectamos servicios y clientes: tenemos un servicio, para cada uno hay un almacenamiento KV listo. Ahora damos acceso no a todos, sino selectivamente.
Grupos
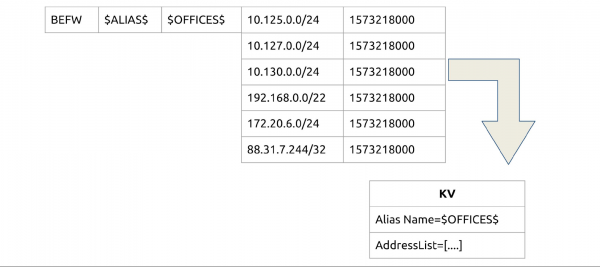
Si cada vez vamos a escribir miles de IP para accesos, nos cansaremos. Vamos a inventar agrupaciones: un subset separado en KV. Lo llamaremos Alias (o grupos) y almacenaremos allí grupos bajo el mismo principio.
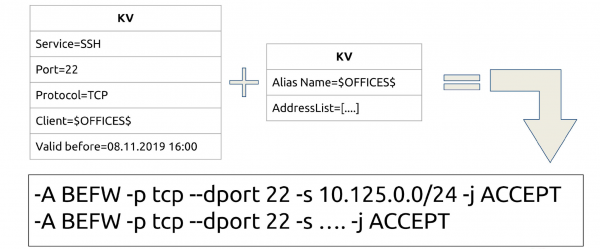
Conectamos: ahora podemos abrir SSH no específicamente en P2P, sino a todo un grupo o varios grupos. Igualmente hay TTL — se puede agregar y eliminar temporalmente de un grupo.
Integración
Nuestro problema es el factor humano y la automatización. Por ahora lo hemos resuelto así.
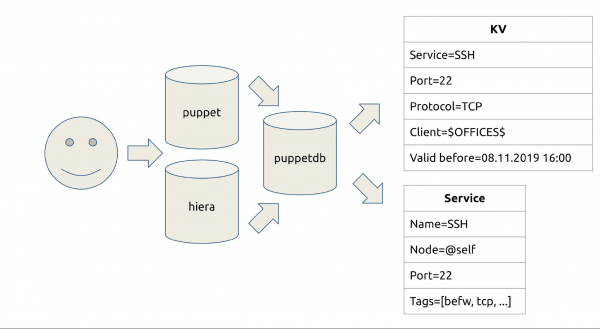
Trabajamos con Puppet y transferimos todo lo relacionado con el sistema (código de aplicaciones). En puppetdb (un PostgreSQL estándar) se almacena una lista de servicios que están en ejecución, que se pueden encontrar por tipo de recurso. También se puede ver a quién se está dirigiendo cada uno. Además, tenemos un sistema de pull request y merge request para esto.
Escribimos befw-sync, una solución sencilla que ayuda a transferir datos. Primero, sync cookies se comunica con puppetdb. Allí está configurada una API HTTP: solicitamos qué servicios tenemos y qué se necesita hacer. Luego se hace una solicitud a Consul.
¿Hay integración? Sí: hemos escrito las reglas y permitido aceptar Pull Requests. ¿Se necesita algún puerto o agregar un host a algún grupo? Pull Request, revisión: no más "Encuentra 200 otras ACL y trata de hacer algo con esto".
Optimización
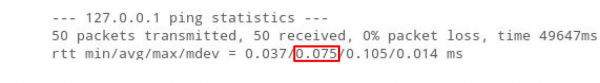
Hacer ping a localhost con una cadena de reglas vacía toma 0,075 ms.
Agregaremos 10,000 direcciones a la cadena de iptables. Como resultado, el ping aumentará 5 veces: iptables es completamente lineal, el procesamiento de cada dirección toma un tiempo.
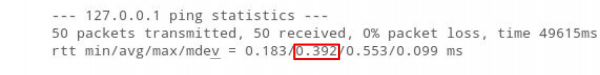
Para el firewall al que estamos migrando miles de ACL, tenemos muchas reglas, y eso introduce latencia. Esto es malo para protocolos de juego.
Pero si colocamos 10,000 direcciones en ipset, el ping incluso disminuirá.
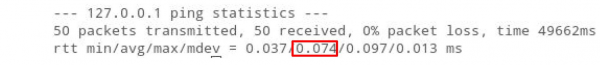
El sentido es que "O" (la complejidad del algoritmo) para ipset siempre es igual a 1, sin importar cuántas reglas haya. Sin embargo, hay una limitación: no puede haber más de 65,535 reglas. Por ahora convivimos con esto: se pueden combinar, ampliar, crear dos ipset en uno.
Almacenamiento
La continuación lógica del proceso de iteraciones es almacenar información sobre los clientes para el servicio en ipset.
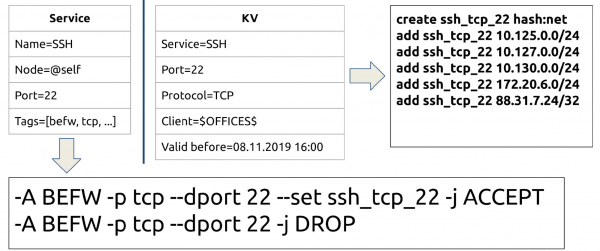
Ahora tenemos el mismo SSH, y no escribimos inmediatamente 100 IP, sino que especificamos el nombre de ipset con el que hay que comunicarse, y la siguiente regla ELIMINAR. Se puede convertir en una sola regla "Quien no esté aquí, que se descarte", pero así es más visual.
Ahora tenemos reglas y conjuntos. La tarea principal es crear el conjunto antes de escribir la regla, porque de lo contrario iptables no registrará la regla.
Esquema general
En forma de esquema, todo lo que he explicado se ve así.
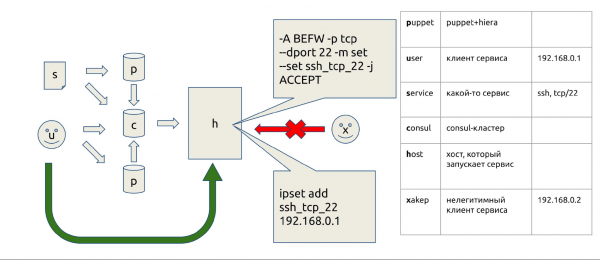
Hacemos commit en Puppet, todo se envía al host, los servicios están aquí, ipset allí, y quien no esté registrado allí, no es permitido.
Permitir y denegar
Para salvar el mundo rápidamente o desconectar a alguien rápidamente, al principio de todas las cadenas hemos creado dos ipsets: rules_allow y rules_deny. ¿Cómo funciona esto?
Por ejemplo, alguien genera carga en nuestro Web con bots. Antes había que buscar su IP en los registros, llevarla a los ingenieros de red para que encontraran el origen del tráfico y lo bloquearan. Ahora, esto se ve diferente.
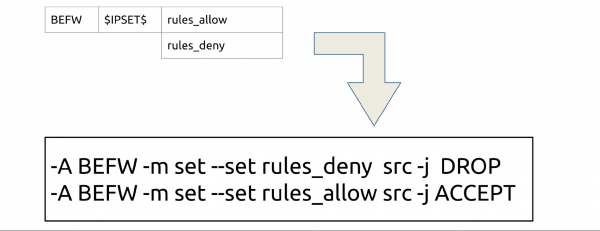
Enviamos a Consul, esperamos 2.5 segundos, y está listo. Dado que Consul distribuye rápidamente a través de P2P, funciona en cualquier parte del mundo.
Una vez, detuve completamente WOT, equivocándome con el firewall. rules_allow — esta es nuestra póliza contra tales casos. Si en algún lugar cometimos un error con el firewall, que bloquea algo, siempre podemos enviar un condicional 0.0/0, para levantar todo rápidamente. Luego, podremos repararlo manualmente.
Otros conjuntos
Se pueden añadir otros conjuntos en el espacio $IPSETS$.
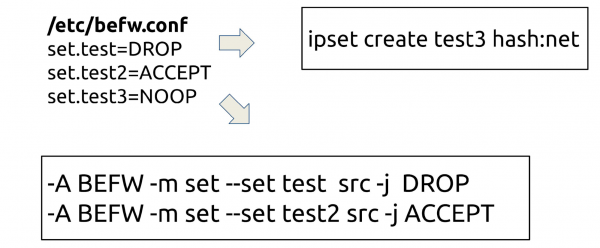
¿Por qué? A veces, alguien necesita ipset, por ejemplo, para emular la desconexión de una parte del clúster. Cualquiera puede traer cualquier conjunto, nombrarlo y se recogerán de Consul. Además, los conjuntos pueden participar en las reglas de iptables, o ser como un comando NOOP: la consistencia será mantenida por el demonio.
Usuarios
Antes era así: el usuario se conectaba a la red y obtenía parámetros a través de un dominio. Hasta que aparecieron los firewalls de nueva generación, Cisco no podía entender dónde estaba el usuario y dónde estaba la IP. Por lo tanto, el acceso solo se otorgaba a través del hostname de la máquina.
¿Qué hicimos? Interrumpimos en el momento de obtener la dirección. Generalmente, esto es dot1x, Wi-Fi o VPN — todo pasa a través de RADIUS. Para cada usuario creamos un grupo bajo su nombre de usuario y colocamos en él la IP con un TTL que equivale a su dhcp.lease — tan pronto como expire, la regla desaparecerá.
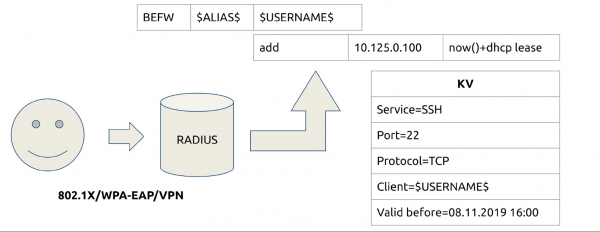
Ahora podemos otorgar acceso a los servicios, como a otros grupos, según el nombre de usuario. Nos hemos librado del dolor con los hostnames cuando cambian, y hemos aliviado la carga de los ingenieros de red, porque ya no necesitan Cisco. Ahora los ingenieros establecen los accesos en sus servidores.
⚠️ Limitado
Paralelamente, comenzamos a desmantelar la aislamiento. Los gerentes de servicios hicieron un inventario y nosotros analizamos todas nuestras redes. Las organizamos en grupos similares, y en los servidores necesarios, agregamos grupos, por ejemplo, en deny. Ahora, el mismo aislamiento de staging se encuentra en rules_deny en producción, pero no en la producción misma.
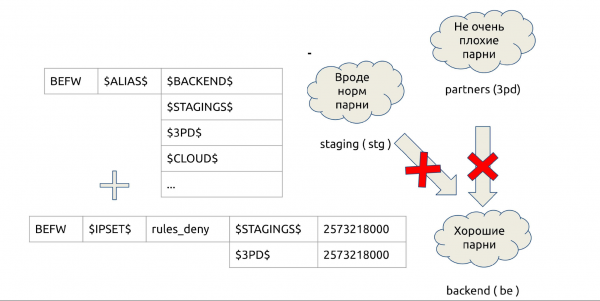
El esquema funciona rápido y simple: eliminamos todos los ACL de los servidores, reducimos la carga de hardware y disminuimos la cantidad de VLAN aisladas.
Control de integridad
Antes teníamos un desencadenador especial que avisaba cuando alguien cambiaba manualmente una regla del firewall. Yo escribí un enorme linter para comprobar las reglas del firewall, fue complicado. Ahora la integridad la controla BEFW. Vigila celosamente que las reglas que él establece no se modifiquen. Si alguien cambia las reglas del firewall, revertirá todo. "Rápidamente levanté un proxy para trabajar desde casa" — esa opción ya no existe.
BEFW controla ipset desde los servicios y la lista en befw.conf, las reglas de los servicios en la cadena BEFW. Pero no monitorea otras cadenas y reglas ni otros ipsets.
Protección contra fallos
BEFW siempre guarda el último estado exitoso directamente en la estructura binaria state.bin. Si algo sale mal, siempre retrocede a este state.bin.
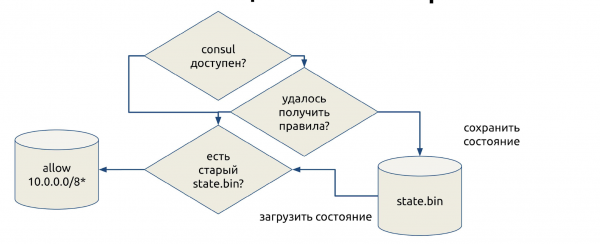
Esto es un seguro contra el funcionamiento inestable de Consul, cuando no envió datos o alguien cometió un error y utilizó reglas que no se pueden aplicar. Para que no nos quedemos sin firewall, BEFW revertirá al último estado si en algún momento ocurre un error.
En situaciones críticas, esto garantiza que mantengamos un firewall funcional. Abrimos todas las redes grises con la esperanza de que el administrador venga y lo repare. Algún día llevaré esto a la configuración, pero ahora solo tenemos tres redes grises: 10/8, 172/12 y 192.168/16. Dentro de nuestro Consul, esta es una característica importante que ayuda a avanzar.
Demo: durante la presentación, Iván demuestra el modo demo de funcionamiento de BEFW. Es más fácil ver la demostración en . El código fuente de la demo está disponible .
Puntos ocultos
Les hablaré sobre los errores con los que nos encontramos.
ipset add set 0.0.0.0/0. ¿Qué sucederá si agregas 0.0.0.0/0 a ipset? ¿Se agregarán todas las IP? ¿Se abrirá el acceso a internet?
No, obtendremos un error que nos costó dos horas de tiempo de inactividad. Además, el error no se ha corregido desde 2016, está en RedHat Bugzilla bajo el número #1297092, y lo encontramos por casualidad — a partir del informe del desarrollador.
Ahora en BEFW existe una regla estricta que 0.0.0.0/0 se convierte en dos direcciones: 0.0.0.0/1 y 128.0.0.0/1.
ipset restore set < file. ¿Qué hace ipset cuando le dices restore?? Вы думаете, он работает также, как iptables? Восстановит данные?
Nada parecido — hace un merge, y las direcciones antiguas no desaparecen, no cierras el acceso.
Encontramos el error cuando probábamos la isolación. Ahora hay un sistema bastante complejo — en lugar de restore? se realiza create temp, luego restore flush temp y restore temp. Al final, swap: para la atomicidad, porque si primero se realiza flush Y en ese momento, si llega algún paquete, será rechazado y algo saldrá mal. Por eso, hay un poco de magia negra.
consul kv get -datacenter=other. Como ya mencioné, pensamos que estamos solicitando algunos datos, pero recibiremos ya sea datos o un error. Podemos hacer esto a través de Consul localmente, pero en este caso tanto uno como otro se congelarán.
El cliente local de Consul es una envoltura sobre la API HTTP. Pero simplemente se congela y no responde ni a Ctrl+C, ni a Ctrl+Z, ni a nada, solo a , finalizar suavemente el proceso y detener el servidor ( en la consola vecina. Nos enfrentamos a esto cuando construimos un gran clúster. Pero aún no tenemos soluciones, estamos preparándonos para corregir este error en Consul.
El líder de Consul no responde. Nuestro máster en el centro de datos no responde, pensamos: "¿Quizás ahora funcionará el algoritmo de reelección?"
No, no funcionará, y la vigilancia no mostrará nada: Consul dirá que el índice de compromiso existe, el líder fue encontrado, todo está bien.
¿Cómo luchamos contra esto? service consul restart en cron cada hora. Si tienes 50 servidores, no hay problema. Cuando tenga 16,000, entenderás cómo funciona.
Conclusión
Al final, obtuvimos las siguientes ventajas:
- 100% de cobertura de todas las máquinas Linux.
- Velocidad.
- Automatización.
- Liberamos el hardware y a los ingenieros de redes de la esclavitud.
- Surgen posibilidades de integración que son prácticamente ilimitadas: desde Kubernetes hasta Ansible, o Python.
Desventajas: Consul, con el que ahora debemos vivir, y un precio de error muy alto. Por ejemplo, una vez a las 6 de la tarde (hora pico en Rusia) estaba ajustando algo en las listas de redes. Justo en ese momento estábamos construyendo la aislamiento en BEFW. Cometí algún error, parece que indiqué una máscara equivocada, pero todo falló en dos segundos. La vigilancia se activa, el soporte acude: "¡Todo está caído!" El jefe del departamento se volvió canoso mientras explicaba a la empresa por qué ocurrió eso.
El precio del error es tan alto que ideamos un complejo procedimiento de prevención. Si vas a implementar esto en una gran producción, no des el token de máster sobre Consul a todo el mundo. Terminará mal.
Costo. Escribí código durante 400 horas en solitario. Mi equipo de 4 personas gasta 10 horas al mes en soporte para todos. En comparación con el costo de cualquier firewall de nueva generación, esto es gratis.
Planes. El plan a largo plazo es buscar un transporte alternativo en lugar de o además de Consul. Podría ser Kafka o algo similar. Pero en los próximos años vivimos con Consul.
Planes más cercanos: integración con Fail2ban, monitoreo, nftables, posiblemente con otras distribuciones, métricas, monitoreo avanzado, optimización. El soporte para Kubernetes también está en nuestros planes, ya que actualmente tenemos varios clústeres y el deseo de implementarlo.
Más planes:
- búsqueda de anomalías en el tráfico;
- gestión del mapa de red;
- soporte para Kubernetes;
- compilación de paquetes para todos los sistemas;
- Interfaz Web.
Constantemente estamos trabajando en la expansión de la configuración, aumento de métricas y optimización.
Únete al proyecto. El proyecto es genial, pero, desafortunadamente, por ahora es un proyecto de una persona. Ven a y trata de hacer algo: haz un commit, prueba algo, sugiere algo, dale tu opinión.
Mientras tanto, nos estamos preparando para , que se llevará a cabo el 6 y 7 de abril en San Petersburgo, e invitamos a desarrolladores de sistemas de alta carga . Los ponentes experimentados ya saben qué hacer, y recomendamos a los principiantes en presentaciones que al menos . Participar en la conferencia como ponente tiene varias ventajas. Puedes leer sobre cuáles son, por ejemplo, al final de .
Fuente: habr.com
