

Cualquier operación con grandes volúmenes de datos requiere una gran potencia de cálculo. Mover datos de una base a Hadoop puede tardar semanas o costar lo mismo que el ala de un avión. ¿No quieres esperar y gastar dinero? Distribuye la carga entre diferentes plataformas. Una de las formas es la optimización pushdown.
Le pedí al destacado entrenador en Rusia sobre desarrollo y administración de productos Informatica, Alexey Ananyev, que me hablara sobre la función de optimización pushdown en Informatica Big Data Management (BDM). ¿Alguna vez aprendiste a trabajar con los productos de Informatica? Seguramente fue Alexey quien te enseñó los fundamentos de PowerCenter y te explicó cómo construir mappings.
Alexey Ananyev, director del departamento de formación de DIS Group
¿Qué es pushdown?
Muchos de ustedes ya están familiarizados con Informatica Big Data Management (BDM). El producto puede integrar grandes datos de diversas fuentes, moverlos entre diferentes sistemas, proporcionar fácil acceso a ellos, permitir su perfilado y mucho más.
En manos expertas, BDM puede hacer maravillas: las tareas se llevarán a cabo rápidamente y con recursos computacionales mínimos.
¿También quieres eso? Aprende a usar la función pushdown en BDM para distribuir la carga de trabajo entre diferentes plataformas. La tecnología pushdown permite convertir un mapping en un script y elegir el entorno en el que este script se ejecutará. Esta opción permite combinar las fortalezas de diferentes plataformas y alcanzar su máximo rendimiento.
Para configurar el entorno de ejecución del script, es necesario seleccionar el tipo de pushdown. El script puede ejecutarse completamente en Hadoop o repartirse parcialmente entre la fuente y el receptor. Hay 4 tipos posibles de pushdown. El mapping puede no convertirse en script (nativo). El mapping puede ejecutarse en su máxima expresión en la fuente (fuente) o completamente en la fuente (completo). Además, el mapping puede convertirse en un script de Hadoop (ninguno).
Optimización pushdown
Los 4 tipos mencionados se pueden combinar de diversas maneras: optimizar pushdown para las necesidades específicas del sistema. Por ejemplo, a menudo es más conveniente extraer datos de la base de datos, utilizando sus propias capacidades. Y transformar los datos con la ayuda de Hadoop, para no sobrecargar la base de datos.
Consideremos un caso en el que tanto la fuente como el receptor están en la base de datos, y la plataforma para ejecutar las transformaciones se puede elegir: según la configuración, será Informatica, servidor de base de datos o Hadoop. Este ejemplo permitirá comprender con mayor precisión el aspecto técnico del funcionamiento de este mecanismo. Por supuesto, en la vida real, tal situación no ocurre, pero para demostrar la funcionalidad se adapta de la mejor manera.
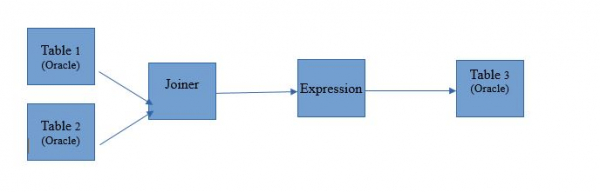
Tomemos un mapeo para leer dos tablas en una única base de datos Oracle. Y los resultados de la lectura se guardarán en una tabla en esta misma base. El esquema de mapeo será el siguiente:
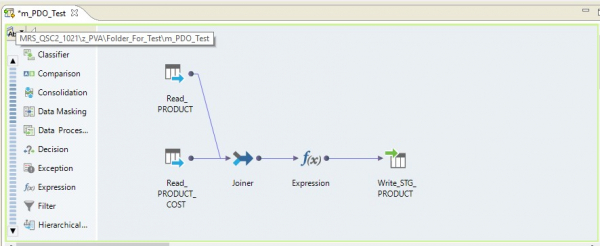
En forma de mapeo en Informatica BDM 10.2.1, se ve así:
Tipo pushdown – nativo
Si elegimos el tipo pushdown nativo, el mapeo se ejecutará en servidor Informatica. Los datos se leerán del servidor Oracle, se transferirán al servidor de Informatica, se transformarán allí y se enviarán a Hadoop. En otras palabras, obtendremos un proceso ETL habitual.
Tipo pushdown – fuente
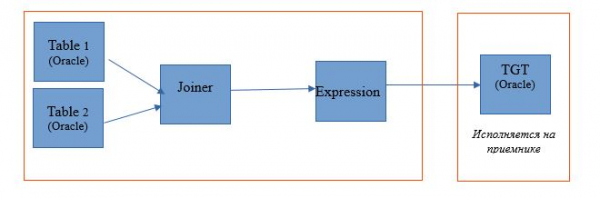
Al elegir el tipo fuente, obtenemos la posibilidad de distribuir nuestro proceso entre el servidor base de datos (BD) y Hadoop. Al ejecutar el proceso con esta configuración, se enviarán consultas para seleccionar datos de las tablas a la base de datos. Y el resto se ejecutará en forma de pasos en Hadoop.
El esquema de ejecución será así:
A continuación se muestra un ejemplo de configuración del entorno de ejecución.
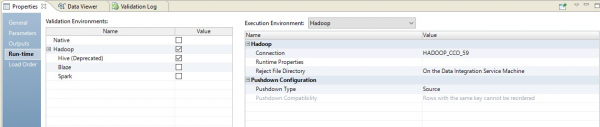
En este caso, el mapeo se llevará a cabo en dos pasos. En su configuración veremos que se ha convertido en un script que se enviará a la fuente. Además, la unión de tablas y la transformación de datos se realizarán en forma de consulta redefinida en la fuente.
En la imagen de abajo, vemos un mapeo optimizado en BDM, y en la fuente, una consulta redefinida.
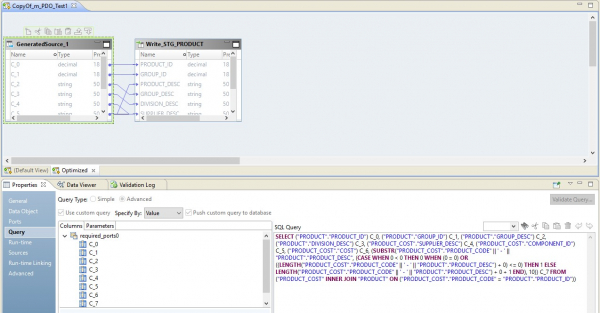
El papel de Hadoop en esta configuración se limitará a gestionar el flujo de datos: orquestar su flujo. El resultado de la consulta se enviará a Hadoop. Después de completar la lectura, el archivo desde Hadoop se guardará en el receptor.
Tipo pushdown – completo
Al elegir el tipo completo, el mapeo se convertirá por completo en una consulta en la base de datos. Y el resultado de la consulta se enviará a Hadoop. El esquema de dicho proceso se presenta a continuación.
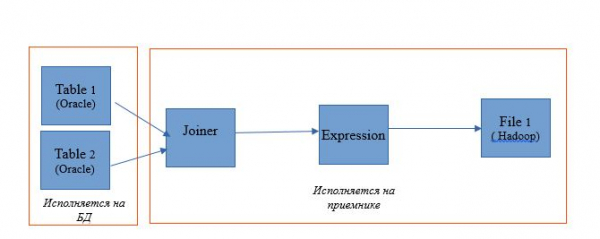
El ejemplo de configuración se presenta a continuación.
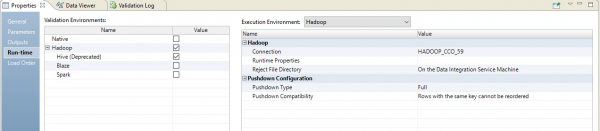
Como resultado, obtendremos un mapeo optimizado similar al anterior. La diferencia es que toda la lógica se trasladará al receptor en forma de redefinición de su inserción. A continuación se presenta un ejemplo de un mapeo optimizado.
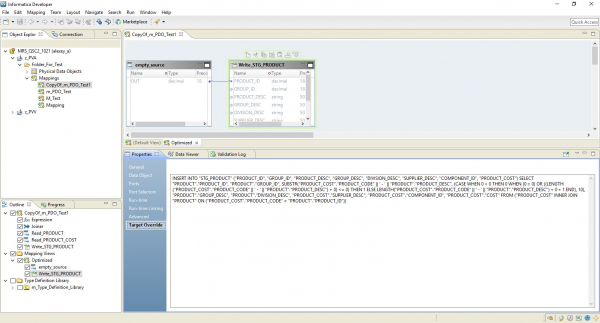
Aquí, al igual que en el caso anterior, Hadoop cumple el papel de director. Sin embargo, aquí se lee la fuente en su totalidad y luego, a nivel del receptor, se lleva a cabo la lógica de procesamiento de datos.
Tipo pushdown – null
Y la última opción es el tipo pushdown, dentro del cual nuestro mapeo se convertirá en un script en Hadoop.
El mapeo optimizado ahora se verá así:
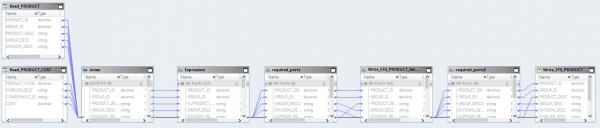
Aquí los datos de los archivos fuente se leerán primero en Hadoop. Luego, con las mismas herramientas, estos dos archivos se combinarán. Después de eso, los datos se transformarán y se cargarán en la base de datos.
Comprendiendo los principios de optimización pushdown, se pueden organizar de manera muy eficaz muchos procesos de trabajo con grandes datos. De hecho, hace poco, una gran empresa extrajo en solo unas semanas grandes datos de un almacén en Hadoop, que había estado recopilando durante varios años.
Fuente: habr.com
