

¡Hola, Habr! Les presento la traducción del artículo
.
Cuando se trata de bases de datos relacionales, no puedo evitar pensar que algo falta. Se utilizan en todas partes. Hay muchas bases de datos diferentes: desde el pequeño y útil SQLite hasta la potente Teradata. Pero hay muy pocos artículos que explican cómo funciona una base de datos. Puedes buscar por ti mismo con la consulta "howdoesarelationaldatabasework" para ver cuántos pocos resultados hay. Además, estos artículos son cortos. Si buscas las últimas tecnologías de moda (Big Data, NoSQL o JavaScript), encontrarás más artículos profundos que explican cómo funcionan.
¿Son las bases de datos relacionales demasiado antiguas y aburridas para ser explicadas fuera de los cursos universitarios, trabajos de investigación y libros?
Como desarrollador, odio usar lo que no entiendo. Y si las bases de datos se han utilizado durante más de 40 años, debe haber una razón. A lo largo de los años, he pasado cientos de horas realmente intentando entender estas extrañas cajas negras que uso todos los días. Bases de datos relacionales son muy interesantes porque se basan en conceptos útiles y reutilizables. Si te interesa entender una base de datos, pero nunca has tenido tiempo o ganas de profundizar en este amplio tema, te debe gustar este artículo.
Aunque el título de este artículo es explícito, el objetivo de este artículo no es entender cómo usar una base de datos. Por lo tanto, ya debes saber cómo escribir una consulta de unión simple y consultas básicas CRUD; de lo contrario, puede que no entiendas este artículo. Esto es lo único que necesitas saber, yo explicaré todo lo demás.
Comenzaré con algunos conceptos básicos de ciencias de la computación, como la complejidad temporal de los algoritmos (Big O). Sé que algunos de ustedes odian este concepto, pero sin él no podrán entender los detalles dentro de una base de datos. Dado que es un tema enorme, me enfocaré en lo que considero importante: cómo una base de datos procesa SQL consultas. Solo presentaré los conceptos básicos de base de datos, para que al final del artículo tengan una idea de lo que sucede bajo el capó.
Dado que se trata de un artículo extenso y técnico que incluye múltiples algoritmos y estructuras de datos, tómese su tiempo para leerlo. Algunos conceptos pueden ser difíciles de entender; puede omitarlos y aún así obtener una comprensión general.
Para aquellos que están más informados, este artículo se divide en 3 partes:
- Resumen de componentes de base de datos de bajo y alto nivel
- Resumen del proceso de optimización de consultas
- Resumen de la gestión de transacciones y del búfer
Volviendo a los fundamentos
Hace muchos años (en una galaxia lejana...), los desarrolladores tenían que conocer exactamente la cantidad de operaciones que estaban codificando. Sabían de memoria sus algoritmos y estructuras de datos porque no podían permitirse desperdiciar el CPU y la memoria de sus lentos ordenadores.
En esta parte, les recordaré algunos de estos conceptos, ya que son necesarios para entender la base de datos. También introduciré el concepto de índice de base de datos.
O(1) vs O(n2)
Hoy en día, muchos desarrolladores no se preocupan por la complejidad temporal de los algoritmos... ¡y tienen razón!
Pero cuando se trata de grandes volúmenes de datos (no hablo de miles) o si está luchando por milisegundos, se vuelve críticamente importante entender este concepto. Y como sabrá, las bases de datos deben lidiar con ambas situaciones. No lo haré perder más tiempo del necesario para captar la esencia. Esto nos ayudará más adelante a comprender el concepto de optimización basada en costos (cost based optimization).
Concepto
Complejidad temporal del algoritmo se utiliza para ver cuánto tiempo tomará ejecutar el algoritmo para un determinado volumen de datos. Para describir esta complejidad, se utilizan notaciones matemáticas de gran O. Esta notación se usa con una función que describe cuántas operaciones necesita el algoritmo para una cantidad determinada de datos de entrada.
Por ejemplo, cuando digo "este algoritmo tiene una complejidad O (some_function() )", significa que para procesar una cierta cantidad de datos, el algoritmo necesita some_function(a_certain_amount_of_data) operaciones.
Al mismo tiempo lo importante no es la cantidad de datos**, sino cómo ** aumenta la cantidad de operaciones a medida que aumenta el volumen de datos. La complejidad temporal no da un número exacto de operaciones, pero es una buena manera de estimar el tiempo de ejecución.
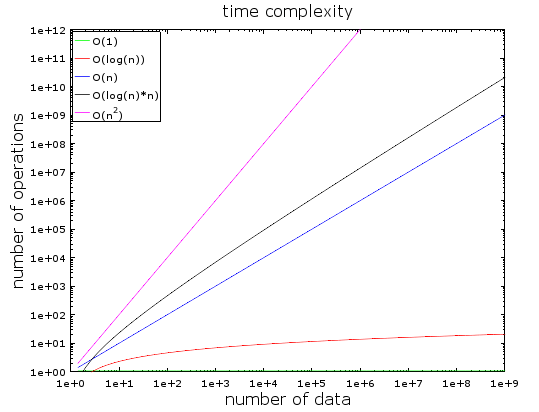
En este gráfico puedes ver la relación entre el número de operaciones y el volumen de datos de entrada para diferentes tipos de complejidades temporales de algoritmos. He utilizado una escala logarítmica para representarlas. En otras palabras, la cantidad de datos aumenta rápidamente de 1 a 1 mil millones. Podemos ver que:
- O(1) o complejidad constante se mantiene constante (de lo contrario, no se llamaría complejidad constante).
- D(log(n)) se mantiene baja incluso con miles de millones de datos.
- La complejidad peor es O(n2), donde el número de operaciones aumenta rápidamente.
- Las otras dos complejidades también aumentan rápidamente.
Ejemplos
Con un pequeño número de datos, la diferencia entre O(1) y O(n2) es insignificante. Por ejemplo, supongamos que tienes un algoritmo que debe procesar 2000 elementos.
- El algoritmo O(1) te costará 1 operación
- El algoritmo O(log(n)) te costará 7 operaciones
- El algoritmo O(n) te costará 2000 operaciones
- El algoritmo O(n * log(n)) te costará 14000 operaciones
- El algoritmo O(n2) te costará 4000000 operaciones
La diferencia entre O(1) y O(n2) parece grande (4 millones de operaciones) pero perderás a lo sumo 2 ms, apenas el tiempo de parpadear. De hecho, los procesadores modernos pueden manejar . Por eso, el rendimiento y la optimización no son un problema en muchos proyectos de TI.
Como ya mencioné, sigue siendo importante conocer este concepto al trabajar con grandes volúmenes de datos. Si esta vez el algoritmo debe procesar 1,000,000 de elementos (lo cual no es mucho para una base de datos):
- El algoritmo O(1) te costará 1 operación
- El algoritmo O(log(n)) te costará 14 operaciones
- El algoritmo O(n) te costará 1,000,000 de operaciones
- El algoritmo O(n * log(n)) te costará 14,000,000 de operaciones
- El algoritmo O(n2) te costará 1,000,000,000,000 de operaciones
No he hecho los cálculos, pero diría que con el algoritmo O(n2) tienes tiempo para tomar un café (incluso dos). Si agregas otro 0 al volumen de datos, tendrás tiempo para una siesta.
Vamos más a fondo
Para referencia:
- Buscar en una buena tabla hash encuentra un elemento en O(1).
- Buscar en un árbol bien equilibrado da un resultado en O(log(n)).
- Buscar en un arreglo da un resultado en O(n).
- Los mejores algoritmos de ordenamiento tienen una complejidad de O(n * log(n)).
- Un mal algoritmo de ordenamiento tiene una complejidad de O(n2).
Nota: en las siguientes partes veremos estos algoritmos y estructuras de datos.
Hay varios tipos de complejidad temporal en un algoritmo:
- escenario promedio
- mejor caso
- y peor caso
La complejidad temporal a menudo se refiere al peor escenario.
Hablé solo sobre la complejidad temporal de un algoritmo, pero la complejidad también se aplica a:
- el consumo de memoria del algoritmo
- el consumo de entrada/salida de disco del algoritmo
Por supuesto, hay complejidades peores que n², por ejemplo:
- n⁴: ¡esto es terrible! Algunos de los algoritmos mencionados tienen esta complejidad.
- 3n: ¡esto es aún peor! Uno de los algoritmos que veremos más adelante en este artículo tiene esta complejidad (y se utiliza realmente en muchas bases de datos).
- factorial n: nunca obtendrás tus resultados incluso con un conjunto de datos pequeño.
- nⁿ: si te enfrentas a esta complejidad, debes preguntarte si realmente es tu campo...
Nota: No te he dado una definición real de la notación "grande O", solo una idea. Puedes leer este artículo en para la definición real (asimptótica).
MergeSort (Ordenación por fusión)
¿Qué haces cuando necesitas ordenar una colección? ¿Qué? Llamas a la función sort()... Bien, buena respuesta... Pero en una base de datos, debes entender cómo funciona esa función sort().
Hay varios buenos algoritmos de ordenación, así que me centraré en el más importante: la ordenación por fusión. Quizás no entiendas ahora por qué es útil ordenar datos, pero lo entenderás después de la parte dedicada a la optimización de consultas. Además, comprender la ordenación por fusión nos ayudará más adelante a entender la operación conjunta general en bases de datos, llamada merge join (unión por fusión).
Merge (fusión)
Como muchos algoritmos útiles, la ordenación por fusión se basa en una astucia: fusionar 2 arreglos ordenados de tamaño N/2 en un arreglo ordenado de N elementos solo cuesta N operaciones. Esta operación se llama fusión.
Veamos lo que esto significa con un ejemplo sencillo:
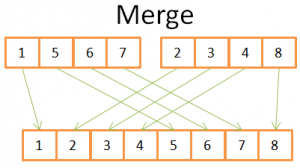
En esta ilustración, se muestra que para construir el arreglo ordenado final de 8 elementos, solo necesitas realizar una iteración sobre 2 arreglos de 4 elementos. Dado que ambos arreglos de 4 elementos ya están ordenados:
- 1) Comparas ambos elementos actuales en dos arreglos (al principio el actual = el primero)
- 2) Luego toma el menor para colocarlo en un arreglo de 8 elementos
- 3) Y pasa al siguiente elemento en el arreglo de donde tomaste el elemento más pequeño
- y repite 1, 2, 3, hasta llegar al último elemento de uno de los arreglos.
- Luego tomas los demás elementos del otro arreglo para colocarlos en un arreglo de 8 elementos.
Esto funciona porque ambos arreglos de 4 elementos están ordenados, por lo que no necesitas 'volver' en estos arreglos.
Ahora que entendemos este truco, aquí está mi pseudocódigo para merge:
array mergeSort(array a)
   if(length(a)==1)
      return a[0];
   end if

   //llamadas recursivas
   [left_array right_array] := split_into_2_equally_sized_arrays(a);
   array new_left_array := mergeSort(left_array);
   array new_right_array := mergeSort(right_array);

   //fusionando los 2 pequeños arreglos ordenados en uno grande
   array result := merge(new_left_array,new_right_array);
   return result;
La ordenación por mezcla divide el problema en problemas más pequeños y luego encuentra los resultados de los problemas menores para obtener el resultado del problema original (nota: este tipo de algoritmos se llama dividir y conquistar). Si no entiendes este algoritmo, no te preocupes; no lo entendí la primera vez que lo vi. Si puede ayudarte, veo este algoritmo como un algoritmo de dos fases:
- Fase de división, donde el arreglo se divide en arreglos más pequeños
- Fase de ordenación, donde los arreglos pequeños se combinan (usando la fusión) para formar un arreglo más grande.
Fase de división
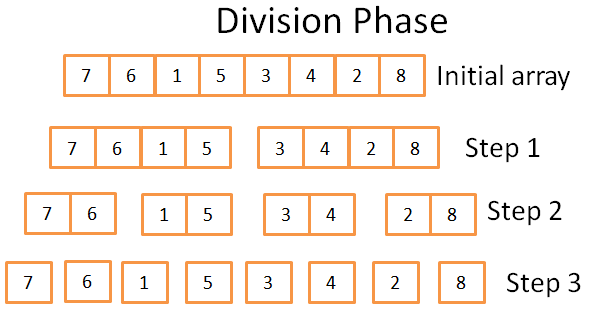
En la etapa de división, el arreglo se divide en arreglos unitarios en 3 etapas. El número formal de pasos es log(N) (dado que N=8, log(N) = 3).
¿De dónde sé esto?
¡Soy un genio! En una palabra: matemáticas. La idea es que cada paso divide el tamaño del arreglo original a la mitad. El número de pasos es cuántas veces puedes dividir el arreglo original por dos. Esta es la definición exacta del logaritmo (en base 2).
Fase de ordenación
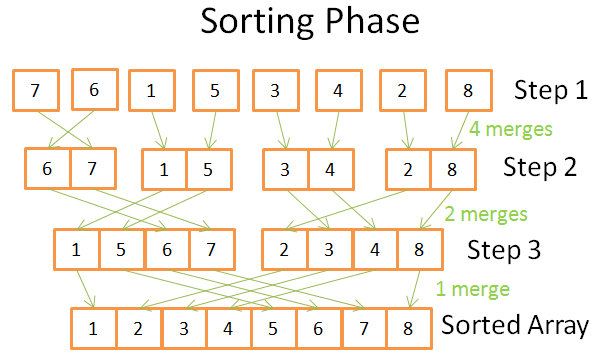
En la etapa de ordenación comienzas con arreglos unitarios (de un solo elemento). En cada etapa aplicas varias operaciones de fusión, y el costo total es N = 8 operaciones:
- En la primera etapa tienes 4 fusiones que cuestan 2 operaciones cada una
- En la segunda etapa tienes 2 fusiones que cuestan 4 operaciones cada una
- En la tercera etapa tienes 1 fusión que cuesta 8 operaciones
Dado que hay log (N) pasos, el costo total de N * log(N) operaciones.
Ventajas del merge sort
¿Por qué es tan poderoso este algoritmo?
Porque:
- Puedes modificarlo para reducir el uso de memoria de modo que no crees nuevos arreglos, sino que modifiques directamente el arreglo de entrada.
Nota: este tipo de algoritmos se llama (ordenamiento sin memoria adicional).
- Puedes adaptarlo para usar espacio en disco y una pequeña cantidad de memoria sin un costo significativo en I/O de disco. La idea es cargar en memoria solo las partes que se están procesando en ese momento. Esto es importante cuando necesitas ordenar una tabla de varios gigabytes con solo 100 megabytes de memoria buffer.
Nota: este tipo de algoritmos se llama .
- Puedes modificarlo para ejecutarse en múltiples procesos/threads/servidores.
Por ejemplo, la ordenación de fusión distribuida es uno de los componentes clave (que es una estructura de Big Data).
- Este algoritmo puede convertir plomo en oro (¡es verdad!).
Este algoritmo de ordenamiento se utiliza en la mayoría (si no en todos) de las bases de datos, pero no es el único. Si deseas saber más, puedes leer este , que discute las ventajas y desventajas de los algoritmos de ordenamiento comunes en bases de datos.
Arreglo, Árbol y Tabla Hash
Ahora que entendemos la idea de la complejidad temporal y el ordenamiento, debo contarte sobre 3 estructuras de datos. Esto es importante porque son la base de las bases de datos modernas. También introducire el concepto de índice de base de datos.
Arreglo
Un arreglo bidimensional es la estructura de datos más simple. Una tabla se puede considerar como un arreglo. Por ejemplo:
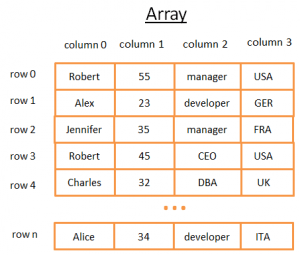
Este arreglo 2D representa una tabla con filas y columnas:
- Cada fila representa una entidad
- Las columnas almacenan propiedades que describen la entidad.
- Cada columna almacena datos de un tipo específico (entero, cadena, fecha…).
Es muy conveniente almacenar y visualizar datos, sin embargo, cuando necesitas encontrar un valor específico, no es adecuado.
Por ejemplo, si deseas encontrar a todos los chicos que trabajan en el Reino Unido, tendrás que revisar cada fila para determinar si pertenece al Reino Unido. Esto te costará N operaciones, donde N — la cantidad de filas, lo cual no está mal, pero ¿podría haber un camino más rápido? Ahora es el momento de conocer los árboles.
Nota: la mayoría de las bases de datos modernas ofrecen arreglos avanzados para el almacenamiento eficiente de tablas: tablas organizadas en heaps y tablas organizadas en índices. Pero eso no cambia el problema de la búsqueda rápida de una condición específica en un grupo de columnas.
Árbol y índice de base de datos
Un árbol binario de búsqueda es un árbol binario con una propiedad especial: la clave en cada nodo debe ser:
- mayor que todas las claves almacenadas en el subárbol izquierdo
- menor que todas las claves almacenadas en el subárbol derecho
Veamos qué significa esto visualmente
La idea
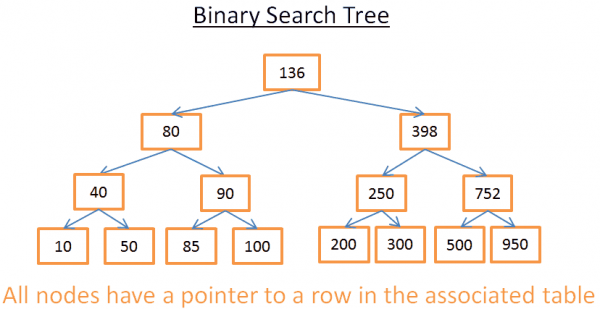
Este árbol tiene N = 15 elementos. Supongamos que estoy buscando 208:
- Comienzo con la raíz, cuya clave es 136. Dado que 136 < 208, miro el subárbol derecho del nodo 136.
- 398 > 208, por lo tanto, miro el subárbol izquierdo del nodo 398
- 250 > 208, por lo tanto, miro el subárbol izquierdo del nodo 250
- 200 < 208, por lo tanto, miro el subárbol derecho del nodo 200. Pero 200 no tiene subárbol derecho, el valor no existe (porque, si existiera, estaría en el subárbol derecho de 200).
Ahora, digamos que busco 40
- Comienzo con la raíz, cuya clave es 136. Dado que 136 > 40, miro el subárbol izquierdo del nodo 136.
- 80 > 40, por lo tanto, miro el subárbol izquierdo del nodo 80
- 40= 40, el nodo existe. Extraigo el identificador de fila dentro del nodo (esto no está en la imagen) y busco en la tabla para el identificador de fila dado.
- Conocer el identificador de fila me permite saber dónde están los datos en la tabla, y por lo tanto puedo obtenerlos de inmediato.
En total, ambas búsquedas me costarán la cantidad de niveles dentro del árbol. Si lees detenidamente la parte sobre la ordenación por fusión, deberías ver que aquí hay log (N) niveles. Así que, el costo de búsqueda es log(N), ¡no está mal!
Regresamos a nuestro problema
Pero esto es muy abstracto, así que volvamos a nuestro problema. En lugar de un simple entero, imagina una cadena que representa el país de alguien en la tabla anterior. Supongamos que tienes un árbol que contiene el campo "country" (columna 3) de la tabla:
- Si quieres saber quién trabaja en el Reino Unido
- miras el árbol para obtener el nodo que representa el Reino Unido
- Dentro de "UKnode" encontrarás la ubicación de los registros de empleados en el Reino Unido.
Esta búsqueda costará log(N) operaciones en lugar de N operaciones si utilizas directamente un arreglo. Lo que acabas de presentar fue el índice de la base de datos.
Puedes construir un árbol índice para cualquier grupo de campos (cadena, número, 2 cadenas, número y cadena, fecha...) siempre que tengas una función para comparar claves (es decir, grupos de campos) para que puedas establecer el orden entre las claves (lo cual es aplicable a cualquier tipo básico en la base de datos).
B+TreeIndex
Aunque este árbol funciona bien para obtener un valor específico, existe un GRAN problema cuando necesitas obtener varios elementos entre dos valores.Esto costará O(N) porque tendrás que observar cada nodo en el árbol y verificar si está entre esos dos valores (por ejemplo, con un recorrido ordenado del árbol). Además, esta operación no es conveniente para la entrada y salida de disco, ya que tendrás que leer todo el árbol. Necesitamos encontrar una forma de ejecutar una consulta de rango.Para resolver este problema, las bases de datos modernas utilizan una versión modificada del árbol anterior llamada B+Tree. En el árbol B+Tree:
- solo los nodos más bajos (hojas) almacenan la información (ubicación de las filas en la tabla asociada)
- los otros nodos están aquí para dirigir al nodo correcto durante la búsqueda..
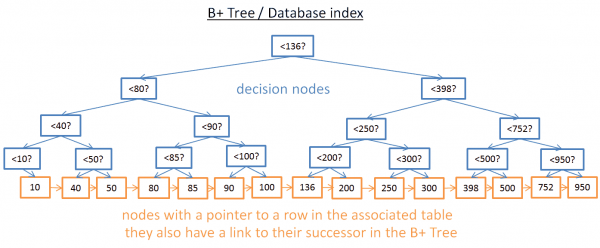
Como puedes ver, hay más nodos aquí (el doble). De hecho, tienes nodos adicionales, los "nodos de decisión", que te ayudarán a encontrar el nodo correcto (que almacena las ubicaciones de las filas en la tabla asociada). Pero la complejidad de búsqueda sigue siendo O(log(N)) (solo hay un nivel más). La gran diferencia es que los nodos en el nivel inferior están conectados a sus sucesores..
Con este B+Tree, si buscas valores del 40 al 100:
- Simplemente necesitas buscar el 40 (o el valor más cercano después del 40, si el 40 no existe), como lo hacías con el árbol anterior.
- Luego recoge los sucesores del 40, utilizando enlaces directos a los sucesores, hasta que llegues al 100.
Supongamos que encontraste M sucesores, y el árbol tiene N nodos. La búsqueda de un nodo específico cuesta log(N), similar al árbol anterior. Sin embargo, al obtener este nodo, recibirás M sucesores en M operaciones con referencias a sus sucesores. Esta búsqueda solo cuesta M + log(N) operaciones en comparación con N operaciones del árbol anterior. Además, no necesitas leer el árbol completo (solo M + log(N) nodos), lo que significa un menor uso de disco. Si M es pequeño (por ejemplo, 200 filas) y N es grande (1,000,000 filas), habrá una GRAN diferencia.
Pero aquí hay nuevos problemas (¡de nuevo!). Si agregas o eliminas una fila en la base de datos (y, por lo tanto, en el índice relacionado B+Tree):
- debes mantener el orden entre los nodos dentro del árbol B+Tree, de lo contrario, no podrás encontrar nodos dentro de un árbol desordenado.
- debes mantener la cantidad mínima posible de niveles en el B+Tree, de lo contrario, la complejidad temporal en O(log(N)) se convertirá en O(N).
En otras palabras, el B+Tree debe ser autoordenado y balanceado. Afortunadamente, esto es posible gracias a operaciones inteligentes de eliminación e inserción. Pero esto tiene un costo: insertar y eliminar en un árbol B+ tiene un costo de O(log(N)). Es por eso que algunos de ustedes han escuchado que usar demasiados índices no es una buena idea. De hecho, estás ralentizando la rápida inserción/actualización/eliminación de filas en la tabla, ya que la base de datos necesita actualizar los índices de la tabla con una costosa operación O(log(N)) para cada índice. Además, agregar índices significa una mayor carga para el gestor de transacciones (se describirá al final del artículo).
Para más información, puedes consultar el artículo en Wikipedia sobre . Si deseas un ejemplo de implementación de B+Tree en bases de datos, revisa y de un destacado desarrollador de MySQL. Ambos se centran en cómo InnoDB (el motor de MySQL) maneja los índices.
Nota: un lector me dijo que, debido a optimizaciones de bajo nivel, el árbol B+ debe estar completamente balanceado.
Hashtable (Tabla Hash)
Nuestra última estructura de datos importante es la tabla hash. Es muy útil cuando deseas buscar valores rápidamente. Además, entender la tabla hash nos ayudará más adelante a comprender una operación de unión con bases de datos, llamada unión hash ( hash join). Esta estructura de datos también es utilizada por la base de datos para almacenar algunas cosas internas (por ejemplo, tabla de bloqueo o pool de búfer, veremos ambos conceptos más adelante).
La tabla hash es una estructura de datos que encuentra rápidamente un elemento por su clave. Para construir una tabla hash, necesitas definir:
- la clave para tus elementos
- una función hash para las claves. Los hashes calculados de las claves dan la ubicación de los elementos (llamados segmentos ).
- una función para comparar claves. Una vez que has encontrado el segmento correcto, debes encontrar el elemento que buscas dentro del segmento, usando esta comparación.
Un ejemplo sencillo
Tomemos un ejemplo visual:
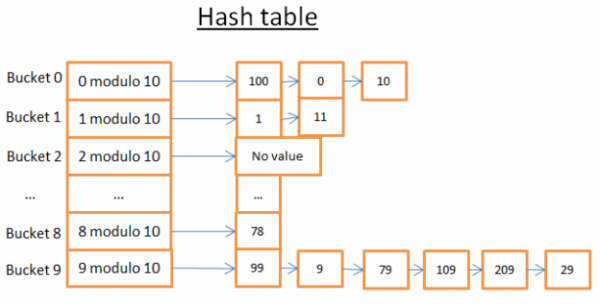
Esta tabla hash tiene 10 segmentos. Dado que soy un poco perezoso, solo dibujé 5 segmentos, pero sé que tú eres inteligente, así que te dejaré imaginar los 5 restantes por ti mismo. Utilicé una función hash módulo 10 de la clave. En otras palabras, solo guardo el último dígito de la clave del elemento para encontrar su segmento:
- si el último dígito es 0, el elemento va al segmento 0,
- si el último dígito es 1, el elemento va al segmento 1,
- si el último dígito es 2, el elemento va al segmento 2,
- …
La función de comparación que utilicé es simplemente la igualdad entre dos números enteros.
Supongamos que deseas obtener el elemento 78:
- La tabla hash calcula el código hash para 78, que es 8.
- La tabla hash mira en el segmento 8, y el primer elemento que encuentra es 78.
- Te devuelve el elemento 78
- La búsqueda costó solo 2 operaciones (una para calcular el valor de la función hash, y otra para buscar el elemento dentro del segmento).
Ahora, supongamos que deseas obtener el elemento 59:
- La tabla hash calcula el código hash para 59, que es 9.
- La tabla hash busca en el segmento 9, el primer elemento encontrado es 99. Dado que 99!=59, el elemento 99 no es el correcto.
- Siguiendo esta misma lógica, se toma el segundo elemento (9), el tercero (79), …, el último (29).
- Elemento no encontrado.
- La búsqueda costó 7 operaciones.
Una buena función hash
Como puedes ver, dependiendo del valor que estás buscando, el costo no es el mismo!
Si ahora cambio la función hash a módulo 1,000,000 de la clave (es decir, tomando los últimos 6 dígitos), la segunda búsqueda costará solo 1 operación, ya que en el segmento 000059 no hay elementos. La tarea real es encontrar una buena función hash que genere segmentos que contengan muy pocos elementos..
En mi ejemplo, encontrar una buena función hash es fácil. Pero es un ejemplo simple; encontrar una buena función hash es más complicado cuando la clave es:
- una cadena (por ejemplo, un apellido)
- 2 cadenas (por ejemplo, un apellido y un nombre)
- 2 cadenas y una fecha (por ejemplo, un apellido, un nombre y una fecha de nacimiento)
- …
Con una buena función hash, la búsqueda en una tabla hash se realiza en O(1)..
Array vs tabla hash
¿Por qué no usar un array?
Hmm, buena pregunta.
- La tabla hash puede estar parcialmente cargada en memoria,, mientras que los demás segmentos pueden quedar en el disco.
- Con un array, debes usar un espacio continuo en memoria. Si cargas una tabla grande, es muy difícil encontrar suficiente espacio continuo..
- Para la tabla hash, puedes elegir la clave que necesites (por ejemplo, un país y el apellido de una persona).
Para más información, puedes leer el artículo sobre , que es una implementación eficiente de una tabla hash; no necesitas entender Java para comprender los conceptos expuestos en este artículo.
Fuente: habr.com
