

Ciencia de datos para principiantes
1. Análisis de Sentimientos
Mira la implementación completa del proyecto de Ciencia de Datos usando el código fuente — .
El Análisis de Sentimientos es el análisis de palabras para determinar emociones y opiniones, que pueden ser positivas o negativas. Es un tipo de clasificación donde las categorías pueden ser binarias (positivas y negativas) o múltiples (felices, enojadas, tristes, desagradables…). Implementaremos este proyecto de Ciencia de Datos en R y utilizaremos un conjunto de datos del paquete «janeaustenR». Usaremos diccionarios de propósito general como AFINN, bing y loughran, realizaremos una unión interna, y al final crearemos nubes de palabras para visualizar los resultados.
Idioma: R
Conjunto de datos / Paquete: janeaustenR
Este artículo fue traducido con el apoyo de EDISON Software, que , así como .
2. Detección de Noticias Falsas
Lleva tus habilidades al siguiente nivel trabajando en un proyecto de Ciencia de Datos para principiantes — .
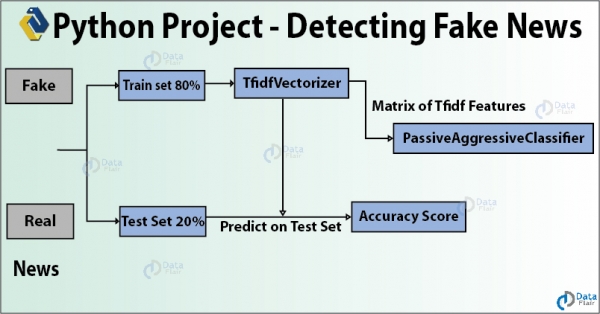
Las noticias falsas son información falsa difundida a través de redes sociales y otros medios digitales con fines políticos. En esta idea de proyecto de Ciencia de Datos, usaremos Python para construir un modelo que pueda determinar con precisión si una noticia es real o falsa. Crearemos un TfidfVectorizer y utilizaremos un PassiveAggressiveClassifier para clasificar las noticias como 'reales' o 'falsas'. Usaremos un conjunto de datos de forma 7796 × 4 y realizaremos todo en Jupyter Lab.
Idioma: Python
Conjunto de datos / Paquete: news.csv
3. Detección de la Enfermedad de Parkinson
Avanza trabajando en la idea del Proyecto de Ciencia de Datos — .
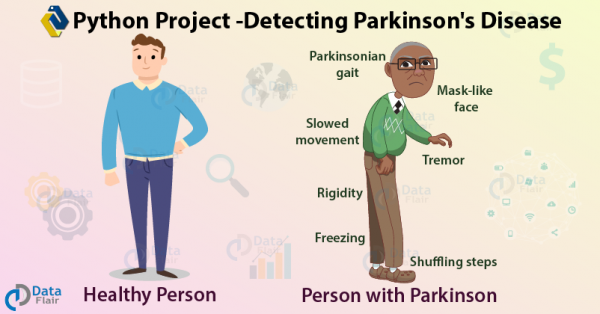
Comenzamos a utilizar la Ciencia de Datos para mejorar la salud y los servicios — si podemos predecir la enfermedad en sus primeras etapas, tendremos muchas ventajas. Así que, en esta idea de proyecto de Ciencia de Datos, aprenderemos a detectar la enfermedad de Parkinson con Python. Esta es una enfermedad neurodegenerativa progresiva del sistema nervioso central que afecta el movimiento y causa temblores y rigidez. Afecta a las neuronas productoras de dopamina en el cerebro, y cada año, afecta a más de 1 millón de personas en India.
Idioma: Python
Conjunto de datos / Paquete: Conjunto de datos UCI ML Parkinsons
Proyectos de Ciencia de Datos de dificultad media
4. Reconocimiento de emociones en el habla
Conozca la implementación completa del proyecto de Ciencia de Datos — .
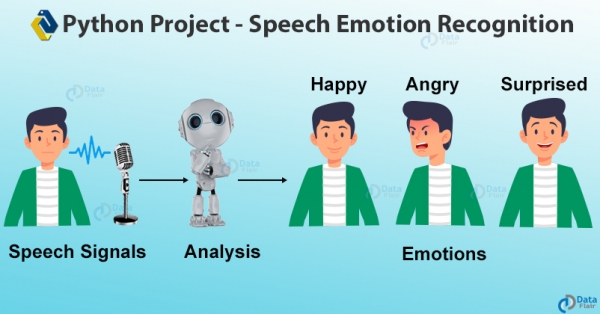
Ahora aprendamos a utilizar diferentes bibliotecas. Este proyecto de Ciencia de Datos utiliza librosa para el reconocimiento de voz. SER es el proceso de determinar las emociones humanas y los estados afectivos a partir del habla. Dado que usamos el tono y la inflexión para expresar emociones con la voz, SER es relevante. Pero como las emociones son subjetivas, la anotación de sonido es una tarea compleja. Usaremos las funciones mfcc, chroma y mel y utilizaremos el conjunto de datos RAVDESS para el reconocimiento de emociones. Crearemos un clasificador MLPC para este modelo.
Idioma: Python
Conjunto de datos / Paquete: Conjunto de datos RAVDESS
5. Detección de género y edad
Impresione a los empleadores con el nuevo proyecto de Ciencia de Datos — .
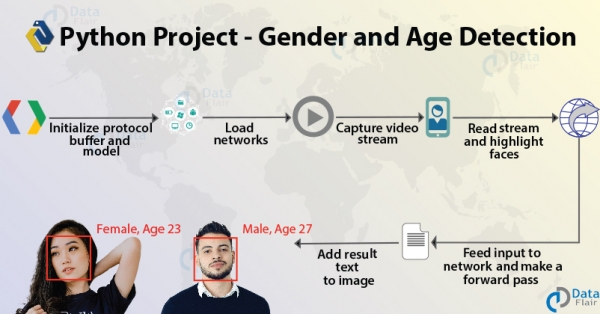
Este es un interesante proyecto de Ciencia de Datos con Python. Usando solo una imagen, aprenderá a predecir el género y la edad de una persona. En esto, le introduciremos a la Visión por Computadora y sus principios. Construiremos y utilizaremos modelos entrenados por Tal Hassner y Gil Levi para el conjunto de datos Adience. A lo largo del camino, utilizaremos algunos archivos .pb, .pbtxt, .prototxt y .caffemodel.
Idioma: Python
Conjunto de datos / Paquete: Adience
6. Análisis de datos de Uber
Vea la implementación completa del proyecto de Ciencia de Datos con código fuente — .
Este es un proyecto de visualización de datos con ggplot2, donde utilizaremos R y sus bibliotecas y analizaremos varios parámetros. Usaremos el conjunto de datos de Uber Pickups en Nueva York y crearemos visualizaciones para diversos períodos del año. Esto nos dice cómo el tiempo influye en los viajes de los clientes.
Idioma: R
Conjunto de datos / Paquete: Conjunto de datos de Uber Pickups en la ciudad de Nueva York
7. Detección de somnolencia del conductor
Mejore sus habilidades trabajando en un proyecto de Ciencia de Datos Top — .
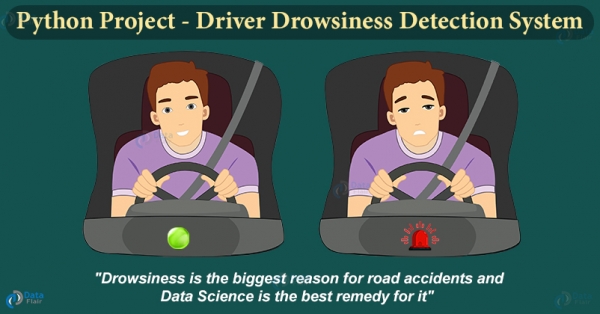
Conducir somnoliento es extremadamente peligroso, y cada año ocurren alrededor de mil accidentes debido a que los conductores se quedan dormidos al volante. En este proyecto en Python, crearemos un sistema que podrá detectar a los conductores somnolientos y también advertirles con una alarma sonora.
Este proyecto se realiza utilizando Keras y OpenCV. Vamos a usar OpenCV para detectar rostros y ojos, y con Keras clasificar el estado del ojo (Abierto o Cerrado) utilizando métodos de redes neuronales profundas.
8. Chatbot
Crea un chatbot con Python y da un paso adelante en tu carrera — .
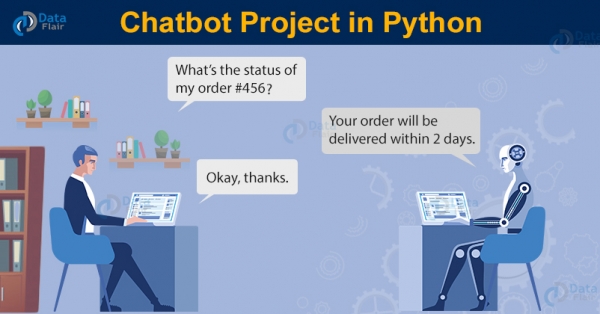
Los chatbots son una parte integral de los negocios. Muchas empresas deben ofrecer servicios a sus clientes, lo que requiere mucho personal, tiempo y esfuerzo. Los chatbots pueden automatizar gran parte de la interacción con los clientes, respondiendo a algunas preguntas frecuentes que hacen los clientes. Principalmente, hay dos tipos de chatbots: Específicos de dominio y de dominio abierto. Los chatbots específicos de dominio suelen utilizarse para resolver un problema concreto. Por lo tanto, debes configurarlo para que funcione de manera efectiva en tu campo. A los chatbots de dominio abierto se les pueden hacer cualquier tipo de preguntas, por lo que requieren una gran cantidad de datos para su entrenamiento.
Conjunto de datos: Archivo json de Intents
Idioma: Python
Proyectos avanzados de Data Science
9. Generador de descripciones de imágenes
Consulta la implementación completa del proyecto con el código fuente — .
Describir lo que hay en una imagen es una tarea fácil para las personas, pero para las computadoras, una imagen es simplemente un conjunto de números que representan el valor del color de cada píxel. Esta es una tarea difícil para las computadoras. Comprender qué hay en la imagen y luego crear una descripción en un lenguaje natural (por ejemplo, en inglés) es otra tarea complicada. Este proyecto utiliza métodos de aprendizaje profundo, donde implementamos una red neuronal convolucional (CNN) con una red neuronal recurrente (LSTM) para crear un generador de descripciones de imágenes.
Conjunto de datos: Flickr 8K
Idioma: Python
Framework: Keras
10. Detección de Fraude con Tarjeta de Crédito
Haz todo lo posible trabajando en la idea del proyecto de Data Science — .
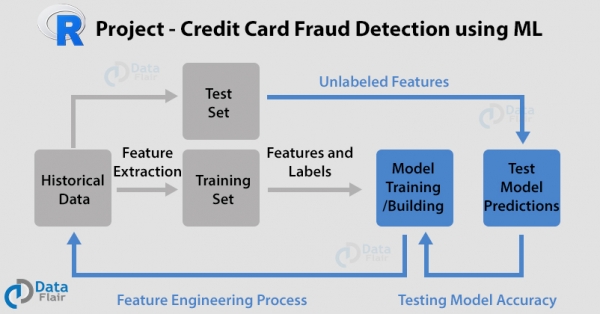
Hasta ahora has comenzado a comprender los métodos y conceptos. Pasemos a algunos proyectos avanzados en el campo de la ciencia de datos. En este proyecto utilizaremos el lenguaje R con algoritmos como , regresión logística, redes neuronales artificiales y clasificador de gradiente. Usaremos un conjunto de datos sobre transacciones con tarjetas para clasificar las transacciones de tarjetas de crédito como fraudulentas y auténticas. Seleccionaremos diferentes modelos y construiremos curvas de rendimiento.
Idioma: R
Conjunto de datos / Paquete: Conjunto de datos de transacciones con tarjetas
11. Sistema de Recomendación de Películas
Explora la implementación del mejor proyecto de Data Science con código fuente —
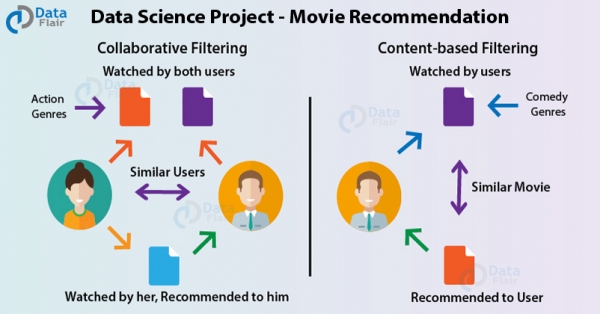
En este proyecto de Data Science, utilizaremos R para realizar recomendaciones de películas mediante aprendizaje automático. El sistema de recomendaciones envía sugerencias a los usuarios a través de un proceso de filtrado basado en las preferencias de otros usuarios y el historial de visualización. Si a A y B les gusta Home Alone, y a B le encanta Mean Girls, se puede sugerir a A que también podría gustarle. Esto permite a los clientes interactuar con la plataforma.
Idioma: R
Conjunto de datos / Paquete: Conjunto de datos de MovieLens
12. Segmentación de Clientes
Impresiona a los empleadores con un proyecto de Data Science (incluido el código fuente) — .
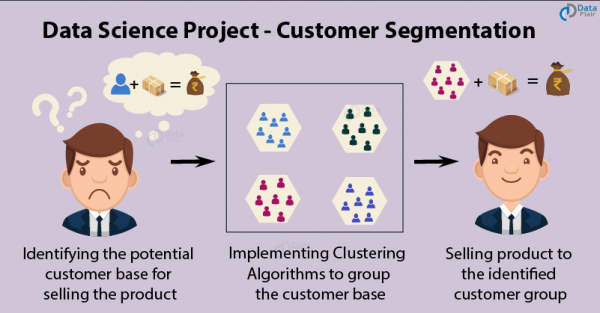
La segmentación de clientes es una aplicación popular Utilizando la agrupación, las empresas determinan segmentos de clientes para trabajar con la base potencial de usuarios. Dividen a los clientes en grupos según características comunes, como género, edad, intereses y hábitos de gasto, para poder vender su producto de manera efectiva a cada grupo. Utilizaremos , así como visualizar la distribución por género y edad. Luego, analizaremos sus ingresos anuales y niveles de gasto.
Idioma: R
Conjunto de datos / Paquete: Conjunto de datos de Mall_Customers
13. Clasificación del Cáncer de Mama
Mira la implementación completa del proyecto de Data Science en Python — .
Volviendo a la contribución médica de la ciencia de datos, aprendamos a detectar el cáncer de mama utilizando Python. Usaremos el conjunto de datos IDC_regular para identificar el carcinoma invasor del conducto, la forma más común de cáncer de mama. Este se desarrolla en los conductos mamarios, infiltrándose en el tejido fibroso o graso del exterior del conducto. En esta idea de proyecto científico para la recopilación de datos, usaremos y la biblioteca Keras para la clasificación.
Idioma: Python
Conjunto de datos / Paquete: IDC_regular
14. Reconocimiento de Señales de Tránsito
Lograr precisión en la tecnología de conducción autónoma mediante un proyecto de Ciencia de Datos sobre de código abierto.
Las señales de tránsito y las reglas de la carretera son muy importantes para cada conductor para evitar accidentes. Para seguir la regla, primero se debe entender cómo se ve una señal de tránsito. Una persona debe aprender todas las señales de tránsito antes de que le otorguen una licencia para conducir cualquier vehículo. Pero ahora el número de vehículos autónomos está en aumento, y en un futuro cercano, las personas ya no conducirán los coches por sí mismas. En el proyecto 'Reconocimiento de señales de tránsito', aprenderás cómo un programa puede reconocer el tipo de señales de tránsito tomando una imagen como entrada. Se utiliza el conjunto de datos de señales de tránsito de Alemania (GTSRB) para construir una red neuronal profunda que reconozca la clase a la que pertenece la señal de tránsito. También creamos una interfaz gráfica simple para interactuar con la aplicación.
Idioma: Python
Conjunto de datos: GTSRB (Benchmark de Reconocimiento de Señales de Tráfico Alemanas)
Leer más
Fuente: habr.com
