

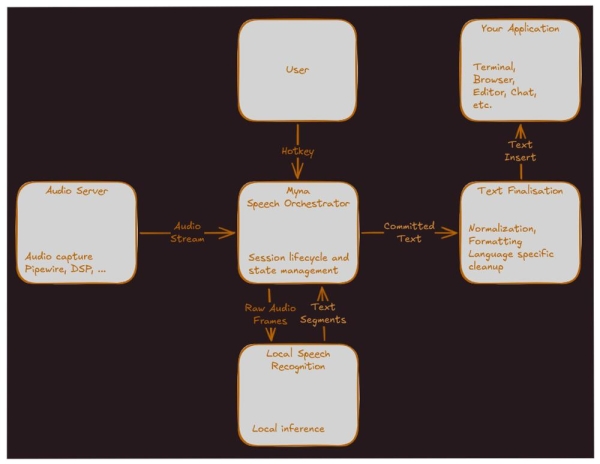
Canonical presentó el proyecto Myna — un nuevo sistema de conversión de voz a texto para Ubuntu Desktop. El proyecto está diseñado para dictado integrado: el usuario presiona una tecla de acceso rápido, habla y el texto reconocido aparece en la aplicación activa. En el anuncio se destaca que Myna debería sentirse como una parte natural del escritorio de Ubuntu y funcionar respetando la privacidad del usuario. La lista de idiomas de entrada soportados al momento de la publicación de la noticia no fue revelada.
El primer objetivo del proyecto es Ubuntu 26.10. En esta etapa, Canonical no está tratando de crear un asistente de voz completo o un sistema de control del escritorio mediante voz. Los desarrolladores han limitado intencionadamente el ámbito de la primera versión a un dictado básico y fiable: presionar una combinación de teclas, decir el texto y obtener el resultado en el campo de entrada actual. El entorno controlado inicial es Ubuntu Desktop en Wayland con GNOME, pero se planea que la arquitectura permanezca lo suficientemente abierta para el futuro soporte de otros entornos.
Myna está diseñada para el reconocimiento local de voz. Después de instalar los modelos necesarios, no se requiere conexión a Internet para el funcionamiento del dictado, el micrófono solo debe usarse tras una activación explícita por parte del usuario, el audio se procesa en la memoria y luego se descarta, y las grabaciones no se envían a servicios externos. La especificación del proyecto también indica que la solución debe evitar guardar audio por defecto y no debe cambiar sin que el usuario se dé cuenta a un servicio en la nube.
El código y la documentación de Myna se publican en el repositorio de Canonical en GitHub. El proyecto se describe como una aplicación ligera de voz a texto para Ubuntu Desktop y se distribuye bajo la licencia GPL-3.0. Sin embargo, el proyecto se encuentra en una etapa temprana: actualmente no hay versiones publicadas en el repositorio y la especificación arquitectónica tiene el estado de Propuesta.
Funciones y características principales de Myna
Dictado Push-to-talk. El usuario mantiene presionada una tecla de acceso rápido personalizable, habla y el sistema inserta el texto reconocido en el campo de entrada seleccionado. El dictado finaliza al soltar la tecla.
Reconocimiento local de voz. El reconocimiento se realiza en la máquina del usuario a través de un stack de inferencia local. Esto reduce la dependencia de la nube y permite trabajar sin conexión después de la instalación de los modelos.
Procesamiento privado de audio. El micrófono se activa solo durante la sesión de dictado del usuario. El audio no debe ser grabado en disco por defecto; se usa un buffer limitado en memoria que se limpia al finalizar la sesión.
Indicador visual de actividad. Durante la grabación y transcripción, el usuario debe ver un indicador de estado claro. La especificación menciona estados como Grabando, Transcribiendo, Finalizando y Error.
Inserción solo de texto estable. En la primera implementación, las hipótesis intermedias de reconocimiento no deben insertarse directamente en la aplicación. Solo se envía texto final confirmado al campo de destino.
Postprocesamiento de texto. La transcripción en bruto puede pasar por normalización, puntuación, capitalización, formato y conversión de formas orales a escritas, por ejemplo, 'twenty two' → '22'.
Selección del idioma de dictado. El sistema debe soportar un idioma de dictado personalizable, basándose en el idioma de la interfaz de usuario por defecto, si hay un modelo adecuado disponible.
Perfiles de calidad del modelo. La especificación prevé diferentes perfiles de modelos: una opción ligera con un menor consumo de recursos, un perfil equilibrado predeterminado y una opción de mayor calidad, pero más pesada.
Trabajo seguro con el foco de entrada. El objetivo para la inserción de texto se elige al inicio de la sesión. Si el foco de la ventana cambia durante el dictado, el sistema no debe enviar silenciamente texto a otra aplicación.
Bloqueo en campos protegidos. El dictado debe bloquearse en campos de contraseña, ventanas de autenticación y otros lugares protegidos, si la aplicación o toolkit puede determinarlo.
Integración con Wayland/GNOME. La primera versión está orientada a Wayland y GNOME. Para la inserción inicial de texto se considera IBus, y en el futuro se planea un camino más nativo de Wayland a través de protocolos de input-method/text-input.
Configuraciones del usuario. En la interfaz de configuración planificada deben incluirse activar/desactivar STT, selección de atajo de teclado, idioma de dictado, micrófono, perfil de modelo, opciones de postprocesamiento e indicador de actividad.
En la primera iteración, quedan fuera del proyecto el despertar por palabra clave, la escucha de fondo constante, el reconocimiento en la nube, el asistente de voz, los comandos de voz, el control del escritorio, la traducción de voz, la identificación del hablante, la detección automática de idioma y el historial de dictados. En otras palabras, Canonical no comienza con un "asistente de IA", sino con una función más práctica: la entrada de voz local de texto en aplicaciones normales de Ubuntu.
Fuente: linux.org.ru
