

Expresar lo que las palabras no pueden transmitir; sentir una amplia variedad de emociones entrelazadas en un torbellino de sentimientos; desprenderse de la tierra, del cielo e incluso del mismo universo, embarcándose en un viaje donde no hay mapas, ni caminos, ni señales; imaginar, contar y vivir toda una historia que siempre será única e irrepetible. Todo esto es posible gracias a la música, un arte que existe desde hace miles de años y que deleita nuestros oídos y corazones.
Sin embargo, la música, o más exactamente, las composiciones musicales pueden servir no solo para el placer estético, sino también para transmitir información codificada en ellas, destinada a algún dispositivo y que es indetectable para el oyente. Hoy, nos familiarizaremos con una investigación bastante inusual, en la que estudiantes de posgrado de la Escuela Politécnica Federal de Zúrich lograron, sin que el oído humano se diera cuenta, insertar ciertos datos en composiciones musicales, lo que convierte a la música en un canal para la transmisión de datos. ¿Cómo implementaron exactamente su tecnología, qué tan diferentes son las melodías con y sin los datos insertados, y qué mostraron las pruebas prácticas? De esto aprenderemos en el informe de los investigadores. ¡Vamos!
Base de la investigación
Los investigadores llaman a su tecnología técnica acústica de transmisión de datos. Cuando un altavoz reproduce una melodía modificada, el ser humano la percibe como normal, mientras que, por ejemplo, un smartphone puede leer la información codificada entre líneas, o más precisamente, entre notas, si se puede expresar así. El aspecto más importante en la implementación de este método de transmisión de datos, según los científicos (el hecho de que estos chicos aún sean estudiantes de posgrado no les impide ser científicos), es la velocidad y la fiabilidad de la transmisión, manteniendo el nivel de estos parámetros independientemente del archivo de audio elegido. Afrontar esta tarea se facilita con la psicoacústica, que estudia los aspectos psicológicos y fisiológicos de la percepción humana de los sonidos.
El núcleo de la transmisión acústica de datos se puede denominar OFDM (multiplexión por división de frecuencia ortogonal), que, junto con la adaptación de las portadoras a la música original con el tiempo, permitió maximizar el uso del espectro de frecuencia transmitida para la transmisión de información. Gracias a esto, se logró alcanzar una velocidad de transmisión de 412 bits/s a una distancia de hasta 24 metros (tasa de errores < 10%). Experimentos prácticos con 40 voluntarios confirmaron que es prácticamente imposible escuchar la diferencia entre la melodía original y aquella en la que se ha incrustado la información.
¿Dónde se puede aplicar esta tecnología en la práctica? Los investigadores tienen su propia respuesta: prácticamente todos los smartphones modernos, laptops y otros dispositivos portátiles están equipados con micrófonos, y en muchos lugares públicos (cafés, restaurantes, centros comerciales, etc.) hay altavoces con música de fondo. En esta melodía de fondo se pueden incrustar, por ejemplo, datos para conectarse a la red Wi-Fi sin necesidad de realizar acciones adicionales.
Ahora que hemos aclarado las características generales de la transmisión acústica de datos, pasemos a un estudio detallado de la estructura de este sistema.
Descripción del sistema
La inserción de datos en la melodía se realiza mediante el enmascaramiento de la frecuencia. En intervalos de tiempo, se identifican las frecuencias enmascaradoras, y las portadoras OFDM cercanas a estos elementos enmascaradores se rellenan con datos.
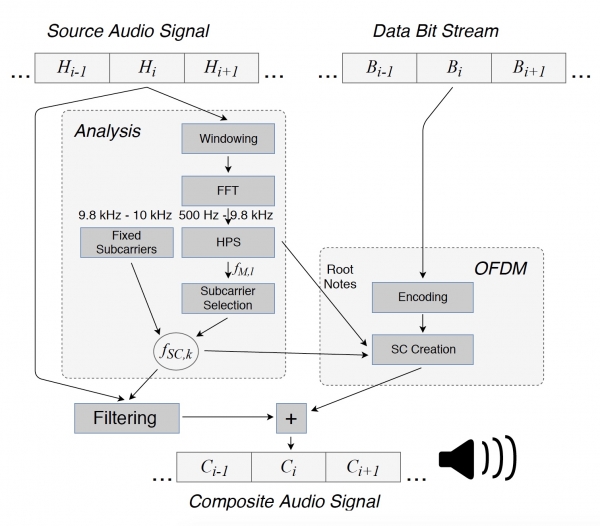
Imagen Nº1: transformación del archivo original en una señal compuesta (melodía + datos), transmitida a través de altavoces.
Primero, la señal de audio original se divide en segmentos secuenciales para su análisis. Cada uno de estos segmentos (Hi) de L = 8820 muestras, equivalente a 200 ms, se multiplica por una ventana* para minimizar los efectos de borde.
Ventana* es una función de peso utilizada para controlar los efectos causados por la presencia de lóbulos laterales en las evaluaciones espectrales.
A continuación, se identificaron las frecuencias dominantes de la señal original en un rango de 500 Hz a 9.8 kHz, lo que permitió obtener las frecuencias de enmascaramiento fM,l para este segmento. Además, se transmitieron datos en un rango reducido de 9.8 a 10 kHz para establecer la ubicación de las portadoras en el receptor. El límite superior de la banda de frecuencias utilizada se fijó en 10 kHz debido a la baja sensibilidad de los micrófonos de los smartphones a altas frecuencias.
Las frecuencias de enmascaramiento se determinaban para cada segmento analizado de manera individual. Mediante el método HPS (espectro armónico de productos) se establecieron tres frecuencias dominantes, que luego se redondearon a las notas más cercanas de la escala cromática armónica. Así se obtuvieron las notas fundamentales fF,i = 1…3, que se encontraban entre las teclas C0 (16.35 Hz) y B0 (30.87 Hz). Dado que las notas fundamentales eran demasiado bajas para su uso en transmisión de datos, se calcularon sus octavas más altas 2kfF,i en el rango de 500 Hz a 9.8 kHz. Muchas de estas frecuencias (fO,l1) se expresaron más debido a la naturaleza del HPS.
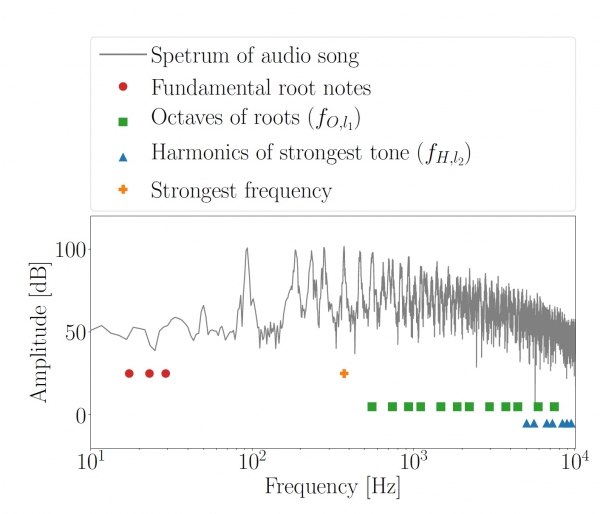
Imagen No. 2: octavas calculadas fO,l1 para las notas fundamentales y armónicas fH,l2 del tono más fuerte.
El conjunto de octavas y armónicas se utilizó como frecuencias de enmascaramiento, a partir de las cuales se obtuvieron las frecuencias de la portadora OFDM fSC,k. Se insertaron dos portadoras por debajo y por encima de cada frecuencia de enmascaramiento.
A continuación, se filtró el espectro del segmento de audio Hi en las frecuencias de las portadoras fSC,k. Después, con base en los bits informativos en Bi, se creó un símbolo OFDM, lo que permitió que el segmento compuesto Ci pudiera transmitirse a través del altavoz. Las magnitudes y fases de las portadoras deben elegirse de manera que el receptor pueda extraer los datos transmitidos, mientras que el oyente no percibe cambios en la melodía.
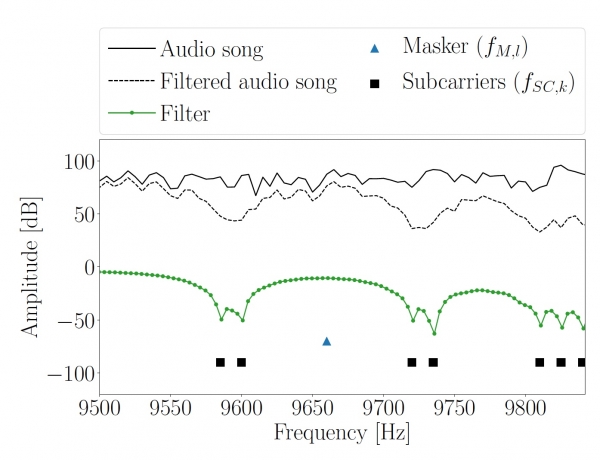
Imagen No. 3: sección del espectro y frecuencias de las portadoras del segmento Hi de la melodía original.
Cuando la señal de audio con la información codificada se reproduce a través de los altavoces, el micrófono del dispositivo receptor la graba. Para encontrar las posiciones iniciales de los símbolos OFDM incorporados, es necesario filtrar la grabación a través de un filtro de paso de banda. De esta manera, se extrae el rango de alta frecuencia, donde no hay señales musicales de interferencia entre las subportadoras. Se puede encontrar el inicio de los símbolos OFDM utilizando un prefijo cíclico.
Después de detectar el inicio de los símbolos OFDM, el receptor recibe información sobre las notas más dominantes mediante la decodificación de la región de alta frecuencia. Además, OFDM es bastante robusto frente a fuentes de interferencia de banda estrecha, ya que estas afectan solo a algunas de las subportadoras.
Pruebas prácticas
El altavoz KRK Rokit 8 fue la fuente de las melodías alteradas, y el smartphone Nexus 5X actuó como el dispositivo receptor.
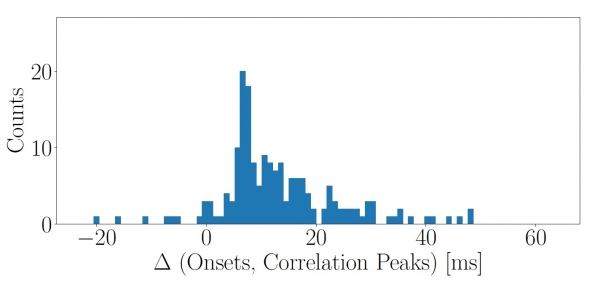
Imagen Nº 4: diferencia entre las manifestaciones reales de OFDM y los picos de correlación medidos dentro de una habitación a 5 m de distancia entre el altavoz y el micrófono.
La mayoría de los puntos OFDM están en el rango de 0 a 25 ms, por lo que se puede encontrar un inicio aceptable dentro del prefijo cíclico de 66.6 ms. Los investigadores señalan que el receptor (en este experimento, un smartphone) considera que los símbolos OFDM se reproducen periódicamente, lo que mejora su detección.
Lo primero que había que comprobar era la influencia de la distancia en la tasa de errores de bits (BER). Para ello se realizaron tres pruebas en diferentes tipos de habitaciones: un pasillo con moqueta, una oficina con linóleo en el suelo y un aula con suelo de madera.
Como 'sujeto de prueba' se eligió la canción 'And The Cradle Will Rock' del grupo Van Halen.
El volumen del sonido se ajustó de manera que el nivel de sonido medido por el smartphone a una distancia de 2 m del altavoz fuera de 63 dB.
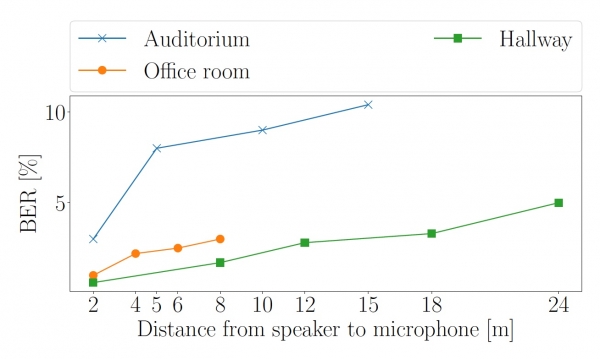
Imagen Nº 5: indicadores de BER en función de la distancia entre el altavoz y el micrófono (la línea azul representa el aula, la verde el pasillo y la naranja la oficina).
En el pasillo, el sonido de 40 dB fue captado por el smartphone a una distancia de hasta 24 metros del altavoz. En el aula, a 15 m, el sonido era de 55 dB, mientras que en la oficina, a 8 metros, el nivel de sonido percibido por el smartphone alcanzaba los 57 dB.
Dado que la audiencia y la oficina son más reverberantes, las señales de eco tardío de los símbolos OFDM exceden la longitud del prefijo cíclico y aumentan el BER.
Reverberación* — disminución gradual de la intensidad del sonido debido a sus múltiples reflexiones.
A continuación, los investigadores demostraron la versatilidad de su sistema aplicándolo a 6 canciones diferentes de tres géneros (tabla a continuación).
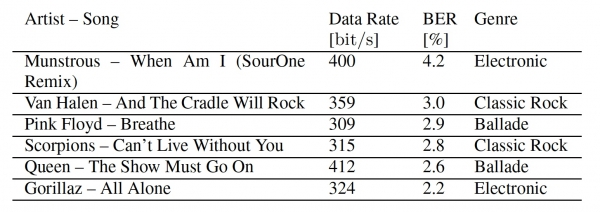
Tabla n.º 1: canciones utilizadas en las pruebas.
Además, a través de los datos en la tabla, podemos ver la velocidad de transmisión y las tasas de error por bit para cada canción. La velocidad de transmisión varía porque el BPSK diferencial (modulación de fase) funciona mejor cuando se utilizan las mismas subportadoras. Esto es posible cuando los segmentos adyacentes contienen los mismos elementos de enmascaramiento. Las canciones continuamente ruidosas proporcionan una base óptima para el ocultamiento de datos, ya que las frecuencias de enmascaramiento están más pronunciadas en un amplio rango de frecuencias. La música de ritmo rápido puede enmascarar los símbolos OFDM solo parcialmente debido a la longitud fija de la ventana de análisis.
A continuación, comenzó a probarse el sistema con personas que debían determinar qué melodía era original y cuál había sido modificada con información insertada. Para ello, se colocaron fragmentos de 12 segundos de las canciones de la tabla n.º 1 en un sitio web especial.
En el primer experimento (E1), a cada participante se le proporcionó un fragmento modificado o uno original para escuchar, y debía decidir si este fragmento era original o modificado. En el segundo experimento (E2), los participantes podían escuchar ambas versiones tantas veces como desearan, y luego decidir cuál de ellas era la original y cuál la modificada.
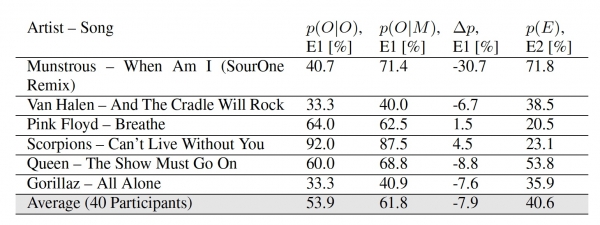
Tabla n.º 2: resultados de los experimentos E1 y E2.
Los resultados de la primera experiencia tienen dos indicadores: p(O|O) — porcentaje de participantes que identificaron correctamente la melodía original y p(O|M) — porcentaje de participantes que identificaron la versión modificada de la melodía como original.
Es curioso que algunos participantes, según los investigadores, consideraron que ciertas melodías modificadas eran más originales que la original misma. La media de ambos experimentos sugiere que el oyente promedio no notaría la diferencia entre una melodía normal y una en la que se han incrustado los datos.
Naturalmente, los conocedores de música y los músicos podrán detectar algunas imprecisiones y elementos sospechosos en las melodías modificadas, pero estos elementos no son tan significativos como para causar incomodidad.
Ahora, nosotros mismos podemos participar en el experimento. A continuación, se presentan dos versiones de la misma melodía: la original y la modificada. ¿Escuchas la diferencia?
vs
Para un conocimiento más detallado de las sutilezas de la investigación, recomiendo echar un vistazo a del grupo de investigación.
También puedes descargar el archivo ZIP con los archivos de audio de las melodías originales y modificadas utilizadas en el estudio, desde .
Epílogo
En este trabajo, los estudiantes de postgrado de la Escuela Politécnica Federal de Zúrich describieron un sorprendente sistema de transmisión de datos dentro de la música. Para ello, aplicaron el enmascaramiento de frecuencia, lo que permitió incrustar datos en la melodía reproducida por un altavoz. Esta melodía es percibida por el micrófono del dispositivo, que reconoce los datos ocultos y los decodifica, mientras que el oyente promedio no notará la diferencia. En el futuro, planean desarrollar su sistema, buscando métodos más avanzados para incrustar datos en el audio.
Siempre nos alegra cuando alguien inventa algo inusual, y lo más importante, funcional. Pero aún más alegría es que este invento haya sido creado por jóvenes. La ciencia no tiene límites de edad. Y si los jóvenes consideran que la ciencia es aburrida, significa que la están presentando desde un ángulo equivocando, por así decirlo. Porque, como sabemos, la ciencia es un mundo sorprendente que nunca deja de asombrar.
Off-topic del viernes:
Ya que hemos hablado de música, más específicamente de rock, aquí tienes un hermoso viaje por los confines del rock.
Queen, «Radio Ga Ga» (1984).
¡Gracias por su atención, sigan siendo curiosos y les deseo un excelente fin de semana, chicos! 🙂
Gracias por seguir con nosotros. ¿Te gustan nuestros artículos? ¿Quieres ver más material interesante? Apóyanos realizando un pedido o recomendándonos a tus conocidos, 30% de descuento para los usuarios de Habr en una alternativa única a los servidores de nivel de entrada, que hemos diseñado para usted: (disponibles opciones con RAID1 y RAID10, hasta 24 núcleos y hasta 40GB DDR4).
¿Dell R730xd a la mitad de precio? Solo aquí ¡en los Países Bajos! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — ¡desde $99! Lee sobre cómo
Fuente: habr.com
