

Parte dos:
Cualquier imagen rasterizada se puede representar como una matriz bidimensional . Cuando se habla de colores, se puede desarrollar la idea considerando la imagen como unamatriz tridimensional , donde dimensiones adicionales se utilizan para almacenar datos sobre cada uno de los colores.Si consideramos el color final como una combinación de los llamados colores primarios (rojo, verde y azul), en nuestra matriz tridimensional definimos tres planos: el primero para el rojo, el segundo para el verde y el último para el azul.
Llamaremos a cada punto en esta matriz un píxel (elemento de la imagen). Cada píxel contiene información sobre la intensidad (generalmente en forma de valor numérico) de cada color. Por ejemplo,
un píxel rojo significa que contiene 0 de color verde, 0 de color azul y el máximo de rojo. Un píxel de color rosa puede ser formado mediante una combinación de los tres colores. Usando un rango numérico de 0 a 255, un píxel rosa se define como Rojo = 255 Verde = 192, Azul = 203 y El artículo fue publicado con el apoyo de la empresa EDISON..
Desarrollamosaplicaciones para videovigilancia, video en streaming , así como .
Para representar los colores que componen una imagen, hay muchos otros modelos disponibles. Por ejemplo, se puede utilizar una paleta indexada, donde solo se requiere un byte para representar cada píxel, en lugar de los tres necesarios al usar el modelo RGB. En tal modelo se puede usar una matriz 2D en lugar de una matriz 3D para representar cada color. Esto ahorra memoria, pero ofrece una gama de colores más limitada.
RGB
Por ejemplo, observe esta imagen a continuación. La primera cara está completamente coloreada. Las otras son los planos rojo, verde y azul (la intensidad de los colores correspondientes se muestra en escala de grises).
Podemos ver que los matices de rojo en el original estarán en los mismos lugares donde se observan las partes más brillantes de la segunda cara. Mientras que la contribución del color azul se puede ver principalmente solo en los ojos de Mario (la última cara) y en elementos de su vestimenta. Tenga en cuenta dónde las tres capas de color contribuyen menos (las partes más oscuras de las imágenes): esto es en los bigotes de Mario.
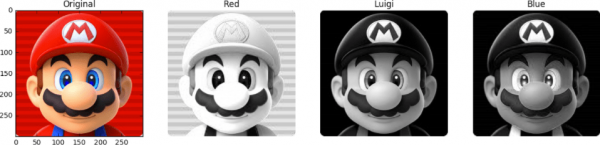
Observamos que los matices de rojo en el original estarán en los mismos lugares donde se observan las partes más brillantes del segundo personaje. Mientras que la contribución del color azul se puede ver principalmente solo en los ojos de Mario (el último personaje) y en los elementos de su vestimenta. Presta atención a dónde las tres superficies de color aportan menos (las partes más oscuras de las imágenes): esto está en los bigotes de Mario.
Para almacenar la intensidad de cada color se requiere una cierta cantidad de bits, esta cantidad se llama profundidad de bits. Supongamos que se utilizan 8 bits (basado en un valor entre 0 y 255) para un solo plano de color. Entonces tenemos una profundidad de color de 24 bits (8 bits * 3 planos R/G/B).
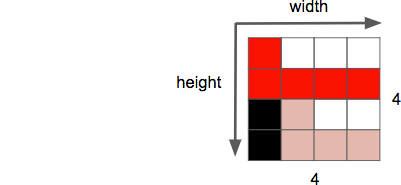
Otra propiedad de la imagen es la resolución, que representa la cantidad de píxeles en una dimensión. A menudo se indica como ancho × alto, como se muestra a continuación en la imagen de ejemplo 4 por 4.
Otra propiedad que tratamos al trabajar con imágenes/video es la relación de aspecto, que describe la relación proporcional típica entre el ancho y la altura de la imagen o del píxel.
Cuando se dice que una película o imagen tiene un tamaño de 16 por 9, generalmente se refiere a la relación de aspecto de la pantalla (DAR — de Display Aspect Ratio). Sin embargo, a veces pueden haber diferentes formas para píxeles individuales; en este caso se habla de la relación de píxeles (PAR — de Pixel Aspect Ratio).
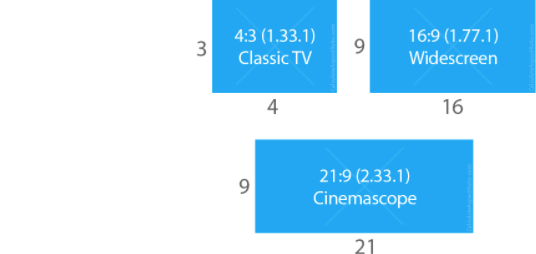
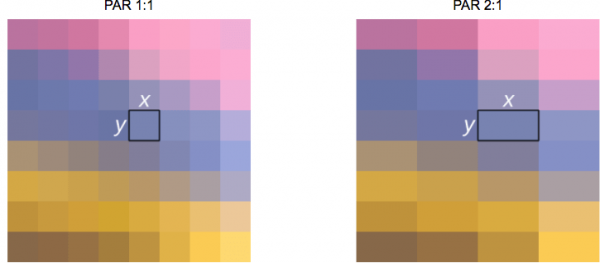
Consejo para la ama de casa: DVD corresponde a DAR 4 por 3
Aunque la resolución real de DVD es de 704×480, mantiene una relación de aspecto de 4:3, ya que el PAR es 10:11 (704×10 / 480×11).
Y, por último, podemos definir videos como una secuencia de n fotogramas en un periodo de tiempo, que puede considerarse como una dimensión adicional. Entonces, eso es la frecuencia de fotogramas o el número de fotogramas por segundo ( n FPSFrames per Second — de La cantidad de bits por segundo necesaria para mostrar video es su).
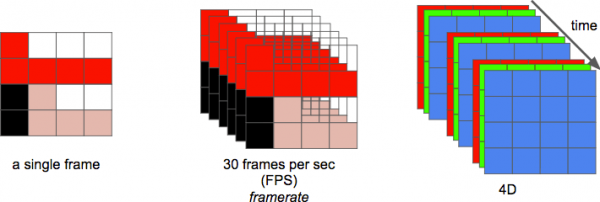
tasa de transmisión bitrate — bitrate = ancho * altura * profundidad de bits * fotogramas por segundo.
Por ejemplo, para un video a 30 fotogramas por segundo, 24 bits por píxel, con una resolución de 480×240 se requerirán 82,944,000 bits por segundo o 82,944 Mbps (30x480x240x24) — pero esto es sin aplicar ningún método de compresión.
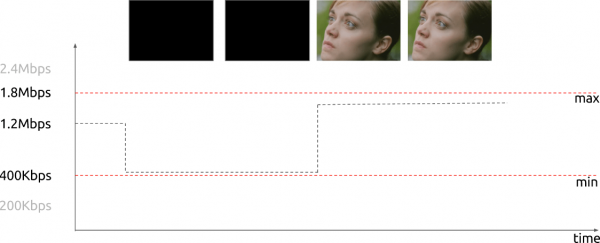
Si la tasa de transmisión
es casi constante , se llamatasa de transmisión constante CBR (constant bit rate — de ). Pero también puede variar, en ese caso se llamatasa de transmisión variable VBR (variable bit rate — de Este gráfico muestra un VBR limitado, cuando se utilizan no demasiados bits en el caso de un fotograma completamente negro.).
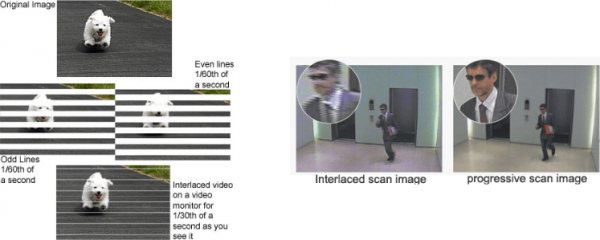
Inicialmente, los ingenieros desarrollaron un método para duplicar la frecuencia de fotogramas percibida en la pantalla de video sin utilizar ancho de banda adicional. Este método es conocido como
video entrelazado video entrelazadoPrincipalmente, envía la mitad de la pantalla en el primer "cuadro", y la otra mitad en el siguiente "cuadro".
Actualmente, la visualización de escenas se realiza principalmente utilizando tecnología de escaneo progresivo.Es un método de visualización, almacenamiento o transmisión de imágenes en movimiento, en el que todas las líneas de cada cuadro se dibujan secuencialmente.
¡Bien! Ahora sabemos cómo se representa una imagen en forma digital, cómo se organizan sus colores, cuántos bits por segundo gastamos para mostrar video, ya sea con una tasa de bits constante (CBR) o variable (VBR). Conocemos la resolución establecida utilizando una frecuencia de cuadros determinada, y hemos aprendido muchos otros términos, como video entrelazado, PAR y otros.
Eliminación de redundancias.
Es conocido que el video sin compresión no es utilizables. Un video de una hora con resolución 720p y 30 cuadros por segundo ocuparía 278 GB. Este valor se obtiene multiplicando 1280 x 720 x 24 x 30 x 3600 (anchura, altura, bits por píxel, FPS y tiempo en segundos).
Uso algoritmos de compresión sin pérdida, como DEFLATE (utilizado en PKZIP, Gzip y PNG), no proporciona una reducción suficiente en el ancho de banda requerido. Por lo tanto, hay que buscar otras formas de comprimir video.
Para esto, se pueden utilizar las características de nuestra visión. Nosotros diferenciamos mejor la luminosidad que los colores. El video es un conjunto de imágenes secuenciales que se repiten con el tiempo. Las diferencias entre cuadros adyacentes de una misma escena son pequeñas. Además, cada cuadro contiene muchas áreas que utilizan el mismo (o similar) color.
Color, luminosidad y nuestros ojos.
Nuestros ojos son más sensibles a la luminosidad que al color. Puedes comprobarlo tú mismo mirando esta imagen.
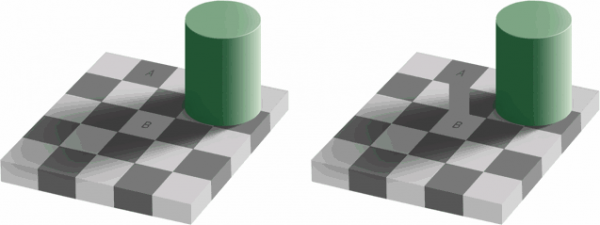
Si no ves que en la mitad izquierda de la imagen los colores de los cuadros A y B son en realidad idénticos, está bien. Nuestro cerebro nos hace prestar más atención a la luz y sombra, que al color. A la derecha, entre los cuadros marcados hay un puente del mismo color, por lo que nosotros (es decir, nuestro cerebro) determinamos fácilmente que, en realidad, ahí hay un mismo color.
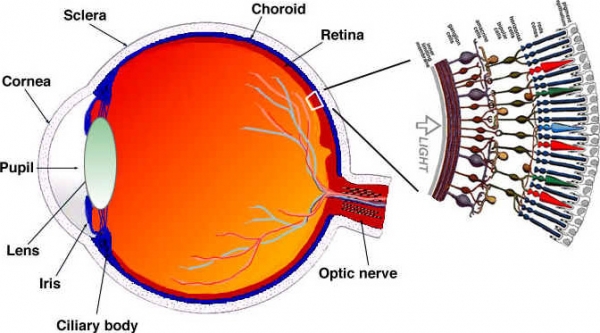
Veamos (simplificadamente) cómo funcionan nuestros ojos. El ojo es un órgano complejo, compuesto por muchas partes. Sin embargo, lo que más nos interesa son los conos y los bastones. El ojo contiene alrededor de 120 millones de bastones y 6 millones de conos.
Consideremos la percepción del color y el brillo como funciones separadas de ciertas partes del ojo (en realidad, es algo más complejo, pero lo simplificaremos). Las células de los bastones, en su mayor parte, son responsables del brillo, mientras que las células de los conos se encargan del color. Los conos se dividen en tres tipos, según el pigmento que contienen: conos S (color azul), conos M (color verde) y conos L (color rojo).
Dado que tenemos muchas más células de los bastones (brillo) que de los conos (color), se puede concluir que somos más capaces de distinguir transiciones entre la oscuridad y la luz que entre colores.
Funciones de sensibilidad al contraste
Investigadores de la psicología experimental y de muchos otros campos han desarrollado numerosas teorías sobre la visión humana. Y una de ellas se llama funciones de sensibilidad al contraste. Están relacionadas con la iluminación espacial y temporal. En resumen, se trata de cuántos cambios son necesarios para que el observador los note. Nota que la palabra 'función' está en plural. Esto se debe a que podemos medir las funciones de sensibilidad al contraste no solo hacia imágenes en blanco y negro, sino también hacia imágenes en color. Los resultados de estos experimentos muestran que, en la mayoría de los casos, nuestros ojos son más sensibles al brillo que al color.
Dado que sabemos que somos más sensibles al brillo de la imagen, se puede intentar utilizar este hecho.
Modelo de color
Hemos aprendido un poco sobre cómo trabajar con imágenes en color, utilizando el esquema RGB. Existen otros modelos. Hay un modelo que separa el brillo de la cromaticidad y se conoce como YCbCr. Por cierto, hay otros modelos que hacen una separación similar, pero solo consideraremos este.
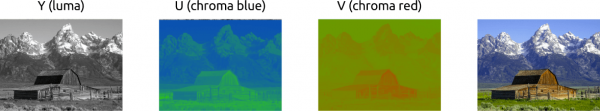
En este modelo de color Y — representa el brillo, y se utilizan dos canales de color: Cb (azul saturado) y Cr (rojo intenso). YCbCr se puede obtener de RGB, así como también es posible la conversión inversa. Usando este modelo, podemos crear imágenes a todo color, como se ve a continuación:
Conversión entre YCbCr y RGB
Alguien objetará: ¿cómo es posible obtener todos los colores si no se utiliza el verde?
Para responder a esta pregunta, convertiremos RGB a YCbCr. Usaremos los coeficientes establecidos en la norma BT.601, que fue recomendada por la división ITU-R. Esta división define los estándares para video digital. Por ejemplo: ¿qué es 4K? ¿Cuáles deberían ser la tasa de fotogramas, la resolución, el modelo de color?
Primero, calcularemos el brillo. Usaremos las constantes propuestas por la UIT y sustituiremos los valores de RGB.
Y = 0.299R + 0.587G + 0.114B
Después de obtener el brillo, separaremos el color azul y rojo:
Cb = 0.564(B — Y)
Cr = 0.713(R — Y)
Y también podemos convertirlo de nuevo e incluso obtener verde usando YCbCr:
R = Y + 1.402Cr
B = Y + 1.772Cb
G = Y — 0.344Cb — 0.714Cr
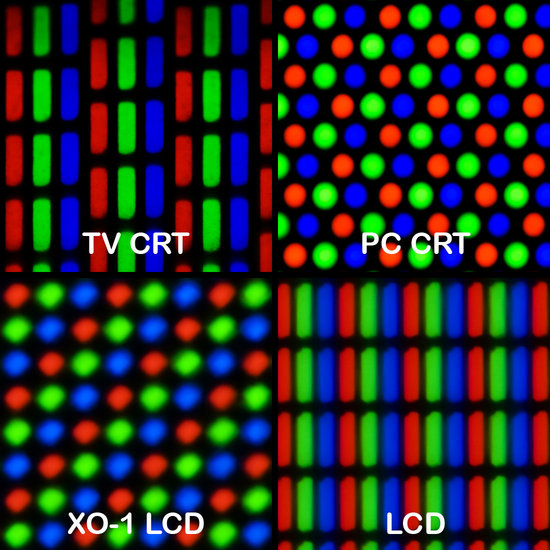
Por lo general, las pantallas (monitores, televisores, pantallas, etc.) utilizan solo el modelo RGB. Pero este modelo puede organizarse de diferentes maneras:
Submuestreo de color
Con la imagen representada como una combinación de brillo y cromaticidad, podemos aprovechar la mayor sensibilidad del sistema visual humano al brillo que a la cromaticidad si eliminamos selectivamente información. La submuestreo de color es un método de codificación de imágenes que utiliza menor resolución para la cromaticidad que para el brillo.
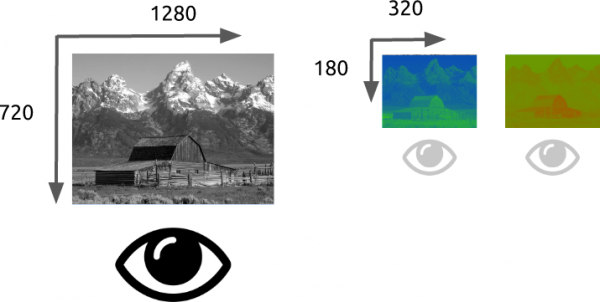
¿Cuánto se puede reducir la resolución de cromaticidad? ¡Resulta que ya existen algunos esquemas que describen cómo manejar la resolución y la fusión (Color final = Y + Cb + Cr).
Estos esquemas son conocidos como sistemas de submuestreo y se expresan en forma de una relación de 3 a 1 — a:x:y, que determina el número de muestras de señal de luminancia y de diferencia de color.
a — estándar de muestreo horizontal (generalmente igual a 4)
x — número de muestras de cromaticidad en la primera fila de píxeles (resolución horizontal en relación a a)
y — número de cambios en las muestras de cromaticidad entre la primera y segunda fila de píxeles.
La excepción es 4:1:0, que proporciona una muestra de cromaticidad en cada bloque de resolución de luminancia 4 por 4.
Los esquemas comunes utilizados en los códecs modernos:
- 4:4:4 (sin submuestreo)
- 4:2:2
- 4:1:1
- 4:2:0
- 4:1:0
- 3:1:1
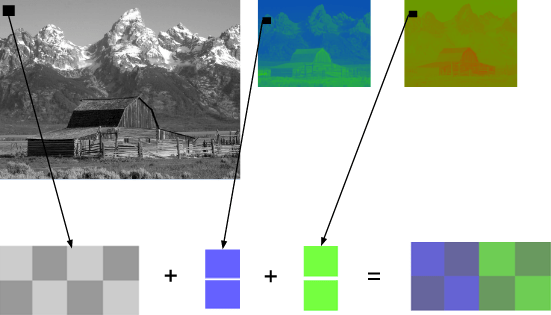
YCbCr 4:2:0 — un ejemplo de fusión
Este es un fragmento de imagen combinado utilizando YCbCr 4:2:0. Tenga en cuenta que solo usamos 12 bits por píxel.
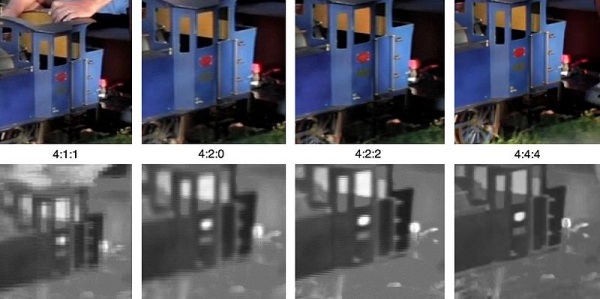
Así es como se ve la misma imagen codificada en los principales tipos de subsampled de color. La primera fila es el YCbCr final, la fila inferior muestra la resolución del color. Resultados bastante decentes, considerando las pequeñas pérdidas de calidad.
¿Recuerdas que contabilizamos 278 GB de espacio en disco para almacenar un archivo de video de una hora de duración con una resolución de 720p y 30 cuadros por segundo? Si utilizamos YCbCr 4:2:0, entonces este tamaño se reducirá a la mitad: 139 GB. Aún estamos lejos de un resultado aceptable.
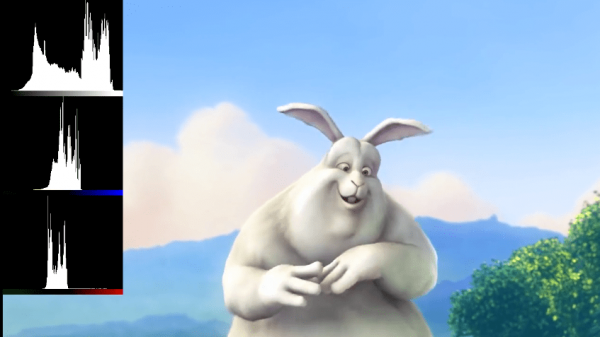
Puedes obtener un histograma YCbCr por ti mismo utilizando FFmpeg. En esta imagen, el azul predomina sobre el rojo, lo cual es evidente en el propio histograma.
Colorimetría, brillo, gama de colores — video reseña
Te recomiendo ver este increíble video. Aquí se explica qué es el brillo y se aclaran todos los puntos sobre el brillo y el color. Tipos de cuadros
Sigamos adelante. Intentaremos eliminar la redundancia temporal. Pero primero, definamos cierta terminología básica. Supongamos que tenemos una película con 30 cuadros por segundo, aquí están sus primeros 4 cuadros:
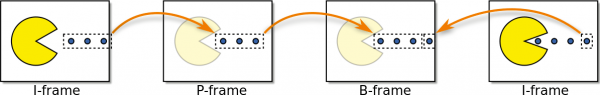
Podemos ver muchas repeticiones en los cuadros: por ejemplo, un fondo azul que no cambia de cuadro a cuadro. Para abordar este problema, podemos clasificar abstractamente los cuadros en tres tipos.


Cuadro I (
ntro Frame)IEl cuadro I (cuadro clave, cuadro de referencia, cuadro interno) es autónomo. Independientemente de lo que se necesite visualizar, un cuadro I es, en esencia, una fotografía estática. El primer cuadro suele ser un cuadro I, sin embargo, vamos a observar regularmente cuadros I incluso entre los que no son los primeros.
Cuadro P (

redicted Frame)PEl cuadro P (cuadro predecido) aprovecha el hecho de que casi siempre la imagen actual puede ser reproducida utilizando el cuadro anterior. Por ejemplo, en el segundo cuadro, el único cambio es el balón que se mueve hacia adelante. Podemos obtener el cuadro 2 simplemente modificando un poco el cuadro 1, utilizando solo la diferencia entre estos cuadros. Para construir el cuadro 2, nos referimos al cuadro anterior, el cuadro 1.
←
 Cuadro B (

i-predictive Frame)Bi-predictive Frame
¿Y qué pasa con los enlaces no solo a los cuadros pasados, sino también a los futuros, para asegurar una compresión aún mejor? Eso es, en esencia, el cuadro B (cuadro bidireccional).
 Cuadro B (
 →

Salida intermedia
Estos tipos de cuadros se utilizan para garantizar la mejor compresión. Veremos cómo sucede esto en la siguiente sección. Por ahora, señalemos que el tipo que consume más memoria es el cuadro I, el cuadro P es significativamente más barato y el más rentable para el video es el cuadro B.
Redundancia temporal (pronóstico entre cuadros)
Veamos qué posibilidades tenemos para minimizar las repeticiones en el tiempo. Este tipo de redundancia se resolverá mediante métodos de pronóstico mutuo.
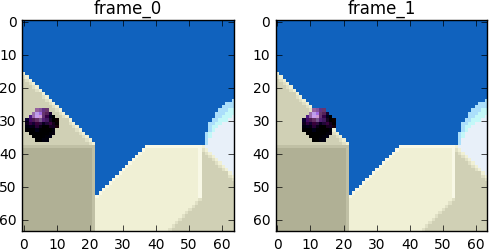
Intentaremos gastar la menor cantidad posible de bits para codificar la secuencia de cuadros 0 y 1.
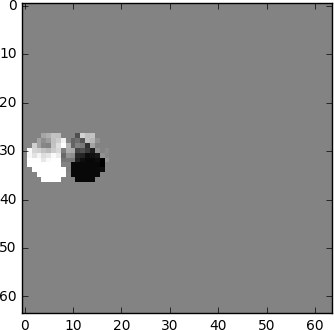
Podemos realizar sustracción, simplemente restamos el cuadro 1 del cuadro 0. Obtenemos el cuadro 1, usando solo la diferencia entre él y el cuadro anterior, pero en realidad codificamos solo el residuo resultante.
¿Pero qué pasa si te digo que existe un método aún mejor que utiliza aún menos bits? Primero, dividamos el cuadro 0 en una rejilla clara compuesta de bloques. Luego intentemos emparejar bloques del cuadro 0 con el cuadro 1. En otras palabras, evaluemos el movimiento entre los cuadros.
De Wikipedia — compensación de movimiento por bloques
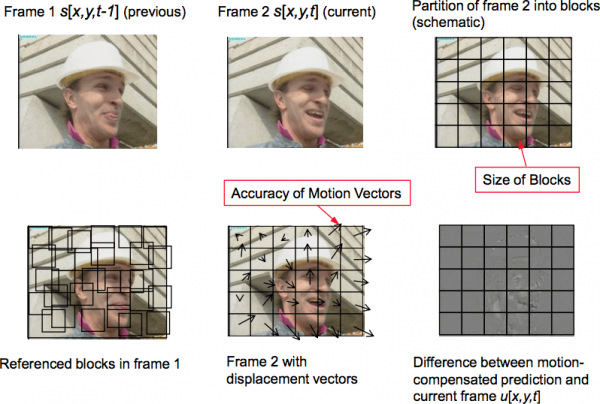
La compensación de movimiento por bloques divide el cuadro actual en bloques no superpuestos y el vector de compensación de movimiento señala el origen de los bloques (un error común es pensar que el cuadro anterior se divide en bloques no superpuestos y los vectores de compensación de movimiento indican a dónde se mueven esos bloques. En realidad, es al revés: no se analiza el cuadro anterior, sino el siguiente, y se determina de dónde aparecieron los bloques, no a dónde se trasladan). Normalmente, los bloques originales se superponen en el cuadro original. Algunos algoritmos de compresión de video ensamblan el cuadro actual a partir de partes de varios cuadros previamente transmitidos.
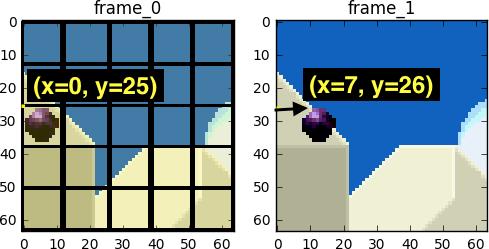
En el proceso de evaluación, observamos que la esfera se ha movido de (x=0, y=25) a (x=6, y=26), valores x y y definen la dirección del movimiento. Otro paso que podemos dar para conservar bits es codificar solo la diferencia entre los vectores de movimiento entre la última posición del bloque y la proyectada, por lo que el vector final de movimiento será (x=6-0=6, y=26-25=1).
En una situación real, esta bola se dividiría en n bloques, pero esto no cambia el sentido del asunto.
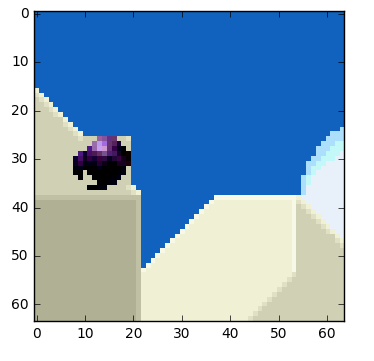
Los objetos en el marco se mueven en tres dimensiones, por lo que al mover la bola puede parecer visualmente más pequeña (o más grande si se mueve hacia el espectador). Es normal que no haya una coincidencia perfecta entre los bloques. Aquí está la vista combinada de nuestra estimación y la imagen real.
Pero vemos que cuando aplicamos la estimación de movimiento, los datos para codificar son notablemente menores que al usar un método más simple que calcula la delta entre cuadros.
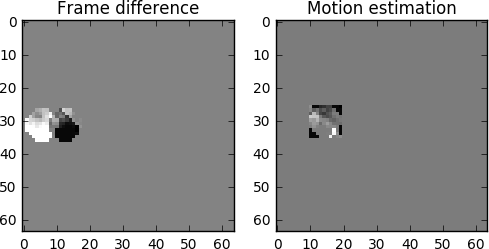
¿Cómo se vería la compensación de movimiento real?
Esta técnica se aplica a todos los bloques a la vez. A menudo, nuestra bola en movimiento condicional se dividirá en varios bloques al mismo tiempo.
Puedes tocar estas ideas tú mismo, usando .
Para ver los vectores de movimiento, se puede crear un video con una predicción externa usando .
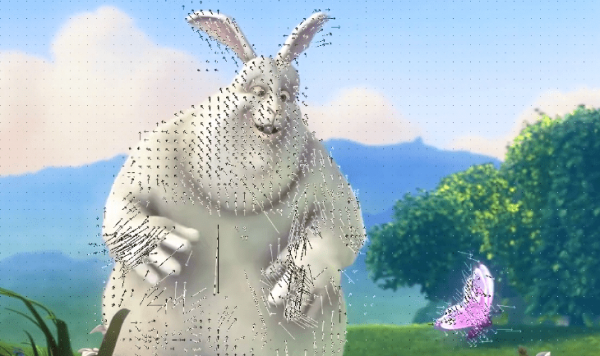
También se puede utilizar (es de pago, pero hay una versión de prueba gratuita que está limitada solo a los primeros diez cuadros).
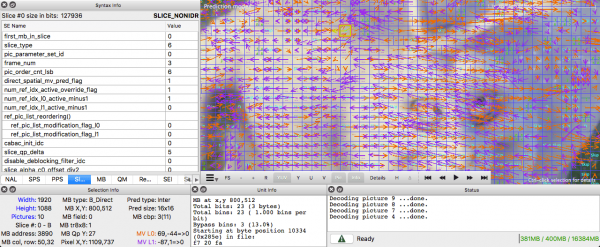
Redundancia espacial (predicción interna)
Si analizamos cada cuadro en el video, encontraremos muchas áreas interrelacionadas.
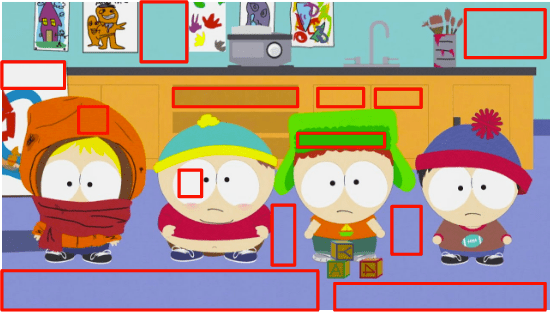
Veamos este ejemplo. Esta escena consiste principalmente en colores azul y blanco.
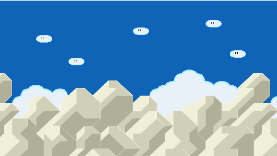
Este es el cuadro I. No podemos usar los cuadros anteriores para la predicción, pero podemos comprimirlo. Codificaremos la selección del bloque rojo. Si miramos a sus vecinos, notamos que alrededor de él hay algunas tendencias de color.
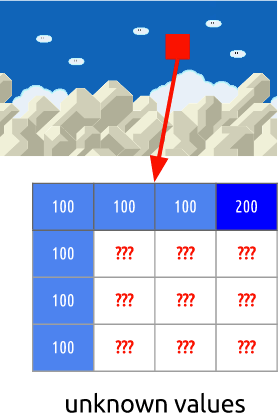
Suponemos que los colores en el cuadro se distribuyen verticalmente. Lo que significa que el color de los píxeles desconocidos contendrá valores de sus vecinos.
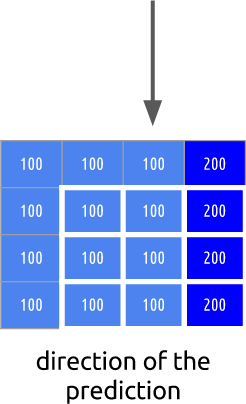
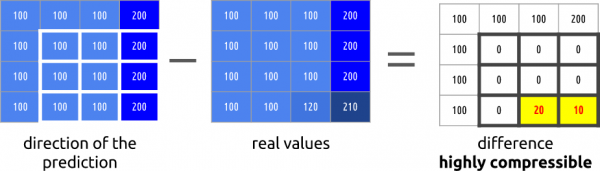
Tal predicción puede ser incorrecta. Por esta razón, es necesario aplicar este método (predicción interna) y luego restar los valores reales. Esto nos dará un bloque residual, lo que llevará a una matriz mucho más comprimida en comparación con el original.
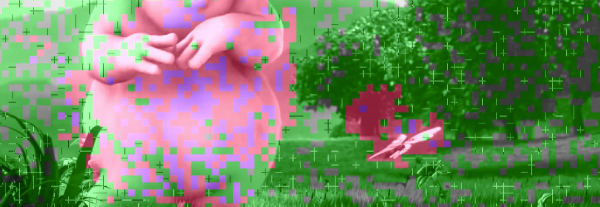
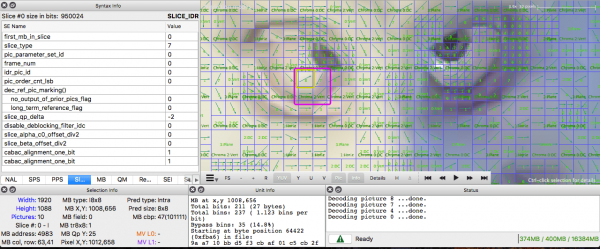
Si quieres practicar con predicciones internas, puedes crear un video con los macrobloques y sus predicciones utilizando ffmpeg. Para entender el significado de cada color de bloque, será necesario revisar la documentación de ffmpeg.
O también puedes utilizar Intel Video Pro Analyzer (como mencioné anteriormente, la versión de prueba gratuita tiene un límite en los primeros 10 fotogramas, pero esto será suficiente al principio).
Parte dos:
Fuente: habr.com
