

Primera parte:
¿Qué? Un códec de video es una parte del software/hardware que comprime y/o descomprime video digital.
¿Para qué? A pesar de ciertas limitaciones tanto en ancho de banda como
en la cantidad de espacio de almacenamiento, el mercado exige videos de mayor calidad. ¿Recuerdas cómo en la publicación anterior calculamos el mínimo necesario para 30 cuadros por segundo, 24 bits por píxel, con una resolución de 480×240? Obtuvimos 82,944 Mbps sin compresión. La compresión es hasta ahora la única forma de transmitir HD/FullHD/4K a pantallas de televisión e Internet. ¿Cómo se logra esto? Ahora revisaremos brevemente los métodos principales.
La traducción se realizó con el apoyo de EDISON Software.Nos dedicamos a , así como .
Códec vs Contenedor
Un error común entre principiantes es confundir un códec de video digital con un contenedor de video digital. Un contenedor es un formato. Una envoltura que contiene metadatos del video (y, posiblemente, audio). El video comprimido puede considerarse como la carga útil del contenedor.
Normalmente, la extensión del archivo de video indica su tipo de contenedor. Por ejemplo, el archivo video.mp4 es probablemente un contenedor MPEG-4 Parte 14, y un archivo llamado video.mkv es, probablemente, . Para estar completamente seguro del códec y del formato del contenedor, se puede utilizar o .
Un poco de historia
Antes de pasar a ¿Cómo?, profundicemos un poco en la historia para entender un poco mejor algunos códecs antiguos.
Códec de video H.261 apareció en 1990 (técnicamente, en 1988) y fue creado para funcionar a velocidades de transmisión de 64 Kbps. Ya usaba ideas como submuestreo de color, macro-bloques, etc. En 1995 se publicó el estándar del códec de video H.263, que se desarrolló hasta 2001.
En 2003 se completó la primera versión de H.264/AVC. Ese mismo año, la empresa 'TrueMotion' lanzó su códec de video gratuito que comprime video con pérdida llamado VP3. En 2008, Google compró esta empresa, lanzando VP8 el mismo año. En diciembre de 2012, Google lanzó VP9, y se admite en aproximadamente ¾ del mercado de navegadores (incluyendo dispositivos móviles).
AV1 es un nuevo códec de video gratuito y de código abierto, desarrollado por la Alianza por Medios Abiertos (AOMedia), que incluye compañías tan reconocidas como: Google, Mozilla, Microsoft, Amazon, Netflix, AMD, ARM, NVidia, Intel y Cisco. La primera versión del códec 0.1.0 fue publicada el 7 de abril de 2016.
El nacimiento de AV1
A principios de 2015, Google trabajaba en VP10, Xiph (que pertenece a Mozilla) trabajaba en Daala, y Cisco desarrolló su códec de video gratuito llamado Thor.
Luego MPEG LA anunció inicialmente límites anuales para HEVC (H.265) y una tarifa, que era 8 veces mayor que la de H.264, pero pronto cambiaron las reglas nuevamente:
sin límite anual,
una tarifa por contenido (0,5% de los ingresos) y
una tarifa por unidad de producto aproximadamente 10 veces mayor que la de H.264.
La Alianza por Medios Abiertos fue creada por empresas de diferentes sectores: fabricantes de hardware (Intel, AMD, ARM, Nvidia, Cisco), proveedores de contenido (Google, Netflix, Amazon), creadores de navegadores (Google, Mozilla) y otros.
Las empresas tenían un objetivo común: un códec de video sin regalías. Luego aparece AV1 con una licencia de patente mucho más simple. Timothy B. Terriberry hizo una presentación sorprendente que se convirtió en la fuente del concepto actual de AV1 y su modelo de licencia.
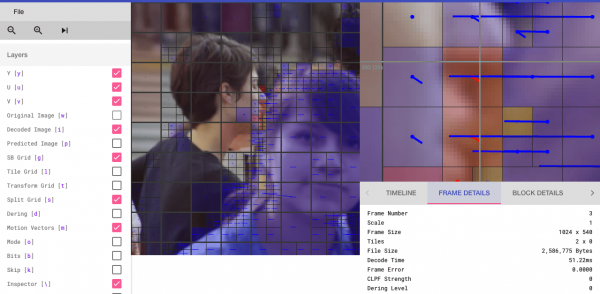
Te sorprenderá saber que se puede analizar el códec AV1 a través de un navegador (los interesados pueden visitar).
Códec universal
Analizaremos los mecanismos principales que subyacen al códec de video universal. La mayoría de estos conceptos son útiles y se utilizan en códecs modernos como VP9, AV1 y HEVC. Advierto que muchas de las explicaciones se simplificarán. A veces se usarán ejemplos reales (como en el caso de H.264) para demostrar las tecnologías.
Paso 1: división de la imagen
El primer paso es dividir el cuadro en varias secciones, subsecciones y así sucesivamente.
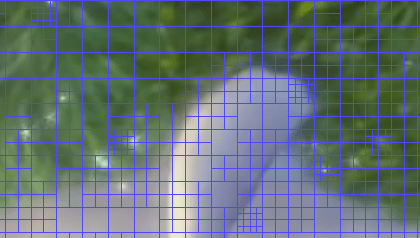
¿Para qué? Hay muchas razones. Al romper la imagen, se puede predecir con mayor precisión el vector de movimiento, utilizando secciones pequeñas para partes móviles pequeñas. Mientras que para el fondo estático, se pueden utilizar secciones más grandes.
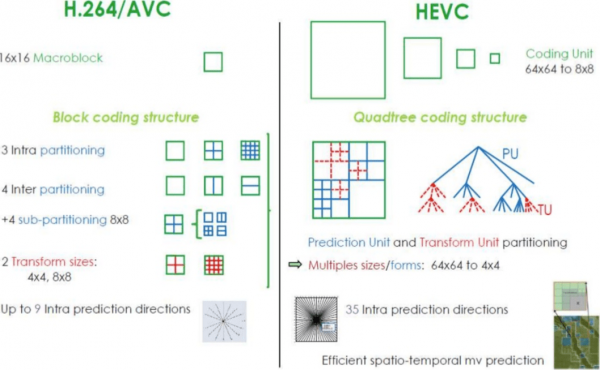
Normalmente, los códecs organizan estas secciones en secciones (o fragmentos), macros bloques (o bloques de árbol de codificación) y múltiples subsecciones. El tamaño máximo de estas secciones varía, HEVC establece 64×64, mientras que AVC utiliza 16×16, y las subsecciones pueden reducirse a tamaños de 4×4.
¿Recuerdas las variedades de cuadros del artículo anterior? ¡Esto también se puede aplicar a los bloques, por lo que podemos tener un fragmento I, un bloque B, un macrobloque P, etc.
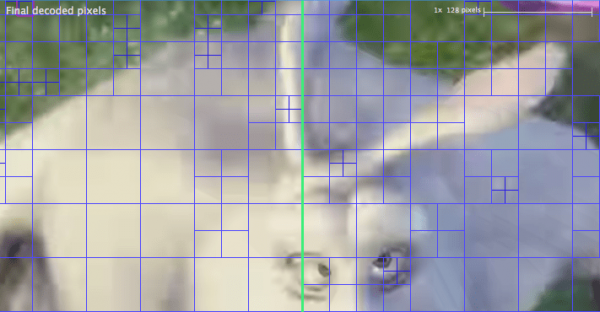
Para aquellos que deseen practicar, vean cómo se descompone la imagen en secciones y subsecciones. Para esto, se puede usar lo ya mencionado en el artículo anterior. (el de pago, pero con una versión de prueba gratuita, que tiene una limitación en los primeros 10 cuadros). Aquí se analizaron las secciones. VP9:
Paso 2 — Predicción
Una vez que tenemos las secciones, podemos formular predicciones astrológicas sobre ellas. Para la predicción INTER es necesario transmitir los vectores de movimiento y el residuo, mientras que para la predicción INTRA se transmite la dirección de la predicción y el residuo.
Paso 3 — Transformación
Después de obtener el bloque residual (sección predicha → sección real), es posible transformarlo de tal manera que se sepa qué píxeles se pueden descartar, manteniendo la calidad general. Hay algunas transformaciones que aseguran un comportamiento preciso.
Aunque hay otros métodos, hablemos más a fondo de la transformación discreta del coseno (DCT — de transformada discreta del coseno). Funciones principales de DCT:
- Transforma bloques de píxeles en bloques de coeficientes de frecuencia de tamaño uniforme.
- Compacta la potencia, ayudando a eliminar la redundancia espacial.
- Proporciona reversibilidad.
El 2 de febrero de 2017, Cintra R.J. y Bayer F.M. publicaron un artículo sobre una transformación similar a DCT para la compresión de imágenes, que requiere solo 14 adiciones.
No te preocupes si no entendiste las ventajas de cada punto. Ahora, con ejemplos concretos, comprobaremos su valor real.
Tomemos un bloque de píxeles de 8×8:
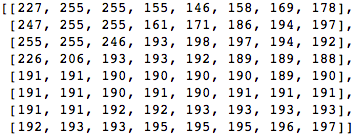
Este bloque se renderiza en la siguiente imagen de 8 por 8 píxeles:
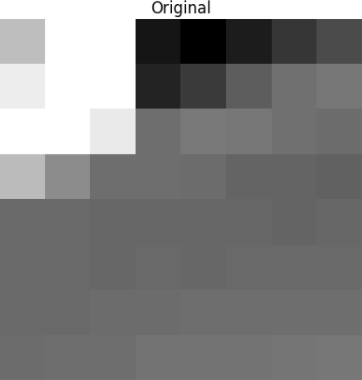
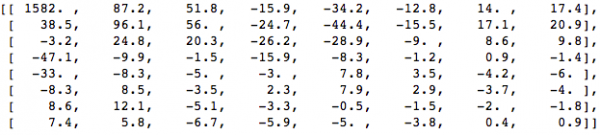
Aplicamos DCT a este bloque de píxeles y obtenemos un bloque de coeficientes de 8×8:
Y si renderizamos este bloque de coeficientes, obtendremos esta imagen:
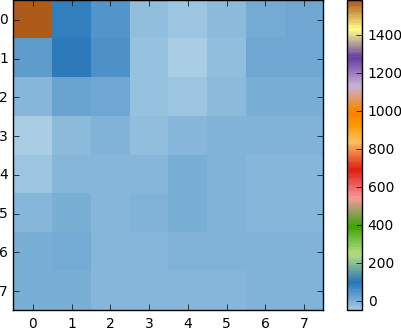
Como podemos ver, esto no se parece a la imagen original. Se puede notar que el primer coeficiente es muy diferente de los demás. Este primer coeficiente se conoce como el coeficiente DC, que representa todas las muestras en la matriz de entrada, algo parecido a un promedio.
Este bloque de coeficientes tiene una propiedad interesante: separa los componentes de alta frecuencia de los de baja frecuencia.
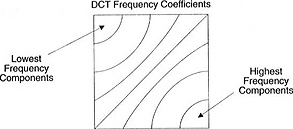
En la imagen, la mayor parte de la potencia está concentrada en frecuencias más bajas, por lo que, si convertimos la imagen en sus componentes de frecuencia y desechamos los coeficientes de alta frecuencia, podemos reducir la cantidad de datos necesarios para describir la imagen sin sacrificar demasiado la calidad.
La frecuencia indica qué tan rápido cambia la señal.
Intentemos aplicar el conocimiento adquirido en el ejemplo de prueba, transformando la imagen original en su frecuencia (bloque de coeficientes) utilizando DCT, y luego desechando algunos de los coeficientes menos importantes.
Primero, la convertimos al dominio de la frecuencia.
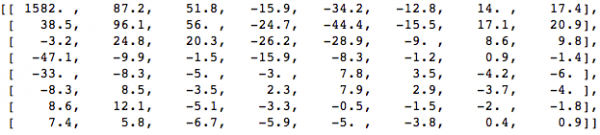
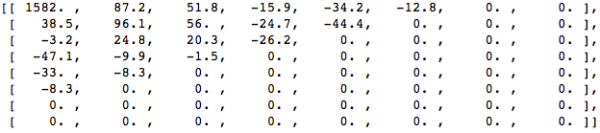
Luego, descartamos parte (67%) de los coeficientes, principalmente la parte inferior derecha.
Finalmente, restauramos la imagen de este bloque de coeficientes desechados (recuerden, debe ser reversible) y la comparamos con el original.
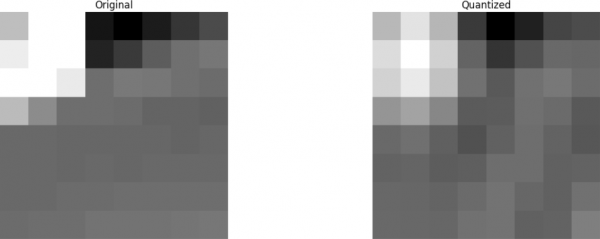
Vemos que se asemeja a la imagen original, pero hay muchas diferencias con respecto al original. Descartamos el 67.1875% y aún así obtuvimos algo que se asemeja a la fuente. Se podrían haber seleccionado los coeficientes de manera más cuidadosa para obtener una imagen de mejor calidad, pero eso es un tema para la próxima vez.
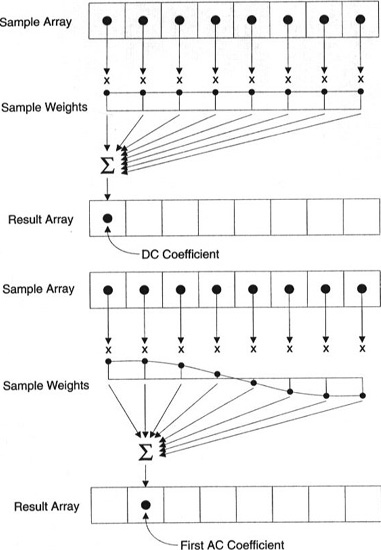
Cada coeficiente se forma utilizando todos los píxeles.
Importante: cada coeficiente no se mapea directamente a un solo píxel, sino que representa una suma ponderada de todos los píxeles. Este gráfico sorprendente muestra cómo se calculan el primer y el segundo coeficiente utilizando pesos únicos para cada índice.
También puedes intentar visualizar DCT, echando un vistazo a la formación simple de la imagen basada en ella. Por ejemplo, aquí está el símbolo A, formado utilizando cada peso del coeficiente:
Paso 4: cuantificación
Después de desechar algunos coeficientes en el paso anterior, en el último paso (transformación), realizamos una forma especial de cuantificación. En esta etapa se permite perder información. O, más simple, cuantificaremos los coeficientes para lograr compresión.
¿Cómo se puede cuantificar un bloque de coeficientes? Uno de los métodos más simples sería la cuantificación uniforme, donde tomamos el bloque, lo dividimos por un valor (10) y redondeamos el resultado.
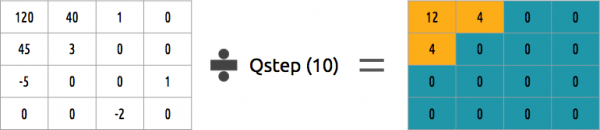
¿Podemos revertir este bloque de coeficientes? Sí, podemos, multiplicando por el mismo valor por el que dividimos.
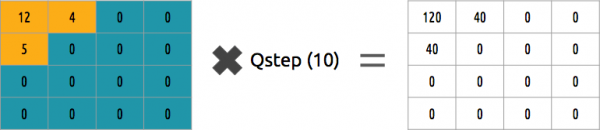
Este enfoque no es el mejor, ya que no tiene en cuenta la importancia de cada coeficiente. Podríamos usar una matriz de cuantificadores en lugar de un solo valor, y esta matriz puede utilizar la propiedad DCT, cuantificando la mayoría de los elementos inferiores derechos y una minoría de los superiores izquierdos.
Paso 5 — codificación de entropía
Después de cuantificar los datos (bloques de imágenes, fragmentos, cuadros), aún podemos comprimirlos sin pérdida. Existen muchas formas algorítmicas de compresión de datos. Vamos a familiarizarnos brevemente con algunas de ellas. Para un entendimiento más profundo, pueden leer el libro «Understanding Compression: Data Compression for Modern Developers» ("»).
Codificación de video con VLC
Supongamos que tenemos una secuencia de símbolos: a, e, r y t. La probabilidad (dentro del rango de 0 a 1) de cuán frecuentemente aparece cada símbolo en la secuencia se representa en esta tabla.
| a | e | r | t | |
|---|---|---|---|---|
| Probabilidad | 0,3 | 0,3 | 0,2 | 0,2 |
Podemos asignar códigos binarios únicos (preferiblemente cortos) a los símbolos más probables y códigos más largos a los menos probables.
| a | e | r | t | |
|---|---|---|---|---|
| Probabilidad | 0,3 | 0,3 | 0,2 | 0,2 |
| Código binario | 0 | 10 | 110 | 1110 |
Comprimimos la secuencia, asumiendo que gastaremos 8 bits por cada símbolo. Sin compresión, se necesitarían 24 bits por símbolo. ¡Si reemplazamos cada símbolo por su código, se obtiene un ahorro!
El primer paso es codificar el símbolo e, que es 10, y el segundo símbolo es a, que se añade (no matemáticamente): [10] [0], y, finalmente, el tercer símbolo t, lo que hace que nuestra secuencia de bits comprimidos final sea [10] [0] [1110], o 1001110, lo que requiere solo 7 bits (3.4 veces menos espacio que el original).
Tenga en cuenta que cada código debe ser un código único con prefijo. ayudará a encontrar estos números. Aunque este método no está exento de defectos, existen códecs de video que aún ofrecen este método algorítmico para la compresión.
Tanto el codificador como el decodificador deben tener acceso a la tabla de símbolos con sus códigos binarios. Por lo tanto, también es necesario enviar la tabla en los datos de entrada.
Codificación aritmética
Supongamos que tenemos una secuencia de símbolos: a, e, r, s y t, y su probabilidad está representada en esta tabla.
| a | e | r | s | t | |
|---|---|---|---|---|---|
| Probabilidad | 0,3 | 0,3 | 0,15 | 0,05 | 0,2 |
Con esta tabla, construiremos rangos que contengan todos los símbolos posibles, ordenados por la mayor cantidad.
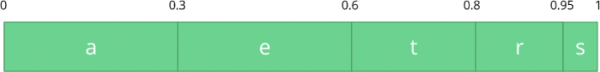
Ahora codifiquemos una secuencia de tres símbolos: eat.
Primero, elegimos el primer símbolo e, que se encuentra en el subrango de 0,3 a 0,6 (sin incluir). Tomamos este subrango y lo dividimos nuevamente en las mismas proporciones que antes, pero ahora para este nuevo rango.
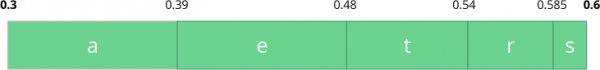
Continuemos codificando nuestra secuencia eat. Ahora tomamos el segundo símbolo a, que se encuentra en el nuevo subrango de 0,3 a 0,39, y luego tomamos nuestro último símbolo t y, repitiendo el mismo proceso, obtenemos el último subrango de 0,354 a 0,372.
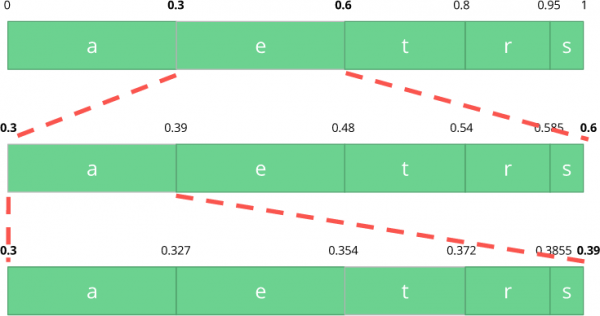
Solo necesitamos elegir un número en el último subrango de 0,354 a 0,372. Vamos a elegir 0,36 (pero se puede elegir cualquier otro número en este rango). Solo con este número podremos recuperar nuestra secuencia original. Es como si dibujáramos una línea dentro de los rangos para codificar nuestra secuencia.
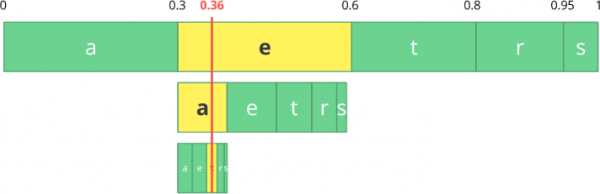
La operación inversa (es decir, decodificación) es igual de sencilla: con nuestro número 0,36 y nuestro rango original podemos iniciar el mismo proceso. Pero ahora, utilizando este número, identificamos la secuencia codificada con este número.
Con el primer rango notamos que nuestro número corresponde a un segmento, por lo tanto, ese es nuestro primer símbolo. Ahora dividimos nuevamente este subrango, siguiendo el mismo proceso que antes. Aquí podemos notar que 0,36 corresponde al símbolo a, y tras repetir el proceso llegamos al último símbolo t (formando nuestra secuencia original codificada. eat).
Tanto para el codificador como para el decodificador debe haber una tabla de probabilidades de símbolos disponible, por lo que es necesario enviar también esta tabla en los datos de entrada.
Bastante elegante, ¿verdad? Quien ideó esta solución fue increíblemente inteligente. Algunos códecs de video utilizan esta técnica (o, al menos, la ofrecen como opción).
La idea es comprimir sin pérdidas un flujo de bits cuantificado. Seguramente, este artículo carece de toneladas de detalles, razones, compromisos, etc. Pero si usted es un desarrollador, debería saber más. Nuevos códecs intentan utilizar diferentes algoritmos de codificación de entropía, como ANS.
Paso 6 - formato del flujo de bits
Después de hacer todo esto, queda desempacar los cuadros comprimidos en el contexto de los pasos realizados. Es necesario informar explícitamente al decodificador sobre las decisiones tomadas por el codificador. Se debe proporcionar toda la información necesaria al decodificador: profundidad de bits, espacio de color, resolución, información sobre pronósticos (vectores de movimiento, pronósticos INTER dirigidos), perfil, nivel, frecuencia de cuadros, tipo de cuadro, número de cuadro y mucho más.
Haremos un vistazo superficial al flujo de bits H.264. Nuestro primer paso es crear un flujo de bits mínimo H.264 (FFmpeg agrega por defecto todos los parámetros de codificación, como SEI NAL — más adelante aprenderemos qué es esto). Podemos hacer esto utilizando nuestro propio repositorio y FFmpeg.
. /s/ffmpeg -i /files/i/minimal.png -pix_fmt yuv420p /files/v/minimal_yuv420.h264
Este comando generará un flujo de bits sin procesar H.264 con un cuadro, resolución 64×64, con espacio de color YUV420. Se utiliza como cuadro la siguiente imagen.

El flujo de bits H.264
El estándar AVC (H.264) determina que la información se enviará en macrocuadros (en el entendimiento de la red), llamados NAL (este es un nivel de abstracción de red). El objetivo principal de NAL es proporcionar una representación «amigable con la red» de video. Este estándar debe funcionar en televisores (basado en flujos) y en Internet (basado en paquetes).

Hay un marcador de sincronización para determinar los límites de los elementos NAL. Cada marcador de sincronización contiene el valor 0x00 0x00 0x01, excepto el primero, que es igual a 0x00 0x00 0x00 0x01. Si ejecutamos hexdump para el flujo de bits H.264 generado, identificaremos al menos tres patrones NAL al principio del archivo.
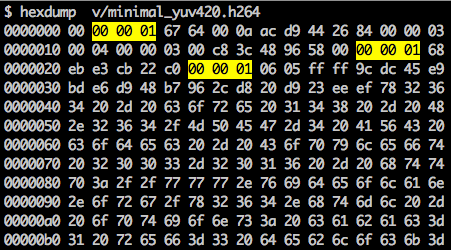
Como se dijo, el decodificador debe conocer no solo los datos de la imagen, sino también detalles del video, cuadro, color, parámetros utilizados y mucho más. El primer byte de cada NAL determina su categoría y tipo.
| Identificador de tipo NAL | Descripción |
|---|---|
| 0 | Tipo desconocido |
| 1 | Fragmento de imagen codificada sin IDR |
| 2 | Sección de datos codificados del corte A |
| 3 | Sección de datos codificados del corte B |
| 4 | Sección de datos codificados del corte C |
| 5 | Fragmento IDR de imagen IDR codificado |
| 6 | Información adicional sobre la extensión SEI |
| 7 | Conjunto de parámetros de la secuencia SPS |
| 8 | Conjunto de parámetros de la imagen PPS |
| 9 | Separador de acceso |
| 10 | Fin de la secuencia |
| 11 | Fin del flujo |
| … | … |
Normalmente, el primer NAL del flujo de bits es SPS. Este tipo de NAL se encarga de informar sobre variables de codificación generales como el perfil, nivel, resolución y más.
Si se omite el primer marcador de sincronización, podemos decodificar el primer byte para determinar qué tipo de NAL es el primero.
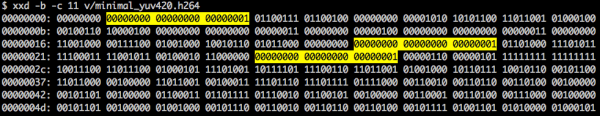
Por ejemplo, el primer byte después del marcador de sincronización es igual a 01100111, donde el primer bit (0) está en el campo forbidden_zero_bit. Los siguientes 2 bits (11) nos informan sobre el campo nal_ref_idc, que indica si este NAL es un campo de referencia o no. Y los otros 5 bits (00111) nos informan sobre el campo nal_unit_type, en este caso es un bloque SPS (7) NAL.
El segundo byte (binario=01100100, hex=0x64, dec,=100) en el NAL SPS es el campo profile_idc, que muestra el perfil utilizado por el codificador. En este caso, se utilizó un perfil alto restringido (es decir, un perfil alto sin soporte para el segmento B bidireccional).
Si consultamos la especificación del flujo de bits H.264 para el NAL SPS, encontraremos múltiples valores para el nombre del parámetro, categoría y descripción. Por ejemplo, veamos los campos pic_width_in_mbs_minus_1 y pic_height_in_map_units_minus_1.
| Nombre del parámetro | Categoría | Descripción |
|---|---|---|
| pic_width_in_mbs_minus_1 | 0 | ue(v) |
| pic_height_in_map_units_minus_1 | 0 | ue(v) |
Si realizamos algunas operaciones matemáticas con los valores de estos campos, obtendremos la resolución. Se puede representar 1920 x 1080 utilizando pic_width_in_mbs_minus_1 con un valor de 119 ((119 + 1) * macroblock_size = 120 * 16 = 1920). Nuevamente, para ahorrar espacio, en lugar de codificar 1920, se hizo con 119.
Si continuamos verificando nuestro video creado en binario (por ejemplo: xxd -b -c 11 v/minimal_yuv420.h264), podemos avanzar al último NAL, que es el cuadro en sí.

Aquí vemos sus primeros 6 valores en bytes: 01100101 10001000 10000100 00000000 00100001 11111111. Dado que se sabe que el primer byte indica el tipo de NAL, en este caso (00101) es un fragmento IDR (5), y luego se podrá investigar adicionalmente:
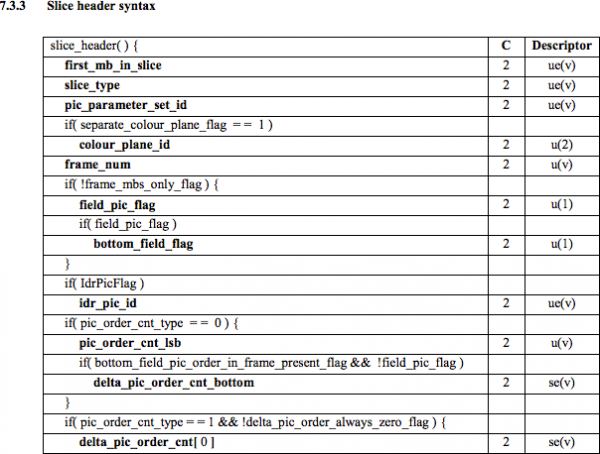
Usando la información de la especificación, se pueden decodificar el tipo de fragmento (slice_type) y el número de cuadro (frame_num) entre otros campos importantes.
Para obtener los valores de algunos campos (ue(v), me(v), se(v) o te(v), necesitamos decodificar el fragmento utilizando un decodificador especial basado en . Este método es muy eficaz para codificar los valores de las variables, especialmente cuando hay muchos valores predeterminados.
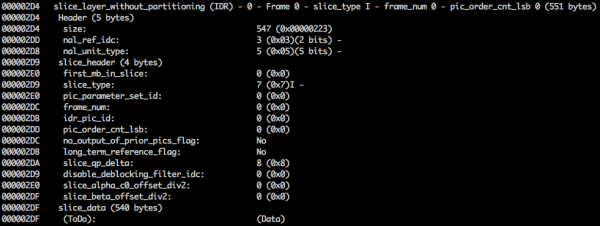
Valores slice_type y frame_num de este video son 7 (fragmento I) y 0 (primer fotograma).
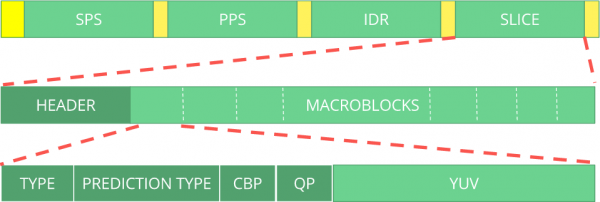
El flujo de bits se puede considerar como un protocolo. Si desea saber más sobre el flujo de bits, debe consultar la especificación ITU H.264. Aquí hay un esquema que muestra dónde se encuentran los datos de la imagen (YUV en forma comprimida).
Se pueden explorar otros flujos de bits, como VP9, H.265 (HEVC) o incluso nuestro nuevo mejor flujo de bits AV1. ¿Son todos ellos similares? No, pero una vez que comprenda al menos uno, será mucho más fácil entender los demás.
¿Quieres practicar? Explora el flujo de bits H.264
Se puede generar un video de un solo fotograma y usar MediaInfo para investigar el flujo de bits H.264. De hecho, nada impide incluso mirar el código fuente que analiza el flujo de bits H.264 (AVC).
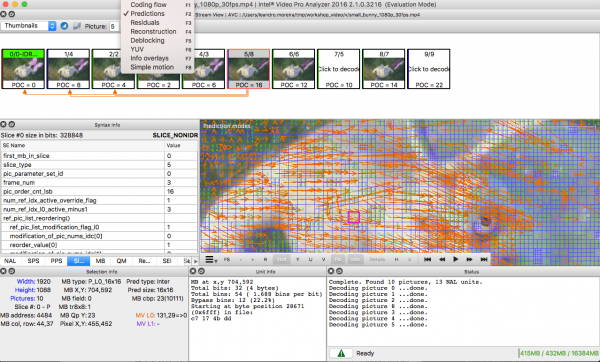
Para practicar, se puede usar Intel Video Pro Analyzer (ya mencioné que el programa es de pago, pero hay una versión de prueba gratuita, con un límite de 10 fotogramas?).
Reseña
Cabe señalar que muchos códecs modernos utilizan el mismo modelo que acabamos de revisar. Aquí, echemos un vistazo al diagrama de bloques del códec de video Thor. Contiene todos los pasos que hemos recorrido. El propósito de esta nota es que al menos comprendas mejor las innovaciones y la documentación de este campo.
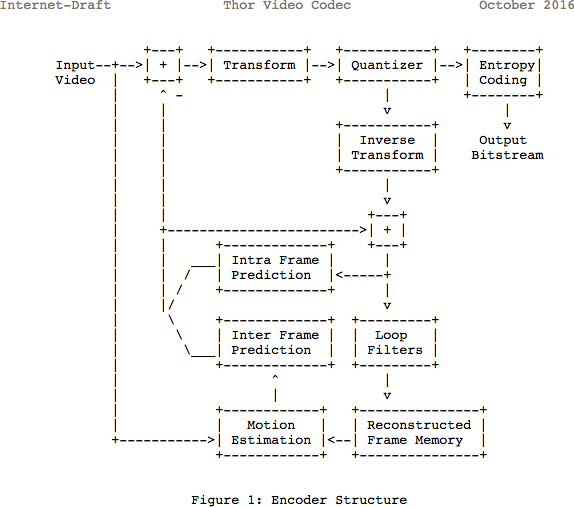
Se calculó anteriormente que se necesitarían 139 GB de espacio en disco para almacenar un archivo de video de una hora de duración a una calidad de 720p y 30 fps. Si se utilizan los métodos analizados en este artículo (predicciones inter-cadencadas y internas, transformación, cuantización, codificación de entropía, etc.), se puede lograr una calidad de video bastante aceptable, ocupando solo 367,82 MB, en lugar de 139 GB de memoria.
¿Cómo logra H.265 un mejor nivel de compresión que H.264?
Ahora que se sabe más sobre cómo funcionan los códecs, es más fácil entender cómo los nuevos códecs pueden proporcionar una mayor resolución con menos bits.
Al comparar AVC y HEVC, no hay que olvidar que casi siempre se trata de elegir entre una mayor carga en la CPU y el grado de compresión.
HEVC tiene más opciones de secciones (y subsecciones) que AVC, más direcciones de predicción interna, codificación de entropía mejorada y mucho más. Todas estas mejoras hicieron que H.265 sea capaz de comprimir un 50% más que H.264.
Primera parte:
Fuente: habr.com
