

El trabajo de investigación es, sin duda, la parte más interesante de nuestra formación. La idea es que, incluso durante la universidad, podamos probar nuestro rumbo elegido. Por ejemplo, los estudiantes de las especialidades de Ingeniería de Software y Aprendizaje Automático a menudo llevan a cabo proyectos de investigación en empresas (principalmente JetBrains o Yandex, pero no solo).
En este post, hablaré sobre mi proyecto en el ámbito de la Informática. En el transcurso de este trabajo, estudié e implementé en la práctica enfoques para resolver uno de los problemas NP-duros más conocidos: el problema de la cobertura de vértices.
Actualmente, se está desarrollando rápidamente un enfoque interesante hacia los problemas NP-duros: los algoritmos parametrizados. Intentaré ponerte al tanto, presentar algunos algoritmos parametrizados simples y describir un poderoso método que me fue de gran ayuda. Presenté mis resultados en la competencia PACE Challenge: tras las pruebas abiertas, mi solución ocupa el tercer lugar, y los resultados finales se darán a conocer el 1 de julio.
Acerca de mí
Me llamo Vasily Alfyorov, estoy finalizando el tercer curso en la HSE de San Petersburgo. Me apasionan los algoritmos desde mis años escolares, cuando estudié en la escuela 179 de Moscú y participé con éxito en olimpiadas de informática.
Un número finito de especialistas en algoritmos parametrizados entra en un bar...
El ejemplo se toma del libro
Imagina que eres un guardia de seguridad en un pequeño bar en un pueblo. Cada viernes, la mitad del pueblo viene a tu bar a relajarse, lo que te genera muchos problemas: tienes que expulsar a los clientes problemáticos para evitar peleas. Al final, te aburres de esto y decides tomar medidas preventivas.
Dado que tu pueblo es pequeño, sabes exactamente qué pares de clientes tienen una alta probabilidad de pelear si entran al bar juntos. Tienes una lista de n personas que vendrán esta noche al bar. Decides no dejar entrar a ciertos ciudadanos de manera que nadie termine peleándose. Al mismo tiempo, tu jefe no quiere perder ganancias y estará descontento si no dejas entrar a más de k personas.
Desafortunadamente, el problema que enfrentan es un clásico problema NP-duro. Podrías conocerlo como , o como el problema del cubrimiento de vértices. Para tales problemas, en general, no se conocen algoritmos que funcionen en un tiempo razonable. Para ser precisos, la hipótesis ETH (Hipótesis del Tiempo Exponencial) no demostrada dice que este problema no se puede resolver en un tiempo  , es decir, que no se puede idear algo significativamente mejor que la búsqueda completa. Por ejemplo, supongamos que un grupo de n = 1000 personas va a acudir a un bar. Entonces, la búsqueda completa implicará
 opciones, que es aproximadamente
 — una cantidad loca. Afortunadamente, su dirección le ha impuesto un límite k = 10, por lo que el número de combinaciones que debe considerar es mucho menor: el número de subconjuntos de diez elementos es
 . Esto ya es mejor, pero aún así no se puede contar en un día ni siquiera en un clúster potente.
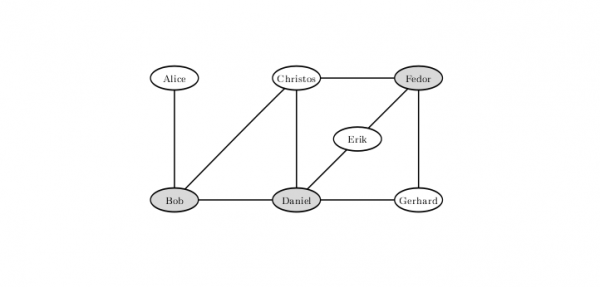
Para eliminar la posibilidad de peleas con esta configuración de relaciones tensas entre los visitantes del bar, es necesario no dejar entrar a Bob, Daniel y Fyodor. No hay solución en la que queden solo dos afuera.
¿Significa esto que es hora de rendirse y dejar entrar a todos? Consideremos otras opciones. Por ejemplo, se puede no dejar entrar solo a aquellos que probablemente pelearán con una cantidad muy grande de gente. Si alguien puede pelear con al menos k + 1 otra persona, entonces definitivamente no se le puede dejar entrar; de lo contrario, habrá que no dejar entrar a todos k + 1 los ciudadanos con quienes puede pelear, lo que ya seguro descontentará a la dirección.
Supongamos que has echado a todos los que pudiste según este principio. Entonces, todos los demás pueden pelear con no más de k personas. Echando de ellos k personas, puedes prevenir no más de  conflictos. Significa que, si hay más de
 personas implicadas en al menos un conflicto, entonces definitivamente no podrás prevenirlos todos. Dado que, evidentemente, los que no son conflictivos los dejarás entrar, debes considerar todos los subconjuntos de tamaño diez de doscientos personas. Hay aproximadamente
 , y tal cantidad de operaciones ya se puede contar en un clúster.
Si es posible incluir a personalidades que no entren en conflicto, ¿qué pasa con aquellos que participan en solo un conflicto? En realidad, también se les puede dejar entrar, cerrando la puerta ante su oponente. De hecho, si Alicia solo tiene conflictos con Bob, al permitir la entrada de Alicia, no perderemos: Bob puede tener otros conflictos y Alicia no tiene ninguno. Además, no tiene sentido no dejar entrar a ambos. Después de tales operaciones, no quedan más que  invitados con un destino incierto: en total, tenemos
 conflictos, en cada uno de los cuales hay dos participantes y cada uno participa en al menos dos. Por lo tanto, solo queda recorrer
 variantes, lo que podría considerarse como medio día en un portátil.
En realidad, con razonamientos simples se pueden obtener condiciones aún más atractivas. Notemos que necesitamos resolver todas las disputas, es decir, de cada par en conflicto elegir al menos a una persona que no dejaremos entrar. Consideremos el siguiente algoritmo: tomaremos cualquier conflicto, eliminaremos a un participante y comenzaremos recursivamente desde el resto, luego eliminaremos al otro y también iniciaremos recursivamente. Dado que en cada paso eliminamos a alguien, el árbol de recursión de este algoritmo es un árbol binario de profundidad k, por lo tanto, el algoritmo funciona en  , donde n — cantidad de nodos, y m — cantidad de aristas. En nuestro ejemplo, esto es del orden de diez millones, lo que se calculará en fracciones de segundo no solo en un portátil, sino incluso en un teléfono móvil.
El ejemplo anterior es un ejemplo de un algoritmo parametrizado. Los algoritmos parametrizados son aquellos que funcionan en un tiempo f(k) poly(n), donde p — polinomio, f — función computable arbitraria, y k — algún parámetro que, muy probablemente, será mucho menor que el tamaño del problema.
Todos los razonamientos hasta este algoritmo dan el ejemplo de kernelización una de las técnicas comunes para crear algoritmos parametrizados. La kernelización es la reducción del tamaño del problema a un valor limitado por una función del parámetro. El problema obtenido a menudo se denomina núcleo. Así, mediante razonamientos simples sobre las potencias de los vértices, obtuvimos un núcleo cuadrático para el problema de Vertex Cover, parametrizado por el tamaño de la respuesta. Existen otros parámetros que se pueden elegir para este problema (por ejemplo, Vertex Cover Above LP), pero discutiremos exactamente este parámetro.
Desafío Pace
Competencia (El Desafío de Algoritmos Parametrizados y Experimentos Computacionales) surgió en 2015 para establecer un vínculo entre los algoritmos parametrizados y los enfoques utilizados en la práctica para resolver problemas computacionales. Las primeras tres competencias se centraron en la búsqueda de la anchura de árbol del grafo (), la búsqueda del árbol de Steiner () y la búsqueda de un conjunto de vértices que corta ciclos (). Este año, uno de los problemas en los que se pudo intentar demostrar habilidades fue el mencionado arriba sobre el cubrimiento de vértices.
La competencia gana popularidad con cada año que pasa. Si se cree en los datos preliminares, este año solo en la competencia para resolver el problema del cubrimiento de vértices participaron 24 equipos. Cabe señalar que la competencia no dura solo unas pocas horas, ni una semana, sino varios meses. Los equipos tienen la oportunidad de investigar la literatura, idear su propia idea original y tratar de implementarla. Esencialmente, esta competencia representa un trabajo de investigación. Las ideas de las soluciones más efectivas y la premiación de los ganadores se llevarán a cabo junto con la conferencia (Simposio Internacional sobre Cálculo Parametrizado y Exacto) en el marco de la reunión algorítmica anual más grande en Europa . Se puede encontrar más información sobre la competencia en , y los resultados de años anteriores están disponibles en .
Esquema de solución
Para abordar el problema de la cobertura de vértices, intenté aplicar algoritmos parametrizados. Estos generalmente consisten en dos partes: reglas de simplificación (que idealmente conducen a la kernelización) y reglas de bifurcación. Las reglas de simplificación son un preprocesamiento de la entrada en tiempo polinómico. El objetivo de aplicar tales reglas es reducir el problema a un problema equivalente de menor tamaño. Las reglas de simplificación son la parte más costosa del algoritmo, y la aplicación de esta parte conduce al tiempo total de ejecución  en lugar de un tiempo polinómico simple. En nuestro caso, las reglas de bifurcación se basan en que para cada vértice se debe tomar como respuesta ya sea él o su vecino.
El esquema general es el siguiente: aplicamos las reglas de simplificación, luego elegimos un vértice y hacemos dos llamadas recursivas: en la primera tomamos el vértice como respuesta, y en la otra tomamos a todos sus vecinos. A esto lo llamamos bifurcarnos (branching) por este vértice.
A este esquema se le hará exactamente una adición en el siguiente párrafo.
Ideas para las reglas de bifurcación (branching)
Hablemos sobre cómo elegir el vértice por el que se realizará la bifurcación.
La idea principal es muy codiciosa en el sentido algorítmico: tomemos el vértice de mayor grado y bifurcémonos precisamente por él. ¿Por qué parece que esto es mejor? Porque en la segunda rama de la llamada recursiva, de este modo eliminaremos muchos vértices. Se puede esperar que quede un grafo pequeño y que trabajemos rápidamente sobre él.
Este enfoque con las técnicas simples de kernelización ya discutidas se comporta bastante bien, resolviendo algunas pruebas de varios miles de vértices. Pero, por ejemplo, funciona mal para grafos cúbicos (es decir, grafos en los que el grado de cada vértice es tres).
Hay otra idea basada en un pensamiento bastante simple: si el grafo es desconexo, se puede resolver la tarea en sus componentes de conectividad de forma independiente, combinando las respuestas al final. Esta, por cierto, es la pequeña modificación prometida en el esquema, que acelerará significativamente la solución: antes, en tal caso, trabajábamos por el producto de los tiempos de conteo de respuestas de los componentes, y ahora trabajamos por la suma. Y para acelerar la bifurcación, es necesario convertir el grafo conexo en desconexo.
¿Cómo hacerlo? Si en el grafo hay un punto de articulación, se debe bifurcar exactamente en él. El punto de articulación es un vértice tal que, al eliminarlo, el grafo pierde su conectividad. Se puede encontrar todos los puntos de articulación en el grafo usando un algoritmo clásico en tiempo lineal. Este enfoque acelera notablemente el bifurcamiento.
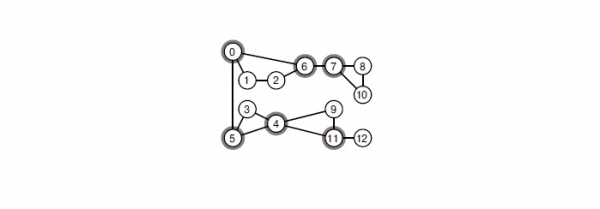
Al eliminar cualquiera de los vértices destacados, el grafo se descompondrá en componentes de conectividad.
Esto lo haremos, pero queremos más. Por ejemplo, buscar pequeños cortes de vértices en el grafo y realizar la bifurcación usando esos vértices. El método más eficiente que conozco para encontrar el corte global mínimo de vértices es utilizar el árbol de Gomory-Hu, que se construye en tiempo cúbico. En el desafío PACE, el tamaño típico del grafo es de varios miles de vértices. Con este panorama, en cada vértice del árbol de recursión se deben realizar miles de millones de operaciones. Por lo tanto, resolver el problema en el tiempo asignado es simplemente imposible.
Intentemos optimizar la solución. El corte mínimo de vértices entre un par de vértices se puede encontrar utilizando cualquier algoritmo que construya flujo máximo. Se puede aplicar a tal red. , en la práctica funciona muy rápido. Tengo la sospecha de que teóricamente se puede demostrar una cota en el tiempo de ejecución  , lo cual ya es bastante aceptable.
He intentado varias veces buscar cortes entre pares de vértices aleatorios y tomar el más equilibrado. Desafortunadamente, en las pruebas abiertas del desafío PACE esto dio malos resultados. Comparé con el algoritmo que se bifurca por vértices de máxima grado, ejecutándolo con una restricción en la profundidad de descenso. Después del algoritmo que intenta encontrar un corte de esta manera, quedaban grafos de mayor tamaño. Esto se debe a que los cortes resultaban muy desequilibrados: al eliminar de 5 a 10 vértices, se lograba desprender solo de 15 a 20.
Cabe mencionar que en los artículos sobre los algoritmos teóricamente más rápidos se utilizan técnicas de selección de vértices para la bifurcación que son mucho más avanzadas. Estas técnicas tienen una implementación muy compleja y, a menudo, malas estimaciones en cuanto a tiempo y memoria. No logré extraer de ellas opciones razonables para la práctica.
Cómo aplicar las reglas de simplificación
Ya tenemos ideas de kernelización. Recuerdo:
- Si hay un vértice aislado, eliminarlo.
- Si hay un vértice de grado 1, elimínalo y toma su vecino como respuesta.
- Si hay un vértice de grado al menos k + 1, tómalo como respuesta.
Con los dos primeros está claro, con el tercero hay un truco. Si en la tarea humorística sobre el bar se nos dio un límite superior en k, en el PACE Challenge solo necesitas encontrar una cobertura de vértices de tamaño mínimo. Esta es una transformación típica de problemas de búsqueda (Search Problem) a problemas de decisión (Decision Problem), a menudo no se diferencia entre estos dos tipos de problemas. En la práctica, si estamos escribiendo un resolutivo para el problema de la cobertura de vértices, la diferencia puede ser notable. Por ejemplo, como en el tercer punto.
Desde el punto de vista de la implementación, se pueden seguir dos enfoques. El primer enfoque se llama Iterative Deepening. Consiste en lo siguiente: podemos comenzar con algún límite razonable inferior en la respuesta y luego ejecutar nuestro algoritmo, utilizando este límite como un límite superior en la respuesta, sin profundizar en la recursión más allá de este límite. Si encontramos alguna respuesta, es garantizadamente óptima, de lo contrario, se puede aumentar este límite en uno y volver a ejecutarlo.
El otro enfoque es mantener alguna respuesta óptima actual y buscar una respuesta de menor tamaño, ajustando este parámetro al encontrarla k para podar más ramas innecesarias en la búsqueda.
Después de realizar varios experimentos nocturnos, me detuve en una combinación de estos dos enfoques: primero ejecuto mi algoritmo con algún límite en la profundidad de búsqueda (ajustándolo de manera que tome un tiempo insignificante en comparación con la solución principal) y utilizo la mejor solución encontrada como límite superior en la respuesta, es decir, en lo que es k.
Vértices de grado 2
Con los vértices de grado 0 y 1 hemos resuelto la cuestión. Resulta que también se puede hacer con los vértices de grado 2, pero para esto se requerirán operaciones más complejas en el gráfico.
Para explicar esto, hay que designar de alguna manera los vértices. Llamaremos al vértice de grado 2 como vértice v, y a sus vecinos como vértices x y y. A continuación, tendremos dos casos.
- Cuando x y y — vecinos. Entonces se puede tomar como respuesta x y y, y v eliminar. Y de hecho, de este triángulo, al menos dos vértices deben tomarse en la respuesta y seguramente no perderemos si tomamos x y y: probablemente tienen más vecinos, mientras que v ellos no tienen.
- Cuando x y y — no vecinos. Entonces, se afirma que se pueden fusionar los tres vértices en uno. La idea es que en tal caso hay una respuesta óptima, en la que tomaremos ya sea v, o ambos vértices x y y. En el primer caso, tendremos que incluir en la respuesta a todos los vecinos x y y, mientras que en el segundo no es necesario. Esto corresponde exactamente a los casos en los que noIncluimos el vértice fusionado en la respuesta y cuando sí lo hacemos. Solo queda notar que en ambos casos la respuesta de tal operación se reduce en uno.
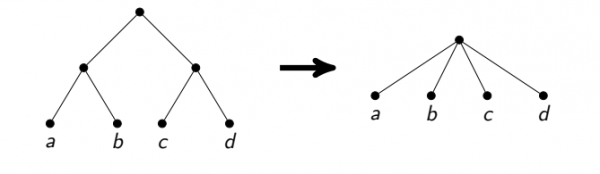
Cabe señalar que este enfoque es bastante complicado de implementar de manera eficiente en tiempo lineal. La fusión de vértices es una operación compleja, se deben copiar las listas de vecinos. Si no se hace con cuidado, se puede obtener un tiempo de ejecución asintóticamente subóptimo (por ejemplo, si después de cada fusión se copian muchos bordes). Me detuve en la búsqueda de caminos enteros de vértices de grado 2 y en el análisis de muchos casos particulares, como ciclos de estos vértices o de todos estos vértices excepto uno.
Además, es necesario que esta operación sea reversible, para que al volver de la recursión restauramos el gráfico a su estado original. Para asegurar esto, no limpié las listas de bordes de los vértices fusionados, después de lo cual simplemente sabía a dónde dirigir los bordes necesarios. Esta implementación de gráficos también requiere cuidado, pero garantiza un tiempo lineal eficiente. Y para gráficos de varios miles de bordes, fácilmente cabe en la caché del procesador, lo que proporciona grandes ventajas en velocidad.
Núcleo lineal
Finalmente, la parte más interesante del núcleo.
Para empezar, recordemos que en los gráficos bipartitos, se puede buscar la cobertura mínima de vértices en  . Para ello, se debe utilizar el algoritmo para encontrar allí el emparejamiento máximo, y luego utilizar el teorema .
La idea del núcleo lineal es la siguiente: primero bifurcamos el gráfico, es decir, en lugar de cada vértice v creamos dos vértices  y
 , y en lugar de cada borde u — v creamos dos bordes
 y
 . El gráfico obtenido será bipartito. Encontramos en él una cobertura mínima de vértices. Algunos vértices del gráfico original estarán en la cobertura dos veces, algunos una sola vez, y algunos no estarán en absoluto. El teorema de Nemhauser-Trotter afirma que en tal caso se pueden eliminar los vértices que no aparecieron y tomar como respuesta aquellos que aparecieron dos veces. Además, indica que de los vértices restantes (aquellos que aparecieron una vez) debemos tomar al menos la mitad como respuesta.
Acabamos de aprender a dejar en el gráfico no más de 2k vértices. Y es cierto, si en la respuesta restante hay al menos la mitad de todos los vértices, entonces el total de vértices no es más que 2k.
Aquí he logrado dar un pequeño paso adelante. Está claro que el núcleo construido de esta manera depende de qué cobertura mínima de vértices tomamos en el gráfico bipartito. Quisiera tomar una que minimizara el número de vértices restantes. Antes, esto solo se podía hacer en un tiempo  . Yo ideé una implementación de este algoritmo en un tiempo
 , así que este núcleo se puede buscar en gráficos de cientos de miles de vértices en cada etapa de ramificación.
Resultado
La práctica demuestra que mi solución funciona bien en pruebas con varios cientos de vértices y varios miles de aristas. En tales pruebas, se puede esperar que la solución se encuentre en media hora. La probabilidad de encontrar una respuesta en un tiempo razonable aumenta en principio si hay muchos vértices de alto grado en el gráfico, por ejemplo, de grado 10 o más.
Para participar en la competencia, era necesario enviar las soluciones a . Según la tabla presentada allí Los resultados en las pruebas cerradas se conocerán el primero de julio.
La investigación científica es, sin duda, la parte más interesante de nuestra formación. La idea es, aún en la universidad, tener la oportunidad de probarse en la dirección elegida.
Fuente: habr.com
