

Un artículo del equipo de Stitch Fix sugiere utilizar un enfoque de ensayos clínicos de no inferioridad en las pruebas A/B de marketing y productos. Este enfoque es realmente aplicable cuando estamos probando una nueva solución que tiene ventajas no medibles a través de las pruebas.
El ejemplo más simple es la reducción de costos. Por ejemplo, automatizamos el proceso de asignación de la primera lección, pero no queremos que la tasa de conversión general se vea muy afectada. O probamos cambios orientados a un segmento de usuarios, asegurándonos de que las conversiones en otros segmentos no disminuyan drásticamente (al probar varias hipótesis, no olvidemos aplicar las correcciones).
Elegir el límite correcto de no inferioridad añade dificultades adicionales en la fase de diseño de la prueba. La cuestión de cómo seleccionar Δ no se aborda adecuadamente en el artículo. Parece que esta elección no es completamente transparente, incluso en los ensayos clínicos. Las publicaciones médicas sobre no inferioridad indican que solo en la mitad de las publicaciones se justifica la elección del límite, y a menudo estas justificaciones son ambiguas o poco detalladas.
En cualquier caso, este enfoque parece interesante, ya que al reducir el tamaño necesario de la muestra puede aumentar la velocidad de prueba y, por lo tanto, la velocidad de toma de decisiones. Daria Mukhina, analista de productos de la aplicación móvil Skyeng.
El equipo de Stitch Fix disfruta probar diferentes cosas. En general, a toda la comunidad tecnológica le gusta realizar pruebas. ¿Qué versión del sitio atrae a más usuarios: A o B? ¿Genera la versión A del modelo de recomendación más ingresos que la versión B? Casi siempre utilizamos el enfoque más simple del curso básico de estadística para validar hipótesis:
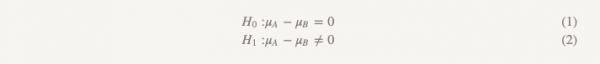
Aunque rara vez usamos este término, este tipo de prueba se llama 'verificación de hipótesis de superioridad'. Con este enfoque, suponemos que no hay ninguna diferencia entre las dos opciones. Mantenemos esta idea y solo la abandonamos si los datos obtenidos son suficientemente convincentes para ello, es decir, demuestran que una de las opciones (A o B) es mejor que la otra.
La verificación de la hipótesis de superioridad es adecuada para resolver muchos problemas. Lanzamos la versión B del modelo de recomendación solo si es claramente mejor que la versión A ya utilizada. Sin embargo, en algunos casos, este enfoque no funciona tan bien. Consideremos algunos ejemplos.
1) Utilizamos un servicio externo, que ayuda a identificar tarjetas bancarias falsas. Encontramos otro servicio que cuesta significativamente menos. Si el servicio más barato funciona tan bien como el que estamos usando actualmente, lo elegiremos. No necesariamente tiene que ser mejor que el servicio utilizado.
2) Queremos dejar de usar la fuente de datos A y reemplazarla por la fuente de datos B. Podríamos posponer la eliminación de A si B produce resultados muy malos, pero continuar usando A no es viable.
3) Nos gustaría cambiar del enfoque de modeladoA al enfoque B no porque esperemos mejores resultados de B, sino porque nos brinda una mayor flexibilidad operativa. No tenemos razones para suponer que B será peor, pero no haremos el cambio si lo es.
4) Hemos realizado algunos cambios de calidad en el diseño del sitio web (versión B) y consideramos que esta versión supera a la versión A. No esperamos cambios en la conversión o en ningún indicador clave de rendimiento por el que normalmente evaluamos el sitio web. Pero creemos que hay ventajas en parámetros que son medibles o que nuestra tecnología no puede medir.
En todos estos casos, el estudio de la superioridad no es la solución más adecuada. Sin embargo, la mayoría de los especialistas lo utilizan por defecto en estas situaciones. Realizamos experimentos cuidadosamente para determinar correctamente el tamaño del efecto. Si fuera cierto que las versiones A y B funcionan de manera muy similar, existe la posibilidad de que no podamos rechazar la hipótesis nula. ¿Concluimos que A y B en general funcionan igual? ¡No! La imposibilidad de rechazar la hipótesis nula y aceptar la hipótesis nula no son lo mismo.
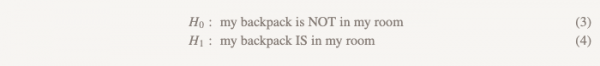
Los cálculos del tamaño de la muestra (que, por supuesto, has realizado) generalmente se llevan a cabo con límites más estrictos para el error de tipo I (la probabilidad de rechazar incorrectamente la hipótesis nula, a menudo llamada alfa) que para el error de tipo II (la probabilidad de no rechazar la hipótesis nula, dado que la hipótesis nula es falsa, a menudo llamada beta). Un valor típico para alfa es 0.05, mientras que un valor típico para beta es 0.20, lo que corresponde a una potencia estadística de 0.80. Esto significa que podemos no detectar el verdadero efecto del tamaño que hemos especificado en nuestros cálculos de potencia con una probabilidad del 20%, y esto es una brecha bastante significativa en la información. Como ejemplo, consideremos las siguientes hipótesis:
H0: mi mochila NO está en mi habitación (3)
H1: mi mochila está en mi habitación (4)
Si he revisado mi habitación y he encontrado mi mochila, genial, puedo rechazar la hipótesis nula. Pero si he revisado la habitación y no he podido encontrar mi mochila (figura 1), ¿qué conclusión debo sacar? ¿Estoy seguro de que no está ahí? ¿He buscado con suficiente minuciosidad? ¿Qué pasa si solo busqué el 80% de la habitación? Sacar la conclusión de que la mochila definitivamente no está en la habitación sería una decisión imprudente. No es de extrañar que no podamos 'aceptar la hipótesis nula'.
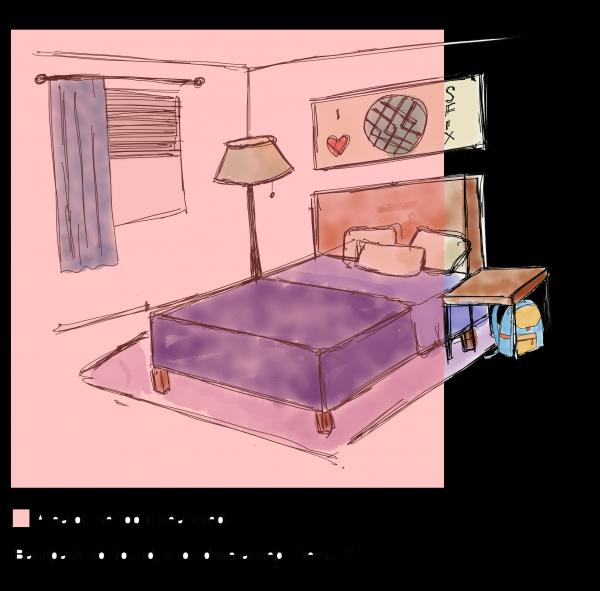
El área que hemos examinado
No encontramos la mochila, ¿deberíamos aceptar la hipótesis nula?
Figura 1. Revisar el 80% de la habitación es aproximadamente lo mismo que realizar un estudio con una potencia del 80%. Si no encontraste la mochila revisando el 80% de la habitación, ¿se puede concluir que no está ahí?
¿Qué debe hacer un especialista en datos en esta situación? Puedes aumentar significativamente la potencia del estudio, pero entonces necesitarás una muestra mucho más grande, y el resultado seguirá siendo insatisfactorio.
Afortunadamente, estos problemas han sido ampliamente estudiados en el mundo de la investigación clínica. El fármaco B es más barato que el fármaco A; se espera que el fármaco B cause menos efectos secundarios que el fármaco A; además, el fármaco B es más fácil de transportar porque no necesita ser almacenado en refrigeración, a diferencia del fármaco A, que sí lo necesita. Verificaremos la hipótesis de una eficacia no menor. Esto es necesario para demostrar que la versión B es tan buena como la versión A, al menos dentro de un cierto límite previamente definido de “no menor eficacia”, Δ. Más adelante hablaremos en detalle sobre cómo establecer este límite. Pero ahora supongamos que esta es la diferencia mínima que es prácticamente significativa (en el contexto de los ensayos clínicos, esto suele llamarse significancia clínica).
Las hipótesis de no menor eficacia lo cambian todo:
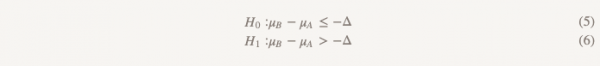
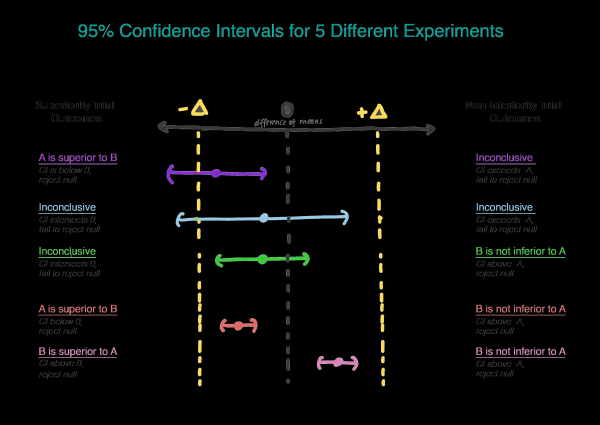
Ahora, en lugar de suponer que no hay diferencia, asumimos que la versión B es inferior a la versión A, y mantendremos esta suposición hasta que demostremos que no es así. Este es el momento en que tiene sentido utilizar una prueba de hipótesis unidireccional. En la práctica, esto se puede lograr construyendo un intervalo de confianza y determinando si realmente el intervalo es mayor que Δ (Figura 2).
Elección de Δ
¿Cómo elegir correctamente Δ? El proceso de elección de Δ incluye la justificación estadística y la evaluación contextual. En el mundo de los ensayos clínicos, existen recomendaciones normativas que indican que delta debe representar la menor diferencia clínica significativa, es decir, aquella que tenga relevancia en la práctica. Aquí hay una cita de la guía europea que puedes usar como referencia: “Si la diferencia ha sido elegida correctamente, el intervalo de confianza, que se encuentra completamente entre –∆ y 0..., sigue siendo suficiente para demostrar no menor eficacia. Si este resultado no parece aceptable, eso significa que ∆ no fue elegido adecuadamente.”
Delta no debe ser mayor que el tamaño del efecto de la versión A en relación con el control real (placebo / ausencia de tratamiento), ya que esto nos lleva a la conclusión de que la versión B es peor que el control real, al mismo tiempo que demuestra 'no menor eficacia'. Supongamos que cuando se presentó la versión A, había una versión 0 o la función no existía en absoluto (ver figura 3).
De los resultados de la prueba de la hipótesis de superioridad, se determinó el tamaño del efecto E (es decir, presumiblemente μ^A−μ^0=E). Ahora A es nuestro nuevo estándar y queremos asegurarnos de que B no sea inferior a A. Otra forma de escribir μB−μA≤−Δ (hipótesis nula) es μB≤μA−Δ. Si asumimos que hacer esto es igual o supera E, entonces μB ≤ μA−E ≤ placebo. Ahora vemos que nuestra estimación para μB supera completamente μA−E, lo que refuta por completo la hipótesis nula y permite concluir que B no es inferior a A, pero al mismo tiempo μB puede ser ≤ μ del placebo, lo que no es lo que necesitamos. (figura 3).
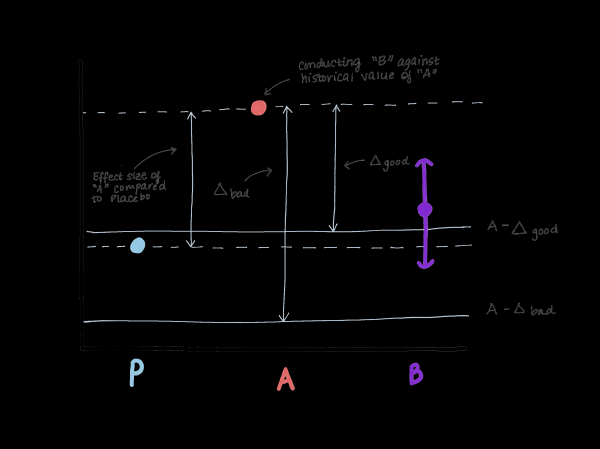
Figura 3. Demostración de los riesgos de elegir el límite de no menor eficacia. Si el límite es demasiado grande, se puede concluir que B no es inferior a A, pero al mismo tiempo es indistinguible del placebo. No vamos a cambiar un medicamento que es claramente más efectivo que el placebo (A) por uno que tiene la misma eficacia que el placebo.
Selección de α
Pasemos a la selección de α. Se puede usar el valor estándar de α = 0,05, pero eso no es del todo justo. Por ejemplo, cuando compras algo en línea y usas varios códigos de descuento a la vez, aunque no deberían acumularse: simplemente el desarrollador cometió un error y te saliste con la tuya. Según las reglas, el valor de α debe ser la mitad del valor de α que se utiliza en la prueba de la hipótesis de superioridad, es decir, 0,05 / 2 = 0,025.
Tamaño de la muestra
¿Cómo estimar el tamaño de la muestra? Si crees que la verdadera diferencia de medias entre A y B es 0, entonces el cálculo del tamaño de la muestra será el mismo que al probar la hipótesis de superioridad, excepto que sustituyes el tamaño del efecto por el límite de no menor eficacia, siempre que uses αno menor eficacia = 1/2αsuperioridad (αno inferioridad=1/2αsuperioridad). Si sospechas que la opción B podría ser un poco peor que la opción A, pero deseas demostrar que no es peor en más de Δ, ¡tienes suerte! De hecho, esto reduce el tamaño de tu muestra, porque es más fácil demostrar que B es peor que A si realmente crees que es un poco peor y no equivalente.
Ejemplo con solución
Supongamos que deseas cambiar a la versión B bajo la condición de que no sea peor que la versión A en más de 0.1 puntos en una escala de satisfacción del cliente de 5 puntos… Enfrentemos esta tarea utilizando la hipótesis de superioridad.
Para verificar la hipótesis de superioridad, calcularíamos el tamaño de la muestra de la siguiente manera:
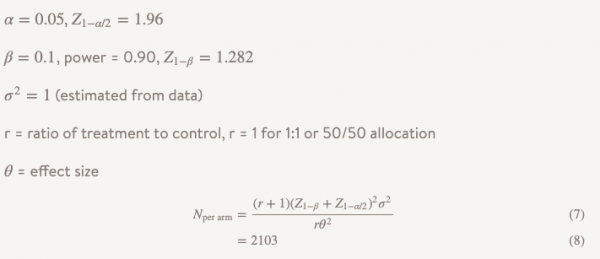
Es decir, si tienes 2103 observaciones en tu grupo, puedes estar al 90% seguro de que detectarás un efecto de 0.10 o más. Pero si el valor de 0.10 es demasiado grande para ti, tal vez no valga la pena verificar la hipótesis de superioridad para ello. Es posible que, por fiabilidad, decidas realizar un estudio para un tamaño de efecto más pequeño, como 0.05. En ese caso, necesitarías 8407 observaciones, lo que significa que el tamaño de la muestra aumentaría casi 4 veces. Pero, ¿qué pasaría si nos mantenemos en nuestro tamaño de muestra original, pero aumentamos la potencia a 0.99, para que no tengamos dudas si obtenemos un resultado positivo? En ese caso, n para un grupo sería 3676, lo cual ya es mejor, pero incrementa el tamaño de la muestra más de un 50%. Y al final, aún así simplemente no podremos refutar la hipótesis nula, sin obtener una respuesta a nuestra pregunta.
¿Y si en su lugar verificamos la hipótesis de no menor efectividad?
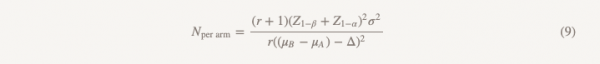
El tamaño de la muestra se calculará con la misma fórmula, excepto por el denominador.
Las diferencias con la fórmula utilizada al verificar la hipótesis de superioridad son las siguientes:
— Z1−α/2 se reemplaza por Z1−α, pero si lo haces bien, reemplazas α = 0.05 por α = 0.025, es decir, es el mismo número (1.96)
— en el denominador aparece (μB−μA)
— θ (tamaño del efecto) se reemplaza por Δ (límite de no menor efectividad)
Si suponemos que µB = µA, entonces (µB − µA) = 0 y el cálculo del tamaño de la muestra para el límite de no menor eficiencia es precisamente lo que obtendríamos al calcular la superioridad para un tamaño del efecto de 0,1, ¡excelente! Podemos realizar un estudio de la misma escala con diferentes hipótesis y otro enfoque para las conclusiones, y obtendremos la respuesta a la pregunta que realmente queremos responder.
Ahora supongamos que en realidad no consideramos que µB = µA y
pensamos que µB es un poco peor, tal vez en 0,01 unidades. Esto aumenta nuestro denominador, reduciendo el tamaño de la muestra del grupo a 1737.
¿Qué pasaría si la versión B es en realidad mejor que la versión A? Rechazamos la hipótesis nula de que B es peor que A por más de Δ y aceptamos la hipótesis alternativa de que B, si es peor, no es peor que Δ, y puede ser mejor. Intenta incluir esta conclusión en una presentación interfuncional y veamos qué sale de ello (en serio, inténtalo). En una situación donde se necesita orientación hacia el futuro, nadie quiere aceptar "no peor que Δ y, posiblemente, mejor".
En este caso, podemos realizar un estudio que se llama muy brevemente "prueba de hipótesis de que una de las opciones supera a la otra o le cede". Utiliza dos conjuntos de hipótesis:
El primer conjunto (el mismo que al probar la hipótesis de no menor eficiencia):
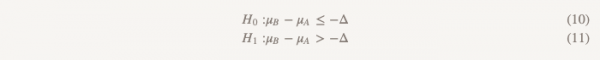
El segundo conjunto (el mismo que al probar la hipótesis de superioridad):
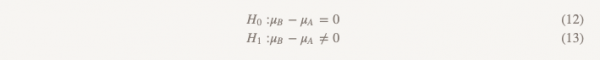
Verificamos la segunda hipótesis solo si se rechaza la primera. En las pruebas secuenciales mantenemos el nivel general de errores de primer tipo (α). En la práctica, esto puede lograrse creando un intervalo de confianza del 95 % para la diferencia entre las medias y verificando para determinar si todo el intervalo supera -Δ. Si el intervalo no supera -Δ, no podemos rechazar la nulidad y paramos. Si todo el intervalo realmente supera -Δ, continuaremos y veremos si el intervalo contiene 0.
Hay otro tipo de estudios que no hemos discutido: estudios de equivalencia.
Los estudios de este tipo pueden ser reemplazados por investigaciones para probar la hipótesis de equivalencia y viceversa, pero tienen una diferencia importante. Un ensayo para verificar la hipótesis de no inferioridad tiene como objetivo demostrar que la opción B es al menos tan buena como la A. En cambio, un estudio de equivalencia tiene como objetivo demostrar que la opción B es al menos tan buena como la A, y que la opción A es también tan buena como la B, lo cual es más complicado. Esencialmente, estamos tratando de determinar si todo el intervalo de confianza para la diferencia de medias se encuentra entre −Δ y Δ. Estos estudios requieren un tamaño de muestra mayor y se realizan con menor frecuencia. Por lo tanto, la próxima vez que realice un estudio en el que su objetivo principal sea asegurarse de que la nueva versión no es peor, no acepte “la incapacidad de refutar la hipótesis nula”. Si desea probar una hipótesis realmente importante, considere diferentes opciones.
Fuente: habr.com
