

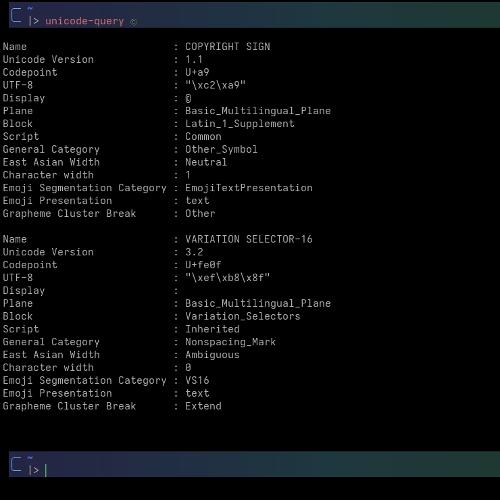
Se ha lanzado la versión 0.9.0 de la biblioteca para el lenguaje C++ (estándar C++20) libunicode. El proyecto está siendo desarrollado por un equipo de desarrolladores del emulador de terminal Contour y de la shell Endo (en desarrollo activo), y se distribuye bajo la licencia Apache 2.0.
Las capacidades de la biblioteca:
- soportan estándares Unicode 17.0:
- API para obtener propiedades de Unicode;
- optimización SIMD de algunas funciones (utilizando std::simd o std::experimental::simd si están disponibles);
- conversión optimizada de UTF-8 <-> UTF-16/UTF-32;
- equivalente a la función wcwidth (int unicode::width(char32_t));
- segmentación de texto por grafemas, caracteres, emojis y escrituras;
- transformación de mayúsculas y comparación de cadenas;
- API de alto nivel para la segmentación de texto, adecuada para la implementación de formateo de texto.
- cobertura de pruebas para la mayoría de las capacidades de la biblioteca (anchura de caracteres y segmentación).
El paquete también incluye la utilidad de consola unicode-query para obtener información detallada sobre cadenas.
Cambios:
- se ha añadido API grapheme_cluster_width;
- mejoras en el manejo de versiones de Unicode (‘Age’);
- soporte completo UAX #15 Formas de Normalización Unicode con manejo de procesamiento en flujo:
normalizer norm(Normalization_Form::NFC); // Alimentar e descompuesto + agudo combinante, luego un nuevo iniciador para activar la emisión auto result = norm.feed(U’e’); CHECK(result.empty()); // aún en almacenamiento result = norm.feed(U’u0301′); CHECK(result.empty()); // aún en almacenamiento (marca combinante) result = norm.feed(U’x’); // el iniciador activa la emisión del segmento anterior REQUIRE_FALSE(result.empty()); CHECK(result == U"u00E9"); // e + agudo compuesto a e-agudo result = norm.flush(); CHECK(result == U"x"); // segmento final
- la función script_extensions ahora devuelve std::optional<std::span<Script const>>;
- se ha implementado la regla GB9c de segmentación de grupos de grafemas para combinaciones de caracteres en lenguas del grupo Indic;
- en grapheme_segmenter se han corregido las reglas para GB11 y GB4/GB5; se ha eliminado la API obsoleta;
- se ha implementado conversión optimizada SIMD de UTF-8 a UTF-16/UTF-32;
- la anchura de los caracteres combinantes Hangul V/T ahora es cero;
- se ha implementado segmentación en los límites de las palabras;
- correcciones en la API de C;
- refactorización del sistema de construcción y generador de tablas auxiliares de C++;
- se han añadido pruebas complejas para la conversión de UTF-16/UTF-32;
- se ha añadido construcción estática de la utilidad unicode-query en CI.
Fuente: linux.org.ru
