

Recientemente se lanzó , que muestra bastante bien la tendencia en el aprendizaje automático de los últimos años. En resumen: el número de startups en el ámbito del aprendizaje automático ha disminuido drásticamente en los últimos dos años.
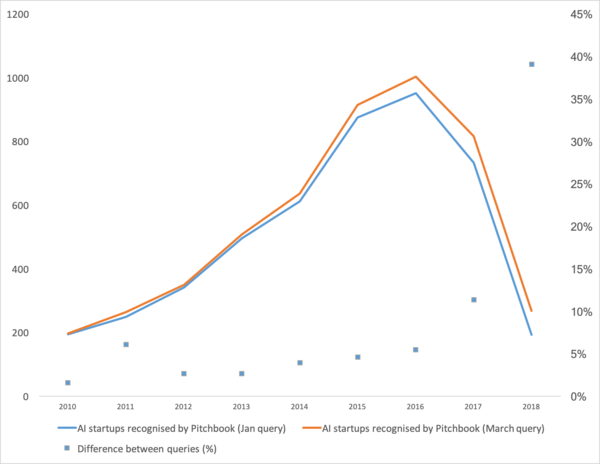
Bueno. Analicemos si "la burbuja ha estallado", "cómo seguir adelante" y hablemos sobre de dónde proviene esta situación.
Para comenzar, hablemos de qué fue el impulsor de esta curva. ¿De dónde surgió? Probablemente todos recordarán del aprendizaje automático en 2012 en el concurso ImageNet. ¡Ese fue el primer evento global! Pero en realidad no es así. Y el crecimiento de la curva comienza un poco antes. Yo dividiría esto en varios momentos.
- El año 2008 es la aparición del término "big data". Los productos reales comenzaron desde 2010. Los big data están directamente relacionados con el aprendizaje automático. Sin big data, el funcionamiento estable de los algoritmos que existían en ese momento es imposible. Y no son redes neuronales. Hasta 2012, las redes neuronales eran cosa de una minoría marginal. Sin embargo, en ese momento empezaron a funcionar algoritmos completamente diferentes que ya existían durante años, si no décadas: (1963, 1993), (1995), (2003),... Las startups de esos años están principalmente relacionadas con el procesamiento automático de datos estructurados: cajas registradoras, usuarios, publicidad, y mucho más.
La derivada de esta primera ola es un conjunto de frameworks, como XGBoost, CatBoost, LightGBM, etc.
- En 2011-2012 ganaron varios concursos de reconocimiento de imágenes. Su uso real se demoró un poco. Diría que las startups y soluciones sensatas comenzaron a aparecer masivamente desde 2014. Se necesitaron dos años para asimilar que las redes neuronales funcionaban, crear marcos de trabajo que pudieran instalarse y ejecutarse en un tiempo razonable, desarrollar métodos que estabilizaran y aceleraran el tiempo de convergencia.
Las redes convolucionales permitieron abordar tareas de visión por computadora: clasificación de imágenes y objetos en imágenes, detección de objetos, reconocimiento de objetos y personas, mejora de imágenes, etc.
- 2015-2017 años. Boom de algoritmos y proyectos relacionados con redes recurrentes o sus análogos (LSTM, GRU, TransformerNet, etc.). Aparecieron algoritmos efectivos para "voz a texto", sistemas de traducción automática. Parte de ellos se basan en redes convolucionales para extraer características básicas. Parte de que han aprendido a reunir conjuntos de datos realmente grandes y de calidad.
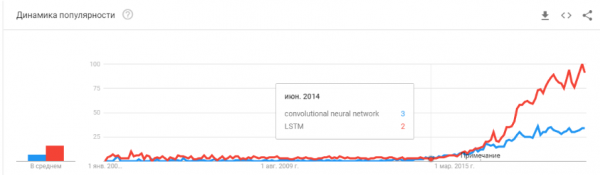
"¿La burbuja estalló? ¿El hype está sobrecalentado? ¿Han muerto como el blockchain?"
¡Sí, claro! Mañana Siri dejará de funcionar en tu teléfono, y pasado mañana Tesla no podrá distinguir entre un giro y un canguro.
Las redes neuronales ya están funcionando. Están en decenas de dispositivos. Realmente permiten generar ingresos, cambian el mercado y el mundo que nos rodea. El hype se ve un poco diferente:
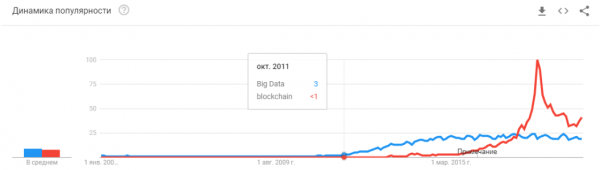
Simplemente las redes neuronales han dejado de ser algo nuevo. Sí, muchas personas tienen expectativas desmedidas. Pero un gran número de empresas ha aprendido a aplicar redes neuronales en su trabajo y a crear productos basados en ellas. Las redes neuronales ofrecen nuevas funcionalidades, permiten reducir los puestos de trabajo y disminuir el costo de los servicios:
- Las empresas manufactureras integran algoritmos para analizar defectos en la línea de producción.
- Las granjas ganaderas compran sistemas para el control del ganado.
- Cosechadoras automáticas.
- Centros de llamadas automatizados.
- Filtros en SnapChat. (¡algo útil por fin!)
Pero lo principal, y no tan obvio: "No hay más ideas nuevas, o no generarán capital instantáneo". Las redes neuronales han resuelto decenas de problemas. Y resolverán aún más. Todas las ideas evidentes que existían dieron lugar a numerosos startups. Pero todo lo que estaba a la vista ya ha sido explorado. En los últimos dos años no he encontrado ninguna nueva idea para aplicar las redes neuronales. Ningún nuevo enfoque (bueno, un poco de problemas con los GANs).
Y cada nuevo startup es cada vez más complicado. Ya no se trata de dos personas enseñando a la red neuronal con datos abiertos. Se requiere programadores, servidores, un equipo de etiquetadores, soporte complejo, etc.
Como resultado, hay menos startups. Pero hay más producción. ¿Necesitas implementar reconocimiento de matrículas? Hay cientos de especialistas en el mercado con experiencia relevante. Se puede contratar, y en unos meses tu empleado hará el sistema. O puedes comprar uno ya hecho. ¿Pero crear una nueva startup? ¡Una locura!
Es necesario crear un sistema de seguimiento de visitantes: ¿por qué pagar por un montón de licencias, cuando en 3-4 meses se puede hacer uno propio, adaptado a su negocio?
Ahora las redes neuronales están pasando por el mismo camino que muchas otras tecnologías.
¿Recuerdas cómo ha cambiado desde 1995 el concepto de "desarrollador de sitios web"? Mientras el mercado no está saturado de especialistas. Hay muy pocos profesionales. Pero puedo debatir que dentro de 5-10 años no habrá una diferencia significativa entre un programador de Java y un desarrollador de redes neuronales. Ambos tipos de especialistas serán suficientes en el mercado.
Simplemente habrá un tipo de tarea para la cual se resolverá mediante redes neuronales. Surge una tarea: contratas a un especialista.
¿Y ahora qué? ¿Dónde está la inteligencia artificial prometida?
Aquí hay una pequeña, pero interesante confusión :)
El stack de tecnologías que existe hoy en día, al parecer, no nos llevará a la inteligencia artificial. Las ideas, su novedad, en gran medida se han agotado. Hablemos sobre lo que sostiene el nivel actual de desarrollo.
Limitaciones
Comencemos con los vehículos autónomos. Parece claro que hacer automóviles completamente autónomos con la tecnología actual es posible. Pero ¿en cuántos años sucederá? No está claro. Tesla cree que sucederá en un par de años -
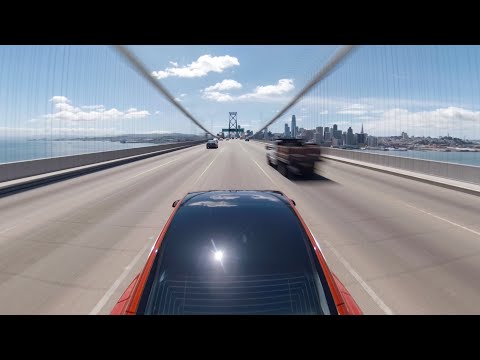
Hay muchos otros , que lo evalúan como 5-10 años.
Probablemente, en mi opinión, en unos 15 años la infraestructura de las ciudades cambiará por sí sola de tal manera que la aparición de automóviles autónomos se volverá inevitable, será una continuación de la misma. Pero eso no se puede considerar inteligencia. El Tesla moderno es una cadena de montaje muy compleja para filtrar datos, buscarlos y volver a entrenarlos. Son reglas-reglas-reglas, recopilación de datos y filtros sobre ellos (bueno, escribí un poco más sobre esto, o mira con la marca).
El primer problema
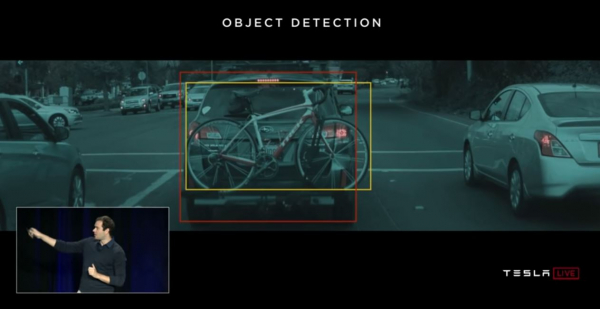
Y es aquí donde vemos el primer problema fundamental. Grandes datos. Eso es precisamente lo que ha generado la actual ola de redes neuronales y aprendizaje automático. Ahora, para hacer algo complejo y automático, se necesitan muchos datos. No solo muchos, sino muchísimos. Se requieren algoritmos automatizados para su recopilación, etiquetado y uso. Si queremos que una máquina vea camiones contra el sol, primero necesitamos reunir una cantidad suficiente. Si queremos que la máquina no se confunda con la bicicleta atada al maletero, necesitamos más muestras.
Y no basta con un solo ejemplo. ¿Cientos? ¿Miles?
El segundo problema
El segundo problema — es la visualización de lo que nuestra red neuronal ha entendido. Esta es una tarea muy no trivial. Hasta ahora, muy pocos comprenden cómo visualizarlo. Estos artículos son bastante recientes, y son solo algunos ejemplos, aunque lejanos:
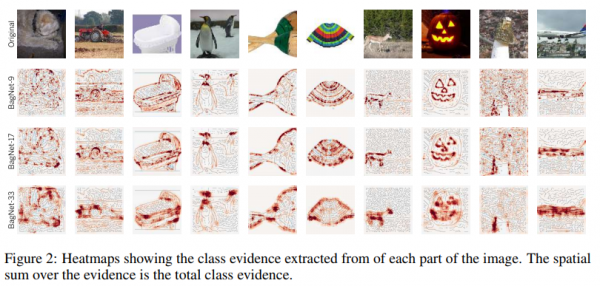
el enfoque en las texturas. Muestra bien en qué se tiende a enfocar la red neuronal y qué percibe como información de partida.
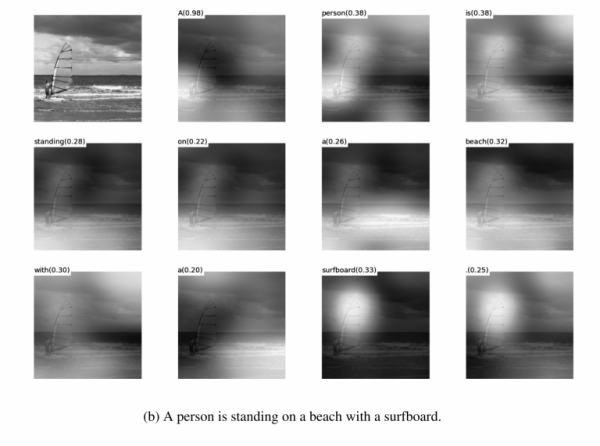
atención en . La atención se puede utilizar a menudo precisamente para mostrar qué provocó esa reacción en la red. He visto cosas así tanto para depurar como para soluciones de producto. Hay muchos artículos sobre este tema. Pero cuanto más complejos son los datos, más difícil es entender cómo lograr una visualización estable.
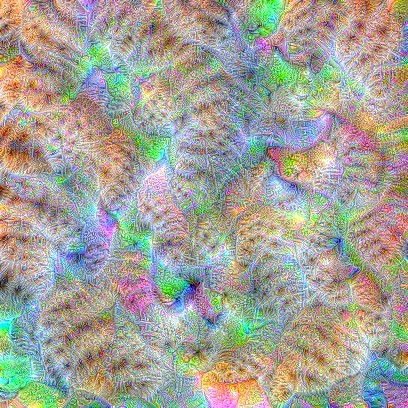
Y sí, el viejo y querido conjunto de «mira qué hay dentro de la red en ». Estas imágenes fueron populares hace unos 3-4 años, pero todos rápidamente se dieron cuenta de que eran imágenes bonitas, pero poco útiles.
No he mencionado decenas de otros trucos, métodos, hacks e investigaciones sobre cómo mostrar el interior de la red. ¿Funcionan estas herramientas? ¿Ayudan a entender rápidamente cuál es el problema y a depurar la red?.. ¿Extraer los últimos porcentajes? Bueno, más o menos así:
Puedes ver cualquier competencia en Kaggle. Y la descripción de cómo la gente hace las soluciones finales. ¡Hemos acumulado de 100 a 500 a 800 millones de modelos y ha funcionado!
Por supuesto, estoy exagerando. Pero estos enfoques no brindan respuestas rápidas y directas.
Con suficiente experiencia, probando diferentes opciones, se puede emitir un veredicto sobre por qué su sistema tomó tal decisión. Pero ajustar el comportamiento del sistema será complicado. Colocar un parche, mover un umbral, agregar un conjunto de datos, tomar otra red en la parte posterior.
El tercer problema
El tercer problema fundamental Las redes neuronales no aprenden lógica, sino estadística. Estadísticamente esto :
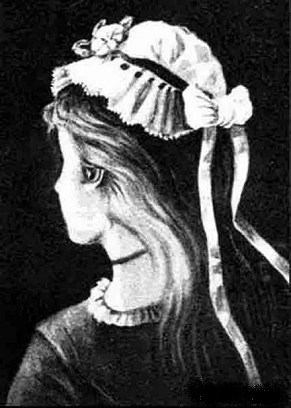
Lógicamente, no se parece mucho. Las redes neuronales no aprenden algo complejo a menos que se les exija. Siempre aprenden características lo más simples posible. ¿Hay ojos, nariz, cabeza? ¡Entonces es una cara! O trae un ejemplo donde los ojos no signifiquen cara. Y de nuevo: millones de ejemplos.
Hay mucho espacio en la parte inferior
Diría que justamente estos tres problemas globales limitan el desarrollo de las redes neuronales y el aprendizaje automático hoy en día. Y donde estos problemas no limitaban, ya se usa activamente.
¿Es esto el fin? ¿Se han estancado las redes neuronales?
No se sabe. Pero, por supuesto, todos esperan que no.
Hay muchos enfoques y direcciones para resolver los problemas fundamentales que he mencionado arriba. Pero hasta ahora, ninguno de estos enfoques ha logrado hacer algo fundamentalmente nuevo, resolver algo que todavía no se había resuelto. Hasta el momento, todos los proyectos fundamentales se realizan sobre la base de enfoques estables (Tesla), o permanecen como proyectos de prueba de instituciones o corporaciones (Google Brain, OpenAI).
Hablando en términos simples, la dirección principal es crear una especie de representación de alto nivel de los datos de entrada. En cierto sentido, una "memoria". El ejemplo más simple de memoria son los diferentes "Embedding" — representaciones de imágenes. Por ejemplo, todos los sistemas de reconocimiento facial. La red aprende a obtener de una cara una representación estable que no dependa de la rotación, la iluminación o la resolución. En esencia, la red minimiza la métrica "diferentes caras — lejos" y "similares — cerca".
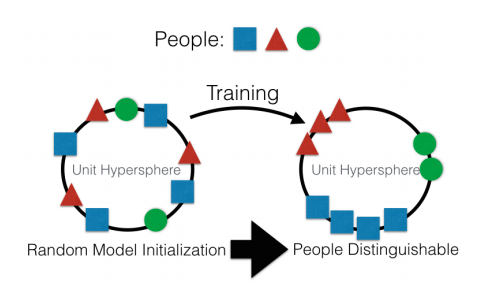
Para este aprendizaje se necesitan decenas y cientos de miles de ejemplos. Sin embargo, el resultado lleva ciertos indicios de "One-shot Learning". Ahora no necesitamos cientos de caras para recordar a una persona. Con solo una cara, ya !
Solo que hay un pequeño problema... La red puede aprender solo objetos bastante simples. Al intentar diferenciar no caras, sino, por ejemplo, "personas por su vestimenta" (tarea ) — la calidad cae en muchos órdenes. Y la red ya no puede aprender cambios de ángulo que son bastante obvios.
Además, aprender con millones de ejemplos tampoco es un entretenimiento muy agradable.
Existen trabajos sobre la reducción significativa de ejemplos. Por ejemplo, se puede recordar uno de los primeros trabajos sobre OneShot Learning :
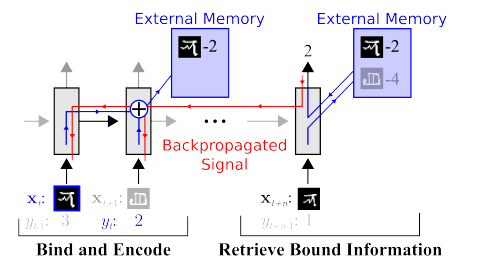
Hay muchos trabajos así, por ejemplo o o .
Una desventaja es que el aprendizaje generalmente funciona bien en algunos ejemplos simples, como los de "MNIST". Pero al pasar a tareas más complejas, se necesita una base de datos más grande, un modelo de objetos, o algún tipo de magia.
El trabajo en el aprendizaje One-Shot es un tema realmente interesante. Se encuentran muchas ideas. Pero en su mayoría, los dos problemas que mencioné (preentrenamiento en un gran conjunto de datos / inestabilidad en datos complejos) dificultan mucho el aprendizaje.
Por otro lado, el tema de Embedding se aborda con GAN, redes generativas antagónicas. Seguro que has leído numerosos artículos sobre este tema en Habr., ,)
Una característica de los GAN es la formación de un cierto espacio interno de estados (en esencia, lo mismo que el Embedding), que permite crear imágenes. Esto puede ser , pueden ser .
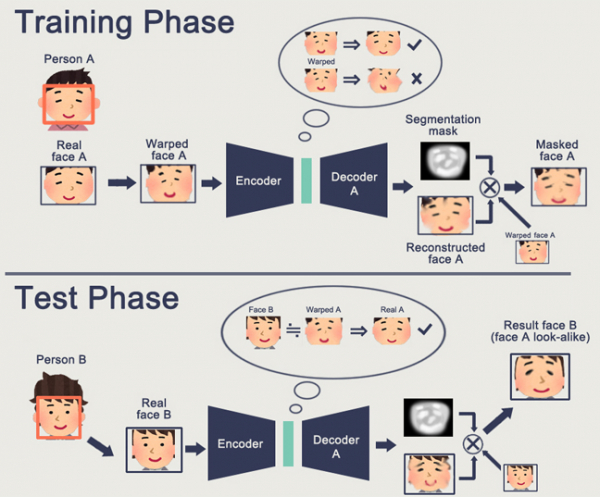
El problema de los GAN es que cuanto más complejo es el objeto generado, más difícil es describirlo dentro de la lógica de "generador-discriminador". Como resultado, en las aplicaciones reales de GAN, que son conocidas, solo está DeepFake, que de nuevo, manipula representaciones de rostros (para los cuales existe una gran base de datos).
He encontrado muy pocas aplicaciones útiles. Normalmente son solo gadgets que rellenan imágenes.
Y de nuevo. Nadie tiene claro cómo esto nos permitirá avanzar hacia un futuro brillante. La representación de lógica/espacio en una red neuronal es buena. Pero se necesita un número enorme de ejemplos, no sabemos cómo la red neuronal representa esto, y no entendemos cómo hacer que la red neuronal memorice una representación realmente compleja.
El aprendizaje por refuerzo es un enfoque completamente diferente. Seguro que recuerdas cómo Google venció a todos en Go. Las recientes victorias en Starcraft y Dota. Pero aquí las cosas no son tan optimistas ni prometedoras. El autor cuenta mejor sobre el RL y sus complejidades. .
Si resumimos brevemente lo que escribió el autor:
- Los modelos de caja de herramientas no son adecuados / funcionan mal en la mayoría de los casos.
- Es más fácil resolver tareas prácticas de otras maneras. Boston Dynamics no utiliza RL debido a su complejidad e imprevisibilidad.
- Para que el RL funcione, se necesita una función compleja. A menudo es difícil de crear / escribir.
- Es complicado entrenar modelos. Se tiene que gastar mucho tiempo para desarrollarlos y salir de óptimos locales.
- Como consecuencia, es difícil replicar el modelo y hay inestabilidad en el modelo con los más mínimos cambios.
- A menudo se sobreajusta a patrones aleatorios, hasta llegar a un generador de números aleatorios.
El punto clave es que el RL aún no funciona en producción. Google tiene algunos experimentos ( , ). Pero no he visto ningún sistema productivo.
Memoria. La desventaja de todo lo mencionado anteriormente es la no estructuración. Uno de los enfoques para intentar organizar todo esto es proporcionar a la red neuronal acceso a una memoria separada. Para que pueda escribir y reescribir allí los resultados de sus pasos. Entonces, la red neuronal puede definirse por el estado actual de la memoria. Esto es muy similar a los procesadores y computadoras clásicos.
La más conocida y popular — de DeepMind:
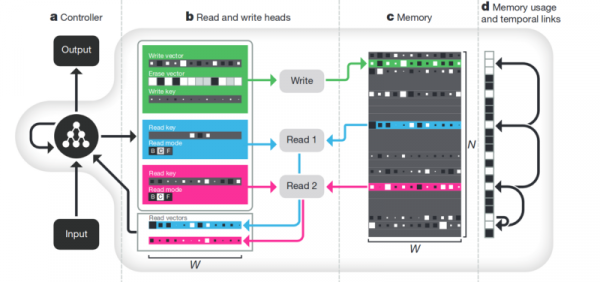
¿Parece que aquí está la clave para entender la inteligencia? Pero más bien no. El sistema aún requiere un enorme conjunto de datos para el entrenamiento. Y funciona principalmente con datos tabulares estructurados. Al mismo tiempo, cuando Facebook un problema similar, decidieron ir por el camino de 'olvidemos la memoria, simplemente hagamos la red neuronal más compleja y tengamos más ejemplos, y ella se entrenará sola'.
Desenredamiento. Otra forma de crear una memoria significativa es tomar los mismos embeddings, pero al entrenar, introducir criterios adicionales que permitan destacar en ellos los 'significados'. Por ejemplo, queremos entrenar una red neuronal para distinguir el comportamiento de una persona en una tienda. Si hubiéramos ido por el camino estándar, tendríamos que haber creado diez redes. Una que busca a la persona, otra que determina qué está haciendo, una tercera su edad, una cuarta — su género. Una lógica separada observa la parte de la tienda donde está haciendo/aprendiendo sobre esto. Una tercera determina su trayectoria, etc.
O, si hubiera una cantidad infinita de datos, se podría entrenar una sola red en todos los posibles resultados (es evidente que no se puede reunir tal conjunto de datos).
El enfoque de desenredamiento nos dice: ¿por qué no entrenamos la red de tal manera que pueda distinguir conceptos por sí misma? Para que, a partir del video, formara un embedding, donde una área definiera la acción, otra — la posición en el tiempo en el suelo, otra — la altura de la persona, y otra más — su género. Al mismo tiempo, en el entrenamiento, nos gustaría casi no sugerir a la red conceptos clave, sino que ella los destacara y agrupase áreas por sí sola. Hay suficientes artículos de este tipo (algunos de ellos , , ) y en general son bastante teóricos.
Pero esta dirección, al menos teóricamente, debería abordar los problemas mencionados al principio.
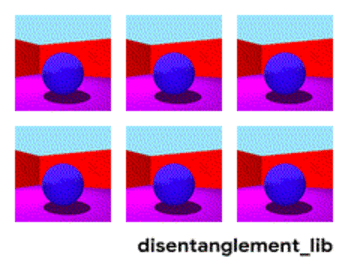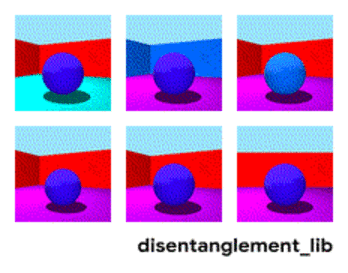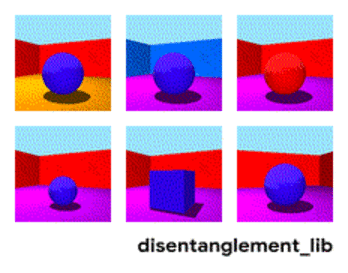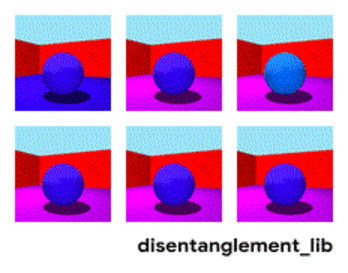
Descomposición de la imagen según los parámetros "color de las paredes/color del suelo/forma del objeto/color del objeto/etc."
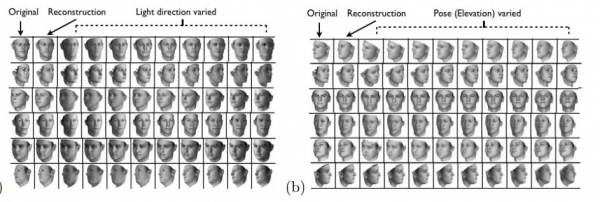
Descomposición del rostro según los parámetros "tamaño, cejas, orientación, color de piel, etc."
Otros
Hay muchas otras direcciones no tan globales, que permiten reducir las bases de datos, trabajar con datos más heterogéneos, etc.
Atención. Probablemente, no tiene sentido destacar esto como un método separado. Simplemente es un enfoque que refuerza a otros. Hay muchos artículos dedicados a él (,,). El sentido de la atención es reforzar la reacción de la red a los objetos significativos durante el entrenamiento. A menudo mediante alguna indicación externa o una pequeña red externa.
Simulación 3D. Si se hace un buen motor 3D, a menudo se puede cubrir el 90% de los datos de entrenamiento (incluso he visto un ejemplo en el que casi el 99% de los datos estaban cubiertos por un buen motor). Hay muchas ideas y trucos para hacer que una red entrenada en un motor 3D funcione con datos del mundo real (ajuste fino, transferencia de estilo, etc.). Pero a menudo hacer un buen motor es varias órdenes de magnitud más difícil que recopilar datos. Ejemplos de cuando se hicieron motores:
Entrenamiento de robots (, )
Formación de productos en la tienda (pero en dos proyectos que hicimos, fácilmente podíamos prescindir de esto).
Entrenamiento en Tesla (de nuevo, el video mencionado anteriormente).
Conclusiones
Todo el artículo es, de alguna manera, una conclusión. Probablemente, el mensaje principal que quería transmitir es: “la bonanza ha terminado, las redes neuronales ya no ofrecen soluciones simples”. Ahora hay que trabajar duro construyendo soluciones complejas. O esforzarse haciendo investigaciones científicas complejas.
En general, el tema es discutible. Quizás los lectores tengan ejemplos más interesantes.
Fuente: habr.com
