

Los sistemas de información modernos son bastante complejos. No en última instancia, su complejidad se debe a la complejidad de los datos que procesan. La complejidad de los datos a menudo radica en la diversidad de los modelos de datos utilizados. Por ejemplo, cuando los datos se vuelven "grandes", una de las características que causa inconvenientes no es solo su volumen, sino también su variedad.
Si aún no encuentras defecto en los razonamientos, sigue leyendo.
Contenido
Persistencia poliglota
Lo anterior lleva a que a veces, incluso dentro de un mismo sistema, se necesiten varias SGBD diferentes para almacenar datos y resolver diversas tareas de procesamiento, cada una de las cuales soporta su propio modelo de datos. A iniciativa de M. Fowler, varias obras reconocidas y uno de del Manifiesto Ágil, esta situación ha sido denominada almacenamiento polivalente ("polyglot persistence").
Fowler también ofrece el siguiente ejemplo de organización del almacenamiento de datos en una aplicación completamente funcional y de alta carga en el campo del comercio electrónico.
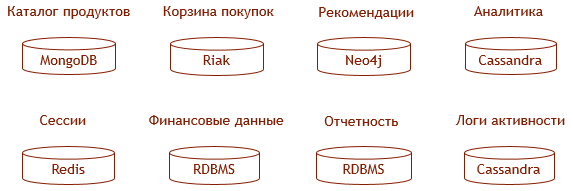
Este ejemplo, por supuesto, es algo exagerado, pero se pueden encontrar algunas consideraciones a favor de la elección de un SGBD específico para un propósito determinado, por ejemplo, .
Es claro que ser un administrador en tal zoológico no es fácil.
- El volumen de código que realiza el almacenamiento de datos crece proporcionalmente al número de SGBD utilizados; el volumen de código que sincroniza los datos, está bien si no es proporcional al cuadrado de ese número.
- Los costos para garantizar características empresariales (escalabilidad, tolerancia a fallos, alta disponibilidad) de cada uno de los SGBD utilizados aumentan de manera exponencial con el número de SGBD empleados.
- No es posible garantizar las características empresariales de la subsistema de almacenamiento en su conjunto, especialmente la transaccionalidad.
Desde la perspectiva del director del zoológico, todo se ve así:
- Un aumento exponencial en los costos de licencias y soporte técnico por parte del fabricante del SGBD.
- Influencia en el personal y ampliación de los plazos.
- Pérdidas financieras directas o sanciones por falta de coherencia en los datos.
Hay un aumento significativo en el costo total de propiedad del sistema (TCO). ¿Hay alguna salida de la situación de "almacenamiento multivariante"?
Multimodalidad
El término "almacenamiento multivariante" se popularizó en 2011. Tomó varios años reconocer los problemas del enfoque y buscar soluciones, y para 2015 los analistas de Gartner formularon la respuesta:
- De "»:
El futuro de las bases de datos, su arquitectura y formas de uso — multimodalidad.
- De "»:
Las principales bases de datos operacionales ofrecerán varios modelos — relacional y no relacionales — dentro de una única plataforma.
Parece que esta vez los analistas de Gartner no se han equivocado en sus pronósticos. Si se accede a la página con el de bases de datos en DB-Engines, se puede ver que lamayor audiencia.mayoría de sus líderes se posiciona precisamente como bases de datos multimodales. Lo mismo se puede observar en la página de cualquier ranking específico.
En la tabla a continuación, se presentan las bases de datos — líderes en cada uno de los rankings específicos, que afirman su multimodalidad. Para cada base de datos se indica el modelo inicialmente soportado (que alguna vez fue el único) y junto a él, los modelos que se soportan actualmente. También se presentan las bases de datos que se posicionan como "multimodales desde el principio", que según sus creadores no tienen ningún modelo heredado inicial.
| SGBD | Modelo inicial | Modelos adicionales |
|---|---|---|
| Oracle | Relacional | Grafos, documentos |
| MS SQL | Relacional | Grafos, documentos |
| PostgreSQL | Relacional | Grafos*, documentos |
| MarkLogic | Documentos | Grafos, relacional |
| MongoDB | Documentos | Clave-valor, grafos* |
| DataStax | Columna amplia | Documentos, grafos |
| Redis | Clave-valor | Documentos, grafos* |
| ArangoDB | — | Grafos, documentos |
| OrientDB | — | Grafos, documentos, relacional |
| Azure CosmosDB | — | Grafos, documentos, relacional |
Notas sobre la tabla
Las afirmaciones marcadas con asteriscos en la tabla requieren aclaraciones:
- La base de datos PostgreSQL no soporta el modelo de datos de grafos, sin embargo un producto basado en ella , en su caso.
- Es más apropiado hablar de la existencia de operadores de grafos en el lenguaje de consultas de MongoDB (, ), que de la soporte del modelo de grafos, aunque, por supuesto, su introducción requirió algunas optimizaciones a nivel de almacenamiento físico en dirección al soporte del modelo de grafos.
- En relación con Redis, se refiere a la extensión .
A continuación, para cada una de las clases, mostraremos cómo se implementa el soporte para múltiples modelos en las bases de datos de este tipo. Consideraremos más importantes los modelos relacional, de documentos y gráfico, y mostraremos con ejemplos de bases de datos concretas cómo se implementan los "faltantes".
SGBD multimodales basados en el modelo relacional
Las principales bases de datos en la actualidad son relacionales; no se podría considerar como cumplida la predicción de Gartner si los RDBMS no mostraran movimientos hacia la multimodalidad. Y lo están demostrando. Ahora los argumentos de que una base de datos multimodal es como un cuchillo suizo, con el que no se puede hacer nada bien, se pueden dirigir directamente a Larry Ellison.
Sin embargo, al autor le gusta más la implementación de la multimodalidad en Microsoft SQL Server, en cuyo ejemplo se describirá el soporte de RDBMS para los modelos de documentos y gráficos.
Modelo de documento en MS SQL Server
Sobre cómo se implementa el soporte para el modelo de documentos en MS SQL Server, ya ha habido dos excelentes artículos en Habr, por lo que me limitaré a un breve resumen y comentario:
El modo de soporte del modelo de documentos en MS SQL Server es bastante típico para las bases de datos relacionales: se propone almacenar documentos JSON en campos de texto convencionales. El soporte para el modelo de documentos consiste en proporcionar operadores especiales para analizar ese JSON:
- para extraer valores escalares de atributos,
- para extraer subdocumentos.
El segundo argumento de ambos operadores es una expresión en una sintaxis similar a JSONPath.
De manera abstracta, se puede decir que los documentos almacenados de esta manera no son "entidades de primera clase" en una base de datos relacional, a diferencia de las tuplas. En concreto, en MS SQL Server, actualmente no existen índices para los campos de los documentos JSON, lo que dificulta las operaciones de unión de tablas por los valores de estos campos e incluso la selección de documentos por estos valores. Sin embargo, es posible crear una columna calculada para dicho campo y un índice sobre ella.
Además, MS SQL Server ofrece la posibilidad de construir fácilmente un documento JSON a partir del contenido de las tablas mediante el operador una opción, en cierto sentido opuesta a la anterior, al almacenamiento convencional. Está claro que, por muy rápida que sea una base de datos de documentos, este enfoque contradice la ideología de las bases de datos de documentos, que en esencia almacenan las respuestas preparadas a consultas populares, y puede resolver solo problemas de conveniencia en el desarrollo, pero no de rendimiento.
Finalmente, MS SQL Server permite resolver la tarea opuesta a la construcción de un documento: se puede descomponer JSON en tablas utilizando . Si el documento no es completamente plano, será necesario usar CROSS APPLY.
Modelo de grafo en MS SQL Server
El soporte para el modelo de gráfico (LPG) se implementa en Microsoft SQL Server de manera : se proponen tablas especiales para almacenar nodos y para almacenar las aristas del gráfico. Estas tablas se crean utilizando expresiones CREATE TABLE AS NODE y CREATE TABLE AS EDGE correspondientemente.
Las tablas del primer tipo son similares a las tablas normales para almacenar registros con la única diferencia externa de que en la tabla hay un campo de sistema $node_id — un identificador único dentro de la base de datos para el nodo del gráfico.
De manera análoga, las tablas del segundo tipo tienen campos de sistema $from_id y $to_id, los registros en estas tablas definen de manera clara las relaciones entre nodos. Para almacenar las relaciones de cada tipo se utiliza una tabla separada.
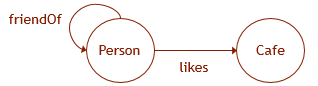 Ilustremos lo dicho con un ejemplo. Supongamos que los datos del gráfico tienen un esquema como el de la imagen proporcionada. Entonces, para crear la estructura correspondiente en la base de datos, es necesario ejecutar las siguientes consultas DDL:
CREATE TABLE Person (
  ID INTEGER NOT NULL,
  name VARCHAR(100)
) AS NODE;

CREATE TABLE Cafe (
  ID INTEGER NOT NULL,
  name VARCHAR(100),
) AS NODE;

CREATE TABLE likes (
  rating INTEGER
) AS EDGE;

CREATE TABLE friendOf
  AS EDGE;

ALTER TABLE likes
  ADD CONSTRAINT EC_LIKES CONNECTION (Person TO Cafe);
La característica principal de estas tablas es que en las consultas se pueden utilizar patrones gráficos con una sintaxis similar a Cypher (sin embargo, «*» y otros aún no son compatibles). Con base en mediciones de rendimiento, también se puede suponer que el modo de almacenamiento de datos en estas tablas es diferente del mecanismo de almacenamiento de datos en tablas comunes y está optimizado para realizar este tipo de consultas gráficas.
SELECT Cafe.name
  FROM Person, likes, Cafe
  WHERE MATCH (Person-(friendOf)-(likes)->Cafe)
  AND Person.name = 'John';
Además, es bastante difícil no utilizar estos patrones gráficos al trabajar con tales tablas, ya que en las consultas SQL normales para resolver problemas similares se requerirá hacer esfuerzos adicionales para obtener identificadores de nodos 'gráficos' del sistema ($node_id, $from_id, $to_id; por esta misma razón, las consultas de inserción de datos no se incluyen aquí como demasiado voluminosas).
Para resumir la descripción de las implementaciones de modelos documentales y gráficos en MS SQL Server, destacaría que tales implementaciones de un modelo sobre otro no parecen exitosas, principalmente desde el punto de vista del diseño del lenguaje. Se requiere expandir un lenguaje con otro, los lenguajes no son del todo 'ortogonales', las reglas de compatibilidad pueden ser bastante peculiares.
SGBD multimodales basados en el modelo de documento
En esta sección quiero ilustrar la implementación de la multimodalidad en bases de datos documentales tomando como ejemplo una de las menos populares, MongoDB (como se mencionó, solo tiene operadores gráficos condicionales $lookup y $graphLookup, que no funcionan en colecciones fragmentadas), sino tomando como ejemplo una base de datos más madura y 'empresarial' .
Así que, supongamos que la colección contiene un conjunto de documentos XML del siguiente tipo (MarkLogic también permite almacenar documentos JSON):
John
  Smith
Modelo relacional en MarkLogic
La representación relacional de la colección de documentos se puede crear utilizando (el contenido de los elementos value en el siguiente ejemplo puede ser un XPath arbitrario):
/Person


      Person


          SSN
          @SSN
          string


          name
          name


          surname
          surname
Se puede dirigir una consulta SQL a la vista creada (por ejemplo, a través de ODBC):
SELECT name, surname FROM Person WHERE name="John"Desafortunadamente, la representación relacional creada mediante la plantilla de mapeo es solo de lectura. Al procesar una consulta hacia ella, MarkLogic intentará utilizar . Antes, en MarkLogic había representaciones relacionales limitadas, basadas completamente en índices и доступные на запись, но сейчас они считаются deprecated.
Modelo de grafo en MarkLogic
Con el soporte del modelo gráfico (RDF), el asunto es aproximadamente el mismo. Nuevamente, con la ayuda de se puede crear una representación RDF de la colección de documentos del ejemplo anterior:
/Person
PREFIX
"http://example.org/example#"
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || surname )
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || name )
Se puede dirigir una consulta SPARQL al gráfico RDF resultante:
PREFIX :
SELECT ?name ?surname {
  :631803299804 :name ?name ; :surname ?surname .
}
A diferencia del modelo relacional, el modelo gráfico de MarkLogic se admite de dos maneras adicionales:
- La base de datos puede ser un almacén de datos RDF completamente independiente (los tripletas en este caso se llamarán en contraste con lo descrito anteriormente ).
- El RDF en una serialización especial puede incrustarse simplemente en documentos XML o JSON (y los tripletas entonces se denominarán ). Probablemente, esto es una alternativa a los mecanismos de
idrefy demás.
Una buena representación de cómo funciona realmente todo en MarkLogic es proporcionada por , en este sentido es de bajo nivel, aunque su objetivo es más bien inverso: intentar abstraerse del modelo de datos utilizado, garantizar un funcionamiento coherente con los datos en varios modelos, la transaccionalidad, etc.
SGBD multimodales "sin modelo principal"
También hay bases de datos en el mercado que se posicionan como multimodales desde sus inicios, sin una modelo principal heredado. Entre ellas se encuentran , (desde 2018, la empresa desarrolladora pertenece a SAP) y (un servicio dentro de la plataforma en la nube de Microsoft Azure).
De hecho, hay "modelos principales" en ArangoDB y OrientDB. En ambos casos, son modelos de datos propios que son generalizaciones del modelo documental. Las generalizaciones consisten principalmente en facilitar la posibilidad de realizar consultas de carácter gráfico y relacional.
Estos modelos son los únicos disponibles para su uso en las bases de datos mencionadas, y están diseñados para trabajar con lenguajes de consulta específicos. Sin duda, estos modelos y bases de datos son prometedores, pero la falta de compatibilidad con modelos y lenguajes estándar hace que sea imposible utilizarlas en sistemas heredados, reemplazando así las bases de datos que ya se utilizan allí.
Sobre ArangoDB y OrientDB ya se publicó un artículo excelente en Habr: .
ArangoDB
ArangoDB declara soporte para el modelo de datos basado en grafos.
Los nodos del grafo en ArangoDB son documentos ordinarios, mientras que las aristas son documentos de un tipo especial que, junto con los campos del sistema comunes, tienen los siguientes campos:_key, _id, _rev) campos del sistema _from y _to. Los documentos en bases de datos de documentos tradicionalmente se agrupan en colecciones. Las colecciones de documentos que representan aristas en ArangoDB se llaman colecciones de aristas. Cabe mencionar que los documentos de las colecciones de aristas también son documentos, por lo que las aristas en ArangoDB pueden actuar como nodos.
Datos de entrada
Supongamos que tenemos una colección persons, cuyos documentos se ven así:
[
  {
    "_id"  : "people/alice" ,
    "_key" : "alice" ,
    "name" : "Alicia"
  },
  {
    "_id"  : "people/bob" ,
    "_key" : "bob" ,
    "name" : "Bob"
  }
]
Supongamos también que hay una colección cafes:
[
  {
    "_id" : "cafes/jd" ,
    "_key" : "jd" ,
    "name" : "John Donne"
  },
  {
    "_id" : "cafes/jj" ,
    "_key" : "jj" ,
    "name" : "Jean-Jacques"
  }
]
Entonces la colección likes podría verse de la siguiente manera:
[
  {
    "_id" : "likes/1" ,
    "_key" : "1" ,
    "_from" : "persons/alice" ,
    "_to" : "cafes/jd",
    "since" : 2010
  },
  {
    "_id" : "likes/2" ,
    "_key" : "2" ,
    "_from" : "persons/alice" ,
    "_to" : "cafes/jj",
    "since" : 2011
  } ,
  {
    "_id" : "likes/3" ,
    "_key" : "3" ,
    "_from" : "persons/bob" ,
    "_to" : "cafes/jd",
    "since" : 2012
  }
]
Consultas y resultados
Una consulta en estilo de grafo en el lenguaje AQL utilizado en ArangoDB, que devuelve en un formato legible por humanos información sobre qué café le gusta a quién, se ve así:
FOR p IN persons
  FOR c IN OUTBOUND p likes
  RETURN { person : p.name , likes : c.name }
En estilo relacional, cuando más bien «calculamos» conexiones en lugar de almacenarlas, esta consulta se podría reescribir así (por cierto, sin la colección likes podríamos haber prescindido de ella):
FOR p IN persons
  FOR l IN likes
  FILTER p._key == l._from
    FOR c IN cafes
    FILTER l._to == c._key
    RETURN { person : p.name , likes : c.name }
El resultado en ambos casos será el mismo:
[
  { "person" : "Alicia" , likes : "Jean-Jacques" } ,
  { "person" : "Alicia" , likes : "John Donne" } ,
  { "person" : "Bob" , likes : "John Donne" }
]
Más consultas y resultados
Si parece que el formato del resultado anterior es más característico de una base de datos relacional que de una documental, se puede intentar con esta consulta (o se puede utilizar ):
FOR p IN persons
  RETURN {
    person : p.name,
    likes : (
      FOR c IN OUTBOUND p likes
      RETURN c.name
    )
}
El resultado tendrá el siguiente formato:
[
  { "person" : "Alicia" , likes : ["Jean-Jacques" , "John Donne"]  } ,
  { "person" : "Bob" , likes : ["John Donne"] }
]
OrientDB
La implementación del modelo gráfico sobre la base de documentos en OrientDB se basa en los campos de documentos que tienen, además de valores escalares más o menos estándar, valores de tipos como LINK, LINKLIST, LINKSET, LINKMAP y LINKBAG. Los valores de estos tipos son referencias o colecciones de referencias a documentos.
El identificador asignado por el sistema al documento tiene un «sentido físico», indicando la posición del registro en la base, y se ve aproximadamente así: @rid : #3:16. Así, los valores de las propiedades de referencia son más bien indicadores (como en el modelo gráfico), y no condiciones de selección (como en el relacional).
Al igual que en ArangoDB, en OrientDB las aristas se representan como documentos separados (aunque si la arista no tiene sus propias propiedades, se puede hacer , y no tendrá un documento correspondiente).
Datos de entrada
En un formato que se asemeja a de la base de OrientDB, los datos del ejemplo anterior para ArangoDB se verían de la siguiente manera:
[
     {
      "@type": "document",
      "@rid": "#11:0",
      "@class": "Persona",
      "name": "Alicia",
      "out_likes": [
        "#30:1",
        "#30:2"
      ],
      "@fieldTypes": "out_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#12:0",
      "@class": "Persona",
      "name": "Bob",
      "out_likes": [
        "#30:3"
      ],
      "@fieldTypes": "out_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#21:0",
      "@class": "Cafetería",
      "name": "Jean-Jacques",
      "in_likes": [
        "#30:2",
        "#30:3"
      ],
      "@fieldTypes": "in_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#22:0",
      "@class": "Cafetería",
      "name": "John Donne",
      "in_likes": [
        "#30:1"
      ],
      "@fieldTypes": "in_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#30:1",
      "@class": "likes",
      "in": "#22:0",
      "out": "#11:0",
      "since": 1262286000000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    },
    {
      "@type": "document",
      "@rid": "#30:2",
      "@class": "likes",
      "in": "#21:0",
      "out": "#11:0",
      "since": 1293822000000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    },
    {
      "@type": "document",
      "@rid": "#30:3",
      "@class": "likes",
      "in": "#21:0",
      "out": "#12:0",
      "since": 1325354400000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    }
  ]
Como vemos, los nodos también almacenan información sobre las aristas entrantes y salientes. Al La API de documento para la integridad referencial requiere seguimiento manual, mientras que la API Graph se encarga de esta tarea. Veamos cómo se ve la consulta a OrientDB en lenguajes de consulta "limpios", no integrados en lenguajes de programación.
Consultas y resultados
Una consulta que tiene un propósito similar a la del ejemplo para ArangoDB en OrientDB se vería así:
SELECT name AS person_name, OUT('likes').name AS cafe_name
   FROM Person
   UNWIND cafe_name
El resultado se obtendrá de la siguiente manera:
[
  { "person_name": "Alicia", "cafe_name": "John Donne" },
  { "person_name": "Alicia", "cafe_name": "Jean-Jacques" },
  { "person_name": "Bob",  "cafe_name": "Jean-Jacques" }
]
Si el formato del resultado parece demasiado "relacional", es necesario eliminar la línea con :
[
  { "person_name": "Alicia", "cafe_name": [ "John Donne", "Jean-Jacques" ] },
  { "person_name": "Bob",  "cafe_name": [ "Jean-Jacques" ] }
]
El lenguaje de consultas de OrientDB puede describirse como SQL con inserciones similares a Gremlin. En la versión 2.2, se introdujo una forma de consulta similar a Cypher. :
MATCH {CLASS: Person, AS: person}-likes->{CLASS: Cafe, AS: cafe}
RETURN person.name AS person_name, LIST(cafe.name) AS cafe_name
GROUP BY person_name
El formato del resultado será el mismo que en la consulta anterior. Piense en qué se necesita eliminar para hacerlo más "relacional", como en la primera consulta.
Azure CosmosDB
Menos relevante lo mencionado anteriormente sobre ArangoDB y OrientDB se aplica a Azure CosmosDB. CosmosDB proporciona las siguientes API de acceso a datos: SQL, MongoDB, Gremlin y Cassandra.
La API SQL y la API MongoDB se utilizan para acceder a datos en el modelo de documentos. La API Gremlin y la API Cassandra se utilizan para acceder a datos en los modelos de grafo y de columna, respectivamente. Los datos en todos los modelos se almacenan en el formato del modelo interno de CosmosDB: ("atom-record-sequence"), que también es similar al del documento.
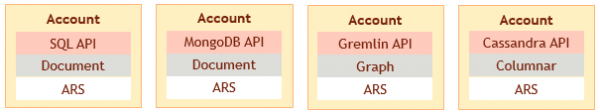
Sin embargo, el modelo de datos elegido por el usuario y la API utilizada se fijan en el momento de crear la cuenta en el servicio. No es posible acceder a los datos cargados en un modelo en el formato de otro modelo, lo que podría ser ilustrado de la siguiente manera:
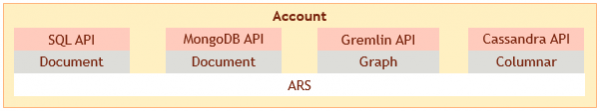
Así, la multimodalidad en Azure CosmosDB presenta actualmente solo la posibilidad de usar varias bases de datos que admiten diferentes modelos de un solo proveedor, lo que no resuelve todos los problemas de almacenamiento variante.
¿SGBD multimodales basados en el modelo de grafo?
Es notable que actualmente no hay DBMS multimodal en el mercado que tenga como base un modelo gráfico (sin contar la multimodalidad del soporte simultáneo de dos modelos gráficos: RDF y LPG; vea sobre esto en ). La mayor dificultad radica en implementar un modelo documental sobre un modelo gráfico, y no relacional.
La cuestión de cómo implementar un modelo relacional sobre un modelo gráfico se discutió ya en los tiempos de la consolidación de este último. Como , por ejemplo, :
No hay nada inherente en el enfoque gráfico que impida crear una capa (por ejemplo, mediante un índice adecuado) sobre una base de datos gráfica que permita una vista relacional con (1) recuperación de tuplas de los habituales pares clave-valor y (2) agrupamiento de tuplas por tipo de relación.
Al implementar un modelo documental sobre un modelo gráfico, se debe tener en cuenta, por ejemplo, lo siguiente:
- Los elementos de un array JSON se consideran ordenados, mientras que los que emergen desde el vértice de una arista del gráfico no lo son;
- Los datos en un modelo documental suelen estar desnormalizados; no se desea mantener varias copias del mismo documento anidado, y usualmente no hay identificadores para los subdocumentos;
- Por otro lado, la ideología de las bases de datos documentales es que los documentos son «agregados» listos, que no es necesario construir de nuevo cada vez. Se requiere garantizar la posibilidad de obtener rápidamente un subgrafo que corresponda a un documento listo en el modelo gráfico.
Un poco de publicidad
El autor del artículo está relacionado con el desarrollo de la base de datos NitrosBase, cuyo modelo interno es gráfico, mientras que los modelos externos — relacional y documental — son sus representaciones. Todos los modelos son equivalentes: prácticamente cualquier dato está disponible en cualquiera de ellos utilizando el lenguaje de consultas natural que le corresponde. Además, en cualquier representación los datos pueden ser modificados. Los cambios se reflejarán en el modelo interno y, en consecuencia, en otras representaciones.
Describiré cómo se corresponde los modelos en NitrosBase, espero, en uno de los siguientes artículos.
Conclusión
Espero que los contornos generales de lo que se llama multimodalidad hayan quedado más o menos claros para el lector. Las bases de datos multimodales son bastante diversas, y el «soporte para múltiples modelos» puede presentarse de diferentes maneras. Para entender lo que se denomina «multimodalidad» en cada caso específico, es útil responder a las siguientes preguntas:
- ¿Se trata de apoyar modelos tradicionales o de una especie de modelo ‘híbrido’?
- ¿Son los modelos ‘equitativos’ o uno de ellos es subordinado a los otros?
- ¿Son «indiferentes» los modelos entre sí? ¿Pueden los datos grabados en un modelo ser leídos en otro o incluso sobreescritos?
Creo que ya se puede dar una respuesta positiva a la pregunta sobre la relevancia de las bases de datos multimodelo, pero es interesante saber cuáles de sus variedades serán más demandadas en un futuro cercano. Parece que las bases de datos multimodelo que soportan modelos tradicionales, en primer lugar, el relacional, serán las más solicitadas; la popularidad de las bases de datos multimodelo que ofrecen nuevos modelos, que combinan las ventajas de varios modelos tradicionales, es un asunto de futuro más lejano.
Solo los usuarios registrados pueden participar en la encuesta. , por favor.
¿Utiliza bases de datos multimodelo?
No, almacenamos todo en una sola base de datos y en un solo modelo.
Usamos las capacidades multimodelo de las bases de datos tradicionales.
Practicamos el almacenamiento poliglot (polyglot persistence).
Usamos nuevas bases de datos multimodelo (Arango, Orient, CosmosDB).
Votaron 19 usuarios. Se abstuvieron 4 usuarios.
Fuente: habr.com
