

Es curioso cómo la historia de los lanzamientos de modelos abiertos para transformar indicaciones de texto en imágenes, desarrollados y entrenados por Stability AI, se asemeja a una serie de altibajos de las versiones sucesivas del sistema operativo Microsoft. Después de la legendariamente exitosa XP, recordemos, apareció la problemática Vista; después la magnífica 'siete' — y tras ella, la estéril Windows 8. A la versión 1.5 de Stable Diffusion, que inicialmente era poco atractiva pero fue perfeccionada gradualmente por entusiastas, le siguió la SD 2.0, que fue abiertamente un fracaso — un fracaso, de hecho, porque incluía un codificador OpenCLIP atípico para modelos de este tipo, de . En este proceso de selección se descartaron no solo referencias visuales inapropiadas (NSFW), sino también obras y ilustraciones de artistas populares como el infame Greg Rutkowski. Precisamente esto enfureció a los entusiastas: mientras que para SD 1.5, incluso en su versión original, sin aplicar especialmente entrenados checkpoints, funcionaban maravillosamente las simples indicaciones con estilos — 'paisaje medieval épico, al estilo de Greg Rutkowski' — y el resultado era impresionante, SD 2.0 dejó de 'reconocer' los nombres de los ilustradores más conocidos, cuyos derechos de autor sobre las obras creadas aún son válidos y que no se dignaron a proporcionar tales obras para el entrenamiento de la IA. Era necesario usar más palabras para describir lo deseado, y con indicaciones demasiado largas, el modelo no se manejaba bien.
Se sentaron — se levantaron, se sentaron — se levantaron
En combinación con un codificador modificado (el convertidor de texto en tokens digitales con los que trabaja directamente el modelo), la imposibilidad de aplicar estilos nombrados simplemente desmotivó a los entusiastas a mejorar "la segunda" por sus propios medios. En realidad, había que lidiar simultáneamente con cómo ajustar la técnica ya desarrollada para la creación de sugerencias al nuevo codificador y continuar entrenando el modelo para que reconociera aquellas imágenes y temas con los que los creadores no lo familiarizaron en la etapa inicial de entrenamiento; después de todo, el diferencial de calidad de las imágenes generadas por "la segunda" en comparación con "la primera" no estaba garantizado. Sí, hubo un salto de calidad en comparación con el tamaño estándar de 512×512 píxeles de SD 1.5 a 768×768, pero para ese momento la comunidad ya estaba usando a fondo upscalers, outpainters y otras herramientas para aumentar el tamaño de la imagen final, así que SD 2.0 pasó prácticamente desapercibida. SDXL (desarrollado por OpenAI y utilizado, entre otros, por el proyecto DALL-E) — el código también es abierto, pero la base de datos en la que fue entrenado, , es propietaria. Además, el tamaño estándar del lienzo aumentó en "Oversize" a 1024×1024, y apareció toda una serie de mejoras adicionales, por lo que los entusiastas se dedicaron con gusto a su perfeccionamiento. Y hasta la fecha, se puede considerar con confianza que SDXL (incluidas las versiones menos exigentes con el "hardware" que surgieron recientemente, como y ) es el generador de imágenes IA de código abierto más popular. Sin embargo, los fervientes defensores de SD 1.5 debaten este argumento, señalando que herramientas fundamentales como ControlNet no se han trasladado adecuadamente a SDXL. .
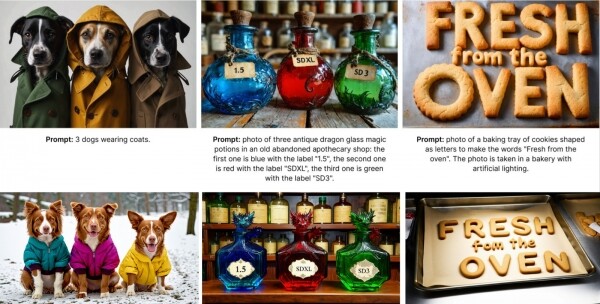
Y así, desde el 12 de junio de 2024, con el momento del "lanzamiento en la naturaleza" del código del modelo que permite las generaciones locales, debería haber llegado el tiempo de la versión "abierta" de SD 3 — más precisamente, (SD3M o SD3 2B) con 2 mil millones de parámetros operativos. Condicionalmente, recordemos, este número corresponde al número total de pesos en las entradas de todas las perceptrones del modelo. Antes, en abril, Stability AI había perfeccionado y ofrecido para uso comercial la versión con 8 millones (en número de parámetros) de , también conocido como SD3 8B. Recordemos que SDXL 1.0 tiene , sin embargo, SD3M, según afirman los desarrolladores, es . Se quería decir que, con menores requerimientos de memoria de video que los de «Oversize», incluso ante solicitudes simples debería generar imágenes «con un nuevo nivel de fotorrealismo». Entre las ventajas de la «tres» también se mencionaban «una calidad sin precedentes en la tipografía del texto generado en las imágenes», «una comprensión más profunda de las solicitudes gracias a la colaboración de tres codificadores» y «preparación para un ajuste efectivo incluso con conjuntos de datos limitados».
Se suponía, evidentemente, que la comunidad de entusiastas, al recibir esta nueva y esperada herramienta, se dedicaría a perfeccionarla con el mismo fervor que lo hicieron con la «semi» y «Oversize» en su momento. Sin embargo, desde el principio todo salió mal: SD3M logró decepcionar profundamente Las anteriores creaciones de Stable Diffusion con código abierto (más bien, con los valores de pesos de la red neuronal disponibles para descarga gratuita y ejecución local), como SDXL, estuvieron acompañadas de una de las características típicas de los modelos generativos
Licencia CreativeML Open RAIL++-M con características como la "licencia de derechos de autor perpetua, mundial, no exclusiva, gratuita, irrevocable, con el objetivo de reproducir, preparar, exhibir públicamente, interpretar públicamente, sublicenciar y distribuir materiales adicionales tanto de la propia modelo como de sus derivados". La "troika" prevé dos tipos de licenciamiento: — con formulaciones muy relajantes como "Stability AI le concede una licencia no exclusiva, mundial, intransferible, no sublicenciable, revocable, gratuita y limitada sobre la propiedad intelectual" — y .
La hierba no lleva a nada bueno
Tras un tiempo muy breve, la comunidad coincidió en que . Y, de hecho, declaró un boicot a la empresa desarrolladora, sin querer gastar tiempo y esfuerzo en el ajuste de un modelo crudo y evidentemente deficiente, con la conciencia de que Stability AI puede, en cualquier momento, por el más mínimo capricho de sus gerentes de medios, revocar la licencia previamente otorgada a un entusiasta que realiza dicho ajuste. El contrato de licencia está formulado de tal manera que los no abogados que lo estudian tienen la impresión de que, tras la revocación del permiso para el uso comercial de SD3M, el antiguo titular estará obligado a eliminar todas las obras derivadas que haya creado a partir de la propiedad intelectual licenciada, incluyendo tanto los modelos ajustados (LoRA, inversiones textuales, checkpoint completos) como sus derivados (cita: "Al finalizar este Acuerdo, deberá eliminar y cesar el uso de cualquier Producto de Software o Obras Derivadas") — es decir, los frutos del trabajo de otras personas que han utilizado estos modelos derivados como punto de partida para su propio trabajo; además, sin que nadie haya pagado por ello, realizado con puro entusiasmo.
Poco después de que la ola de indignación al respecto alcanzara alturas estratosféricas, comenzaron a aparecer informes de abogados profesionales, Y el hecho de que la reseña con la prohibición de su uso futuro deba referirse solo a ciertos productos auxiliares con código cerrado, que Stability AI entregará al usuario comercial (digamos, para acelerar y optimizar la misma preentrenamiento SD3M), — pero la propia empresa aún no ha proporcionado aclaraciones finales al respecto. Y el mero hecho de un silencio tan agobiante durante ya tres semanas (en el momento de escribir este artículo) desde la aparición de la "tres" en acceso abierto perjudica la reputación del desarrollador mucho más que la hierba — generada por su creación en chicas.
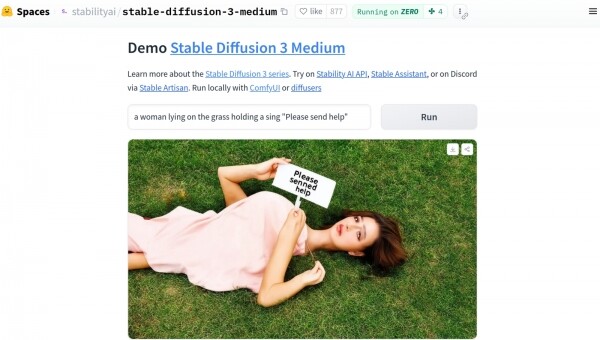
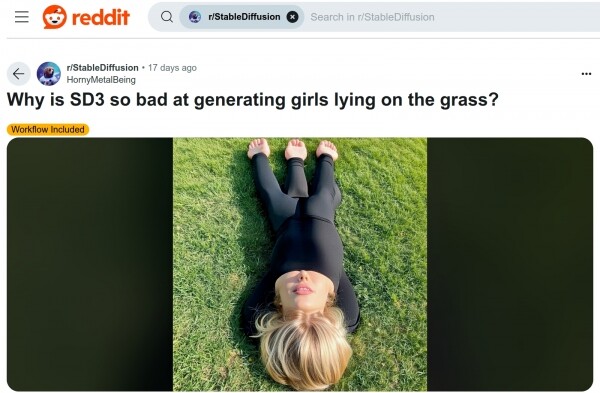
En cuanto a la famosa hierba, que se convirtió literalmente en un meme en pocas horas , y luego en prácticamente todos los sitios de perfil más o menos relevantes en la red, se descubrió que la presencia en la sugerencia de frases como "una chica tumbada en el césped" provoca que la "tres" no solo genere alucinaciones, sino horripilantes creaciones de la enferma — en sentido médico — imaginación de artistas y cineastas que se especializan en cuerpo horror (te lo suplicamos, si tienes sentido y vida, mantente alejado de esto y ni siquiera intentes escribir esta frase en la ventana de búsqueda de imágenes con el filtro de seguridad desactivado). A pesar de esto, las imágenes de personas de pie — y, en menor medida, sentadas — son logradas por la "tres" con un claro cuatro y más, mientras que los retratos a veces son completamente impecables; al menos, no peor que el modelo base SDXL 1.0, — el problema aquí radica precisamente en algún tabú interno sobre la posición horizontal del cuerpo humano.
Según el comentario de Emad Mostaque, fundador y ex (hasta marzo de 2024) director de Stability AI, quien dejó la empresa para , la violación brutal de SD3M justo antes de abrir sus pesos para uso no comercial limitado (recordemos que pero sus pesos siguen siendo ocultos) fue consecuencia del deseo de la dirección actual de garantizar la seguridad — , formuladas aún en marzo de este año como . De acuerdo con esta política y utilizando el modelo generativo SD3M, a los usuarios no se les permite «realizar, promover, facilitar, alentar, planear, incitar o contribuir a más violencia, terrorismo o la creación de contenido que incite al odio, que discrimine o amenace a un grupo protegido de personas (ya sea por género, etnia, identidad sexual u orientación, religión, etc.)», — así que ¡nada de imágenes de pandas, en pelotas, luchando contra dragones desenfrenados! ¡Sólo gatos con sombreros divertidos, perros en chaquetas adorables, botellas con contenido desconocido y galletas recién horneadas!
Hablando técnicamente, puede que la depuración del modelo consistiera simplemente en eliminar del conjunto de datos de entrenamiento las imágenes de personas acostadas y otras imágenes que de algún modo implicaran interpretaciones indecorosas, — y por eso ahora la «tercera» simplemente «no entiende» el significado de la palabra «acostarse». O bien, la arquitectura actualizada de SD3 ha permitido identificar de manera bastante segura los pesos en los perceptrones que se activan durante la generación de imágenes «no seguras», — y esos pesos fueron seleccionadamente anulados justo antes del lanzamiento, ocasionando como efecto secundario la «alucinación forzada». Probablemente, : el codificador traduce correctamente el texto en tokens, pero en el espacio latente «asegurado» esos tokens ya no apuntan a nada en particular, — y por lo tanto, los píxeles resultantes se disponen en la imagen, esencialmente, al azar.
Dada la disponibilidad de la API de un modelo SD3 8B completo pero cerrado durante varios meses y las cálidas promesas de los gerentes de medios de Stability AI de que el modelo «compactado» 2B , los entusiastas del arte generado por IA recibieron la liberación al público de los pesos de SD3M el 12 de junio con gran entusiasmo: . Actualmente, aún se puede obtener, aunque de una manera un poco más indirecta que lo habitual para los checkpoints SDXL y SD 1.5. De hecho, el camino habitual es dirigirse al sitio web de Civitai, desde el cual la mayoría de los modelos se descargan sin necesidad de registro, pero desde el 17 de junio y hasta el momento de la entrega del presente artículo para diseño, la página dedicada a la "triple" de este sitio . Y la razón es una: la licencia comercial para SD3M está redactada de tal manera confusa que incluso los abogados de Civitai han tomado un tiempo para estudiarla más detenidamente. Después de todo, si algún entusiasta entrena LoRA para la "triple" en su PC y la publica en Civitai, y Stability AI de repente decide que el resultado no es adecuado y revoca la licencia al culpable, — ¿qué debe hacer en ese caso el sitio host? No solo aloja checkpoints, ciclos de apoyo y modelos, sino que también brinda a los visitantes la posibilidad de generar imágenes en la nube y entrenar LoRA, inversiones de texto, etc. En resumen, mientras se resuelve el asunto, los archivos del modelo y de los tres convertidores de texto a tokens que vienen con él pueden obtenerse solo .
Comencemos
Sin embargo, hay un matiz: para acceder a los enlaces de descarga, es necesario registrarse en el sitio y luego confirmar la aceptación del mencionado acuerdo de licencia draconiano — sin embargo, este procedimiento es gratuito y es completamente accesible desde Rusia. Hay cuatro opciones a elegir disponibles para los modelos (models) y las mismas cuatro para los convertidores de prompts de texto a tokens (encoders), más tres ciclos de referencia para ejecutarse en el entorno de trabajo de ComfyUI, :
modelos:
- sd3_medium.safetensors
- sd3_medium_incl_clips.safetensors
- sd3_medium_incl_clips_t5xxlfp8.safetensors
- sd3_medium_incl_clips_t5xxlfp16.safetensors
codificadores:
- clip_g.safetensors
- clip_l.safetensors
- t5xxl_fp8_e4m3fn.safetensors
- t5xxl_fp16.safetensors
ciclos:
- sd3_medium_example_workflow_basic.json
- sd3_medium_example_workflow_multi_prompt.json
- sd3_medium_example_workflow_upscaling.json
En este «Taller», nos limitaremos al modelo base sd3_medium.safetensors (4.2 GB), tres codificadores: clip_g.safetensors (1.3 GB), clip_l.safetensors (234 MB) y t5xxl_fp8_e4m3fn.safetensors (4.7 GB), así como al ciclo de trabajo sd3_medium_example_workflow_multi_prompt.json. La cuestión es que en nuestra máquina de prueba está instalada, recordemos, una tarjeta gráfica GeForce GTX 1070 con 8 GB de VRAM, y en este tamaño no caben modelos más grandes con todos los convertidores integrados a la vez. En los puntos de control basados en SD 1.5 y SDXL, los codificadores están integrados en el archivo principal por defecto, pero en este caso hay no dos, sino tres conversores, sumando más de 6 GB, y junto con el modelo en sí, ya superamos los 10 GB; y si optamos por la versión de 16 bits del codificador T5XXL, se requerirá una tarjeta gráfica aún más potente. Sin embargo, en el caso de cargar primero los convertidores de texto a tokens en la memoria de video y luego el modelo que trabaja con esos tokens, se puede manejar incluso con un adaptador gráfico de 6 GB. Desde este punto de vista, la «triple» modular sin duda supera al típico punto de control SDXL de 5-7 GB.
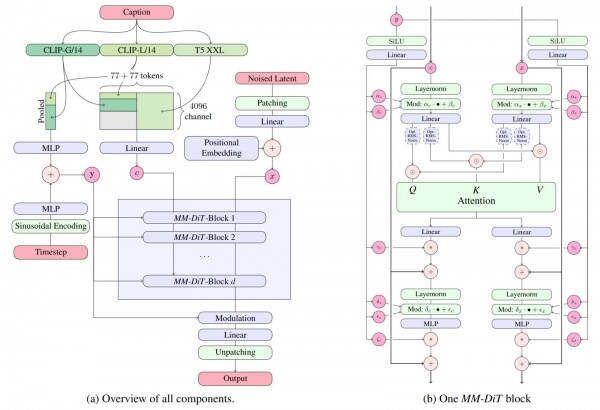
SD3M es un modelo basado en transformadores de difusión multimodal () — y, por tanto, difiere fundamentalmente de los desarrollos anteriores de Stability AI (y no solo de ella), que se basan en El «Taller» no es un lugar para profundizar en la diferencia entre estos enfoques de generación de imágenes por IA; simplemente diré que , su capacidad de trabajar con un mayor número de tokens (lo que, a su vez, permite al operador formular sugerencias textuales bastante amplias, y al sistema seguirlas con bastante precisión), así como una mejor calidad en las imágenes resultantes. La SD3 completa 8B puede generar imágenes en un lienzo de 4 MP (2048×2048 píxeles), y también en aspectos como la reproducción de texto en la imagen, la precisión de la correspondencia de la imagen generada con la sugerencia textual y la estética visual general. La conversión de texto a vector de tokens se realiza aquí con tres codificadores ( y uno T5-XXL — el «T5», por cierto, de ) — y, en general, no tienen que trabajar con el mismo aviso.
Pero, dejando de lado las introducciones, vamos a enfocarnos en lo que trata la 'Taller', que es la generación de imágenes basada en el modelo SD3M. Usaremos para esto, como ya se mencionó, el entorno de trabajo ComfyUI, que se puede descargar . Cabe destacar que esta variante es solo para ejecutarse en tarjetas gráficas NVIDIA o directamente en CPUs de AMD o Intel (lo que, por supuesto, será mucho más lento): a los propietarios de tarjetas gráficas AMD rocm y pytorch, que se pueden instalar a través del gestor de descargas pip.
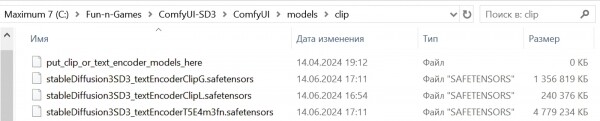
Una vez completada la instalación del entorno de trabajo, se deben colocar los archivos .safetensors descargados anteriormente: los modelos en el directorio ComfyUImodelscheckpoints, los convertidores de texto a tokens en ComfyUImodelsclip. ¡Y ya se puede empezar!
Es hora de acelerarse
Vale la pena mencionar que AUTOMATIC1111, bien conocida por los lectores de anteriores 'Talleres' sobre el tema de la pintura con IA, a finales de junio también , sin embargo, en ComfyUI el soporte para el nuevo modelo sigue siendo el más completo. No es sorprendente, ya que hasta hace poco, el autor del 'monstruo de pasta', conocido en la comunidad de entusiastas con el apodo de ComfyAnonimous, o simplemente Comfy, , donde trabajó, entre otras cosas, en un entorno de trabajo interno que utilizan los mismos desarrolladores. Como veremos más adelante, la versión más reciente de ComfyUI realmente muestra que su autor tiene ciertos conocimientos privilegiados sobre cómo está estructurado y funciona este modelo controvertido, conocimientos que los creadores de otros entornos de trabajo para la ejecución local de Stable Diffusion 3 Medium, por razones obvias, no pueden presumir.
Instalar ComfyUI en una versión portátil para Windows es muy sencillo: tras descargar el archivo ZIP correspondiente basta descomprimirlo en cualquier directorio conveniente; preferiblemente, por supuesto, en una unidad lógica basada en SSD, no en HDD, ya que se espera un intercambio entre el almacenamiento y la memoria, teniendo en cuenta los ciclos de carga-descarga de los modelos, incluso para generar una sola imagen (primero se tendrá que colocar en la VRAM los convertidores de texto a tokens, luego limpiar la memoria de video y cargar el SD3M propiamente dicho), lo cual será tanto más intensivo cuanto menos VRAM tenga disponible este computador. Por cierto, la instalación portátil es buena también por su completa independencia: nada, excepto el volumen de espacio libre en el disco lógico, impide desplegar localmente tantas copias de ComfyUI como se deseen, para experimentar ampliamente con diversas extensiones, sin temor a arruinar un sistema ya depurado y que funcione perfectamente.
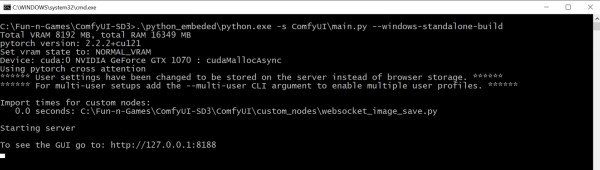
Asegurándose de que el archivo del modelo base SD3M sin codificadores de texto a tokens integrados (archivo stableDiffusion3SD3_sd3Medium.safetensors, 4,2 GB) esté ubicado en el subdirectorio checkpoints (en nuestra instalación de prueba, la ruta completa es C:Fun-n-GamesComfyUI-SD3ComfyUImodelscheckpoints), y que los tres archivos de los codificadores (archivos stableDiffusion3SD3_textEncoderClipG.safetensors, stableDiffusion3SD3_textEncoderClipL.safetensors y stableDiffusion3SD3_textEncoderT5E4m3fn.safetensors; 1,3 GB, 234 MB y 4,7 GB, respectivamente) estén en el subdirectorio clip (C:Fun-n-GamesComfyUI-SD3ComfyUImodelsclip), se puede iniciar el entorno de trabajo haciendo doble clic en el archivo run_nvidia_gpu.bat en la carpeta raíz (en nuestro caso C:Fun-n-GamesComfyUI-SD3). Tras el inicio del servidor, en la ventana de comandos de Windows, se abrirá automáticamente (esto lo implican las configuraciones del archivo BAT) una nueva pestaña en el navegador predeterminado, donde se podrá acceder a la interfaz web en la dirección 127.0.0.1/8188. (aunque solo sea en una primera aproximación) «monstruo espagueti».
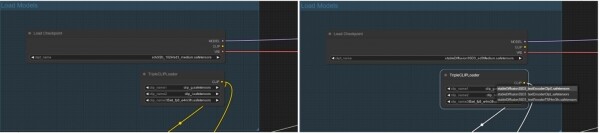
En principio, si tienes a tu disposición una tarjeta gráfica NVIDIA más moderna (de la generación RTX y no GTX, incluso con solo 6 GB de VRAM), puedes cargar de inmediato el flujo de trabajo base creado por ComfyAnonimous, del que ya se habló antes: el archivo comfy_example_workflows_sd3_medium_example_workflow_multi_prompt.json, que contiene múltiples ventanas para ingresar indicaciones, una para cada uno de los tres codificadores, y trabajar con él. Sin embargo, primero tendrás que ajustar los nombres de los cuatro archivos de modelos (en los nodos de carga) para que coincidan con los que tienes. El autor del flujo de trabajo base, evidentemente, trabajó en su lugar de trabajo (en Stability AI, como se mencionó) con archivos locales disponibles que se llamaban ligeramente diferente, así que, si presionas el botón «Queue Prompt» en la interfaz espartana de ComfyUI justo después de cargar el flujo de trabajo, el entorno de trabajo mostrará un mensaje de error.
Rotación de cultivos para IA-generación
Sin embargo, esto no es difícil de arreglar: lo que realmente desanima es el hecho de que nuestra vieja GTX 1070 procesa SD3M de manera extremadamente lenta: la generación de imágenes toma entre 27 y 30 segundos por cada iteración, y considerando que el parámetro «Steps» en el flujo de trabajo base está establecido en «28», se invierte un tiempo injustificable. Por lo tanto, realizaremos una pequeña optimización: utilizaremos el módulo de Python venv (), diseñado, entre otras cosas, para acelerar el funcionamiento de modelos de IA generativos. No viene incluido en el paquete de la versión portátil de ComfyUI, , que en última instancia se reducen a implementar un entorno Python completo en tu PC local y activar el módulo necesario desde ese entorno.
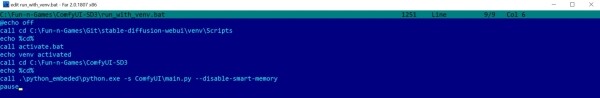
Esperemos que los lectores que siguen nuestras «Talleres» ya tengan una instalación activa de AUTOMATIC1111 en sus máquinas. En este caso, todo es mucho más simple: el módulo venv ya está implementado, y lo único que se requiere hacer para activarlo al iniciar el entorno de trabajo ComfyUI es . Para comenzar, primero se debe detener el servidor, cambiando a su ventana y presionando «Ctrl» + «C», y luego ingrese «y» para confirmar; después, copie el archivo BAT run_nvidia_gpu.bat en uno nuevo, llamémoslo run_with_venv.bat. El archivo de inicio original es bastante conciso: simplemente llama a una copia portátil de Python con el parámetro —windows-standalone-build:
.python_embededpython.exe -s ComfyUImain.py —windows-standalone-build
pause
Este parámetro en sí no es demasiado ambiguo; implica ciertas optimizaciones que, probablemente, están diseñadas específicamente para las tarjetas gráficas NVIDIA más recientes y, por lo tanto, pueden dificultar la vida a quienes todavía mantienen lealtad a sus venerables GTX. Por esta razón, eliminemos —windows-standalone-build de la línea de comandos, y también renunciaremos a otra optimización de moda — el 'gestor de memoria inteligente' activado por defecto, smart memory, que , sin descargarla. Esto realmente acelera la creación de imágenes de IA, sin embargo, al mismo tiempo convierte nuestra computadora moralmente obsoleta en un sistema de una sola tarea: ya no es posible navegar por la web, jugar, ni siquiera trabajar con documentos y correos electrónicos en la PC al mismo tiempo que la actividad del entorno de trabajo. Así que, para quienes no disponen de una computadora dedicada para la creación artística de IA, se presenta el siguiente archivo BAT para ejecutar ComfyUI (no solo con el objetivo de generar imágenes con SD3M, por cierto, también es adecuado para SDXL):
@echo off
call cd C:Fun-n-GamesGitstable-diffusion-webuivenvScripts
echo %
call activate.bat
echo venv activado
call cd C:Fun-n-GamesComfyUI-SD3
echo %
call .python_embededpython.exe -s ComfyUImain.py —disable-smart-memory
pause
Aquí se supone que la instalación portátil de ComfyUI se realizó en el directorio C:Fun-n-GamesComfyUI-SD3, y que AUTOMATIC1111 se instaló previamente en C:Fun-n-GamesGitstable-diffusion-webui. Numerosos «echo» son necesarios simplemente para el control visual de que el cambio de directorios se está realizando correctamente y que los comandos necesarios están siendo ejecutados; una vez que todo esté depurado, se pueden eliminar de el archivo BAT.
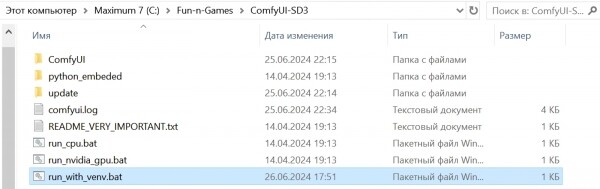
Reiniciamos el entorno de trabajo, esta vez haciendo doble clic en run_with_venv.bat. Dado que anteriormente cerramos simplemente el servidor y no tocamos la interfaz web, en la pestaña correspondiente debería seguir estando el mismo diagrama de flujo de ComfyUI con los nombres de los modelos corregidos. Observemos la parte derecha: allí se encuentra el nodo "Preview Image", que no guarda la imagen lista en disco, sino que solo la muestra. Si se ejecuta cada vez el diagrama de flujo para generar exactamente una imagen, evaluarla visualmente, modificar algunos parámetros y volver a ejecutarla, es una opción totalmente válida: siempre se puede guardar la imagen deseada manualmente haciendo clic derecho sobre ella. Pero si se realizan múltiples generaciones en el entorno de trabajo de forma secuencial, es mejor que sus resultados se acumulen automáticamente en la memoria permanente (en el directorio ComfyUIoutput por defecto).
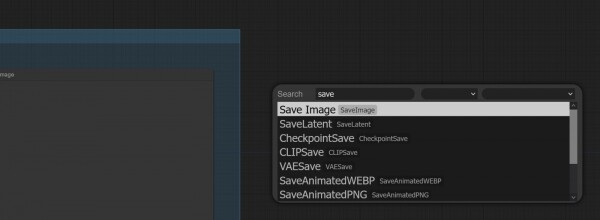
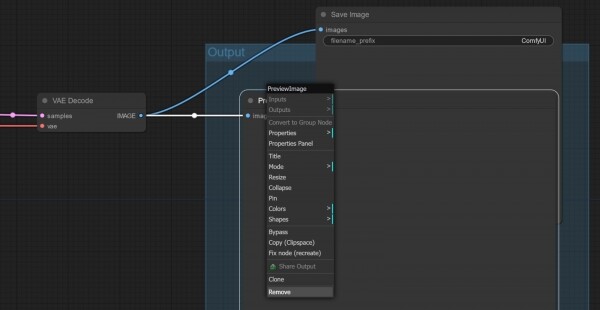
Así que es mejor cambiar el nodo "Preview Image" a "Save Image" de inmediato. Para ello, hacemos doble clic con el botón izquierdo del ratón en cualquier área libre del diagrama de flujo, se abrirá una ventana de selección de nodos con una barra de búsqueda. Empezaremos a escribir "Save…" en esta barra, y casi de inmediato veremos el nombre buscado. Luego solo queda hacer clic en él y conectar la entrada del nuevo nodo a la salida "IMAGE" del nodo "VAE Decode", donde originalmente estaba conectado "Preview Image". El "Preview Image" se puede eliminar más tarde: simplemente selecciónelo haciendo clic en el encabezado y presione la tecla "Del" en el teclado.
Y ahora es el momento perfecto para ejecutar el diagrama de flujo original creado por ComfyAnonimous (con nuestras modestas correcciones). Esto es lo que obtenemos:
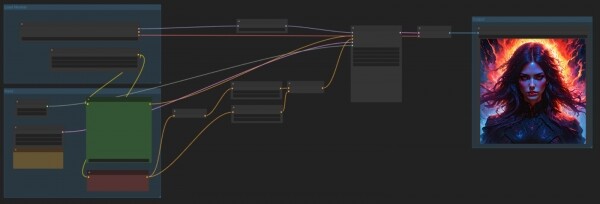
Una imagen bastante impresionante, incluso con un poco de sensación, y no dirías que fue creada utilizando el mismo modelo que literalmente no puede evitar dibujar personas tumbadas en la hierba. Además, el sistema funciona bastante ágilmente: alrededor de 5-6 segundos por iteración para una imagen de 1 Mpx en una GTX 1070 se considera un rendimiento aceptable. Como comparación: la misma PC en el mismo ComfyUI con el mismo archivo BAT genera imágenes SDXL de tamaños similares, tardando aproximadamente 6-7 segundos por cada iteración, así que el "tres" se puede considerar menos exigente con el hardware de la PC en la que se lleva a cabo la generación de IA.
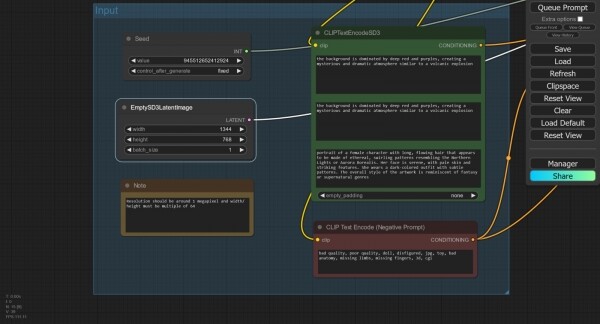
Ahora ajustaremos las dimensiones del lienzo. Cerca del nodo «EmptySD3LatentImage», que las define, se encuentra un nodo de referencia «Note», que está desconectado (en el sentido de que no está conectado a nada), donde hay un recordatorio importante: el área total de la imagen en el caso de SD3M debe ser de aproximadamente 1 Mpx, lo que significa que se deben seleccionar las dimensiones del lienzo rectangular en consecuencia. Entonces, las estableceremos como 1344×768, que es aproximadamente 1,03 Mpx.
Notemos que arriba se encuentra el nodo «Seed», donde se define la semilla, en este caso «945512652412924», y se indica que no debería cambiar después de la generación (parámetro «fixed»).
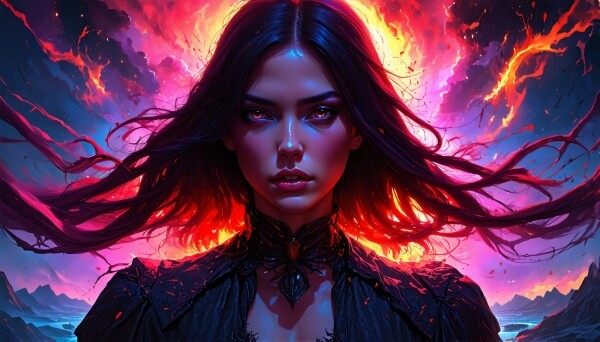
Ejecutaremos el mismo ciclo con la semilla anterior, pero ya para el lienzo rectangular. Se nota de inmediato que el tiempo de ejecución en general es menor, aunque la velocidad de renderizado se ha mantenido igual: menos de 6 segundos por iteración. Y esto tiene sentido: dado que las sugerencias de texto no cambiaron, no es necesario cargar de nuevo el (los) codificador(es) para ellas. La imagen resultante, como era de esperar, es un poco diferente de la primera, cuadrada, pero esencialmente no cambia: la composición general se mantiene.
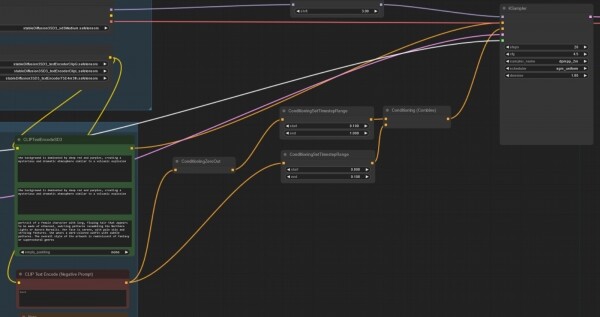
Ahora prestemos atención a los nodos «CLIPTextEncodeSD3» y «CLIP Text Encode (Negative Prompt)». El primero se destaca porque contiene tres campos de entrada; si se eliminan los textos, se verán las notas sobre para qué codificadores están diseñados: de arriba hacia abajo, son CLIP G, CLIP L y T5XXL. Anteriormente, no había nodos similares en ComfyUI por razones obvias. El ciclo de referencia contiene sugerencias cortas y duplicadas para los dos primeros campos de texto (para los codificadores CLIP G y CLIP L) y una mucho más extensa para el tercero: T5XXL. Es evidente que se puede jugar con el contenido de estos campos en amplios márgenes, y estudiar hasta qué punto el cambio de texto en ellos influye en la imagen final representa una tarea no trivial, pero extremadamente atractiva. Sin embargo, por razones que se volverán claras un poco más adelante, no nos ocuparemos de ello por ahora.
Sin embargo, en el nodo «CLIP Text Encode (Negative Prompt)», no hay nada especial. Pero considere cuán complicado es el camino desde allí hasta la entrada correspondiente «conditioning» del nodo principal «KSampler». Este camino se bifurca, y una de sus ramas (la superior en este caso) señala que, desde el 10% de los pasos de generación hasta su finalización, el sistema no tomará en cuenta la sugerencia negativa (el paso a través del nodo «ConditioningZeroOut» significa precisamente el restablecimiento de la condición). Mientras que la segunda rama permite que la sugerencia negativa (también condicionalmente con medio peso) pase para un procesamiento posterior sin cambios, pero solo en los primeros 10% del total de pasos de generación.
Lejanas brumas
Una vez más: en los primeros 10%, es decir, 3 de los 28 asignados en este caso, la sugerencia negativa se pasa al nodo «KSampler», encargado de formar la imagen en el espacio latente (en el espacio de píxeles, es decir, en una imagen comprensible para el ser humano, el resultado de su salida lo traduce el siguiente nodo, «VAE Decoder»), de manera normal: la rama superior (con el restablecimiento de la condición) no está activa, solo trabaja la inferior. En los restantes 90% de pasos (25 de 28 en nuestro caso), la sugerencia negativa no funciona en absoluto: está activa precisamente la rama superior de transmisión de condiciones —con su restablecimiento—, mientras que el movimiento por la inferior está bloqueado por el parámetro límite que activa el nodo correspondiente «ConditioningSetTimestepRange». Ahora está claro por qué varios revisores afirman que , — el efecto que producen (si consideramos exactamente este, el programa base, y suponemos que en los sitios de generación en línea utilizando el modelo SD3 Medium se aplican reglas similares) es mínimo.
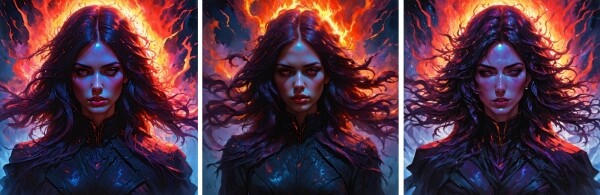
Y aun así, existe: si simplemente tomas y conectas directamente la salida del nodo «CLIP Text Encode (Negative Prompt)» con la entrada correspondiente de «KSampler» (o marcas todos los nodos intermedios con condiciones en este camino como «saltables», «Bypass», lo que llevará al mismo efecto), la calidad de la imagen final se deteriorará notablemente. Esto, por cierto, puede considerarse una prueba indirecta de la «no cocción» de SD3M, ya que, a decir verdad, a los desarrolladores se les debería haber permitido ajustar la fuerza y relevancia de la sugerencia negativa incluso antes de publicar los pesos del modelo al público. Dos ramas de condiciones astutamente planteadas para utilizar la sugerencia negativa son una especie de parche, y en este sentido las expectativas desmedidas promovidas por el departamento de marketing de Stability AI en su relación, se ven bastante justificadas.
La falta de al menos una breve guía oficial sobre cómo trabajar con SD3M ha llevado a que ya circulen rumores en la red de que este modelo Lo cual, por supuesto, no es así, pero en cualquier caso, estas sugerencias deben aplicarse de manera diferente a En particular, los entusiastas afirman con total seriedad que agregar descripciones detalladas de la mayor cantidad posible de indecoros al campo negativo (sí, sí, el viejo y querido «nsfw, nude» no es suficiente; habrá que esforzarse un poco más en la imaginación) incluso de la infame chica tumbada sobre la hierba. Si esto es cierto o no, no se puede averiguar sin una revisión cuidadosa (y no está garantizado que incluso la etiqueta «18+» en el encabezado de nuestro sitio proteja la publicación de demandas por parte de fervientes defensores de la moralidad si nos arriesgamos a publicar la «sugerencia milagrosa» compuesta por entusiastas — por el hecho de que esté en inglés). Esta divertida situación recuerda a un caso con , gracias a las cuales — precisamente porque contenían descripciones bastante detalladas de lo que los buenos cristianos no debían hacer — nos han llegado al menos fragmentos de testimonios escritos sobre las creencias y costumbres de la antigua Rusia precristiana.
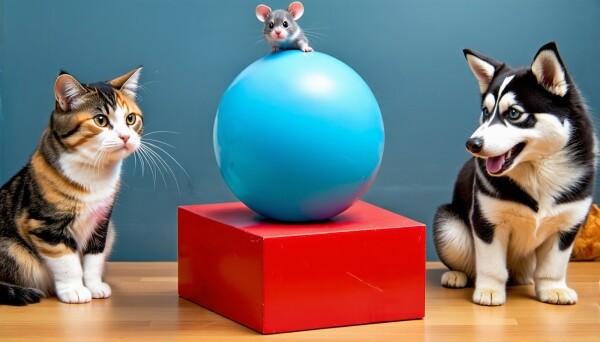
Ahora, esperemos que sea más claro por qué profundizar en el estudio de SD3M en este momento no parece ser una de las inversiones más razonables de tiempo y esfuerzo. Realmente hay mucho que discutir y explorar: los parámetros de generación recomendados en el nodo "KSampler" (CFG — 4.5-5.0; número de pasos — alrededor de 28; par sampler/scheduler — exclusivamente dpmpp_2m/sgm_uniform, de lo contrario la calidad de la salida baja notablemente); y la notable variabilidad en la calidad subjetiva de las generaciones con los mismos parámetros iniciales, pero con diferentes inspiraciones; y la eliminación de la famosa "maldición de estar en/sobre la hierba" (para lo cual ya ); y, en realidad, averiguar qué parámetros de generación afectan cada uno de los tres convertidores de texto a tokens — y cómo, al operar con ellos, conseguir verdaderas obras maestras del Arte Generativo de IA (si es que esto es posible con "tres", por supuesto).
Más aún, el despido de Emad Mostaque en marzo y ComfyAnonimous en junio, , — no son los únicos problemas que ha enfrentado Stability AI. Según informa Reuters citando a The Information, esta startup británica acaba de , que ahora es Prem Akkaraju, designado por un conocido grupo global de inversores en TI — y este, a su vez, está dispuesto a invertir una cantidad considerable de efectivo en la empresa (). La situación de Stability AI como estructura empresarial es hoy abiertamente inestable; muchos entusiastas decepcionados pronostican su pronta desaparición — y en una situación así es difícil esperar que la empresa se ocupe reflexivamente incluso de errores tan evidentes.
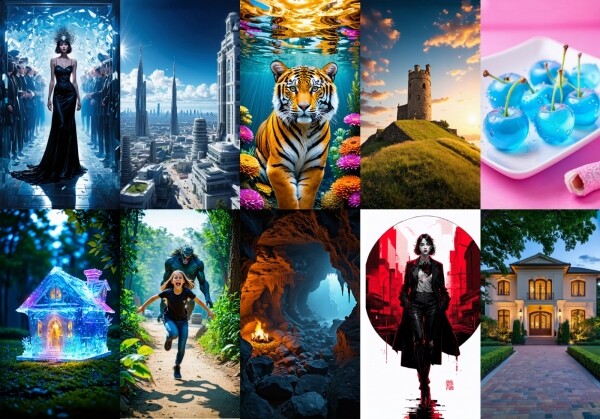
Sin embargo, una política de licencias mal pensada está, lamentablemente, impidiendo que la comunidad lleve SD3M a su máximo potencial, como ocurrió con SD 1.5 y SDXL. Al menos los checkpoints derivados y herramientas como LoRA para los últimos dos modelos seguirán estando disponibles para su ejecución local, incluso cuando (y si) Stability AI concluya su camino como entidad comercial. Justo después del estrepitoso fracaso de la 'triple alianza', en los foros especializados de la red comenzaron a alzarse cada vez más voces a favor de la creación de un proyecto no lucrativo para desarrollar un modelo generativo de transformación de texto a imágenes basado en crowdfunding, y en la actualidad este movimiento comienza a tomar forma bajo el nombre . Han declarado su disposición a unirse a este proyecto Invoke (una de las plataformas de generación de IA en línea, enfocada en estudios profesionales), Comfy Org (el equipo responsable del soporte y desarrollo de ComfyUI), Civitai (que no necesita presentación) y el equipo detrás de LAION (una base de imágenes anotadas, en la cual principalmente se entrenan este tipo de modelos).
Por lo tanto, en un futuro cercano, las nuevas versiones de 'La Fábrica' probablemente se centrarán en trabajar con aquellos modelos para los cuales la comunidad ya ha creado un amplio conjunto de mejoras y herramientas adicionales, es decir, 'la versión 1.5' y 'Oversize'. Tal vez el momento de gloria de SD3M aún llegará, pero hoy es difícil incluso imaginar cuándo ocurrirá exactamente. Mientras tanto, los interesados pueden descargar el archivo con las generaciones de SD3M mencionadas en este artículo (los ciclos están integrados justo en los archivos PNG; simplemente arrastre la imagen al área de trabajo de ComfyUI desde el 'Explorador' de Windows para reproducir todo el orden y los parámetros de generación) . Quizás alguno de nuestros lectores logre antes que los habituales de Reddit y Hugging Face descubrir la forma óptima de distribuir el texto en los tres campos de sugerencia, ¿verdad?
Materiales relacionados:
.
.
.
.
.
Fuente: 3dnews.ru
