

El original del artículo se encuentra en el sitio web y se publica en 3DNews con el permiso del autor. Presentamos el texto completo del artículo, excepto por la gran cantidad de enlaces; estos serán útiles para aquellos que estén seriamente interesados en el tema y deseen estudiar los aspectos teóricos de la fotografía computacional más a fondo, pero para el público en general consideramos que este material es excesivo.
Hoy en día, ninguna presentación de un smartphone se lleva a cabo sin que se alabe su cámara. Cada mes escuchamos sobre el último éxito de las cámaras móviles: Google enseña al Pixel a tomar fotos en la oscuridad, Huawei hace zoom como un binocular, Samsung incorpora lidar, y Apple crea los bordes más redondeados del mundo. En ningún lugar es tan evidente el flujo de innovaciones.
Las cámaras réflex, por otro lado, parecen estar estancadas. Sony cada año sorprende a todos con nuevos sensores, mientras que los fabricantes actualizan perezosamente el último número de la versión y continúan relajándose al margen. Tengo una réflex que cuesta $3000 en mi escritorio, pero en mis viajes llevo un iPhone. ¿Por qué?
Como decía un clásico, salí a internet con esta pregunta. Allí discuten sobre ciertos 'algoritmos' y 'redes neuronales', sin tener idea de cómo influyen específicamente en la fotografía. Los periodistas proclaman ruidosamente la cantidad de megapíxeles, los bloggers realizan unánimes unboxings pagados, y los estetas se embadurnan con la 'percepción sensorial de la paleta de colores del sensor'. Todo como siempre.
Tuve que sentarme, gastar media vida y resolver todo por mi cuenta. En este artículo, compartiré lo que descubrí.
¿Qué es la fotografía computacional?
En todas partes, incluida Wikipedia, se ofrece una definición similar: la fotografía computacional son todas las técnicas de captura y procesamiento de imágenes donde, en lugar de transformaciones ópticas, se utilizan cálculos digitales. Todo está bien, excepto que no explica nada. Se puede incluir incluso el autofoco, pero no se abarca la óptica de luz estructurada, que ya nos ha traído muchas cosas útiles. La vaguedad de las definiciones oficiales parece insinuar que no tenemos idea de lo que estamos hablando.
El pionero de la fotografía computacional, el profesor de Stanford Marc Levoy (actualmente a cargo de la cámara en Google Pixel) proporciona otra definición: un conjunto de métodos de visualización por computadora que mejoran o amplían las capacidades de la fotografía digital, utilizando los cuales se obtiene una fotografía convencional que no podría haber sido capturada técnicamente de esta manera por la cámara tradicional. En este artículo, me atengo precisamente a su definición.
Así que la culpa la tuvieron los smartphones.
Los smartphones no tuvieron otra opción que dar vida a un nuevo tipo de fotografía: la computacional.
Sus pequeños sensores ruidosos y diminutas lentes de baja luminosidad, por todas las leyes de la física, deberían haber traído solo dolor y sufrimiento. Y lo hicieron, hasta que sus desarrolladores se dieron cuenta de cómo utilizar astutamente sus fortalezas para contrarrestar sus debilidades: obturadores electrónicos rápidos, potentes procesadores y software.
La mayoría de las investigaciones destacadas en el campo de la fotografía computacional datan de 2005 a 2015, lo que en ciencia se considera literal y figurativamente ayer. En este momento, ante nuestros ojos y en nuestros bolsillos, está emergiendo una nueva rama del conocimiento y la tecnología que nunca antes existió.
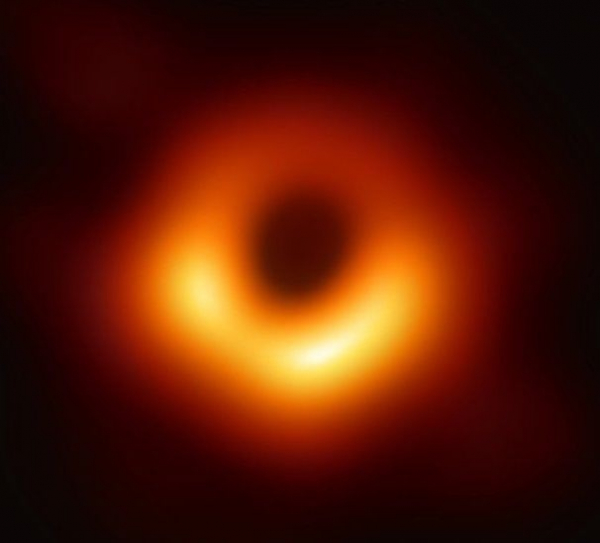
La fotografía computacional no se limita solo a los selfies con bokeh neuronal. La reciente fotografía de un agujero negro no habría visto la luz sin los métodos de fotografía computacional. Para capturar tal imagen con un telescopio convencional, tendríamos que hacerlo del tamaño de la Tierra. Sin embargo, al combinar datos de ocho radiotelescopios en diferentes puntos de nuestro planeta y programando un poco en Python, obtuvimos la primera fotografía del horizonte de eventos en el mundo. También sirve para selfies.
Introducción: procesamiento digital
Imaginemos que hemos regresado a 2007. Nuestra madre es una anarquía, y nuestras fotos son ruidosos JPEG de 0.6 Mp tomadas con un skate. Aproximadamente en ese momento surge nuestro primer deseo irrefrenable de aplicarles presets para ocultar la pobreza de los sensores móviles. No nos privemos de esto.
Matemáticas e Instagram
Con la llegada de Instagram, todos se obsesionaron con los filtros. Como alguien que en su momento realizó ingeniería inversa de X-Pro II, Lo-Fi y Valencia, por supuesto con fines de investigación (je), aún recuerdo que consistían en tres componentes:
- Configuraciones de color (Tono, Saturación, Luminosidad, Contraste, Niveles, etc.) — coeficientes digitales simples, al igual que en cualquier preestablecido que los fotógrafos han usado desde tiempos inmemoriales.
- Mapas de tonos (Tone Mapping) — vectores de valores, cada uno de los cuales nos decía: "El color rojo con tono 128 debe convertirse en tono 240".
- Superposiciones — imágenes semitransparentes con polvo, grano, viñetas, y todo lo demás que se puede superponer para obtener un efecto nada banal de película antigua. No siempre estaba presente.
Los filtros modernos no se han alejado mucho de este trío, solo se han vuelto un poco más complejos matemáticamente. Con la llegada de los sombreadores de hardware y OpenCL en los teléfonos inteligentes, se reescribieron rápidamente para GPU, y eso se consideraba increíblemente genial. Para el año 2012, por supuesto. Hoy en día, cualquier estudiante de secundaria puede hacer algo similar en CSS, y no recibirá nada en la graduación.
Sin embargo, el progreso de los filtros no se ha detenido hoy en día. Los chicos de Dehancer, por ejemplo, están muy entusiasmados con los filtros no lineales; en lugar de la proletaria mapeo de tonos, utilizan transformaciones no lineales más complejas, lo que, según ellos, abre muchas más posibilidades.
Las transformaciones no lineales pueden hacer muchas cosas, pero son increíblemente complejas, y nosotros, los humanos, somos increíblemente torpes. Tan pronto como la ciencia llega a las transformaciones no lineales, preferimos recurrir a métodos numéricos e insertar redes neuronales por todas partes para que ellas escriban obras maestras por nosotros. Lo mismo sucedió aquí.
Automatización y sueños de un botón de "obra maestra"
Cuando todos se acostumbraron a los filtros, comenzamos a integrarlos directamente en las cámaras. La historia oculta quién fue el primer fabricante, pero para entender cuánto tiempo ha pasado — en iOS 5.0, que se lanzó en 2011, ya había una API pública para la Mejora Automática de Imágenes. Solo a Jobs le importa cuánto tiempo se utilizó antes de ser abierto al público.
La automatización hacía lo mismo que cada uno de nosotros al abrir una foto en un editor: levantaba las sombras y los deslumbramientos, acumulaba saturación, eliminaba ojos rojos y corregía el tono de piel. Los usuarios ni siquiera sospechaban que la "cámara drásticamente mejorada" en el nuevo smartphone era solo el resultado de un par de nuevos sombreadores. Pasarían cinco años hasta el lanzamiento de Google Pixel y el inicio del hype sobre la fotografía computacional.
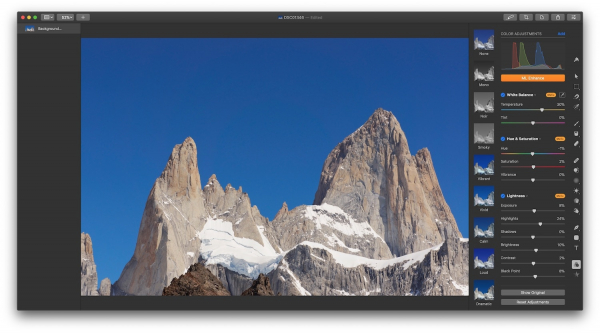
Hoy, la lucha por el botón 'obra maestra' ha pasado al ámbito del aprendizaje automático. Después de experimentar con el tono-mapeo, todos se lanzaron a entrenar CNNs y GANs para mover los deslizadores en lugar del usuario. En otras palabras, se trata de determinar a partir de la imagen de entrada un conjunto de parámetros óptimos que acerquen dicha imagen a una cierta comprensión subjetiva de 'una buena fotografía'. Esto se implementó en el mismo Pixelmator Pro y otros editores. Funciona, como se puede suponer, de manera irregular y no siempre.
El apilamiento representa el 90% del éxito de las cámaras móviles.
La auténtica fotografía computacional comenzó con el apilamiento: sobreponer varias fotografías una encima de otra. No es un problema para un smartphone tomar una docena de instantáneas en medio segundo. En sus cámaras no hay partes mecánicas lentas: el diafragma es fijo, y en lugar de un obturador mecánico, hay un obturador electrónico. El procesador simplemente le dice al sensor cuántos microsegundos capturar los fotones salvajes, y luego lee el resultado.
Técnicamente, un teléfono puede tomar fotos a la velocidad de un video, y video con la resolución de una foto, pero todo depende de la velocidad del bus y del procesador. Por eso siempre se establecen límites programáticos.
El apilamiento ha estado con nosotros desde hace mucho tiempo. Nuestros abuelos utilizaban plugins en Photoshop 7.0 para ensamblar varias imágenes en un HDR llamativo o para crear panoramas de 18000 × 600 píxeles, y... en realidad, nadie ha podido descubrir qué hacer con ellas después. Fueron tiempos gloriosos, lástima que salvajes.
Ahora hemos crecido y lo llamamos 'fotografía épsilon' — cuando, al cambiar uno de los parámetros de la cámara (exposición, enfoque, posición) y fusionando las imágenes obtenidas, conseguimos algo que no podría capturarse en una sola toma. Pero este es un término para teóricos, en la práctica ha prevalecido otro nombre: apilamiento. Hoy, de hecho, el 90% de todas las innovaciones en cámaras móviles se basa en ello.
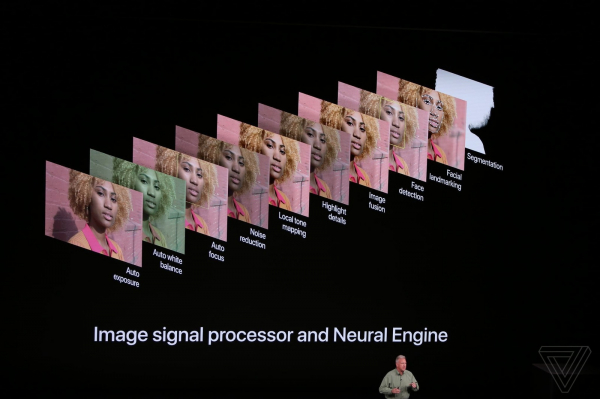
Una cosa que muchos no consideran, pero que es importante para entender toda la fotografía móvil y computacional: la cámara en el smartphone moderno comienza a tomar fotografías inmediatamente después de abrir su aplicación. Lo cual es lógico, ya que necesita de alguna manera transmitir la imagen a la pantalla. Sin embargo, además de la pantalla, guarda imágenes de alta resolución en su propio buffer cíclico, donde las mantiene durante unos segundos más.
Cuando presionas el botón «tomar foto» — en realidad, la foto ya ha sido tomada, la cámara simplemente recupera la última imagen del búfer.
Así es como funciona cualquier cámara móvil hoy en día. Al menos en todos los modelos insignia, no en los de gama baja. La utilización del búfer permite implementar no solo un tiempo de obturación cero, del que los fotógrafos han soñado durante tanto tiempo, sino incluso un tiempo negativo: al presionar el botón, el smartphone revisa el pasado, recuperación de las 5-10 últimas fotos del búfer y comienza a analizarlas y combinarlas frenéticamente. Ya no hay necesidad de esperar a que el teléfono tome varias fotos para HDR o modo nocturno; simplemente las tomas del búfer, el usuario ni siquiera se dará cuenta.
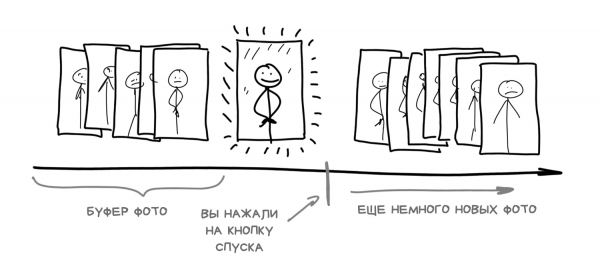
Por cierto, es precisamente gracias al tiempo de obturación negativa que se implementó Live Photo en los iPhones, mientras que en HTC algo similar existió ya en 2013 bajo el extraño nombre de Zoe.
Apilamiento por exposición — HDR y lucha contra los cambios de brillo.
Si los sensores de las cámaras pueden capturar todo el rango de brillo disponible para nuestros ojos es un viejo tema candente de discusión. Algunos dicen que no, ya que el ojo puede ver hasta 25 f-stops, mientras que incluso el mejor sensor de fotograma completo solo puede extraer un máximo de 14. Otros consideran que la comparación es incorrecta, ya que el ojo recibe ayuda del cerebro, ajustando automáticamente la pupila y reconstruyendo la imagen con sus redes neuronales, y el rango dinámico instantáneo del ojo no supera de hecho entre 10 y 14 f-stops. Dejemos esas discusiones a los mejores pensadores en el sofá de internet.
El hecho es innegable: al fotografiar amigos contra un cielo brillante sin HDR con cualquier cámara móvil, obtienes o un cielo normal y caras de amigos negras, o amigos bien definidos, pero un cielo quemado.
La solución ya fue ideada: expandir el rango de brillo con HDR (rango dinámico alto). Necesitas tomar varias imágenes con diferentes exposiciones y combinarlas. Una debe ser «normal», la segunda más clara, la tercera más oscura. Tomamos las áreas oscuras de la imagen clara y llenamos los sobreexpuestos con la oscura — beneficio. Solo queda resolver la tarea del bracketing automático: cuánto desplazar la exposición de cada imagen para no exagerar, pero un segundo año de universidad en una escuela técnica puede manejar ahora la determinación del brillo promedio de la imagen.
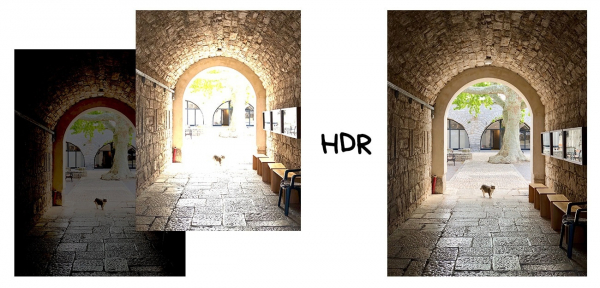
En los últimos iPhone, Pixel y Galaxy, el modo HDR se activa automáticamente cuando un algoritmo sencillo dentro de la cámara determina que estás capturando algo contrastante en un día soleado. Se puede notar incluso cómo el teléfono cambia al modo de grabación en búfer para guardar los fotogramas desplazados por la exposición: los fps en la cámara disminuyen y la imagen se vuelve más vibrante. El momento del cambio es bien visible en mi iPhone X al filmar al aire libre. Observa tu smartphone la próxima vez también.
El inconveniente del HDR con bracket de exposición es su completa incapacidad en condiciones de poca luz. Incluso con la luz de una lámpara de habitación, las tomas quedan tan oscuras que la computadora no puede alinearlas y unirlas. Para resolver el problema de la luz, en 2013 Google mostró un enfoque diferente para el HDR en el smartphone Nexus que salió ese año. Utilizó el apilamiento por tiempo.
El apilamiento por tiempo es una simulación de larga exposición y timelapse.
El apilamiento por tiempo permite obtener una larga exposición mediante una serie de capturas cortas. Los pioneros fueron aficionados a fotografiar rastros de estrellas en el cielo nocturno, quienes encontraban incómodo abrir el obturador durante dos horas. Era difícil calcular todas las configuraciones con anticipación, y con el más mínimo movimiento toda la toma quedaba arruinada. Decidieron abrir el obturador solo por unos minutos, pero muchas veces, y luego iban a casa y unían los fotogramas obtenidos en Photoshop.
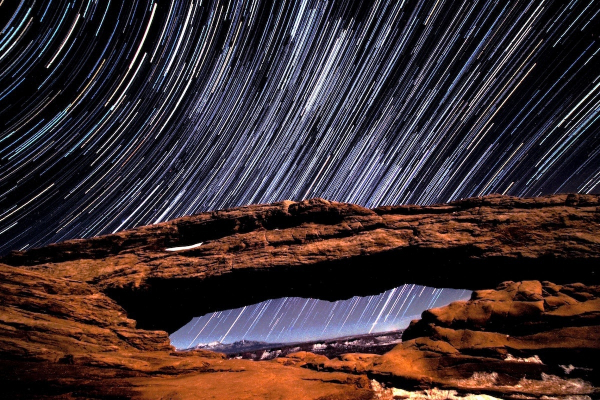
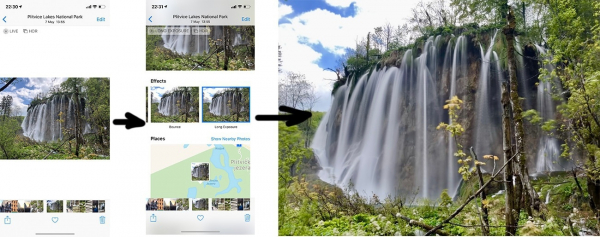
Así que, en realidad, la cámara nunca tomó una larga exposición, pero obteníamos el efecto de su simulación al superponer varias tomas consecutivas. Para smartphones, ya existen un montón de aplicaciones que utilizan este truco, pero ya no son necesarias desde que esta función se añadió a casi todas las cámaras estándar. Hoy en día, incluso un iPhone puede fácilmente unir una larga exposición a partir de una Live Photo.
Volvamos a Google con su HDR nocturno. Resultó que, con el bracket de tiempo, se puede lograr un buen HDR en la oscuridad. La tecnología apareció por primera vez en el Nexus 5 y se llamó HDR+. Los otros teléfonos Android la recibieron como un regalo. La tecnología sigue siendo tan popular que incluso se menciona en la presentación de los últimos Pixel.
HDR+ funciona de manera bastante simple: al detectar que estás tomando fotos en la oscuridad, la cámara carga del buffer las últimas 8-15 fotos en RAW para superponerlas. De esta forma, el algoritmo recoge más información sobre las áreas oscuras de la imagen para minimizar el ruido: píxeles donde, por alguna razón, la cámara no pudo recopilar toda la información y falló.
Es como si no supieras cómo es una capibara y le pidieras a cinco personas que la describieran: sus relatos serían aproximadamente similares, pero cada uno mencionaría algún detalle único. Así, recopilarías más información que simplemente preguntando a uno. Lo mismo ocurre con los píxeles.
La combinación de disparos tomados desde un mismo lugar produce el mismo efecto falso de largas exposiciones como el de las estrellas mencionado anteriormente. La exposición de decenas de tomas se acumula, minimizando los errores en una toma con respecto a las otras. Imagina cuántas veces tendrías que presionar el obturador de una réflex para lograr lo mismo.
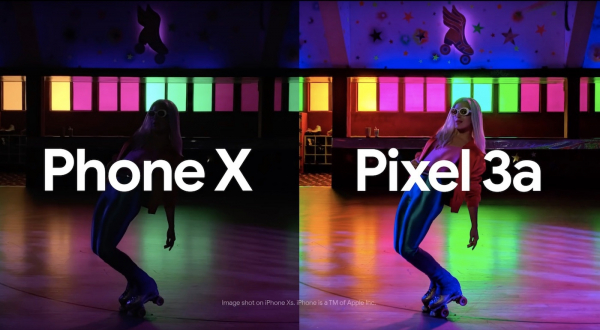
Solo quedaba resolver el problema de la corrección automática del color: las fotos tomadas en la oscuridad suelen salir amarillas o verdes, y queremos la vivacidad de la luz diurna. En las primeras versiones de HDR+, esto se resolvía simplemente ajustando los parámetros, como en filtros tipo Instagram. Luego, se recurrió a las redes neuronales.
Así nació Night Sight, la tecnología de "fotografía nocturna" en Pixel 2 y 3. En el descripción se dice: “Técnicas de aprendizaje automático construidas sobre HDR+, que hacen que Night Sight funcione”. En esencia, esto automatiza la etapa de corrección del color. La máquina fue entrenada con un conjunto de datos de fotos "antes" y "después" para crear una imagen bonita a partir de un conjunto de fotos oscuras.
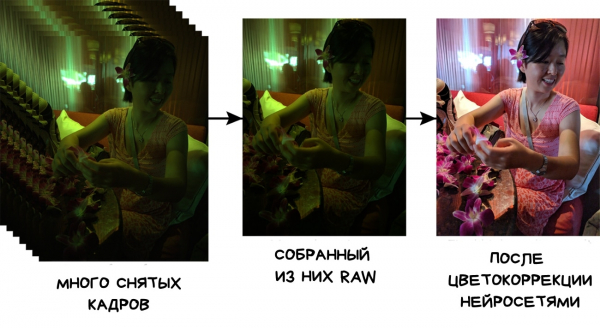
Por cierto, el conjunto de datos se publicó en acceso abierto. Quizás, los chicos de Apple lo tomen y finalmente logren que sus tubos de vidrio tomen fotos decentemente en la oscuridad.
Además, en Night Sight se utiliza el cálculo del vector de movimiento de los objetos en el marco para normalizar el desenfoque que necesariamente se produce con una larga exposición. Así, el smartphone puede tomar partes nítidas de otros cuadros y unirlas.
Apilamiento por movimiento: panorama, superzoom y combate contra el ruido.
La panorámica es una actividad popular entre los habitantes de las zonas rurales. Hasta el momento, no se conocen casos en los que una foto de salchicha haya interesado a alguien más que a su autor, pero no se puede dejar de mencionarla; para muchos, este fue el comienzo de la apilación de imágenes.
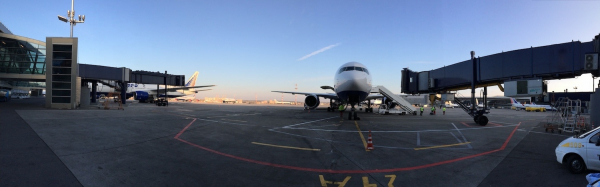
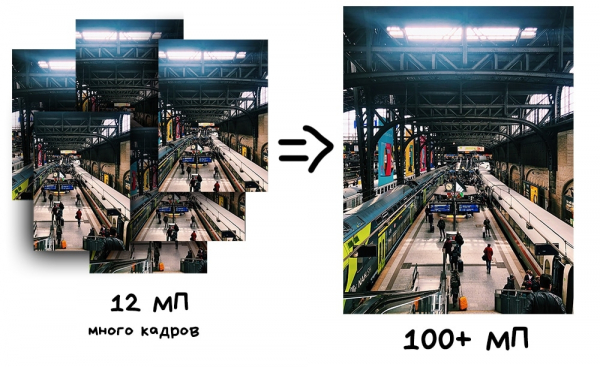
El primer uso útil de la panorámica es obtener una fotografía de mayor resolución de la que permite el sensor de la cámara mediante la unión de varias tomas. Los fotógrafos han estado utilizando diferentes programas para lo que se conoce como fotografías de superresolución, donde imágenes ligeramente desplazadas se complementan entre sí a nivel de píxeles. De esta manera, se puede obtener una imagen de cientos de gigapíxeles, lo cual es muy útil si necesitas imprimirlo en un cartel publicitario del tamaño de una casa.
Otro enfoque, ya más interesante, es el Pixel Shifting. Algunas cámaras sin espejo, como las de Sony y Olympus, comenzaron a soportarlo desde 2014, pero todavía se requería unir los resultados manualmente. Son innovaciones típicas de las cámaras grandes.
Los smartphones han tenido éxito aquí por una razón sorprendente: cuando tomas una foto, tus manos tienden a temblar. Este problema aparente ha sido la base para la implementación nativa de superresolución en los smartphones.
Para entender cómo funciona, hay que recordar cómo está estructurado el sensor de cualquier cámara. Cada píxel (fotodiodo) solo puede medir la intensidad de la luz, es decir, la cantidad de fotones que inciden. Sin embargo, un píxel no puede detectar el color (longitud de onda). Para obtener una imagen en RGB, fue necesario recurrir a un truco: cubrir todo el sensor con una cuadrícula de pequeños cristales de diversos colores. La implementación más popular de esto se llama filtro Bayer y se utiliza hoy en día en la mayoría de los sensores. Se ve como en la imagen de abajo.
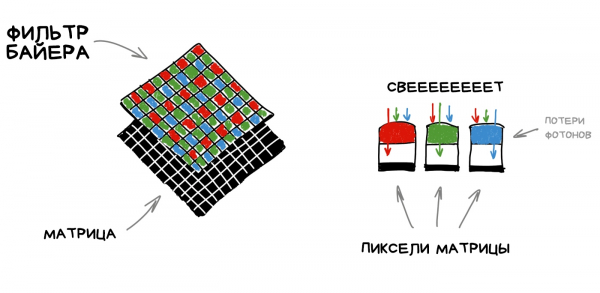
Así que, cada píxel del sensor solo captura el componente R, G o B, ya que los demás fotones son reflejados por el filtro Bayer. Los componentes faltantes se obtienen mediante un promedio simple de los valores de los píxeles vecinos.
Las celdas verdes en el filtro Bayer son más numerosas, siguiendo el modelo del ojo humano. De los 50 millones de píxeles en el sensor, el color verde capturará 25 millones, mientras que el rojo y el azul tendrán 12,5 millones cada uno. El resto se promediará, un proceso conocido como debayerización o demosaico, que es un truco tan artificial sobre el que todo se mantiene.
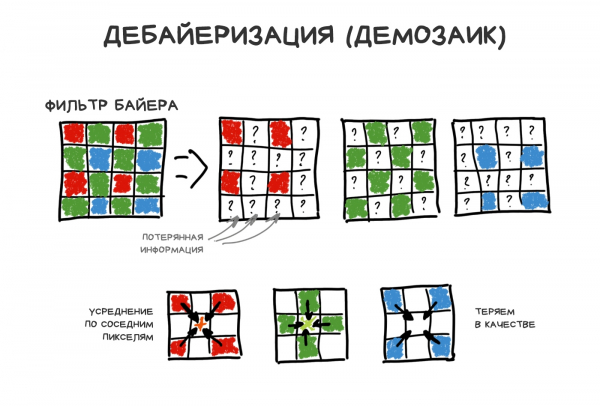
En realidad, cada sensor tiene su propio algoritmo patentado para la demosaico, pero en el marco de esta historia, lo vamos a pasar por alto.
Otros tipos de sensores (como los de Foveon) aún no han ganado popularidad. Aunque algunos fabricantes intentan utilizar sensores sin el filtro Bayer para mejorar la nitidez y el rango dinámico.
Cuando hay poca luz o los detalles del objeto son minúsculos, perdemos mucha información porque el filtro Bayer corta descaradamente los fotones con longitudes de onda no deseadas. Por eso se ideó el Pixel Shifting: desplazar el sensor un píxel hacia arriba, abajo, derecha o izquierda para capturarlos todos. La fotografía resultante no es cuatro veces más grande, como podría parecer; simplemente, el procesador utiliza estos datos para registrar con mayor precisión el valor de cada píxel. Promedia no con los vecinos, así decirlo, sino con los cuatro valores de sí mismo.
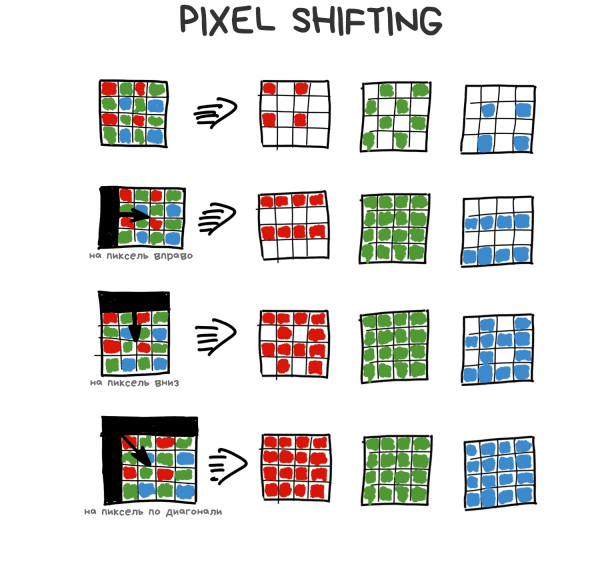
Las sacudidas de nuestras manos al tomar fotos con el teléfono hacen que este proceso sea una consecuencia natural. En las últimas versiones de Google Pixel, esta función se implementa y se activa siempre que utilizas el zoom en el teléfono; se llama Super Res Zoom (sí, a mí también me gusta su implacable nombramiento). Los chinos también lo copiaron en sus teléfonos, aunque el resultado fue un poco peor.
La superposición de fotos ligeramente desplazadas permite recopilar más información sobre el color de cada píxel y, por lo tanto, reducir el ruido, aumentar la nitidez y elevar la resolución sin aumentar el número físico de megapíxeles del sensor. Los flagships modernos de Android hacen esto automáticamente, mientras sus usuarios ni siquiera piensan en ello.
El apilamiento por enfoque — cualquier profundidad de campo y re-enfoque en posproducción.
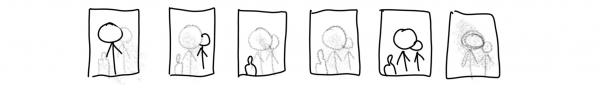
El método proviene de la macrofotografía, donde una profundidad de campo reducida siempre ha sido un problema. Para que todo el objeto estuviera enfocado, era necesario hacer varias tomas con el enfoque desplazándose hacia adelante y hacia atrás, para luego unirlas en una sola imagen nítida. El mismo método era a menudo utilizado por aficionados a la fotografía de paisajes, logrando que tanto el primer plano como el fondo fueran nítidos como si fueran de pasta.
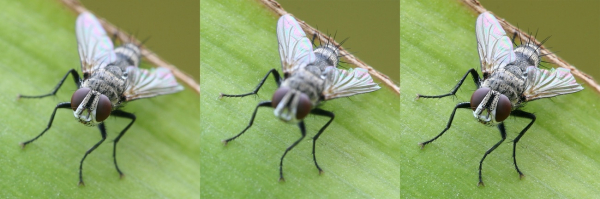
Todo esto también se trasladó a los smartphones, aunque sin mucho ruido. En 2013, salió el Nokia Lumia 1020 con la 'Refocus App', y en 2014 el Samsung Galaxy S5 con el modo 'Selective Focus'. Funcionaban según el mismo esquema: al presionar el botón, tomaban rápidamente 3 fotografías: una con enfoque 'normal', otra con el enfoque desplazado hacia adelante y la tercera con el enfoque desplazado hacia atrás. La aplicación alineaba los cuadros y permitía seleccionar uno de ellos, lo que se presentaba como un control 'real' del enfoque en la postproducción.
No hubo más procesamiento, ya que incluso este simple truco fue suficiente para enterrar aún más la idea del Lytro y sus equivalentes con su verdadero reaprendizaje del enfoque. Por cierto, hablemos de ellos (maestro del cambio de niveles 80).
Matrices computacionales: campos de luz y plenóptica
Como entendimos anteriormente, nuestras matrices son un desastre. Simplemente nos hemos acostumbrado y tratamos de vivir con ello. En cuanto a su estructura, han cambiado poco desde los inicios. Solo hemos mejorado el proceso tecnológico: reduciendo la distancia entre píxeles, combatiendo el ruido, añadiendo píxeles especiales para el funcionamiento del autofocus de fase. Pero basta con tomar incluso la DSLR más cara y tratar de fotografiar un gato corriendo en condiciones de luz ambiental: el gato, suavemente dicho, ganará.
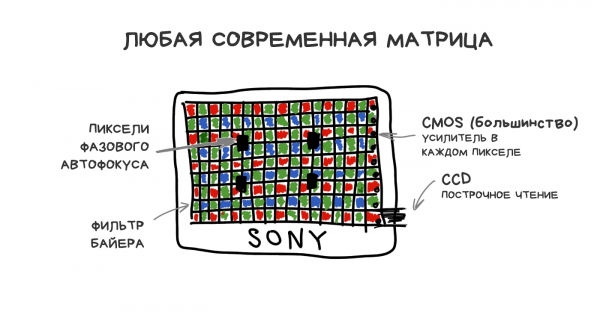
Ya hemos estado intentando inventar algo mejor durante mucho tiempo. Muchas de las tentativas y estudios en este campo pueden encontrarse buscando 'sensor computacional' o 'sensor no Bayer', e incluso el ejemplo del Pixel Shifting anterior se puede considerar un intento de mejorar las matrices mediante cálculos. Sin embargo, las historias más prometedoras de los últimos veinte años vienen del mundo de las llamadas cámaras plenópticas.
Para que no te quedes dormido ante la anticipación de las complicadas palabras que se avecinan, te dare un chisme: la cámara de los últimos Google Pixel es 'un poco' plenóptica. Solo dos píxeles, pero eso es suficiente para que pueda calcular la profundidad óptica real de la imagen sin necesidad de otra cámara como la de todos.
La plenóptica es una poderosa herramienta que aún no ha explotado. Aquí les dejo un enlace a uno de mis artículos recientes favoritos sobre las capacidades de las cámaras plenópticas y nuestro futuro con ellas. La cámara plenóptica: pronto será de todos.
Inventada en 1994, ensamblada en Stanford en 2004. La primera cámara de consumo, Lytro, fue lanzada en 2012. La industria de la realidad virtual ahora está experimentando activamente con tecnologías similares.
La única diferencia entre una cámara convencional y una plenóptica radica en una modificación: el sensor está cubierto por una malla de lentes, cada uno de los cuales abarca varios píxeles reales. Algo así:
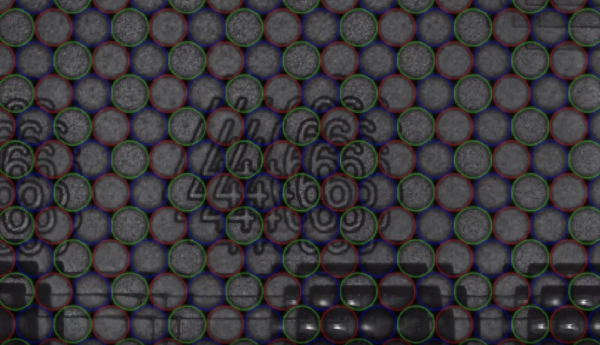
si se calcula correctamente la distancia de la malla al sensor y el tamaño de la apertura, la imagen resultante mostrará grupos nítidos de píxeles, mini versiones de la imagen original.
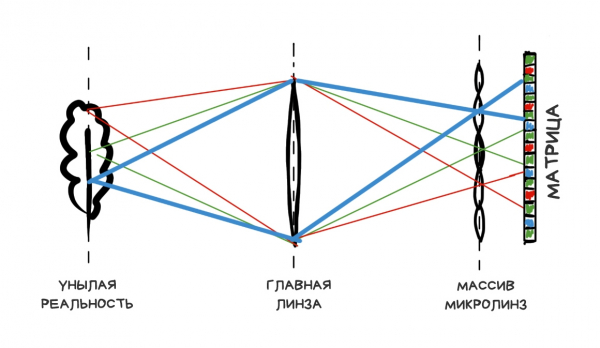
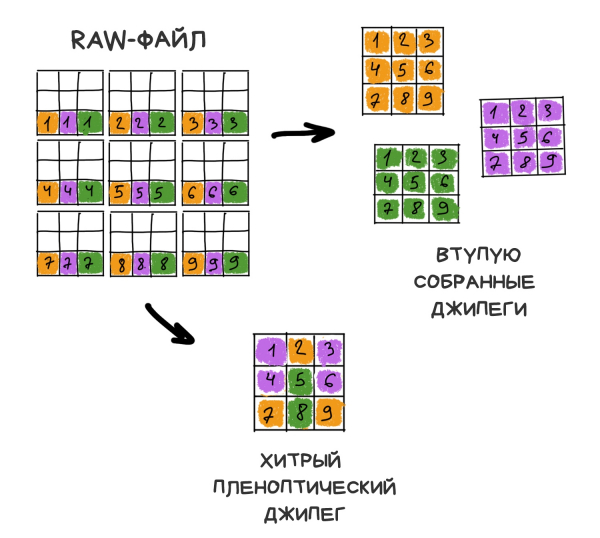
Resulta que si tomamos un píxel central de cada grupo y ensamblamos la imagen solo a partir de ellos, no habrá diferencia con una captura hecha con una cámara normal. Sí, hemos perdido un poco de resolución, pero solo pediremos a Sony que añada unos megapíxeles más a los nuevos sensores.
La diversión apenas comienza. Si tomamos otro píxel de cada grupo y ensamblamos de nuevo la imagen, obtendremos una fotografía normal, pero como si hubiera sido tomada con un desplazamiento de un píxel. Así, teniendo grupos de 10 × 10 píxeles, obtendremos 100 imágenes del objeto desde "puntos" ligeramente distintos.
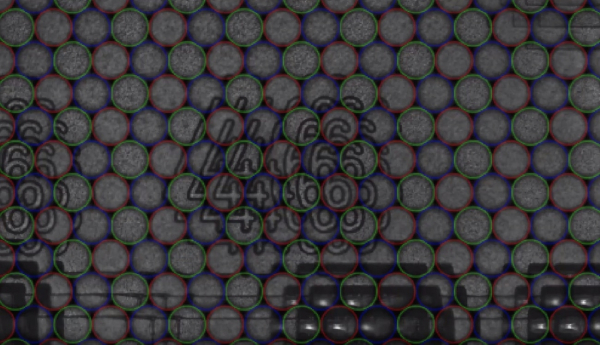
Cuanto mayor sea el tamaño del grupo, más imágenes tendremos, pero menor será la resolución. En el mundo de los smartphones con sensores de 41 megapíxeles, podemos permitirnos un poco de indulgencia con la resolución, pero hay un límite. Debemos mantener el equilibrio.
De acuerdo, hemos construido una cámara plenóptica, ¿y qué nos ofrece?
Reenfoque real.
La característica de la que todos los periodistas han hablado en los artículos sobre Lytro es la posibilidad de ajustar el enfoque de manera genuina en la postproducción. Por genuino me refiero a que no aplicamos algoritmos de desenfoque, sino que usamos únicamente los píxeles disponibles, seleccionándolos o promediándolos de los grupos en el orden necesario.
La característica de la que todos los periodistas han hablado en los artículos sobre Lytro es la posibilidad de ajustar el enfoque de manera genuina en la postproducción. Por genuino me refiero a que no aplicamos algoritmos de desenfoque, sino que usamos únicamente los píxeles disponibles, seleccionándolos o promediándolos de los grupos en el orden necesario.
Una fotografía RAW de una cámara plenóptica se ve extraña. Para convertirla en un JPEG nítido habitual, primero hay que ensamblarla. Para ello, se debe seleccionar cada píxel del JPEG de uno de los clústeres del RAW. Dependiendo de cómo los seleccionemos, el resultado variará.
Por ejemplo, cuanto más lejos esté un clúster del lugar de incidencia del rayo original, más desenfocado aparecerá este rayo. Esto se debe a la óptica. Para obtener una imagen desenfocada, solo necesitamos seleccionar píxeles a la distancia deseada del original, ya sea más cerca o más lejos.
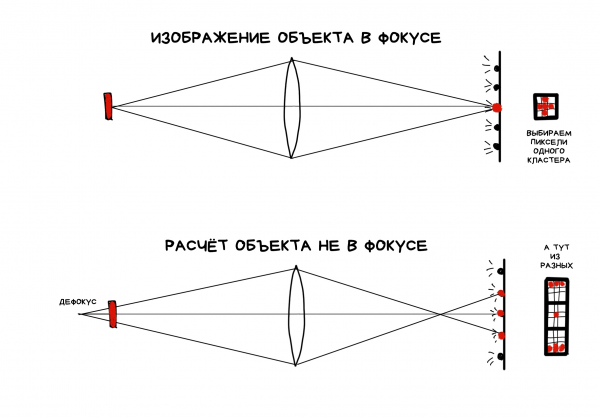
Con el desplazamiento del enfoque hacia uno mismo fue más complicado; físicamente, había menos de esos píxeles en los clústeres. Al principio, los desarrolladores ni siquiera querían permitir que el usuario enfocar a mano; la cámara lo decidía automáticamente a través de software. A los usuarios no les agradó este futuro, por lo que la función se añadió en versiones posteriores con el nombre de "modo creativo", pero hicieron que el re-enfoque fuera muy limitado precisamente por esta razón.
Mapa de profundidad y 3D de una sola cámara
Una de las operaciones más simples en la plenóptica es obtener un mapa de profundidad. Para ello, solo se necesita capturar dos tomas diferentes y calcular cuánto se han desplazado los objetos en ellas. Cuanto mayor sea el desplazamiento, más lejos estará de la cámara.
Recientemente, Google compró y retiró a Lytro, pero utilizó su tecnología para su VR y... para la cámara del Pixel. Desde el Pixel 2, la cámara se volvió "un poco" plenóptica por primera vez, aunque con clústeres de solo dos píxeles. Esto permitió a Google no instalar una segunda cámara, como hicieron todos los demás, y calcular el mapa de profundidad exclusivamente a partir de una sola fotografía.
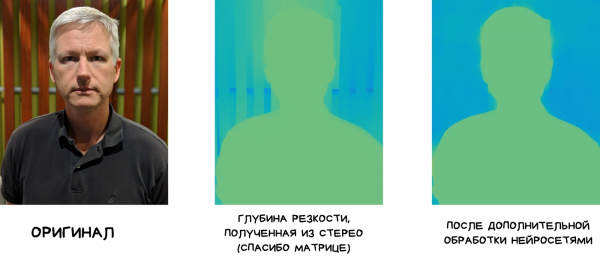
El mapa de profundidad se construye a partir de dos tomas, desplazadas un subpíxel. Esto es suficiente para calcular un mapa de profundidad binarizado y separar el primer plano del fondo, difuminando este último de la manera de moda en el bokeh. El resultado de tal descomposición se suaviza y "mejora" mediante redes neuronales que han sido entrenadas para mejorar mapas de profundidad (y no para difuminar, como muchos piensan).
La gracia adicional es que la plenóptica en los smartphones casi nos llegó gratis. Ya estábamos colocando lentes en estos diminutos sensores para aumentar el flujo de luz de alguna manera. En los próximos Pixel, Google planea ir más allá y cubrir cuatro fotodiodos con una lente.
Fuente: 3dnews.ru
