

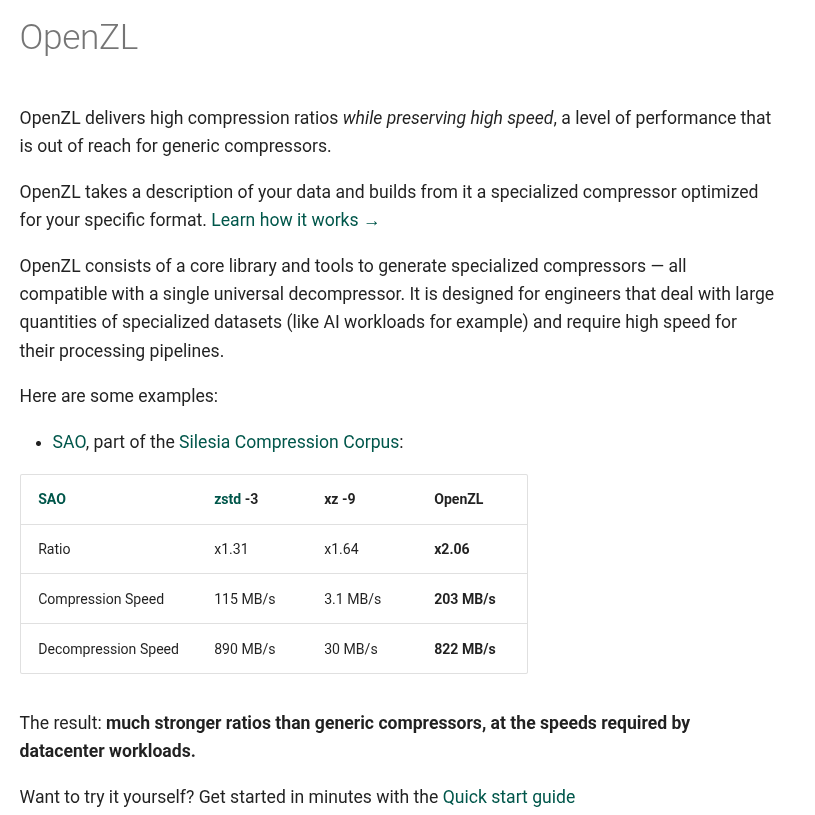
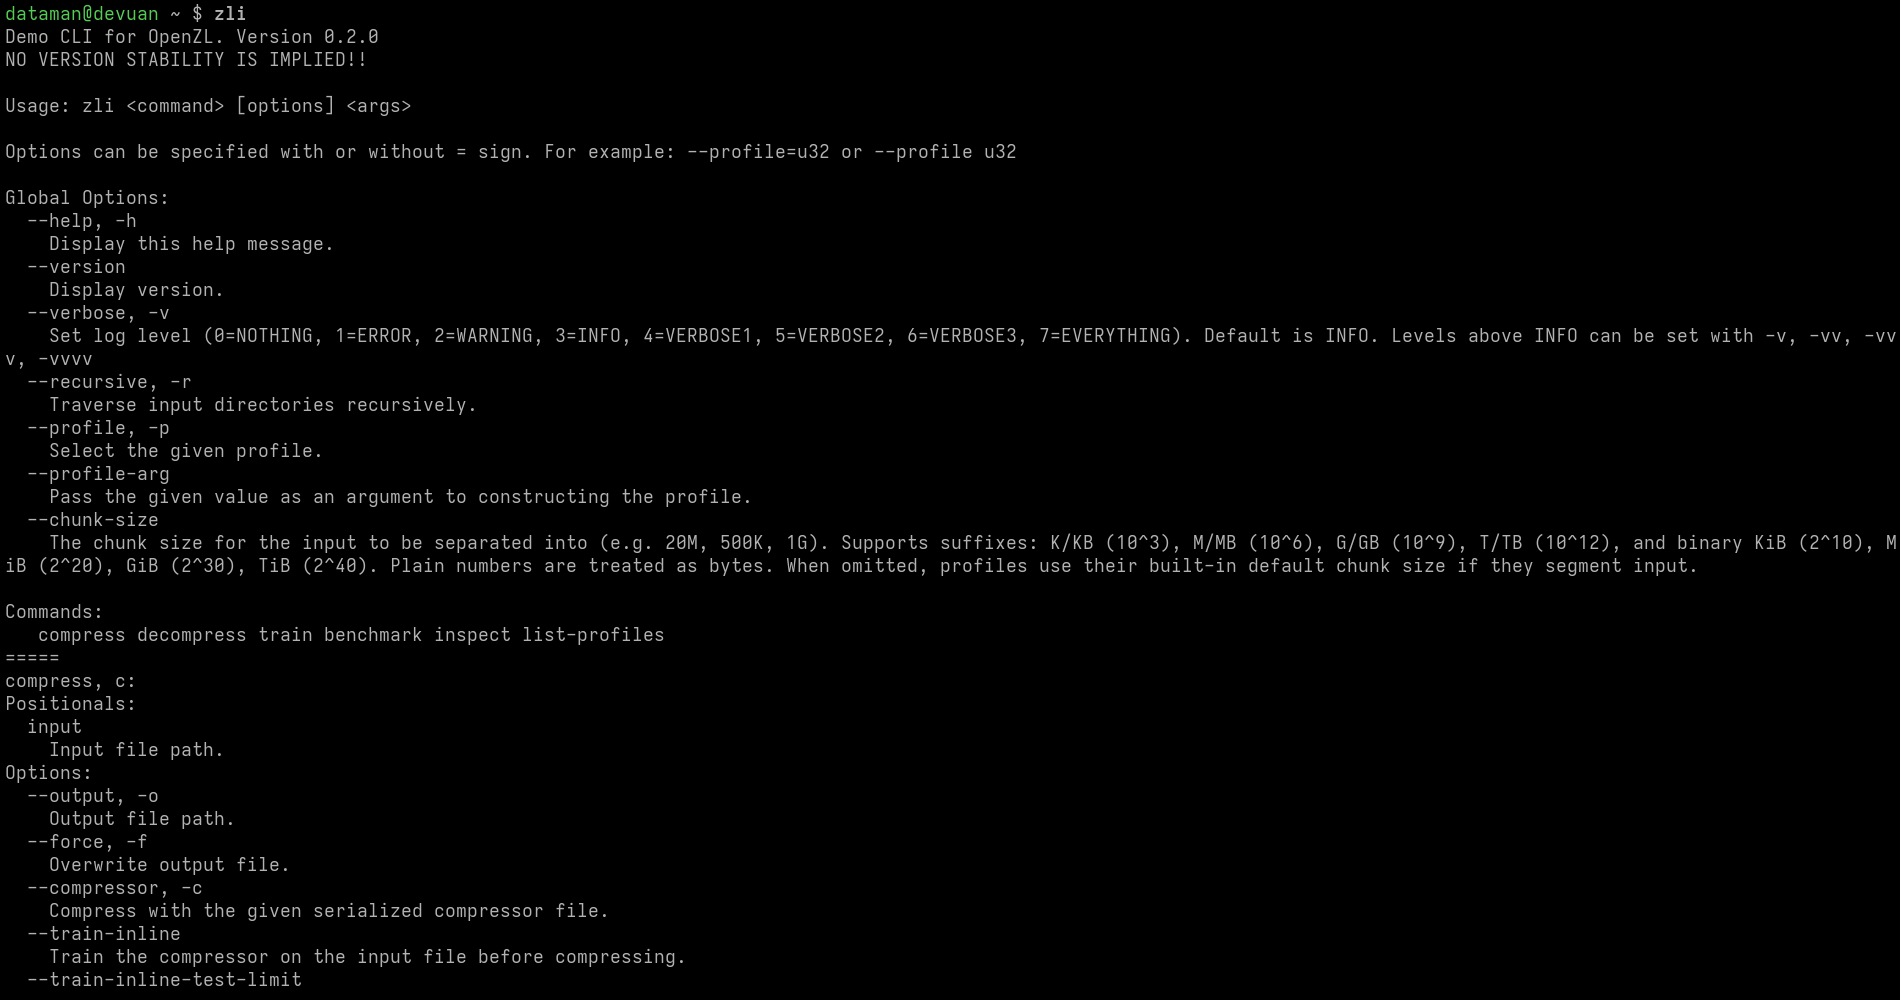
Después de siete meses de desarrollo, se lanzó la versión 0.2.0 del framework OpenZL, diseñado para crear compresores de datos sin pérdidas.
El framework consta de una biblioteca básica y herramientas para crear compresores especializados, descritos en el lenguaje SDDL.
Para crear un buen compresor especializado, hay dos etapas:
- Análisis de datos para extraer la estructura.
- Uso de buenos compresores backend, que utilizan la estructura obtenida para lograr una buena compresión.
OpenZL proporciona herramientas para ambas etapas.
El proyecto está escrito en C y C++ y se distribuye bajo la licencia BSD.
Principales cambios
SDDL2
SDDL ha sido completamente reescrito desde cero para lograr los objetivos de diseño establecidos. Si la versión demo inicial era un entorno de ejecución simplificado, SDDL2 es un compilador completo: el analizador sintáctico pasa los datos al analizador semántico, que a su vez pasa el árbol de sintaxis abstracto (AST) tipificado al optimizador, y el optimizador gestiona el generador de código, que genera bytecode para la máquina virtual.
El resultado clave es el análisis sintáctico instantáneo. Cuando la ubicación de un registro puede determinarse completamente solo por parámetros y constantes, el motor va directamente a cualquier campo, sin escanear los bytes anteriores, lo que proporciona acceso sin copias y un ancho de banda de varios GB/s.
El propio lenguaje ha evolucionado junto con el conjunto de herramientas. Ahora admite bloques when para ubicaciones condicionales, registros parametrizados y anónimos, acceso a los miembros de los campos de los registros, así como operadores a nivel de bits y lógicos.
En lo que respecta a la comodidad del desarrollador, la etapa de análisis semántico ahora identifica referencias indefinidas, desajustes de tipos y errores de aridad en tiempo de compilación – con la ubicación en el código fuente – en lugar de durante la ejecución, y también se ha lanzado una extensión de VS Code para el resaltado de sintaxis de archivos .sddl.
Nuevo códec LZ incorporado
En OpenZL ahora se incluye un códec LZ propio, presentado como ZL_GRAPH_LZ, así como un perfil de compresión secuencial en la utilidad zli. El trabajo en el códec continúa: se está ampliando el conjunto de funciones y mejorando el rendimiento al procesar pequeños datos de entrada. Hasta el momento, admite funcionalidad equivalente a zstd nivel 1, con un tamaño de ventana de compresión de 64 KB.
OpenZL permite rediseñar cada etapa del proceso LZ con el fin de aumentar la velocidad. Su arquitectura gráfica también permite combinar etapas de codificación de entropía en lugar de utilizar un solo proceso que se adapte igualmente a todos los escenarios de uso. Luego, varias etapas se pueden combinar en una sola operación para aumentar la velocidad de procesamiento. Esto le permite a OpenZL lograr una velocidad de compresión un 10% más alta y una velocidad de descompresión un 70% más alta en comparación con Zstandard nivel 1 en la prueba de Silesia. nuestros tests:
| Compresor | Tasa de compresión | Velocidad de compresión | Velocidad de descompresión |
|---|---|---|---|
| OpenZL LZ nivel 1 | 2.74 | 466 MB/s | 2288 MB/s |
| Zstd nivel 1 con tamaño de ventana de 64K | 2.74 | 419 MB/s | 1254 MB/s |
| Zstd nivel 1 | 2.89 | 424 MB/s | 1345 MB/s |
Soporte para entradas muy grandes
zli ahora admite el procesamiento de grandes entradas (de varios gigabytes). Antes de la compresión, estos datos ahora se dividen automáticamente en fragmentos de tamaño manejable (por defecto, aproximadamente 16 MB), lo que permite limitar la cantidad de memoria utilizada, aumentar la localidad de los datos y abre posibilidades para el procesamiento paralelo. En SDDL2 se implementó una función similar de fragmentación automática durante la operación. Se han creado o actualizado nuevos segmentadores para CSV, Parquet y datos numéricos estándar, y todos los segmentadores ahora son serializables y configurables, de modo que la configuración seleccionada se puede guardar en el compresor y reutilizar más tarde.
Esto se aplica de manera transparente durante la compresión. Cabe señalar que el proceso de aprendizaje es diferente y permanece intacto, por lo que no está diseñado para aceptar grandes entradas como material de entrenamiento.
Mejoras en el visualizador de gráficos en línea (probar)
Ahora el visualizador reconoce las trazas de compresión y descompresión de principio a fin.
El panel de vista previa de flujo permite ver los bytes que están pasando a través de cada borde, y gracias a los controles de recorte, incluso los flujos grandes se mantienen manejables.
El panel de configuración combina todas las opciones de visualización en un solo lugar, y el conjunto completo de teclas de acceso rápido —navegación direccional, recorrido ordenado, expansión y contracción, selección de nodos— permite trabajar fácilmente con la herramienta sin ratón.
Ahora las trazas tienen versiones, la compresión con división en bloques se muestra correctamente, y zli finalmente puede generar sus propias trazas utilizando las nuevas banderas —trace y —trace-streams-dir.
Varios
- Se han añadido varios códecs al catálogo. Los códecs Partition y bitpack ahora utilizan un decodificador combinado. El códec de bits flotantes ha recibido codificadores y decodificadores específicos para los formatos fp16, fp32, fp64 y bf16 con aceleraciones especializadas. Se han añadido la división por rango (split_byrange), un multiplexor de longitud, el códec sentinel, el gráfico lz4 y funciones auxiliares pequeñas, como tryParseInt y splitByParam.
- El API se ha ordenado.
- Se ha mejorado la prueba de fuzzing.
- Se ha mejorado el proceso de construcción y empaquetado para una mayor cantidad de plataformas.
Fuente: linux.org.ru
