

Se ha publicado una guía detallada sobre la optimización del entorno Linux para lograr el máximo rendimiento en el procesamiento de solicitudes HTTP. Los métodos propuestos permitieron aumentar el rendimiento del manejador JSON basado en la biblioteca libreactor en un entorno de Amazon EC2 (4 vCPU) de 224 mil solicitudes API por segundo con la configuración predeterminada de Amazon Linux 2 con núcleo 4.14 a 1.2 millones de solicitudes por segundo después de la optimización (un aumento del 436%), y también llevaron a una reducción del 79% en la latencia al procesar solicitudes. Los métodos propuestos no son específicos para libreactor y funcionan con otros servidores http, incluidos nginx, Actix, Netty y Node.js (libreactor se utilizó en las pruebas ya que la solución basada en él mostró el mejor rendimiento).
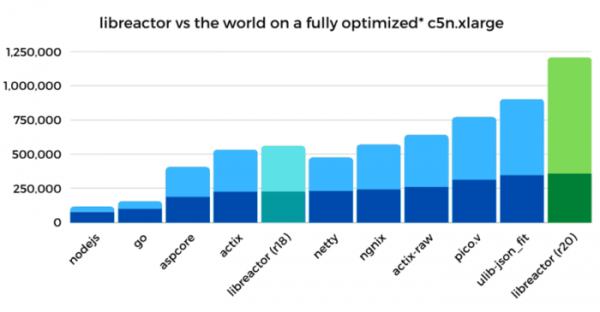
Optimizaciones principales:
- Optimización del código libreactor. Se utilizó como base la versión R18 del conjunto Techempower, que fue mejorada eliminando el código que limitaba el número de núcleos de CPU utilizados (la optimización permitió aumentar la velocidad en un 25-27%), compilando en GCC con las opciones «-O3» (aumento del 5-10%) y «-march-native» (5-10%), reemplazando las llamadas read/write por recv/send (5-10%) y reduciendo la sobrecarga al usar pthreads (2-3%). El aumento total del rendimiento después de la optimización del código fue del 55%, y el rendimiento pasó de 224k req/s a 347k req/s.
- Desactivación de la protección contra vulnerabilidades causadas por la ejecución especulativa de instrucciones. El uso de parámetros al cargar el núcleo «nospectre_v1 nospectre_v2 pti=off mds=off tsx_async_abort=off» permitió aumentar el rendimiento en un 28%, y el rendimiento pasó de 347k req/s a 446k req/s. El aumento individual del parámetro «nospectre_v1» (protección contra Spectre v1 + SWAPGS) fue del 1-2%, «nospectre_v2» (protección contra Spectre v2) del 15-20%, «pti=off» (Spectre v3/Meltdown) del 6%, «mds=off tsx_async_abort=off» (MDS/Zombieload y TSX Asynchronous Abort) del 6%. Se han dejado sin cambios las configuraciones de protección contra ataques L1TF/Foreshadow (l1tf=flush), iTLB multihit, Speculative Store Bypass y SRBDS, que no afectaron al rendimiento, ya que no se cruzaron con la configuración probada (por ejemplo, son específicas para KVM, virtualización anidada y otros modelos de CPU).
- Desactivación de los mecanismos de auditoría y bloqueo de llamadas al sistema mediante el comando «auditctl -a never,task» y especificando la opción «—security-opt seccomp=unconfined» al iniciar el contenedor docker. El aumento total del rendimiento fue del 11%, y el rendimiento pasó de 446k req/s a 495k req/s.
- Desactivación de iptables/netfilter mediante la descarga de los módulos del núcleo relacionados. La idea de desactivar el cortafuegos, que no se utilizaba en la solución del servidor específica, fue impulsada por los resultados de la profilación, los cuales indicaron que la función nf_hook_slow consumía el 18% del tiempo. Se señala que nftables opera de manera más eficiente que iptables, pero en Amazon Linux todavía se utiliza iptables. Tras desactivar iptables, el aumento en el rendimiento fue del 22%, y el ancho de banda aumentó de 495k req/s a 603k req/s.
- Reducción de la migración de manejadores entre diferentes núcleos de CPU para mejorar la eficiencia del uso de la caché de procesador. La optimización se realizó tanto a nivel de vinculación de procesos de libreactor a núcleos de CPU (CPU Pinning), como mediante la fijación de los manejadores de red del núcleo (Receive Side Scaling). Por ejemplo, se desactivó irqbalance y se establecieron explícitamente las vinculaciones de colas a CPU en /proc/irq/$IRQ/smp_affinity_list. Para utilizar el mismo núcleo de CPU para procesar el proceso libreactor y la cola de red de paquetes entrantes, se implementó un manejador BPF propio, conectado mediante la configuración de la bandera SO_ATTACH_REUSEPORT_CBPF al crear el socket. Para vincular las colas de paquetes salientes a la CPU, se modificaron las configuraciones en /sys/class/net/eth0/queues/tx-<n>/xps_cpus. El aumento total en el rendimiento fue del 38%, y el ancho de banda aumentó de 603k req/s a 834k req/s.
- Optimización del procesamiento de interrupciones y uso de polling. La activación del modo adaptive-rx en el controlador ENA y las manipulaciones con sysctl net.core.busy_read permitieron aumentar el rendimiento en un 28% (el ancho de banda aumentó de 834k req/s a 1.06M req/s, y las latencias se redujeron de 361μs a 292μs).
- Desactivación de servicios del sistema que causan bloqueos adicionales en la pila de red. La desactivación de dhclient y la configuración IP manualmente condujo a un aumento en el rendimiento del 6%, y el ancho de banda aumentó de 1.06M req/s a 1.12M req/s. La razón del impacto de dhclient en el rendimiento se encuentra en el análisis del tráfico utilizando un socket en bruto.
- Lucha contra el Spin Lock. La transición de la pila de red al modo "noqueue" a través de sysctl "net.core.default_qdisc=noqueue" y "tc qdisc replace dev eth0 root mq" resultó en un aumento del rendimiento del 2%, y el ancho de banda aumentó de 1.12M req/s a 1.15M req/s.
- Las optimizaciones finales menores, como desactivar GRO (Generic Receive Offload) con el comando «ethtool -K eth0 gro off» y cambiar el algoritmo de control de congestión de cubic a reno mediante sysctl «net.ipv4.tcp_congestion_control=reno». La ganancia total de rendimiento fue del 4%. El rendimiento aumentó de 1.15M req/s a 1.2M req/s.
Además de las optimizaciones implementadas, el artículo también analiza métodos que no llevaron al aumento esperado en el rendimiento. Por ejemplo, resultaron ineficaces:
- La ejecución independiente de libreactor no mostró diferencias en el rendimiento en comparación con la ejecución en un contenedor. No influyeron el cambio de writev a send, el aumento de maxevents en epoll_wait, ni los experimentos con versiones y banderas de GCC (el efecto solo fue notable para las banderas «-O3» y «-march-native»).
- La actualización del núcleo de Linux a las versiones 4.19 y 5.4 no afectó el rendimiento, al igual que el uso de los schedulers SCHED_FIFO y SCHED_RR, y las manipulaciones de sysctl kernel.sched_min_granularity_ns, kernel.sched_wakeup_granularity_ns, transparent_hugepages=never, skew_tick=1 y clocksource=tsc.
- En el controlador ENA, no influyó la activación de los modos Offload (segmentación, scatter-gather, rx/tx checksum), la compilación con la bandera «-O3» y la aplicación de los parámetros ena.rx_queue_size y ena.force_large_llq_header.
- Los cambios en la pila de red no llevaron a un aumento del rendimiento:
- Desactivación de IPv6: ipv6.disable=1
- Desactivación de VLAN: modprobe -rv 8021q
- Desactivación de la comprobación de la fuente del paquete
- net.ipv4.conf.all.rp_filter=0
- net.ipv4.conf.eth0.rp_filter=0
- net.ipv4.conf.all.accept_local=1 (efecto negativo)
- net.ipv4.tcp_sack=0
- net.ipv4.tcp_dsack=0
- net.ipv4.tcp_mem/tcp_wmem/tcp_rmem
- net.core.netdev_budget
- net.core.dev_weight
- net.core.netdev_max_backlog
- net.ipv4.tcp_slow_start_after_idle=0
- net.ipv4.tcp_moderate_rcvbuf=0
- net.ipv4.tcp_timestamps=0
- net.ipv4.tcp_low_latency=1
- SO_PRIORITY
- TCP_NODELAY
Fuente: opennet.ru
