

Un ingeniero de la empresa Clyso resumió la experiencia de crear un clúster de almacenamiento basado en un sistema distribuido tolerante a fallos Ceph con un ancho de banda superior a un tebibyte por segundo. Se destaca que este es el primer clúster basado en Ceph que ha alcanzado una cifra así, pero antes de conseguir este resultado, los ingenieros tuvieron que superar una serie de obstáculos no evidentes.
Por ejemplo, para aumentar el rendimiento en un 10-20%, fue suficiente habilitar en los servidores la opción de funcionamiento únicamente en modo de rendimiento máximo en la configuración de ahorro de energía del BIOS y desactivar c-state (c-state ajusta los parámetros de ahorro de energía según la carga, lo que afecta a Ceph). También se descubrió que al utilizar unidades NVMe, el núcleo de Linux gastaba un tiempo significativo en el manejo de bloqueos de tipo spin durante la actualización del mapeo de IOMMU. Desactivar IOMMU en el núcleo condujo a un aumento notable en el rendimiento en las pruebas de escritura y lectura de bloques de 4MB.
Sin embargo, desactivar IOMMU no resolvió el problema de la caída del rendimiento al realizar escrituras aleatorias de bloques de 4KB. Al investigar la causa, los ingenieros se encontraron con correcciones en los scripts de construcción de Ceph de los proyectos Gentoo y Ubuntu, que incluían la compilación con la opción RelWithDebInfo, ya que con esta opción en GCC se aplicaba el modo de optimización '-O2', lo que aumentaba notablemente el rendimiento de Ceph. La compilación con la biblioteca TCMalloc también contribuía a la disminución del rendimiento. Cambiar las banderas de compilación y dejar de usar TCMalloc resultó en una reducción del tiempo de compactación en tres veces y un aumento del rendimiento de las operaciones de escritura aleatorias de bloques de 4K en dos veces. Al final, se realizó una optimización adicional de la configuración de Reef RocksDB y de los grupos de colocación (PG).
El clúster está formado por 68 nodos basados en servidores Dell PowerEdge R6615 con CPU AMD EPYC 9454P 48C/96T. Cada nodo contiene 10 unidades NVMe Dell de 15.36TB, dos adaptadores Ethernet 100GbE Mellanox ConnectX-6 y 192 GB de RAM. El software está basado en Ubuntu 20.04.6 y Ceph 17.2.7. En el clúster de 63 nodos se han levantado 630 OSD (Object Storage Daemon, proceso en segundo plano que gestiona el almacenamiento de datos en el almacenamiento local, uno por cada unidad NVMe), tres procesos MON (monitor, que sigue el estado del clúster) y un proceso MGR (Manager, servicio de gestión). La capacidad de almacenamiento es de 8.2 PB.
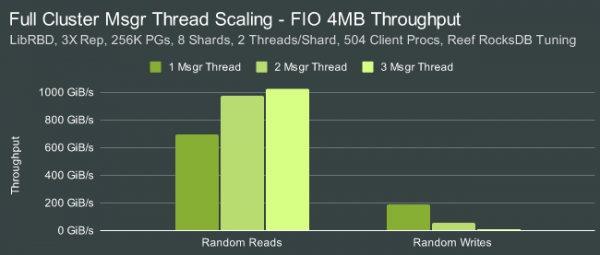
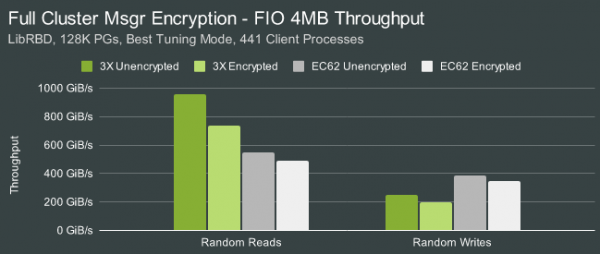
La capacidad de transferencia durante operaciones secuenciales de lectura de bloques de 4M fue de 1025 GiB/s, y de escritura — 270 GiB/s. En la lectura aleatoria de bloques de 4KB, el rendimiento fue de 25.5 millones de operaciones de lectura por segundo y 4.9 millones en escritura. La activación de la encriptación redujo la capacidad de transferencia durante la lectura a aproximadamente 750 GiB/s. Al emplear códigos de corrección de errores EC62, la capacidad de transferencia fue de 547 GiB/s en lectura y 387 GiB/s en escritura (la velocidad de escritura resultó ser mayor que sin códigos de corrección), y en acceso aleatorio, 3.4M IOPS en lectura y 936K IOPS en escritura.
Adicionalmente, se puede mencionar que en septiembre se alcanzó un hito similar en capacidad de transferencia en tebibytes por segundo en el clúster de almacenamiento de exabytes del CERN, implementado sobre el almacenamiento distribuido abierto EOS, construido sobre el protocolo XRootD.
Fuente: opennet.ru
