

El proyecto OpenAI, que se dedica al desarrollo de proyectos de inteligencia artificial de acceso público, ha publicado avances relacionados con el sistema de reconocimiento de voz Whisper. Se afirma que para el habla en inglés, el sistema proporciona niveles de fiabilidad y precisión de reconocimiento automático cercanos a los de un ser humano. El código de la implementación de referencia está disponible en la base del marco PyTorch y se han liberado un conjunto de modelos ya entrenados, listos para usar. El código se publica bajo la licencia MIT.
Para entrenar el modelo se utilizaron 680 mil horas de datos de voz, recopilados de varias colecciones que abarcan diferentes idiomas y áreas temáticas. Aproximadamente 1/3 de los datos de voz utilizados para el entrenamiento corresponden a idiomas distintos del inglés. El sistema propuesto maneja correctamente situaciones como pronunciación con acento, presencia de ruido de fondo y uso de jerga técnica. Además de la transcripción de voz a texto, el sistema también puede traducir la voz de cualquier idioma al inglés y detectar la aparición de voz en el flujo de audio.
Los modelos se han formado en dos versiones: un modelo para el idioma inglés y un modelo multilingüe que admite, entre otros, los idiomas ruso, ucraniano y bielorruso. A su vez, cada versión se divide en 5 variantes, que difieren en tamaño y número de parámetros incluidos en el modelo. Cuanto mayor es el tamaño, mayor es la precisión y calidad del reconocimiento, pero también mayores son los requisitos para el tamaño de la memoria de video del GPU y menor es el rendimiento. Por ejemplo, la variante mínima incluye 39 millones de parámetros y requiere 1 GB de memoria de video, mientras que la variante máxima incluye 1550 millones de parámetros y requiere 10 GB de memoria de video. La variante mínima es 32 veces más rápida que la máxima.
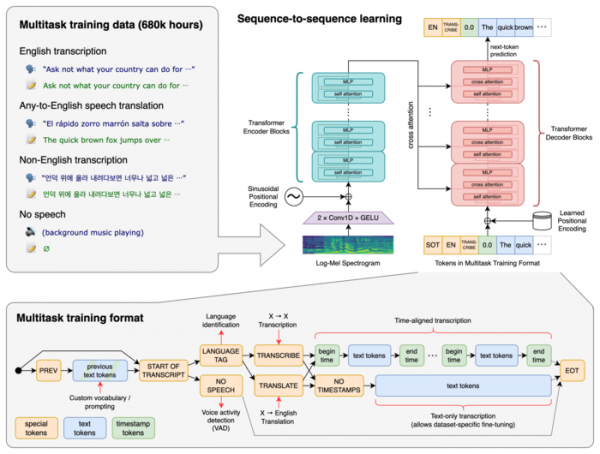
El sistema utiliza una arquitectura de red neuronal "Transformer", que incluye un codificador y un decodificador que interactúan entre sí. El sonido se divide en segmentos de 30 segundos, que se convierten en un espectrograma log-Mel y se envían al codificador. El resultado del codificador se envía al decodificador, que predice una representación textual, mezclada con tokens especiales que permiten abordar tareas como la detección de idioma, el seguimiento de la cronología de la pronunciación de frases, la transcripción de voz en diferentes idiomas y la traducción al inglés.
Fuente: opennet.ru
