

Después de cinco meses de desarrollo, se ha publicado la versión 1.1 del proyecto IncidentRelay, que desarrolla un sistema abierto para la organización de turnos, la gestión de alertas y el manejo de incidentes, que se ejecuta en un servidor propio (self-hosted). IncidentRelay 1.1 se marca como la primera versión estable (la rama 1.0 tenía el estado de versión beta). El proyecto está orientado a SRE, DevOps y equipos de infraestructura que requieren una alternativa local a los servicios SaaS para la gestión de turnos (on-call management), la aplicación de políticas de escalación y la respuesta a incidentes. El código del proyecto está escrito en Python y se distribuye bajo la licencia MIT.
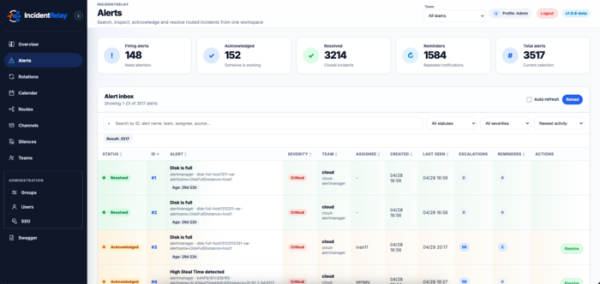
IncidentRelay recibe eventos de sistemas de monitoreo, los asocia con servicios, equipos y rotaciones, y luego entrega notificaciones a los turnos responsables o a los equipos. El sistema implementa horarios de turnos, rotaciones, redefiniciones de turnos, confirmación de recepción de incidentes, estados ACK/Resolve, recordatorios, escalaciones, reemplazos temporales de turnos, determinación del tiempo de mantenimiento programado y supresión de alertas ruidosas.
La principal ventaja del proyecto es el control total sobre la infraestructura y la lógica de enrutamiento. IncidentRelay se despliega en su propio entorno, trabaja con su base de datos y permite separar claramente las rutas entrantes, los equipos, las rotaciones y los canales de entrega. Los tokens entrantes pertenecen a las rutas y no a los canales, lo que facilita la comprensión de qué fuente externa tiene permiso para enviar eventos a un equipo específico.
IncidentRelay admite la recepción de eventos de Prometheus Alertmanager, Grafana Alerting, Zabbix, Sentry, LibreNMS, RMON, AWS SNS/CloudWatch y webhooks arbitrarios. Para el envío de notificaciones, se han previsto canales como Mattermost, Slack, Telegram, Discord, Microsoft Teams, correo electrónico, webhooks, notificaciones push de navegador/PWA y proveedores de llamadas de voz. En Mattermost y Telegram, las notificaciones pueden incluir acciones para confirmar y resolver problemas, lo que permite manejar el incidente sin necesidad de cambiar a una interfaz separada.
El proyecto se puede ejecutar a través de Docker Compose, un paquete RPM para distribuciones similares a Red Hat, manualmente a través de systemd, así como en Kubernetes utilizando un Helm chart. Para instalaciones pequeñas, se puede usar SQLite, mientras que para sistemas de trabajo y cargas más altas se recomienda PostgreSQL.
La nueva versión incluye los siguientes cambios:
- Se han añadido rotaciones de servicio on-call en múltiples niveles con restricciones de tiempo, prioridades por capas y consideración de reemplazos temporales;
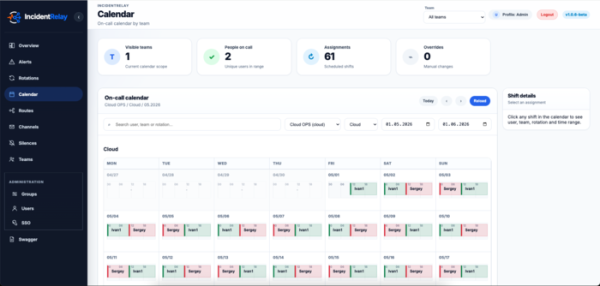
- Ahora hay un calendario de guardias, suscripciones CalDAV e ICS para calendarios externos;
- Se han implementado políticas de escalado de incidentes con cadenas de elevación de múltiples pasos;
- Se han añadido grupos de advertencias, agrupación de eventos, notificaciones diferidas y fusión manual de alertas relacionadas;
- Han aparecido ventanas para realizar tareas programadas y alertas 'silenciosas';
- Se ha añadido la capacidad de agregar comentarios a las alertas;
- Se han agregado prioridades de incidentes (P1-P5) y elevación automática de prioridad según el nivel de importancia;
- Se han implementado un catálogo de servicios, dependencias de servicios, SLI/SLO, historial de impacto en el funcionamiento de sistemas (Service Impact History) y servicios empresariales (Business Services);
- Ahora hay Explain Trace para analizar el enrutamiento: por qué una alerta fue o no fue incluida en el equipo, agrupada, suprimida o enviada a un canal específico;
- Se han añadido comprobaciones (Heartbeats/dead-man-switch) para watchdog, backup, ETL y otras tareas donde el problema es la falta de una señal esperada.
Fuente: opennet.ru
