

Se presentó el proyecto DBOS (Sistema Operativo Orientado a SGBD), que desarrolla un nuevo sistema operativo para ejecutar aplicaciones distribuidas y escalables. La característica distintiva del proyecto es el uso de un SGBD para almacenar aplicaciones y el estado del sistema, así como la organización del acceso al estado únicamente a través de transacciones. El proyecto está siendo desarrollado por investigadores del Instituto Tecnológico de Massachusetts, de las universidades de Wisconsin y Stanford, de la Universidad Carnegie Mellon y de las empresas Google y VMware. Los avances se distribuyen bajo la licencia MIT.
Los componentes para interactuar con el hardware y los servicios de gestión de memoria de bajo nivel se han trasladado a un microkernel. Las capacidades proporcionadas por el microkernel se utilizan para ejecutar una capa con SGBD. Los servicios del sistema de alto nivel, que garantizan la ejecución de aplicaciones, interactúan únicamente con el SGBD distribuido y están separados del microkernel y de los componentes específicos del sistema.
La construcción sobre un SGBD distribuido permite que los servicios del sistema sean inherentemente distribuidos y no estén vinculados a un nodo específico, lo que distingue a DBOS de los sistemas de clúster tradicionales, en los que cada nodo ejecuta su propia instancia del sistema operativo, sobre la cual se ejecutan planificadores de clúster separados, sistemas de archivos distribuidos y gestores de red.
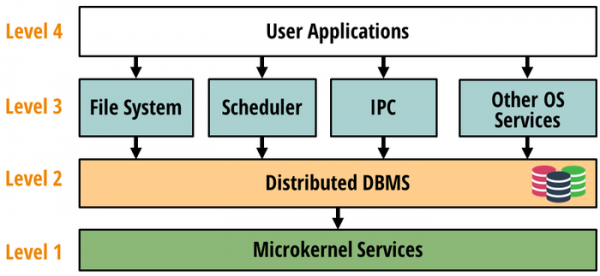
Se observa que el uso de SGBDs distribuidos modernos, que almacenan datos en memoria y admiten transacciones, como VoltDB y FoundationDB, como base para DBOS puede proporcionar un rendimiento suficiente para la ejecución eficaz de muchos servicios del sistema. En el SGBD también pueden almacenarse los datos del planificador, del sistema de archivos y de IPC. A su vez, estos SGBDs se escalan excelentemente, garantizan la atomicidad y aislamiento de las transacciones, pueden gestionar petabytes de datos y ofrecen herramientas para la gestión de acceso y el seguimiento de flujos de datos.
Entre las ventajas de la arquitectura propuesta se destaca la considerable ampliación de las capacidades analíticas y la reducción de la complejidad del código gracias al uso de consultas estándar de bases de datos en servicios del sistema operativo, donde se externaliza la implementación de transacciones y soluciones para garantizar alta disponibilidad (esta funcionalidad puede implementarse en la base de datos una vez y utilizarse en el sistema operativo y aplicaciones).
Por ejemplo, el planificador de clúster puede almacenar información sobre tareas y controladores en tablas de bases de datos y realizar operaciones de planificación como transacciones estándar, fusionando código imperativo y SQL. El uso de transacciones simplifica la resolución de problemas como la gestión de múltiples hilos y la recuperación ante fallos, ya que las transacciones garantizan la coherencia y la resistencia del estado. En el contexto del ejemplo del planificador, las transacciones permiten organizar el acceso simultáneo a datos compartidos y garantizar la integridad del estado en caso de fallos.
Los mecanismos de registro y análisis de datos proporcionados en la base de datos pueden utilizarse para rastrear el acceso y cambios en el estado de las aplicaciones, así como para monitorización, depuración y mantenimiento de la seguridad. Por ejemplo, tras detectar acceso no autorizado al sistema, se puede determinar el alcance de la filtración mediante la ejecución de consultas SQL, identificando todas las operaciones realizadas por los procesos que accedieron a información confidencial.
El proyecto se ha estado desarrollando durante más de un año y se encuentra en la fase de creación de prototipos de componentes individuales de la arquitectura. Actualmente se ha preparado un prototipo de servicios operativos que funcionan sobre la base de datos, tales como FS, IPC y el planificador, y se está desarrollando un entorno de programación que proporciona una interfaz para ejecutar aplicaciones basadas en el modelo FaaS (function-as-a-service).
En la siguiente fase de desarrollo, se planea proporcionar un conjunto completo de programas para aplicaciones distribuidas. Actualmente, se está utilizando VoltDB como sistema de gestión de bases de datos en los experimentos, pero se está discutiendo la creación de una capa propia para el almacenamiento de datos o la implementación de las funcionalidades faltantes en los sistemas de gestión de bases de datos existentes. También se está debatiendo qué componentes deben ejecutarse a nivel del núcleo y cuáles se pueden implementar sobre el sistema de gestión de bases de datos.
Fuente: opennet.ru
