

En el marco del proyecto Qwenputer, los investigadores han preparado una versión ampliada del modelo de IA Qwen3.5-4B, que incluye un simulador integrado de un CPU de 32 bits basado en la arquitectura RISC-V (RV32IM), que soporta la extensión Zba y está equipado con un coprocesador bignum para operaciones aritméticas con números grandes. La implementación del núcleo CPU se ha compilado en un conjunto de pesos e integrado en un gran modelo de lenguaje en forma de 11 capas adicionales de transformadores, que se han añadido antes de las capas principales de Qwen. Los cálculos se realizan directamente durante el paso directo (forward pass) de la red neuronal, sin conexión a herramientas o plugins externos.
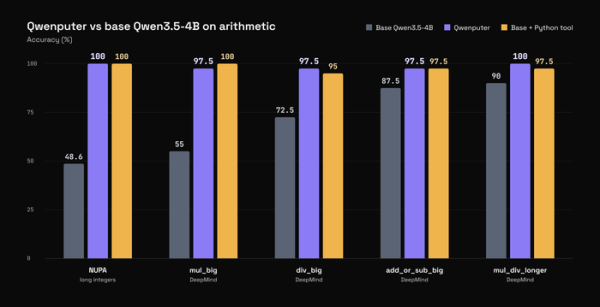
La implementación supera con éxito todos los controles del conjunto oficial de pruebas riscv-tests y es capaz de ejecutar código compilado en C y MicroPython. Al llevar a cabo cálculos aritméticos con números grandes, Qwenputer garantiza una precisión del 97.5-100%, que es comparable o superior a los resultados del modelo base Qwen3.5 con un intérprete externo de Python conectado.
Para simular la memoria RAM en el modelo se han utilizado capas separadas de Gated DeltaNet (RNN lineales), que se aplican en el modelo AI estándar de Qwen para mantener el estado modificado al trabajar con ventanas de contexto amplias. Al fijar el estado de la puerta y aplicar codificación unitaria (one-hot), cada solicitud de escritura sobrescribe exactamente una fila de la matriz de estado, lo que permite usar el estado DeltaNet como memoria direccionable de tamaño fijo, evitando el crecimiento lineal del caché KV (Key-Value) al aumentar la longitud del contexto. En tal memoria se almacenan los registros del CPU, los datos y el código máquina ejecutado.
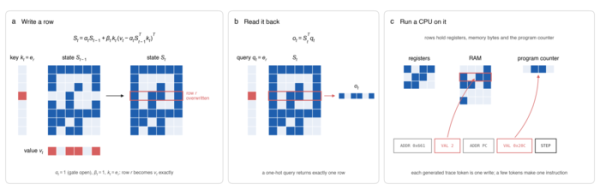
Las instrucciones del procesador, como la lectura de registros, las operaciones aritméticas y las transiciones condicionales, se compilan directamente en los pesos de las capas del transformador. A cada instrucción se le asignan tokens especiales (ADDR, VAL, STEP), que las capas del modelo de IA interpretan como la lógica de funcionamiento del CPU. Para inicializar el CPU y cargar el firmware se utiliza un pequeño controlador externo RvChat, pero el código máquina se procesa completamente dentro de los pesos del modelo.
Entre las limitaciones del proyecto se menciona un aumento de tamaño aproximadamente dos veces mayor en comparación con el modelo original Qwen (18.8 GB) al mantener los puntos de control (checkpoint), lo que ocurre principalmente debido al relleno adicional de capas adicionales. También se observa una velocidad de cálculo relativamente baja (alrededor de 3200 tokens por segundo en GPU L4), lo que puede hacer que cálculos complejos tarden segundos en lugar de milisegundos.
Además, se ha implementado una variante del modelo de IA con un sistema de archivos experimental que permite almacenar hasta 512 archivos con 53,000 tokens de texto dentro de los pesos del modelo de IA. Al igual que en la implementación de la memoria RAM, el almacenamiento se organiza en función de los estados de DeltaNet, pero se diferencia en que el sistema de archivos proporciona almacenamiento permanente, que no pierde estado entre sesiones.
Los avances de Qwenputer también han servido de base para investigar nuevos problemas potenciales de seguridad en IA. A través de Qwenputer se demostró cómo un modelo de IA modificado específicamente puede ocultar sus razonamientos en el estado de RNN y eludir los mecanismos de monitoreo del razonamiento del modelo (CoT, Chain-of-Thought). También se ha demostrado
la posibilidad de crear mecanismos de control y monitoreo de seguridad, integrados en los pesos del modelo de IA, que la propia modelo no puede desactivar o modificar.
Fuente: opennet.ru
