

Los desarrolladores de OrioleDB analizaron el estado actual de la API de bajo nivel utilizada para el acceso de extensiones a tablas e índices en PostgreSQL (API de Método de Acceso a Tabla/Índice), y propusieron formas de mejorarlo. Desde la llegada de esta API en PostgreSQL 12, los desarrolladores han tenido la capacidad de crear mecanismos de almacenamiento de datos alternativos. Sin embargo, a pesar de la existencia de esta API y de las conocidas limitaciones del mecanismo de almacenamiento incorporado, todavía no han surgido motores de almacenamiento transaccionales completamente funcionales que se implementen exclusivamente como extensiones.
Las funciones más demandadas para los motores de tabla alternativos en PostgreSQL son:
- Implementaciones alternativas de MVCC, como almacenes basados en registros UNDO.
- Tablas organizadas por índice, donde el índice no es un complemento opcional de la tabla que acelera las consultas, sino que representa la estructura de datos principal en la que se almacenan los datos de la tabla.
Los cambios necesarios en la API de Table/Index AM para admitir implementaciones alternativas de MVCC se consideran a la luz de la extensión OrioleDB, diseñada para abordar las limitaciones conocidas del mecanismo de almacenamiento integrado en PostgreSQL. El problema es que para la integración completa de OrioleDB con PostgreSQL se requieren modificaciones en el código de PostgreSQL, lo que complica la implementación del proyecto y subraya la necesidad de modernizar la API actual de Table AM.
La API de Table AM no impone directamente la forma de implementación de MVCC. Sin embargo, la API de Table AM y la API de Index AM hacen la siguiente suposición: cada TID (Identificador de Tupla/Fila) o está indexado por todos los índices o no está indexado en absoluto. Incluso si la Index AM tiene múltiples referencias a un mismo TID (por ejemplo, GIN), todas estas referencias deben corresponder al mismo valor indexado.
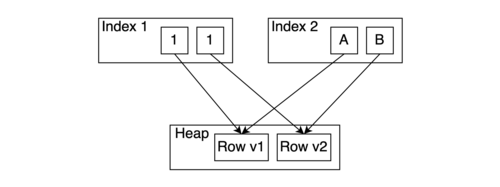
Este principio ha sido criticado por aumentar el número de operaciones de escritura ('write amplification') — si se actualiza un atributo indexado, es necesario actualizar cada índice en la tabla. Para aprovechar completamente las ventajas del registro UNDO o construir un método de almacenamiento que no sufra de 'amplificación de escritura' (por ejemplo, el método WARM), es necesario romper esta suposición.
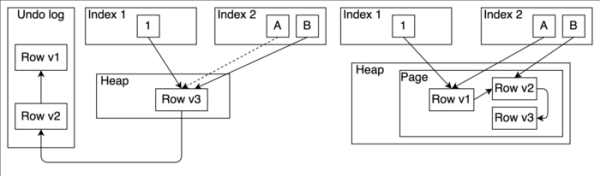
La Tabla AM, basada en UNDO, que no violará esta suposición, se asemeja al método existente HOT (Heap-Only Tuples), excepto que las versiones antiguas de las filas se mantienen en el registro UNDO y no deben caber en la misma página. Sin embargo, según los autores, esta ventaja no es suficiente para justificar la existencia de una Tabla AM separada.
Limitaciones prácticas de la API existente:
- Durante la actualización de una fila de la tabla, los índices se actualizan bajo el principio de "todo o nada".
- La API Index AM actualmente no permite la eliminación puntual de ciertos tuplas. Actualmente, las tuplas se pueden eliminar masivamente de los índices mediante los métodos ambulkdelete y amvacuumcleanup. Intentar implementar la eliminación puntual a través de esta API llevaría a una baja eficiencia, ya que la mayoría de las implementaciones actuales deben escanear todo el índice. Además, la API no permite especificar cuáles de las tuplas que hacen referencia a un mismo TID deben eliminarse. Solo puede eliminar todas ellas.
- Los índices actualmente hacen referencia a las filas de la tabla por número de bloque (32 bits) y número de desplazamiento (16 bits). Y solo 11 bits del número de desplazamiento se pueden transmitir de forma segura del TID de la tabla a todos los métodos de acceso del índice. Al mismo tiempo, las implementaciones alternativas de MVCC pueden necesitar almacenar una carga útil adicional junto con el TID. Por ejemplo, en OrioleDB se requiere uno o varios bits para implementar índices de "marcado de eliminación" o información completa sobre la visibilidad.
Se han propuesto dos enfoques para superar las limitaciones en la práctica:
Enfoque 1: La API Index AM proporciona capacidades para una implementación alternativa de MVCC.
Mientras que la Tabla AM sigue siendo responsable de todos los componentes de MVCC, la Index AM proporciona las capacidades necesarias para una implementación alternativa de MVCC, a saber: almacenar carga útil personalizada junto con el TID, un método de eliminación puntual e incluso un método de actualización puntual (si el TID en el índice no puede ser cambiado, la carga útil personalizada sí puede). Además, dado que es necesario permitir que varias tuplas del índice hagan referencia al mismo TID, los métodos de la API usados al escanear el índice también necesitan ser actualizados.
Enfoque 2: Índices que admiten MVCC.
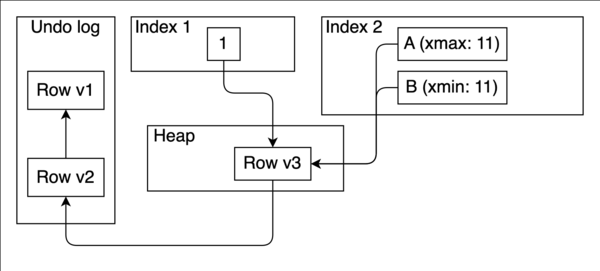
Una alternativa sería permitir índices que soporten MVCC. Es decir, el «executor» (o, posiblemente, Table AM) simplemente invoca los métodos insert() y delete() en Index AM, mientras que Index AM proporciona la capacidad de escanear considerando MVCC. Esto simplificaría significativamente el escaneo utilizando solo índices (index-only). Incluso todo Table AM en tal caso podría convertirse en una capa intermedia que almacena datos en el índice.
En el diagrama de abajo se muestra un ejemplo. El valor del índice 2 se actualiza por la transacción 11 de «A» a «B». Por lo tanto, el valor «A» se marca como xmax == 11, y el valor «B» se marca como xmin == 11. De esta manera, se puede escanear el índice 2 y obtener solo las tuplas visibles de acuerdo con MVCC sin verificaciones del montón (heap). La recolección de basura del índice 2 también puede realizarse sin el uso del montón.
Al implementar todas las innovaciones mencionadas en la API de los métodos de acceso indexados, es poco probable que se logre mejorar todos los índices para soportar todas las nuevas funcionalidades al mismo tiempo. Es más realista permitir varias implementaciones para un solo método de acceso de índice. Por ejemplo, además del B-tree estándar, la extensión podrá implementar un B-tree alternativo que soporte MVCC dentro del índice y soporte identificadores de registro de longitud variable.
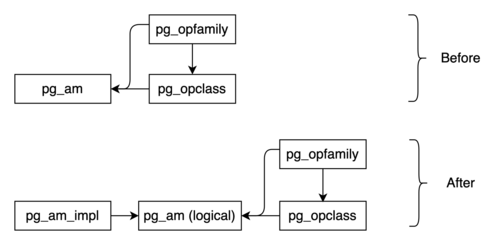
Así, se propone revisar no solo la API de Table AM, sino también la API de Index AM, que ha servido bien a la comunidad de PostgreSQL a lo largo de los años. Además, se sugiere dividir Index AM en una capa lógica y una capa de implementación. Esta arquitectura repensada permitirá a PostgreSQL soportar diferentes modelos de almacenamiento.
Fuente: opennet.ru
