

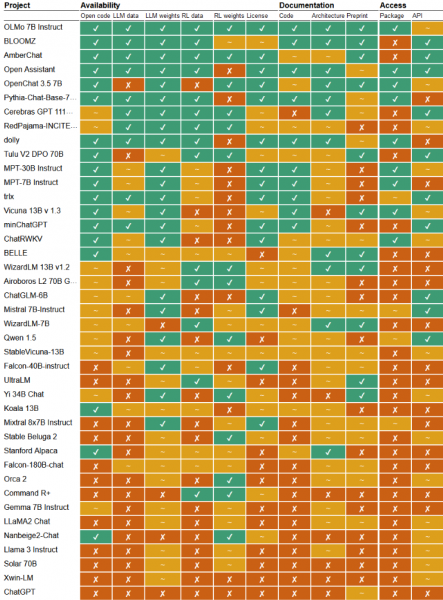
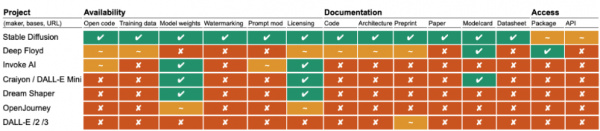
Investigadores de la Universidad de Nijmegen (Países Bajos) han preparado un ranking de apertura de 40 grandes modelos de lenguaje y 7 modelos para la generación de imágenes a partir de descripciones textuales, reivindicados como abiertos por sus fabricantes. Debido a que los criterios de apertura de los modelos de aprendizaje automático todavía se están formando, actualmente existe una situación en la que se difunden modelos bajo la apariencia de ser abiertos, pero que tienen licencias que limitan su uso (por ejemplo, muchos modelos prohíben su utilización en proyectos comerciales). Además, los fabricantes a menudo no proporcionan acceso a los datos utilizados en el entrenamiento, no revelan detalles de la implementación ni abren completamente el código asociado.
La mayoría de los modelos que se posicionan como "abiertos" deben ser considerados más como "coeficientes de peso abiertos" o, más precisamente, "coeficientes de peso disponibles", ya que se distribuyen bajo licencias restrictivas que prohíben su uso en productos comerciales. Los investigadores externos pueden experimentar con tales modelos, pero no tienen la posibilidad de adaptar el modelo a sus necesidades ni de inspeccionar la implementación. Más de la mitad de los modelos no proporcionan detalles sobre los datos utilizados para el entrenamiento, ni publican información sobre su funcionamiento interno y arquitectura.
Los modelos más abiertos son BloomZ, AmberChat, OLMo, Open Assistant y Stable Diffusion, que se han publicado bajo licencias abiertas junto con los datos originales, el código y la implementación de la API. Los modelos de Google (Gemma 7B), Microsoft (Orca 2) y Meta (Llama 3), posicionados por los fabricantes como abiertos, se encuentran más cerca del final del ranking, ya que no proporcionan acceso a los datos originales, no revelan detalles técnicos de la implementación, y distribuyen los coeficientes del modelo bajo licencias que limitan su uso. El popular modelo Mistral 7B se ubicó aproximadamente en el medio del ranking, ya que se ofrece bajo una licencia abierta, pero está solo parcialmente documentado, no revela los datos utilizados para el entrenamiento y tiene un código asociado que no está completamente abierto.
Los investigadores han propuesto 14 criterios de apertura para los modelos de IA, que abarcan las condiciones de distribución de código, datos de entrenamiento, coeficientes, variantes de datos y coeficientes optimizados mediante aprendizaje por refuerzo (RL), así como la disponibilidad de paquetes listos para usar, API, documentación y una descripción detallada de la implementación.
De acuerdo con el borrador de definición de IA abierta propuesto por la organización OSI (Open Source Initiative), los principales criterios de apertura de un sistema de IA son la provisión de oportunidades para su uso con cualquier propósito sin necesidad de obtener un permiso específico; el estudio del funcionamiento del sistema y la inspección de sus componentes; la posibilidad de realizar modificaciones para cualquier fin; y la transferencia a otros de la versión original, así como de la edición tras realizar las modificaciones.
Para permitir la realización de cambios, un sistema de IA debe incluir:
- Información detallada sobre los datos utilizados durante el entrenamiento y la metodología de enseñanza. La información debe ser suficiente para que un desarrollador profesional pueda recrear el sistema de IA equivalente, utilizando los mismos datos o datos similares para el entrenamiento.
- Disponibilidad del código fuente, que permita tanto ejecutar el sistema de IA como realizar el proceso de entrenamiento (en la tabla presentada anteriormente, en la columna 'código' se indica ' ~ ', lo que implica la disponibilidad parcial del código, donde el código para ejecutar el modelo está disponible, pero falta el código para el entrenamiento o la creación del modelo). El código también debe incluir áreas como preprocesamiento, verificación de datos y tokenización. Además, debe proporcionarse una descripción detallada de la arquitectura del modelo.
- Parámetros del modelo (coeficientes de peso) que implican la disponibilidad de un corte de estado listo para usar tras el entrenamiento o la existencia de una versión final optimizada del modelo.
Fuente: opennet.ru
