

El artículo examina varias formas de determinar la ecuación matemática de una línea de regresión simple (bivariada).
Todas las formas de resolver la ecuación aquí tratadas se basan en el método de mínimos cuadrados. Denotaremos las formas de la siguiente manera:
- Solución analítica
- Descenso por gradiente
- Descenso estocástico por gradiente
Para cada uno de los métodos de resolución de la ecuación de la línea, el artículo presenta diversas funciones, que se dividen principalmente en aquellas que están escritas sin utilizar una biblioteca NumPy y las que utilizan NumPy. Se considera que un uso hábil de NumPy permitirá reducir los costos de cálculo.
Todo el código proporcionado en el artículo está escrito en el lenguaje python 2.7 utilizando Jupyter Notebook. El código fuente y el archivo con los datos de la muestra están disponibles en
El artículo está orientado principalmente tanto a principiantes como a aquellos que ya han comenzado a explorar una parte bastante extensa del campo de la inteligencia artificial: el aprendizaje automático.
Para ilustrar el material, utilizaremos un ejemplo muy simple.
Condiciones del ejemplo
Tenemos cinco valores que caracterizan la dependencia Y desde X (Tabla nº 1):
Tabla nº 1 "Condiciones del ejemplo"
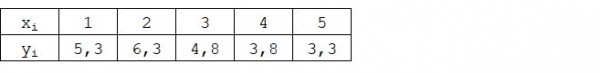
Supongamos que los valores  son el mes del año, y que
 es el ingreso de ese mes. En otras palabras, el ingreso depende del mes del año, y
 es la única variable que afecta al ingreso.
El ejemplo no es muy bueno, tanto desde el punto de vista de la dependencia condicional del ingreso respecto al mes del año, como desde la cantidad de valores: son muy pocos. Sin embargo, tal simplificación permitirá, como se dice, explicar, aunque no siempre con facilidad, un material que los principiantes pueden tener dificultades en asimilar. Además, la simplicidad de los números permitirá, sin una gran carga de trabajo, a aquellos interesados resolver el ejemplo en "papel".
Supongamos que la dependencia presentada en el ejemplo puede ser bastante bien aproximada por una ecuación matemática de una línea de regresión simple (bivariada) del tipo:

donde  es el mes en el que se obtuvo el ingreso,
 es el ingreso correspondiente al mes,
 y
 son los coeficientes de la línea de regresión estimada.
Cabe destacar que el coeficiente  a menudo se denomina coeficiente angular o gradiente de la línea estimada; representa la cantidad por la cual cambiará
 al cambiar
 .
Es evidente que nuestra tarea en el ejemplo es ajustar en la ecuación tales coeficientes.  y
 , donde las desviaciones de nuestros valores calculados de ingresos mensuales respecto a las respuestas reales, es decir, los valores presentados en la muestra, serán mínimas.
Método de mínimos cuadrados
De acuerdo con el método de mínimos cuadrados, se debe calcular la desviación elevándola al cuadrado. Este enfoque permite evitar la cancelación mutua de desviaciones, en caso de que tengan signos opuestos. Por ejemplo, si en un caso, la desviación es +5 (más cinco), y en otro -5 (menos cinco), entonces la suma de las desviaciones se cancelará y será 0 (cero). También se puede no elevar la desviación al cuadrado, sino aprovechar la propiedad del valor absoluto, y así todas nuestras desviaciones serán positivas y se acumularán. No nos detendremos en este aspecto por ahora, solo señalaremos que, para mayor comodidad en los cálculos, es común elevar la desviación al cuadrado.
Así es como se ve la fórmula que usaremos para determinar la suma mínima de los cuadrados de las desviaciones (errores):

donde  — es la función de aproximación de las respuestas reales (es decir, nuestros ingresos calculados),
 — son las respuestas reales (los ingresos proporcionados en la muestra),
 — es el índice de la muestra (número del mes en el que se determina la desviación)
Diferenciaremos la función, definiremos las ecuaciones de las derivadas parciales y estaremos listos para pasar a la solución analítica. Pero primero, hagamos un pequeño excursus sobre qué es la diferenciación y recordemos el significado geométrico de la derivada.
Diferenciación
La diferenciación es la operación de encontrar la derivada de una función.
¿Para qué sirve la derivada? La derivada de una función caracteriza la velocidad de cambio de la función y nos indica su dirección. Si la derivada en un punto dado es positiva, la función está aumentando; en caso contrario, la función está disminuyendo. Cuanto mayor sea el valor absoluto de la derivada, mayor será la velocidad de cambio de los valores de la función, así como mayor será la inclinación de la gráfica de la función.
Por ejemplo, en el contexto del sistema de coordenadas cartesiano, el valor de la derivada en el punto M(0,0) igual a +25 significa que en el punto dado, al desplazar el valor  hacia la derecha una unidad, el valor
 aumenta en 25 unidades arbitrarias. En la gráfica, esto se ve como un ángulo de inclinación bastante pronunciado de los valores
 desde el punto dado.
Otro ejemplo. El valor de la derivada igual a -0,1 significa que al movernos  una unidad, el valor
 disminuye solo 0,1 unidades. En este caso, en el gráfico de la función, podemos observar una leve inclinación hacia abajo. Haciendo una analogía con una montaña, es como si estuviéramos bajando lentamente por una ladera suave, a diferencia del ejemplo anterior, donde teníamos que escalar picos muy empinados :)
Por lo tanto, al realizar la diferenciación de la función  según los coeficientes
 y
 , determinaremos las ecuaciones de las derivadas parciales de primer orden. Tras establecer las ecuaciones, obtendremos un sistema de dos ecuaciones, resolviendo el cual podremos determinar los valores de los coeficientes
 y
 , para los cuales los valores de las derivadas correspondientes en los puntos dados cambian en cantidades muy pequeñas, y en el caso de una solución analítica no cambian en absoluto. En otras palabras, la función de error con los coeficientes encontrados alcanzará un mínimo, ya que los valores de las derivadas parciales en esos puntos serán cero.
Así que, según las reglas de diferenciación, la ecuación de la derivada parcial de primer orden respecto al coeficiente  tomará la siguiente forma:

la ecuación de la derivada parcial de primer orden respecto a  tomará la siguiente forma:

Como resultado, hemos obtenido un sistema de ecuaciones que tiene una solución analítica bastante simple:
begin{equation*}
begin{cases}
na + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i) = 0
end{cases}
end{equation*}
Antes de resolver la ecuación, primero carguemos, verifiquemos la correcta carga y formateemos los datos.
Carga y formateo de datos
Cabe señalar que, debido a que para la solución analítica, y posteriormente para el descenso por gradiente y el descenso estocástico por gradiente, utilizaremos el código en dos variaciones: con el uso de la biblioteca NumPy y sin su uso, necesitaremos el formateo correspondiente de los datos (ver código).
Código para carga y procesamiento de datos
# импортируем все нужные нам библиотеки
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import math
import pylab as pl
import random

# графики отобразим в Jupyter
%matplotlib inline

# укажем размер графиков
from pylab import rcParams
rcParams['figure.figsize'] = 12, 6

# отключим предупреждения Anaconda
import warnings
warnings.simplefilter('ignore')

# загрузим значения
table_zero = pd.read_csv('data_example.txt', header=0, sep='t')

# посмотрим информацию о таблице и на саму таблицу
print table_zero.info()
print '********************************************'
print table_zero
print '********************************************'

# подготовим данные без использования NumPy

x_us = []
[x_us.append(float(i)) for i in table_zero['x']]
print x_us
print type(x_us)
print '********************************************'

y_us = []
[y_us.append(float(i)) for i in table_zero['y']]
print y_us
print type(y_us)
print '********************************************'

# подготовим данные с использованием NumPy

x_np = table_zero[['x']].values
print x_np
print type(x_np)
print x_np.shape
print '********************************************'

y_np = table_zero[['y']].values
print y_np
print type(y_np)
print y_np.shape
print '********************************************'
Visualización
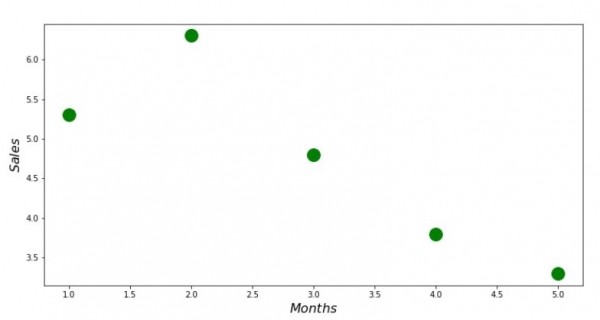
Ahora, después de haber, en primer lugar, cargado los datos, en segundo lugar, verificado la correcta carga y finalmente formateado los datos, realizaremos la primera visualización. A menudo se utiliza el método pairplot de la biblioteca Seaborn. En nuestro ejemplo, debido a la limitación de los números, no tiene sentido aplicar la biblioteca Seaborn. Utilizaremos la biblioteca normal Matplotlib y solo observaremos el diagrama de dispersión.
Código del diagrama de dispersión
print 'Gráfico №1 "Dependencia de los ingresos del mes del año"'

plt.plot(x_us,y_us,'o',color='green',markersize=16)
plt.xlabel('$Meses$', size=16)
plt.ylabel('$Ventas$', size=16)
plt.show()
Gráfico №1 «Dependencia de los ingresos del mes del año»
Solución analítica
Utilizaremos las herramientas más comunes en python y resolveremos el sistema de ecuaciones:
begin{equation*}
begin{cases}
na + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i) = 0
end{cases}
end{equation*}
Por la regla de Cramer encontraremos el determinante general, así como los determinantes de  y de
 , después de lo cual, dividiendo el determinante de
 por el determinante general, obtendremos el coeficiente
 , y de manera análoga encontraremos el coeficiente
 .
Código de la solución analítica
# определим функцию для расчета коэффициентов a и b по правилу Крамера
def Kramer_method (x,y):
        # сумма значений (все месяца)
    sx = sum(x)
        # сумма истинных ответов (выручка за весь период)
    sy = sum(y)
        # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x[i]*y[i]) for i in range(len(x))]
    sxy = sum(list_xy)
        # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x[i]**2) for i in range(len(x))]
    sx_sq = sum(list_x_sq)
        # количество значений
    n = len(x)
        # общий определитель
    det = sx_sq*n - sx*sx
        # определитель по a
    det_a = sx_sq*sy - sx*sxy
        # искомый параметр a
    a = (det_a / det)
        # определитель по b
    det_b = sxy*n - sy*sx
        # искомый параметр b
    b = (det_b / det)
        # контрольные значения (прооверка)
    check1 = (n*b + a*sx - sy)
    check2 = (b*sx + a*sx_sq - sxy)
    return [round(a,4), round(b,4)]

# запустим функцию и запишем правильные ответы
ab_us = Kramer_method(x_us,y_us)
a_us = ab_us[0]
b_us = ab_us[1]
print ' 33[1m' + ' 33[4m' + "Оптимальные значения коэффициентов a и b:"  + ' 33[0m'
print 'a =', a_us
print 'b =', b_us
print

# определим функцию для подсчета суммы квадратов ошибок
def errors_sq_Kramer_method(answers,x,y):
    list_errors_sq = []
    for i in range(len(x)):
        err = (answers[0] + answers[1]*x[i] - y[i])**2
        list_errors_sq.append(err)
    return sum(list_errors_sq)

# запустим функцию и запишем значение ошибки
error_sq = errors_sq_Kramer_method(ab_us,x_us,y_us)
print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений" + ' 33[0m'
print error_sq
print

# замерим время расчета
# print ' 33[1m' + ' 33[4m' + "Время выполнения расчета суммы квадратов отклонений:" + ' 33[0m'
# % timeit error_sq = errors_sq_Kramer_method(ab,x_us,y_us)
Esto es lo que hemos obtenido:
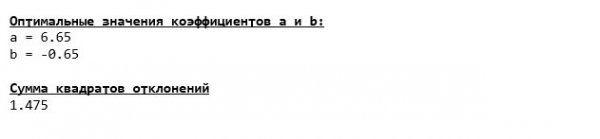
Así, se han encontrado los valores de los coeficientes, y se ha establecido la suma de los cuadrados de las desviaciones. Dibujaremos una línea en el histograma de dispersión de acuerdo con los coeficientes encontrados.
Código de la línea de regresión
# определим функцию для формирования массива рассчетных значений выручки
def sales_count(ab,x,y):
    line_answers = []
    [line_answers.append(ab[0]+ab[1]*x[i]) for i in range(len(x))]
    return line_answers

# построим графики
print 'Грфик№2 "Правильные и расчетные ответы"'
plt.plot(x_us,y_us,'o',color='green',markersize=16, label = '$True$ $answers$')
plt.plot(x_us, sales_count(ab_us,x_us,y_us), color='red',lw=4,
         label='$Function: a + bx,$ $where$ $a='+str(round(ab_us[0],2))+',$ $b='+str(round(ab_us[1],2))+'$')
plt.xlabel('$Months$', size=16)
plt.ylabel('$Sales$', size=16)
plt.legend(loc=1, prop={'size': 16})
plt.show()
Gráfico №2 «Respuestas correctas y calculadas»
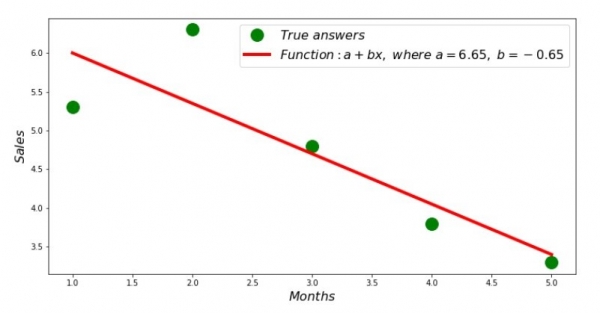
Podemos observar el gráfico de desviaciones para cada mes. En nuestro caso, no obtendremos ningún valor práctico significativo, pero satisfaremos la curiosidad sobre cuán bien el modelo de regresión lineal simple caracteriza la dependencia de los ingresos del mes del año.
Código del gráfico de desviaciones
# определим функцию для формирования массива отклонений в процентах
def error_per_month(ab,x,y):
    sales_c = sales_count(ab,x,y)
    errors_percent = []
    for i in range(len(x)):
        errors_percent.append(100*(sales_c[i]-y[i])/y[i])
    return errors_percent

# построим график
print 'График№3 "Отклонения по-месячно, %"'
plt.gca().bar(x_us, error_per_month(ab_us,x_us,y_us), color='brown')
plt.xlabel('Months', size=16)
plt.ylabel('Calculation error, %', size=16)
plt.show()
Gráfico №3 «Desviaciones, %»
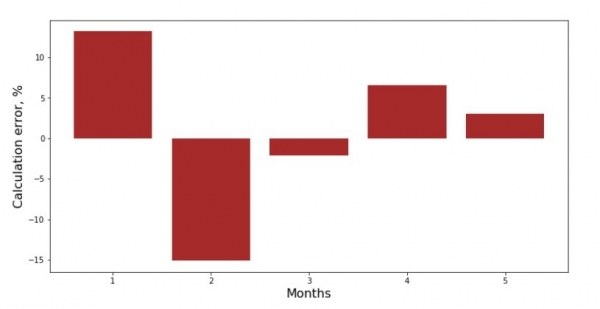
No es perfecto, pero hemos cumplido nuestra tarea.
Escribiremos una función que para determinar los coeficientes  y
 utiliza la biblioteca NumPy, es decir, escribiremos dos funciones: una utilizando la pseudo-inversa (no recomendada en la práctica, ya que el proceso es computacionalmente complejo e inestable), y la otra utilizando la ecuación matricial.
Código de la solución analítica (NumPy)
# для начала добавим столбец с не изменяющимся значением в 1.
# Данный столбец нужен для того, чтобы не обрабатывать отдельно коэффицент a
vector_1 = np.ones((x_np.shape[0],1))
x_np = table_zero[['x']].values # на всякий случай приведем в первичный формат вектор x_np
x_np = np.hstack((vector_1,x_np))

# проверим то, что все сделали правильно
print vector_1[0:3]
print x_np[0:3]
print '***************************************'
print

# напишем функцию, которая определяет значения коэффициентов a и b с использованием псевдообратной матрицы
def pseudoinverse_matrix(X, y):
    # задаем явный формат матрицы признаков
    X = np.matrix(X)
    # определяем транспонированную матрицу
    XT = X.T
    # определяем квадратную матрицу
    XTX = XT*X
    # определяем псевдообратную матрицу
    inv = np.linalg.pinv(XTX)
    # задаем явный формат матрицы ответов
    y = np.matrix(y)
    # находим вектор весов
    return (inv*XT)*y

# запустим функцию
ab_np = pseudoinverse_matrix(x_np, y_np)
print ab_np
print '***************************************'
print

# напишем функцию, которая использует для решения матричное уравнение
def matrix_equation(X,y):
    a = np.dot(X.T, X)
    b = np.dot(X.T, y)
    return np.linalg.solve(a, b)

# запустим функцию
ab_np = matrix_equation(x_np,y_np)
print ab_np
Compararemos el tiempo que se ha utilizado para determinar los coeficientes  y
 , de acuerdo con los 3 métodos presentados.
Código para calcular el tiempo de cálculos
print ' 33[1m' + ' 33[4m' + "Tiempo de ejecución del cálculo de coeficientes sin usar la biblioteca NumPy:" + ' 33[0m'
% timeit ab_us = Kramer_method(x_us,y_us)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "Tiempo de ejecución del cálculo de coeficientes utilizando la pseudo-inversa:" + ' 33[0m'
%timeit ab_np = pseudoinverse_matrix(x_np, y_np)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "Tiempo de ejecución del cálculo de coeficientes utilizando la ecuación matricial:" + ' 33[0m'
%timeit ab_np = matrix_equation(x_np, y_np)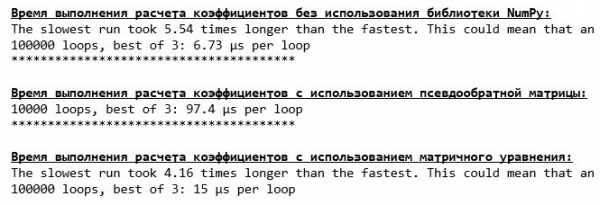
Con un conjunto pequeño de datos, la función «hecha a mano» que encuentra los coeficientes mediante el método de Cramer se destaca.
Ahora podemos pasar a otros métodos para encontrar los coeficientes.  y
 .
Descenso por gradiente
Primero, definamos qué es un gradiente. En términos simples, el gradiente es un segmento que indica la dirección del aumento máximo de una función. Por analogía con escalar una montaña, hacia donde apunta el gradiente es donde se encuentra la subida más pronunciada hacia la cima de la montaña. Desarrollando el ejemplo de la montaña, recordamos que en realidad necesitamos el descenso más pronunciado para alcanzar lo más rápido posible el valle, es decir, el mínimo: el lugar donde la función no aumenta ni disminuye. En este punto, la derivada será cero. Por lo tanto, no necesitamos el gradiente, sino el antigradiente. Para encontrar el antigradiente, solo hay que multiplicar el gradiente por -1 (-1).
Cabe señalar que una función puede tener múltiples mínimos, y si caemos en uno de ellos siguiendo el algoritmo que se presentará a continuación, no podremos encontrar otro mínimo que pueda estar por debajo del que ya encontramos. ¡Relajémonos, no tenemos de qué preocuparnos! En nuestro caso, estamos tratando con un único mínimo, ya que nuestra función  en el gráfico representa una parábola común. Y como todos debemos saber por el curso escolar de matemáticas, la parábola tiene solo un mínimo.
Después de haber determinado para qué necesitábamos el gradiente, así como que el gradiente es un segmento, es decir, un vector con coordenadas dadas, que son precisamente los coeficientes  y
 podemos implementar el descenso por gradiente.
Antes de comenzar, propongo leer literalmente algunas frases sobre el algoritmo de descenso:
- Definimos las coordenadas de los coeficientes de manera pseudoaleatoria.
 y En nuestro ejemplo, definiremos los coeficientes cerca de cero. Esta es una práctica común, aunque cada caso puede tener su propia práctica prevista.
- A la coordenada le restamos el valor de la derivada parcial de primer orden en el punto . Así, si la derivada es positiva, la función está aumentando. Por lo tanto, al restar el valor de la derivada, nos moveremos en la dirección opuesta al crecimiento, es decir, hacia abajo. Si la derivada es negativa, significa que la función está disminuyendo en este punto, y al restar el valor de la derivada nos movemos hacia abajo.
- Realizamos una operación similar con las coordenadas. : restamos el valor de la derivada parcial en un punto .
- Para no saltar el mínimo y no volar al lejano espacio, es necesario establecer el tamaño del paso hacia la bajada. En general, se podría escribir un artículo completo sobre cómo establecer correctamente el paso y cómo cambiarlo durante el descenso para reducir los costos de cálculo. Pero ahora tenemos una tarea algo diferente, y mediante el método científico de 'prueba y error' o, como se dice popularmente, de forma empírica, estableceremos el tamaño del paso.
- Después de haber restado los valores de las derivadas y , obtenemos nuevas coordenadas y . Damos el siguiente paso (resta), ya desde las coordenadas calculadas. Y así el ciclo comienza una y otra vez, hasta que se alcance la convergencia requerida.
 y
 En nuestro ejemplo, definiremos los coeficientes cerca de cero. Esta es una práctica común, aunque cada caso puede tener su propia práctica prevista.
 le restamos el valor de la derivada parcial de primer orden en el punto
 . Así, si la derivada es positiva, la función está aumentando. Por lo tanto, al restar el valor de la derivada, nos moveremos en la dirección opuesta al crecimiento, es decir, hacia abajo. Si la derivada es negativa, significa que la función está disminuyendo en este punto, y al restar el valor de la derivada nos movemos hacia abajo.
 : restamos el valor de la derivada parcial en un punto
 .
 y
 , obtenemos nuevas coordenadas
 y
 . Damos el siguiente paso (resta), ya desde las coordenadas calculadas. Y así el ciclo comienza una y otra vez, hasta que se alcance la convergencia requerida.
¡Todo! Ahora estamos listos para ir en busca del cañón más profundo de la Fosa de las Marianas. Comencemos.
Código para el descenso por gradiente
# напишем функцию градиентного спуска без использования библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = sum(x_us)
    # сумма истинных ответов (выручка за весь период)
    sy = sum(y_us)
    # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x_us[i]*y_us[i]) for i in range(len(x_us))]
    sxy = sum(list_xy)
    # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x_us[i]**2) for i in range(len(x_us))]
    sx_sq = sum(list_x_sq)
    # количество значений
    num = len(x_us)
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = [a,b]
        errors.append(errors_sq_Kramer_method(ab,x_us,y_us))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)


print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print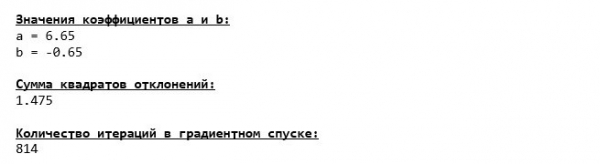
Nos hemos sumergido en el fondo de la Fosa de las Marianas y allí hemos encontrado los mismos valores de coeficientes  y
 , que era de esperar.
Haremos otra inmersión, pero esta vez, el interior de nuestro aparato submarino utilizará otras tecnologías, a saber, la biblioteca NumPy.
Código para el descenso por gradiente (NumPy)
# перед тем определить функцию для градиентного спуска с использованием библиотеки NumPy,
# напишем функцию определения суммы квадратов отклонений также с использованием NumPy
def error_square_numpy(ab,x_np,y_np):
    y_pred = np.dot(x_np,ab)
    error = y_pred - y_np
    return sum((error)**2)

# напишем функцию градиентного спуска с использованием библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = float(sum(x_np[:,1]))
    # сумма истинных ответов (выручка за весь период)
    sy = float(sum(y_np))
    # сумма произведения значений на истинные ответы
    sxy = x_np*y_np
    sxy = float(sum(sxy[:,1]))
    # сумма квадратов значений
    sx_sq = float(sum(x_np[:,1]**2))
    # количество значений
    num = float(x_np.shape[0])
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = np.array([[a],[b]])
        errors.append(error_square_numpy(ab,x_np,y_np))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print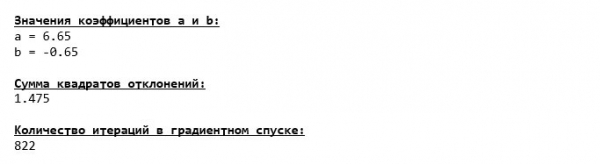
Los valores de los coeficientes  y
 son invariables.
Veamos cómo cambió el error durante el descenso por gradiente, es decir, cómo cambió la suma de los cuadrados de las desviaciones en cada paso.
Código para el gráfico de la suma de cuadrados de desviaciones
print 'Gráfico №4 "Suma de cuadrados de desviaciones por paso"'
plt.plot(range(len(list_parametres_gradient_descence[1])), list_parametres_gradient_descence[1], color='red', lw=3)
plt.xlabel('Pasos (Iteración)', size=16)
plt.ylabel('Suma de cuadrados de desviaciones', size=16)
plt.show()
Gráfico Nº4 «Suma de cuadrados de desviaciones durante el descenso por gradiente»
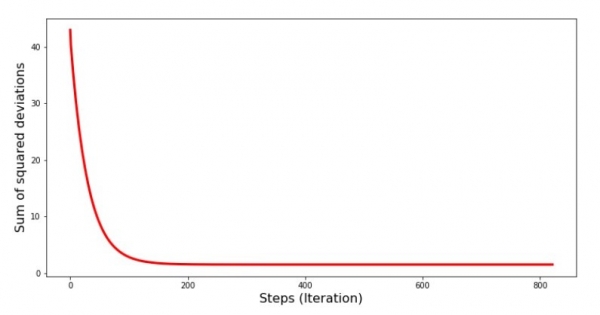
En el gráfico vemos que, con cada paso, el error disminuye, y después de un cierto número de iteraciones, observamos una línea prácticamente horizontal.
Finalmente, evaluemos la diferencia en el tiempo de ejecución del código:
Código para determinar el tiempo de cálculo del descenso por gradiente
print ' 33[1m' + ' 33[4m' + "Tiempo de ejecución del descenso de gradiente sin usar la biblioteca NumPy:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' + "Tiempo de ejecución del descenso de gradiente usando la biblioteca NumPy:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)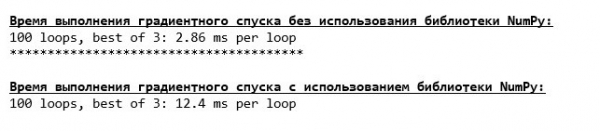
Puede que estemos haciendo algo incorrecto, pero otra vez la simple función «hecha a mano» que no utiliza una biblioteca NumPy supera en tiempo de ejecución a la función que usa la biblioteca NumPy.
Pero no nos detenemos, sino que avanzamos hacia el estudio de otra fascinante forma de resolver la ecuación de regresión lineal simple. ¡Conózcanla!
Descenso estocástico por gradiente
Para entender más rápidamente el principio de funcionamiento del descenso de gradiente estocástico, es mejor definir sus diferencias con el descenso de gradiente ordinario. En el caso del descenso de gradiente, en las ecuaciones de derivadas de  y
 utilizamos las sumas de los valores de todas las características y las respuestas reales presentes en la muestra (es decir, la suma de todos
 y
 ). En el descenso de gradiente estocástico no usaremos todos los valores presentes en la muestra, sino que en su lugar, elegiremos aleatoriamente un índice de muestra y utilizaremos sus valores.
Por ejemplo, si el índice resulta ser el número 3 (tres), tomamos los valores  y
 , luego sustituimos los valores en las ecuaciones de derivadas y determinamos nuevas coordenadas. A continuación, al determinar las coordenadas, nuevamente seleccionamos aleatoriamente un índice de muestra, sustituyendo los valores correspondientes al índice en las ecuaciones de derivadas parciales, y redefinimos las coordenadas
 y
 y así sucesivamente hasta que converja. A primera vista, puede parecer que esto no puede funcionar, pero lo hace. Aunque es cierto que no siempre se reduce el error en cada paso, la tendencia es innegable.
¿Cuáles son las ventajas del descenso de gradiente estocástico sobre el ordinario? En caso de que tengamos un tamaño de muestra muy grande y se mida en decenas de miles de valores, es mucho más fácil procesar, digamos, una millar aleatoria de ellos que toda la muestra. Es en este caso donde se inicia el descenso de gradiente estocástico. En nuestro caso, por supuesto, no notaremos una gran diferencia.
Veamos el código.
Código para el descenso de gradiente estocástico
# определим функцию стох.град.шага
def stoch_grad_step_usual(vector_init, x_us, ind, y_us, l):
#     выбираем значение икс, которое соответствует случайному значению параметра ind
# (см.ф-цию stoch_grad_descent_usual)
    x = x_us[ind]
#     рассчитывыаем значение y (выручку), которая соответствует выбранному значению x
    y_pred = vector_init[0] + vector_init[1]*x_us[ind]
#     вычисляем ошибку расчетной выручки относительно представленной в выборке
    error = y_pred - y_us[ind]
#     определяем первую координату градиента ab
    grad_a = error
#     определяем вторую координату ab
    grad_b = x_us[ind]*error
#     вычисляем новый вектор коэффициентов
    vector_new = [vector_init[0]-l*grad_a, vector_init[1]-l*grad_b]
    return vector_new


# определим функцию стох.град.спуска
def stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800):
#     для самого начала работы функции зададим начальные значения коэффициентов
    vector_init = [float(random.uniform(-0.5, 0.5)), float(random.uniform(-0.5, 0.5))]
    errors = []
#     запустим цикл спуска
# цикл расчитан на определенное количество шагов (steps)
    for i in range(steps):
        ind = random.choice(range(len(x_us)))
        new_vector = stoch_grad_step_usual(vector_init, x_us, ind, y_us, l)
        vector_init = new_vector
        errors.append(errors_sq_Kramer_method(vector_init,x_us,y_us))
    return (vector_init),(errors)


# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])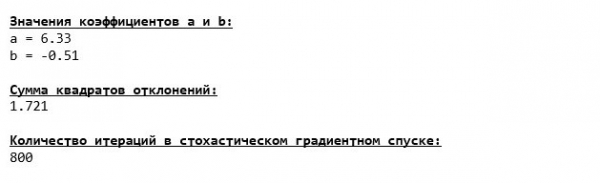
Observemos cuidadosamente los coeficientes y preguntémonos: «¿Cómo puede ser esto?». Hemos obtenido otros valores de los coeficientes  y
 . ¿Puede que el descenso de gradiente estocástico haya encontrado parámetros más óptimos para la ecuación? Lamentablemente, no. Basta con mirar la suma de los cuadrados de las desviaciones y ver que con los nuevos valores de los coeficientes, el error es mayor. No nos desesperemos. Construyamos un gráfico que muestre la variación del error.
Código para el gráfico de la suma de cuadrados de las desviaciones en el descenso de gradiente estocástico
print 'Gráfico №5 "Suma de cuadrados de las desviaciones paso a paso"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Pasos (Iteración)', size=16)
plt.ylabel('Suma de cuadrados de las desviaciones', size=16)
plt.show()
Gráfico №5 «Suma de cuadrados de las desviaciones en el descenso de gradiente estocástico»
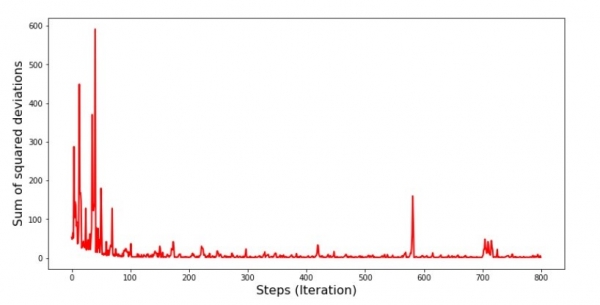
Al observar el gráfico, todo se aclara y ahora lo corregiremos.
Entonces, ¿qué ha ocurrido? Lo siguiente. Cuando seleccionamos un mes al azar, nuestro algoritmo busca reducir el error en el cálculo de los ingresos para ese mes elegido. Luego elegimos otro mes y repetimos el cálculo, pero ahora reducimos el error para el segundo mes seleccionado. Y ahora recordemos que nuestros dos primeros meses se desvían significativamente de la línea de la ecuación de la regresión lineal simple. Esto significa que al seleccionar cualquiera de estos dos meses, al reducir el error de cada uno, nuestro algoritmo aumenta significativamente el error en toda la muestra. Entonces, ¿qué hacer? La respuesta es sencilla: debemos reducir el paso del descenso. Al reducir el paso, el error también dejará de «saltar» hacia arriba y hacia abajo. Más bien, el error «saltar» no dejará de hacerlo, pero no lo hará con tanta agilidad :) Verifiquemos.
Código para iniciar el SGD con un paso más pequeño
# запустим функцию, уменьшив шаг в 100 раз и увеличив количество шагов соответсвующе
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])

print 'График №6 "Сумма квадратов отклонений по-шагово"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Steps (Iteration)', size=16)
plt.ylabel('Sum of squared deviations', size=16)
plt.show()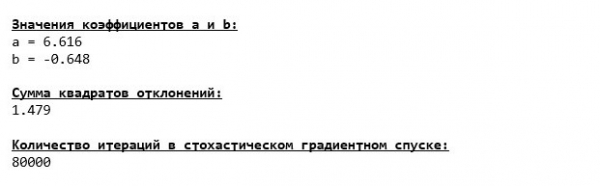
Gráfico №6 «Suma de cuadrados de las desviaciones en el descenso de gradiente estocástico (80 mil pasos)»
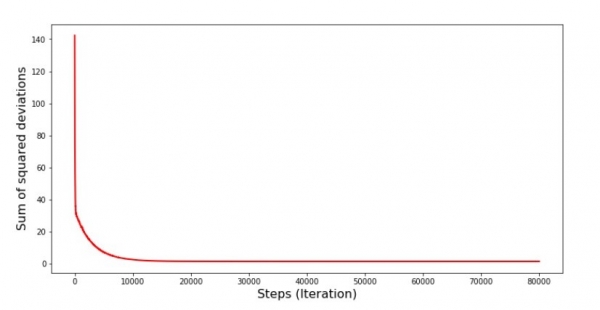
Los valores de los coeficientes han mejorado, pero aún no son ideales. Hipotéticamente, se podría corregir de esta manera. Seleccionamos, por ejemplo, en las últimas 1000 iteraciones, los valores de los coeficientes con los que se cometió el error mínimo. Sin embargo, para eso tendríamos que registrar también los valores mismos de los coeficientes. No lo haremos, y mejor prestaremos atención al gráfico. Se ve suave, y el error parece disminuir de manera uniforme. En realidad, no es así. Observaremos las primeras 1000 iteraciones y las compararemos con las últimas.
Código para el gráfico SGD (primeros 1000 pasos)
print 'Gráfico №7 "Suma de cuadrados de desviaciones paso a paso. Primeras 1000 iteraciones"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][:1000])),
         list_parametres_stoch_gradient_descence[1][:1000], color='red', lw=2)
plt.xlabel('Pasos (Iteración)', size=16)
plt.ylabel('Suma de cuadrados de desviaciones', size=16)
plt.show()

print 'Gráfico №7 "Suma de cuadrados de desviaciones paso a paso. Últimas 1000 iteraciones"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][-1000:])),
         list_parametres_stoch_gradient_descence[1][-1000:], color='red', lw=2)
plt.xlabel('Pasos (Iteración)', size=16)
plt.ylabel('Suma de cuadrados de desviaciones', size=16)
plt.show()
Gráfico №7 «Suma de cuadrados de desviaciones SGD (primeros 1000 pasos)»
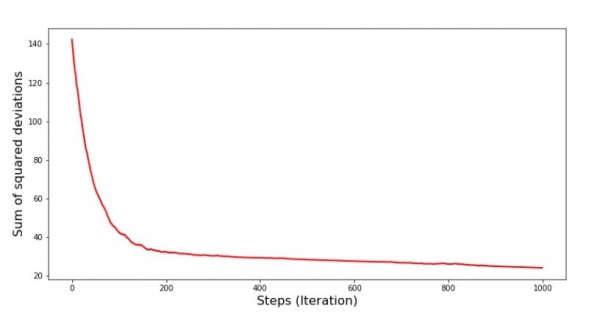
Gráfico №8 «Suma de cuadrados de desviaciones SGD (últimos 1000 pasos) »
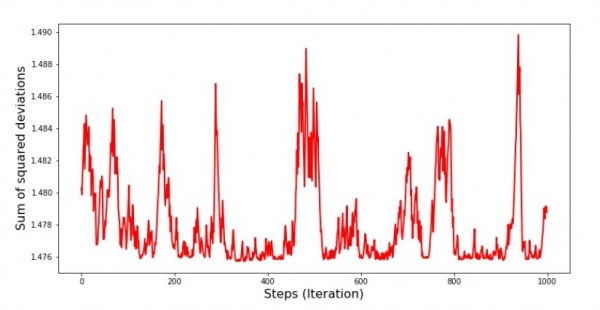
Al principio del descenso, observamos una disminución bastante uniforme y pronunciada del error. En las últimas iteraciones vemos que el error ronda un valor de 1.475 y en algunos momentos incluso alcanza este valor óptimo, pero luego vuelve a aumentar... Repito, se pueden registrar los valores de los coeficientes  y
 , y luego elegir aquellos para los cuales el error es mínimo. Sin embargo, nos enfrentamos a un problema más serio: tuvimos que hacer 80,000 pasos (ver código) para obtener valores cercanos a los óptimos. Esto contradice la idea de ahorro de tiempo de cálculo en el descenso de gradiente estocástico en relación con el de gradiente. ¿Qué se puede corregir y mejorar? No es difícil notar que en las primeras iteraciones vamos hacia abajo con confianza y, por lo tanto, deberíamos mantener un paso grande en las primeras iteraciones y reducir el paso a medida que avanzamos. No haremos esto en este artículo, ya que se ha prolongado lo suficiente. Los interesados pueden pensar en cómo hacerlo, no es complicado 🙂
Ahora realizaremos el descenso de gradiente estocástico utilizando la biblioteca NumPy (y no tropezaremos con las piedras que identificamos anteriormente)
Código para descenso de gradiente estocástico (NumPy)
# для начала напишем функцию градиентного шага
def stoch_grad_step_numpy(vector_init, X, ind, y, l):
    x = X[ind]
    y_pred = np.dot(x,vector_init)
    err = y_pred - y[ind]
    grad_a = err
    grad_b = x[1]*err
    return vector_init - l*np.array([grad_a, grad_b])

# определим функцию стохастического градиентного спуска
def stoch_grad_descent_numpy(X, y, l=0.1, steps = 800):
    vector_init = np.array([[np.random.randint(X.shape[0])], [np.random.randint(X.shape[0])]])
    errors = []
    for i in range(steps):
        ind = np.random.randint(X.shape[0])
        new_vector = stoch_grad_step_numpy(vector_init, X, ind, y, l)
        vector_init = new_vector
        errors.append(error_square_numpy(vector_init,X,y))
    return (vector_init), (errors)

# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])
print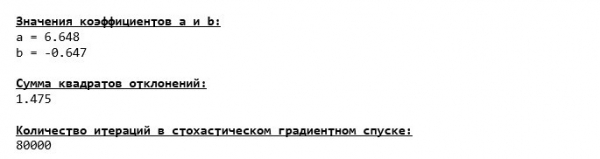
Los valores eran casi los mismos que al descender sin utilizar NumPy. Sin embargo, esto es lógico.
Veamos cuánto tiempo nos han llevado los descensos de gradiente estocástico.
Código para determinar el tiempo de cálculo del SGD (80 mil pasos)
print ' 33[1m' + ' 33[4m' +
"Tiempo de ejecución del descenso de gradiente estocástico sin utilizar la biblioteca NumPy:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' +
"Tiempo de ejecución del descenso de gradiente estocástico utilizando la biblioteca NumPy:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)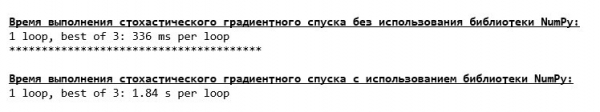
Cuanto más profundo en el bosque, más oscuras se vuelven las nubes: otra vez la fórmula 'hecha en casa' muestra el mejor resultado. Todo esto sugiere que deben existir formas aún más sutiles de utilizar la biblioteca NumPy, que realmente aceleran las operaciones de cálculo. En este artículo no nos enteraremos de ellas. Será algo en lo que pensar durante el tiempo libre :)
Resumiendo
Antes de resumir, quería responder a la pregunta que seguramente ha surgido en la mente de nuestro querido lector. ¿Para qué, en realidad, estos 'sufrimientos' con los descensos, por qué debemos subir y bajar (principalmente bajar) por la montaña para encontrar el ansiado valle, si en nuestras manos tenemos un instrumento tan poderoso y sencillo, en forma de solución analítica, que nos teletransporta instantáneamente al lugar deseado?
La respuesta a esta pregunta está a la vista. Ahora hemos analizado un ejemplo muy simple, en el que la respuesta real  depende de una característica
 . En la vida, esto no se encuentra a menudo, así que imaginemos que tenemos 2, 30, 50 o más características. Agreguemos a esto miles, o incluso decenas de miles de valores para cada característica. En este caso, la solución analítica puede no soportar la prueba y fallar. A su vez, el descenso de gradiente y sus variaciones se acercarán lenta pero seguramente a nuestro objetivo: el mínimo de la función. Y en cuanto a la velocidad, no se preocupen: seguramente volveremos a analizar formas que nos permitan establecer y regular la longitud del paso (es decir, la velocidad).
Y ahora, en resumen.
En primer lugar, espero que el material presentado en este artículo ayude a los principiantes en «ciencia de datos» a comprender cómo resolver ecuaciones de regresión lineal simple (y no solo).
En segundo lugar, hemos revisado varios métodos para resolver la ecuación. Ahora, dependiendo de la situación, podemos elegir el que mejor se adapte a la tarea planteada.
En tercer lugar, hemos visto el poder de las configuraciones adicionales, como la longitud del paso del descenso de gradiente. No se debe subestimar este parámetro. Como se mencionó anteriormente, para reducir los costos computacionales, la longitud del paso debe ajustarse durante el descenso.
En cuarto lugar, en nuestro caso, las funciones «hechas a medida» mostraron el mejor rendimiento temporal en los cálculos. Probablemente, esto se debe a un uso no del todo profesional de las capacidades de la biblioteca. NumPy. Pero de cualquier manera, la conclusión es la siguiente. Por un lado, a veces vale la pena cuestionar las opiniones establecidas, y por otro, no siempre hay que complicar las cosas: a veces un enfoque más simple resulta ser más efectivo. Dado que nuestro objetivo era analizar tres enfoques para resolver la ecuación de regresión lineal simple, el uso de funciones «hechas a medida» fue suficiente.
Literatura (o algo parecido)
1. Regresión lineal
2. Método de los mínimos cuadrados
3. Derivada
4. Gradiente
5. Descenso de gradiente
6. Biblioteca NumPy
Fuente: habr.com
