

SciPy (se pronuncia como sai pai) es un paquete de procedimientos matemáticos aplicados, basado en la extensión Numpy de Python. Con SciPy, una sesión interactiva de Python se convierte en un entorno completo para el procesamiento de datos y la creación de prototipos de sistemas complejos, similar a MATLAB, IDL, Octave, R-Lab y SciLab. Hoy quiero hablar brevemente sobre cómo se deben aplicar algunos algoritmos conocidos de optimización en el paquete scipy.optimize. Puedes obtener una referencia más detallada y actual sobre el uso de las funciones utilizando el comando help() o mediante Shift+Tab.
Introducción
Para evitar que yo mismo y los lectores tengamos que buscar y leer las fuentes originales, las referencias a las descripciones de los métodos serán, en su mayoría, a Wikipedia. Normalmente, esta información es suficiente para comprender los métodos en términos generales y las condiciones de su aplicación. Para entender la esencia de los métodos matemáticos, seguimos los enlaces a publicaciones más autoritarias, que se pueden encontrar al final de cada artículo o en tu motor de búsqueda favorito.
Así que el módulo scipy.optimize incluye la implementación de los siguientes procedimientos:
- Minimización condicional y no condicional de funciones escalares de varias variables (minim) utilizando diferentes algoritmos (simplex de Nelder-Mead, BFGS, gradientes conjugados de Newton, y )
- Optimización global (por ejemplo: , )
- Minimización de residuos (least_squares) y algoritmos de ajuste de curvas con mínimos cuadrados no lineales (curve_fit)
- Minimización de funciones escalares de una variable (minim_scalar) y búsqueda de raíces (root_scalar)
- Solucionadores multidimensionales de sistemas de ecuaciones (root) utilizando diferentes algoritmos (híbrido de Powell, o métodos a gran escala, como ).
En este artículo, solo abordaremos el primer aspecto de toda esta lista.
Minimización no condicionada de una función escalar de varias variables
La función minim del paquete scipy.optimize proporciona una interfaz general para resolver problemas de minimización condicional y no condicional de funciones escalares de varias variables. Para demostrar su funcionamiento, necesitaremos una función adecuada de varias variables que vamos a minimizar de diferentes maneras.
Para estos propósitos, la función de Rosenbrock de N variables es perfectamente adecuada, que tiene la forma:

A pesar de que la función Rosenbrock y sus matrices de Jacobi y Hessiana (derivadas primera y segunda respectivamente) ya están definidas en el paquete scipy.optimize, la definiremos por nuestra cuenta.
import numpy as np

def rosen(x):
    """La función Rosenbrock"""
    return np.sum(100.0*(x[1:]-x[:-1]**2.0)**2.0 + (1-x[:-1])**2.0, axis=0)
Para mayor claridad, graficaremos en 3D los valores de la función Rosenbrock en función de dos variables.
Código para la graficación
from mpl_toolkits.mplot3d import Axes3D
import matplotlib.pyplot as plt
from matplotlib import cm
from matplotlib.ticker import LinearLocator, FormatStrFormatter

# Configuramos la gráfica 3D
fig = plt.figure(figsize=[15, 10])
ax = fig.gca(projection='3d')

# Establecemos el ángulo de vista
ax.view_init(45, 30)

# Creamos los datos para la gráfica
X = np.arange(-2, 2, 0.1)
Y = np.arange(-1, 3, 0.1)
X, Y = np.meshgrid(X, Y)
Z = rosen(np.array([X,Y]))

# Dibujamos la superficie
surf = ax.plot_surface(X, Y, Z, cmap=cm.coolwarm)
plt.show()
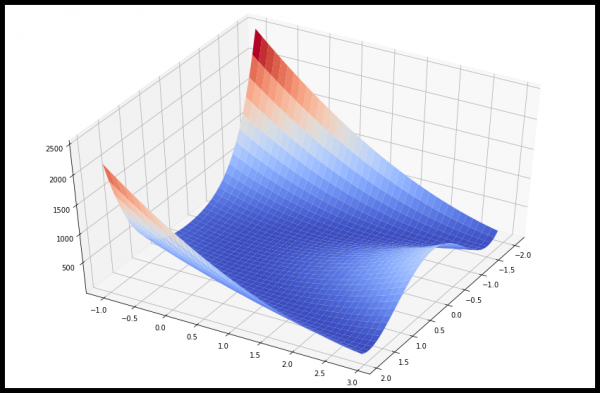
Sabiendo de antemano que el mínimo es 0 en  , veamos ejemplos de cómo determinar el valor mínimo de la función Rosenbrock utilizando diferentes procedimientos de scipy.optimize.
Método del simplex de Nelder-Mead
Supongamos que tenemos un punto inicial x0 en un espacio de 5 dimensiones. Encontraremos el punto mínimo de la función Rosenbrock más cercano a él utilizando el algoritmo (el algoritmo se indica como valor del parámetro method):
from scipy.optimize import minimize
x0 = np.array([1.3, 0.7, 0.8, 1.9, 1.2])
res = minimize(rosen, x0, method='nelder-mead',
    options={'xtol': 1e-8, 'disp': True})
print(res.x)
Optimización terminada con éxito.
Valor actual de la función: 0.000000
Iteraciones: 339
Evaluaciones de la función: 571
[1. 1. 1. 1. 1.]El método del simplex es la forma más sencilla de minimizar una función definida explícitamente y bastante suave. No requiere calcular derivadas de la función, solo es necesario especificar sus valores. El método de Nelder-Mead es una buena opción para problemas simples de minimización. Sin embargo, dado que no utiliza estimaciones de gradiente, puede requerir más tiempo para encontrar el mínimo.
Método de Powell
Otro algoritmo de optimización que solo calcula valores de funciones es . Para utilizarlo, debe establecer method = 'powell' en la función minim.
x0 = np.array([1.3, 0.7, 0.8, 1.9, 1.2])
res = minimize(rosen, x0, method='powell',
    options={'xtol': 1e-8, 'disp': True})
print(res.x)
Optimización terminada con éxito.
Valor actual de la función: 0.000000
Iteraciones: 19
Evaluaciones de la función: 1622
[1. 1. 1. 1. 1.]Algoritmo Broyden-Fletcher-Goldfarb-Shanno (BFGS)
Para lograr una convergencia más rápida hacia la solución, el procedimiento utiliza el gradiente de la función objetivo. El gradiente puede estar definido como una función o calcularse usando diferencias de primer orden. En cualquier caso, generalmente el método BFGS requiere menos llamadas a funciones que el método simplex.
Encontraremos la derivada de la función de Rosenbrock de forma analítica:


Esta expresión es válida para las derivadas de todas las variables, excepto la primera y la última, que se definen como:


Veamos la función de Python que calcula este gradiente:
def rosen_der(x):
    xm = x[1: -1]
    xm_m1 = x[:-2]
    xm_p1 = x[2:]
    der = np.zeros_like(x)
    der[1: -1] = 200 * (xm - xm_m1 ** 2) - 400 * (xm_p1 - xm ** 2) * xm - 2 * (1 - xm)
    der[0] = -400 * x[0] * (x[1] - x[0] ** 2) - 2 * (1 - x[0])
    der[-1] = 200 * (x[-1] - x[-2] ** 2)
    return der
La función que calcula el gradiente se indica como el valor del parámetro jac de la función minim, como se muestra a continuación.
res = minimize(rosen, x0, method='BFGS', jac=rosen_der, options={'disp': True})
print(res.x)
Optimización terminada con éxito.
Valor actual de la función: 0.000000
Iteraciones: 25
Evaluaciones de la función: 30
Evaluaciones del gradiente: 30
[1.00000004 1.0000001 1.00000021 1.00000044 1.00000092]El algoritmo de gradientes conjugados (Newton)
Algoritmo es un método modificado de Newton.
El método de Newton se basa en la aproximación de la función en un área local mediante un polinomio de segundo grado:

donde  es la matriz de segundas derivadas (matriz Hessiana, hessiano).
Si el hessiano es definido positivo, se puede encontrar el mínimo local de esta función igualando el gradiente nulo de la forma cuadrática a cero. Como resultado se obtiene la expresión:

El hessiano se calcula utilizando el método de gradientes conjugados. A continuación se proporciona un ejemplo de uso de este método para minimizar la función de Rosenbrock. Para usar el método Newton-CG, es necesario definir una función que calcule el hessiano.
El hessiano de la función de Rosenbrock en forma analítica es:


donde  y
 , define la matriz
 .
Los demás elementos distintos de cero de la matriz son:


Por ejemplo, en un espacio de cinco dimensiones N = 5, la matriz Hessiana para la función de Rosenbrock tiene una forma de banda:

El código que calcula este hessiano junto con el código para minimizar la función de Rosenbrock utilizando el método de gradientes conjugados (Newton):
def rosen_hess(x):
    x = np.asarray(x)
    H = np.diag(-400*x[:-1],1) - np.diag(400*x[:-1],-1)
    diagonal = np.zeros_like(x)
    diagonal[0] = 1200*x[0]**2-400*x[1]+2
    diagonal[-1] = 200
    diagonal[1:-1] = 202 + 1200*x[1:-1]**2 - 400*x[2:]
    H = H + np.diag(diagonal)
    return H

res = minimize(rosen, x0, method='Newton-CG',
               jac=rosen_der, hess=rosen_hess,
               options={'xtol': 1e-8, 'disp': True})
print(res.x)
La optimización se ha terminado con éxito.
Valor actual de la función: 0.000000
Iteraciones: 24
Evaluaciones de la función: 33
Evaluaciones del gradiente: 56
Evaluaciones del hessiano: 24
[1. 1. 1. 0.99999999 0.99999999]Ejemplo de definición de la función del producto del hessiano y un vector arbitrario
En problemas reales, calcular y almacenar toda la matriz Hessiana puede requerir recursos significativos de tiempo y memoria. Sin embargo, no es necesario definir la matriz Hessiana en sí, ya que para el procedimiento de minimización solo se necesita un vector que sea el producto del hessiano con otro vector arbitrario. Por lo tanto, desde el punto de vista computacional, es mucho más conveniente definir de inmediato una función que devuelva el resultado del producto del hessiano con un vector arbitrario.
Consideremos la función hess, que toma el vector de minimización como primer argumento y un vector arbitrario como segundo argumento (junto con otros argumentos de la función minimizada). En nuestro caso, calcular el producto del hessiano de la función de Rosenbrock con un vector arbitrario no es muy complicado. Si p — es un vector arbitrario, entonces el producto  tiene la forma:

La función que calcula el producto del hessiano y un vector arbitrario se pasa como valor del argumento hessp de la función minimize:
def rosen_hess_p(x, p):
    x = np.asarray(x)
    Hp = np.zeros_like(x)
    Hp[0] = (1200*x[0]**2 - 400*x[1] + 2)*p[0] - 400*x[0]*p[1]
    Hp[1:-1] = -400*x[:-2]*p[:-2]+(202+1200*x[1:-1]**2-400*x[2:])*p[1:-1]
    -400*x[1:-1]*p[2:]
    Hp[-1] = -400*x[-2]*p[-2] + 200*p[-1]
    return Hp

res = minimize(rosen, x0, method='Newton-CG',
               jac=rosen_der, hessp=rosen_hess_p,
               options={'xtol': 1e-8, 'disp': True})
La optimización se ha terminado con éxito.
         Valor actual de la función: 0.000000
         Iteraciones: 24
         Evaluaciones de la función: 33
         Evaluaciones del gradiente: 56
         Evaluaciones del hessiano: 66
El algoritmo de región de confianza (trust region) de gradientes conjugados (Newton)
Una mala condicionamiento de la matriz Hessiana y direcciones de búsqueda incorrectas pueden llevar a que el algoritmo de gradientes conjugados de Newton sea ineficaz. En tales casos, se prefiere (trust-region) de gradientes conjugados de Newton.
Ejemplo de definición de la matriz Hessiana:
res = minimize(rosen, x0, method='trust-ncg',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})
print(res.x)
La optimización ha terminado con éxito.
Valor actual de la función: 0.000000
Iteraciones: 20
Evaluaciones de la función: 21
Evaluaciones del gradiente: 20
Evaluaciones de la Hessiana: 19
[1. 1. 1. 1. 1.]Ejemplo con la función de producto de la Hessiana y un vector arbitrario:
res = minimize(rosen, x0, method='trust-ncg',
                jac=rosen_der, hessp=rosen_hess_p,
                options={'gtol': 1e-8, 'disp': True})
print(res.x)
La optimización ha terminado con éxito.
Valor actual de la función: 0.000000
Iteraciones: 20
Evaluaciones de la función: 21
Evaluaciones del gradiente: 20
Evaluaciones de la Hessiana: 0
[1. 1. 1. 1. 1.]Métodos de tipo Krylov
Al igual que el método trust-ncg, los métodos de tipo Krylov son adecuados para resolver problemas a gran escala, ya que solo utilizan productos matriz-vector. Su esencia radica en resolver el problema en un área de confianza, limitada por un subespacio truncado de Krylov. Para problemas indefinidos, es mejor utilizar este método, ya que requiere menos iteraciones no lineales gracias a un menor número de productos matriz-vector por subproblema, en comparación con el método trust-ncg. Además, la solución de la sub-tarea cuadrática se encuentra de manera más precisa que con el método trust-ncg.
Ejemplo de definición de la matriz Hessiana:
res = minimize(rosen, x0, method='trust-krylov',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})

La optimización ha terminado con éxito.
         Valor actual de la función: 0.000000
         Iteraciones: 19
         Evaluaciones de la función: 20
         Evaluaciones del gradiente: 20
         Evaluaciones de la Hessiana: 18

print(res.x)

    [1. 1. 1. 1. 1.]
Ejemplo con la función de producto de la Hessiana y un vector arbitrario:
res = minimize(rosen, x0, method='trust-krylov',
               jac=rosen_der, hessp=rosen_hess_p,
               options={'gtol': 1e-8, 'disp': True})

La optimización ha terminado con éxito.
         Valor actual de la función: 0.000000
         Iteraciones: 19
         Evaluaciones de la función: 20
         Evaluaciones del gradiente: 20
         Evaluaciones de la Hessiana: 0

print(res.x)

    [1. 1. 1. 1. 1.]
Algoritmo de solución aproximada en el área de confianza
Todos los métodos (Newton-CG, trust-ncg y trust-krylov) son adecuados para resolver problemas a gran escala (con miles de variables). Esto se debe a que el algoritmo subyacente de gradientes conjugados implica encontrar de manera aproximada la matriz inversa de la Hessiana. La solución se encuentra de forma iterativa, sin descomposición explícita de la Hessiana. Dado que solo se requiere definir la función para el producto de la Hessiana y un vector arbitrario, este algoritmo es especialmente bueno para trabajar con matrices dispersas (diagonales de banda). Esto asegura bajos costos de memoria y un ahorro significativo de tiempo.
En problemas de tamaño mediano, los costos de almacenamiento y la factorización de la matriz Hessiana no son decisivos. Esto significa que se puede obtener una solución en menos iteraciones al resolver casi con precisión las sub-tareas del área de confianza. Para ello, algunas ecuaciones no lineales se resuelven de manera iterativa para cada sub-tarea cuadrática. Tal solución generalmente requiere 3 o 4 descomposiciones de Cholesky de la matriz Hessiana. Como resultado, el método converge en menos iteraciones y requiere menos evaluaciones de la función objetivo que otros métodos de área de confianza implementados. Este algoritmo implica únicamente la determinación de la matriz Hessiana completa y no admite la posibilidad de utilizar la función del producto de la Hessiana y un vector arbitrario.
Ejemplo de minimización de la función de Rosenbrock:
res = minimize(rosen, x0, method='trust-exact',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})
res.x
Optimización terminada con éxito.
Valor actual de la función: 0.000000
Iteraciones: 13
Evaluaciones de la función: 14
Evaluaciones del gradiente: 13
Evaluaciones de la Hessiana: 14
array([1., 1., 1., 1., 1.])Con esto, quizás sea suficiente. En el próximo artículo intentaré contar lo más interesante sobre la minimización condicionada, la aplicación de la minimización en la resolución de problemas de aproximación, minimización de funciones de una variable, minimizadores arbitrarios y la búsqueda de raíces de sistemas de ecuaciones utilizando el paquete scipy.optimize.
Fuente:
Fuente: habr.com
