

El proyecto Riffusion desarrolla una variante del sistema de aprendizaje automático Stable Diffusion, adaptado para generar música en lugar de imágenes. La música puede ser sintetizada a partir de una descripción en lenguaje natural o según una plantilla propuesta. Los componentes para la síntesis de música están escritos en Python utilizando el marco de trabajo PyTorch y están disponibles bajo la licencia MIT. La interfaz está implementada en TypeScript y también se distribuye bajo la licencia MIT. Los modelos entrenados están abiertos bajo la licencia permisiva Creative ML OpenRAIL-M, que permite su uso con fines comerciales.
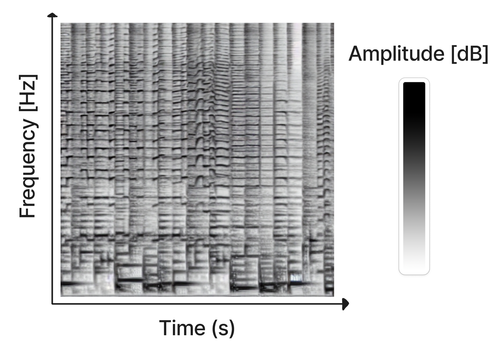
El proyecto es interesante porque continúa utilizando modelos 'de texto a imagen' y 'de imagen a imagen' para generar música, pero manipula espectrogramas como si fueran imágenes. En otras palabras, el clásico Stable Diffusion no fue entrenado en fotografías y gráficos, sino en imágenes de espectrogramas que reflejan el cambio en la frecuencia y la amplitud de la onda sonora a lo largo del tiempo. Por lo tanto, la salida también es un espectrograma, que luego se convierte en una representación sonora.
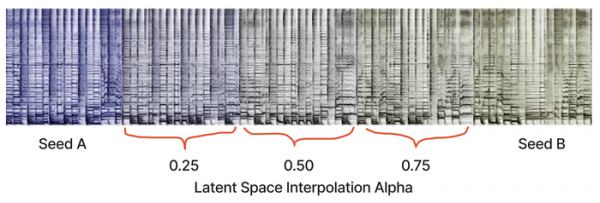
El método también puede usarse para modificar composiciones sonoras existentes y sintetizar música a partir de ejemplos, similar a la modificación de imágenes en Stable Diffusion. Por ejemplo, se pueden especificar ejemplos de espectrogramas con un estilo de referencia durante la generación, combinar diferentes estilos, hacer una transición suave de un estilo a otro o realizar cambios en un sonido existente para resolver tareas como aumentar el volumen de instrumentos individuales, alterar el ritmo y reemplazar instrumentos. Los ejemplos también se utilizan para generar composiciones que se reproducen durante un tiempo prolongado, compuestas de una serie de fragmentos cercanos entre sí que cambian ligeramente con el tiempo. Los fragmentos generados por separado se unen en un flujo continuo mediante la interpolación de parámetros internos del modelo.
Para crear un espectrograma a partir de sonido se utiliza la transformada de Fourier de ventana. Al recrear sonido a partir de un espectrograma, surge el problema de determinar la fase (en el espectrograma solo hay frecuencia y amplitud), para cuya reconstrucción se utiliza el algoritmo de aproximación de Griffin-Lim.
Fuente: opennet.ru
