

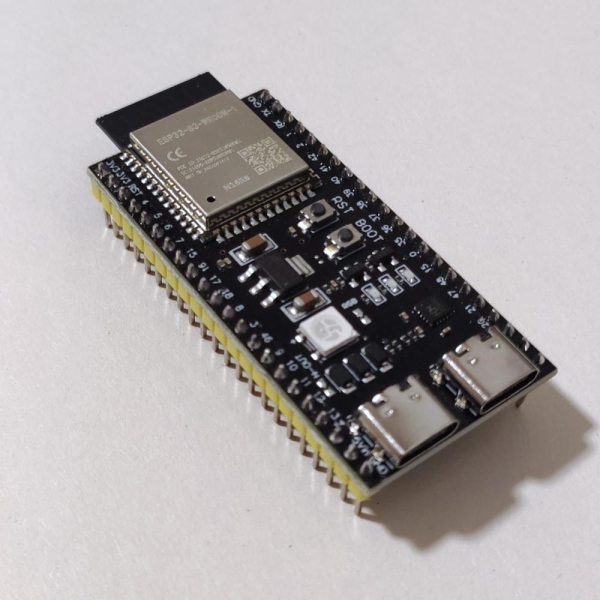
El desarrollador Viacheslav Serbov, que utiliza el seudónimo slvDev, demostró ha creado una generación de texto completamente local en el microcontrolador ESP32-S3. El modelo de lenguaje que ha desarrollado contiene 28,9 millones de parámetros y produce alrededor de 9,9 tokens por segundo, sin necesidad de conectarse a un servidor o a otros recursos de computación externos. Las historias cortas generadas se muestran en una pantalla OLED conectada.
Proyecto esp32-ai ha sido probado en el módulo ESP32-S3 N16R8, que cuenta con 512 KB de SRAM integrada, 8 MB de PSRAM y 16 MB de memoria flash. El modelo cuantificado a cuatro bits ocupa 14,9 MB. En el repositorio se publica el código fuente del entorno de ejecución en C, herramientas de entrenamiento y cuantificación del modelo, el firmware, pruebas y scripts para su carga en la placa.
Los 28,9 millones de parámetros declarados no deben compararse directamente con la cantidad de parámetros de los LLM de escritorio convencionales. Según el informe detallado del desarrollador, el modelo consiste en un núcleo computacional denso de aproximadamente 559 mil parámetros, una capa de salida de 3,1 millones de parámetros y una tabla de representaciones vectoriales por capa de aproximadamente 25 millones de parámetros. Es esta última la que proporciona la mayor parte del tamaño formal del modelo, pero no se procesa en su totalidad durante la generación de cada token.
La modelación utiliza tres niveles de memoria. Los datos más frecuentemente utilizados se encuentran en la SRAM interna, la capa de salida, el caché KV y los búferes temporales están en PSRAM, mientras que la tabla de 25 millones de parámetros permanece en la memoria flash y se accede a través de un mapeo en el espacio de direcciones. Para cada token, solo se leen alrededor de seis líneas con un volumen total de aproximadamente 450 bytes.
Este dispositivo se basa en la tecnología Per-Layer Embeddings, utilizada por Google en Gemma 3n. Según la documentación de Google, los parámetros PLE pueden almacenarse fuera de la memoria de trabajo del modelo y añadirse al proceso de salida a medida que se procesan capas individuales. En esp32-ai, este enfoque se ha trasladado a la jerarquía de memoria del microcontrolador, donde la SRAM rápida es especialmente limitada.
La primera versión correcta del entorno de ejecución escrito en C solo generaba 0,57 tokens por segundo. Después de colocar la capa de salida en PSRAM, cambiar a activaciones de 8 bits, distribuir cálculos entre dos núcleos Xtensa LX7 y otras optimizaciones, la latencia se redujo a 94,9 ms por paso del modelo. La velocidad final medida alcanzó 9,88 tokens por segundo teniendo en cuenta todo el proceso de generación. El principal límite ahora es el ancho de banda de PSRAM al leer la capa de salida.
El modelo ha sido entrenado en un conjunto de datos sintéticos TinyStories, compuesto por narraciones simples en inglés con un vocabulario limitado. Por lo tanto, puede continuar frases y crear pequeñas historias coherentes, pero no está diseñado para responder preguntas, seguir instrucciones, programar o reproducir conocimientos fácticos. El desarrollador considera el trabajo principalmente como una demostración de la efectiva colocación del modelo en la memoria del microcontrolador, y no como un chatbot autónomo listo para usar.
En la documentación actual, el autor enfatiza que esp32-ai es un desarrollo independiente. Los proyectos llama2.c de Andrei Karpathy y el lanzamiento anterior de un modelo de 260,000 parámetros en el ESP32-S3 se mencionan solo como hitos y ejemplos de trabajos anteriores: el código, los puntos de control y el método no fueron tomados directamente de ellos. El código fuente de esp32-ai se distribuye bajo la licencia MIT.
Fuente: linux.org.ru
