

En junio de este año, en la pequeña ciudad suiza de Rapperswil, se celebró por décima vez un evento llamado . Esta vez, más de quinientos aficionados a Haskell, desde principiantes hasta pioneros del lenguaje, se reunieron allí. Aunque los organizadores llaman a este evento un hackatón, no se trata de una conferencia o hackatón en el sentido clásico. Su formato se diferencia de los típicos eventos para programadores. Nos enteramos de ZuriHac por casualidad, participamos en él y ahora consideramos nuestro deber contarles sobre este hallazgo inusual.
Sobre nosotros
Este artículo fue preparado por dos estudiantes de tercer año del programa de "Matemáticas Aplicadas e Informática" de la Universidad Nacional de Investigación – Higher School of Economics – San Petersburgo: Vasiliy Alferov y Elizabeth Vasilenko. La pasión por la programación funcional para ambos comenzó con un ciclo de conferencias de D. N. Moskvín en segundo año de la universidad. En este momento, Vasiliy está participando en el programa Google Summer of Code, donde trabaja en la implementación de grafos algebraicos en el lenguaje Haskell bajo la supervisión del equipo del proyecto . Elizabeth aplicó las habilidades adquiridas en programación funcional en su trabajo de curso, dedicado a la implementación del algoritmo de anti-unificación con su posterior aplicación en la teoría de tipos.
Formato del evento
La audiencia objetivo son los propietarios de proyectos de código abierto, programadores que desean participar en su desarrollo, investigadores de la programación funcional y simplemente entusiastas de Haskell. Este año, en el lugar de celebración - la universidad HSR Hochschule für Technik Rapperswil - se reunieron desarrolladores de más de cincuenta proyectos de código abierto en el lenguaje Haskell de todo el mundo para hablar sobre sus productos y atraer a nuevas personas a su desarrollo.
Fotos de Twitter
El esquema es muy sencillo: es necesario escribir de antemano algunas frases sobre su proyecto y enviarlas a los organizadores, que publicarán la información sobre su proyecto en la página del evento. Además, en el primer día, los autores de los proyectos tienen treinta segundos para contar muy brevemente desde el escenario en qué están trabajando y qué se necesita hacer. Luego, las personas interesadas buscan a los autores y les preguntan en detalle sobre las tareas.
Por el momento, no tenemos proyectos abiertos propios, pero queremos contribuir a los existentes, así que nos registramos como participantes comunes. Durante tres días trabajamos con dos grupos de desarrolladores. Resulta que el estudio conjunto del código y la comunicación en vivo hace que la interacción entre los autores del proyecto y los contribuyentes sea muy productiva; en ZuriHac pudimos adentrarnos en nuevas áreas y ayudar a dos equipos completamente diferentes, cerrando una tarea en cada uno de los proyectos.
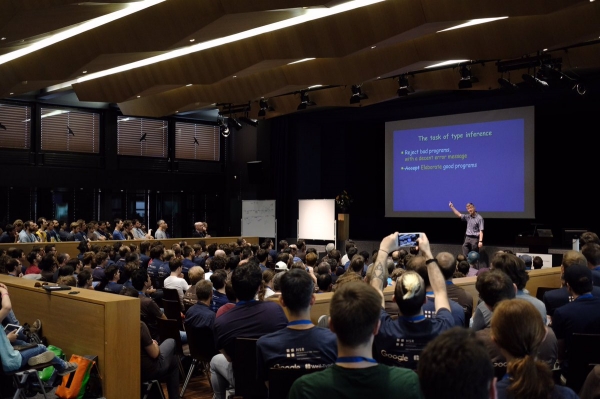
Además de la valiosa práctica, también se dieron varias conferencias y talleres en ZuriHac. Nos quedaron especialmente grabadas dos conferencias. En la primera, Andrey Mokhov, de la Universidad de Newcastle, habló sobre los funtores aplicativos selectivos, una clase de tipos que debería servir de intermediario entre los funtores aplicativos y las mónadas. En la otra, uno de los fundadores de Haskell, Simon Peyton Jones, explicó cómo se lleva a cabo la inferencia de tipos en el compilador GHC.
Conferencia de Simon Peyton Jones. Foto de Twitter
Los talleres que se llevaron a cabo durante el hackatón se dividieron en tres categorías según el nivel de preparación de los participantes. Las tareas ofrecidas a los participantes que se unieron al desarrollo de proyectos también tenían etiquetas con el nivel de dificultad. Una comunidad pequeña pero unida de programadores funcionales acepta con gusto a los principiantes. Sin embargo, para comprender las conferencias de Andrey Mokhov y Simon Peyton Jones, nos resultó muy útil el curso de programación funcional que cursamos en la universidad.
Para los participantes comunes y los autores de proyectos, la inscripción al evento es gratuita. Presentamos nuestras solicitudes a principios de junio, y después de un tiempo bastante corto, fuimos trasladados de la lista de espera a la lista de participantes confirmados.
Ahora les contaremos sobre los proyectos en los que participamos en el desarrollo.
Pandoc
es un convertidor universal de documentos de texto, de hecho, de cualquier formato a cualquier otro. Por ejemplo, de docx a pdf, o de Markdown a MediaWiki. Su autor, John MacFarlane, es profesor de filosofía en la Universidad de California en Berkeley. En general, Pandoc es bastante conocido, y algunos de nuestros conocidos se sorprendieron al enterarse de que Pandoc está escrito en Haskell.
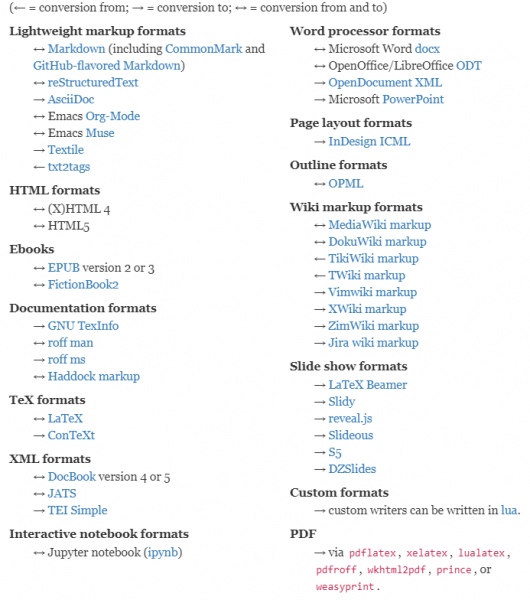
Lista de formatos de documentos compatibles con Pandoc. En el sitio también hay un gráfico completo, pero esa imagen no cabe en el artículo.
Por supuesto, Pandoc no implementa la conversión directa para cada par de formatos. Para soportar una gama tan amplia de conversiones, se utiliza una solución arquitectónica estándar: primero, todo el documento se traduce a una representación intermedia interna específica, y luego se genera un documento en otro formato a partir de esta representación interna. Los desarrolladores llaman a esta representación interna 'AST', que se desglosa como Árbol de Sintaxis Abstracta, o . Se puede ver la representación intermedia de manera muy sencilla: solo hay que especificar 'native' como formato de salida.
$ cat example.html
<h1>¡Hola, mundo!</h1>

$ pandoc -f html -t native example.html
[Encabezado 1 ("hello-world",[],[]) [Str "¡Hola,",Space,Str "Mundo!"]]
Los lectores que hayan trabajado un poco con Haskell ya pueden, a partir de este pequeño ejemplo, suponer que Pandoc está escrito precisamente en Haskell: la salida de este comando es una representación de las estructuras internas de Pandoc en forma de cadena, creada a semejanza de cómo se hace normalmente en Haskell, por ejemplo, en la biblioteca estándar.
Así que aquí se puede ver que la representación interna es una estructura recursiva, en la que cada nodo interno contiene una lista. Por ejemplo, en el nivel más alto hay una lista de un solo elemento: un encabezado de primer nivel con los atributos 'hello-world', [], []. Dentro de este encabezado hay una lista compuesta por la cadena 'Hello,', un espacio y la cadena 'World!'.
Como se puede ver, la representación interna no difiere mucho del HTML. Representa un árbol, donde cada nodo interno informa sobre el formato de sus descendientes, y en las hojas se encuentra el contenido del documento.
Si se baja a un nivel de implementación específica, el tipo de datos para todo el documento se define de la siguiente manera:
data Pandoc = Pandoc Meta [Block]Aquí Block son precisamente los nodos internos sobre los que se habla arriba, y Meta es la metainformación sobre el documento, como el título, la fecha de creación, los autores; para diferentes formatos esta información varía, y Pandoc trata de conservar esta información en la medida de lo posible al convertir de un formato a otro.
Casi todos los constructores de tipo Block, como Header o Para (párrafo), aceptan atributos y una lista de nodos de nivel más bajo, que suelen ser de tipo Inline. Por ejemplo, Space o Str son constructores de tipo Inline, y el HTML también se convierte en un Inline especial. No vemos sentido en proporcionar una definición completa de estos tipos, sin embargo, podemos señalar que se puede consultar aquí. .
Es interesante que el tipo Pandoc sea un monoide. Esto significa que hay algún documento vacío y que los documentos se pueden combinar entre sí. Esto es conveniente al escribir Readers, ya que se puede dividir el documento en partes con una lógica arbitraria, analizar cada una por separado y luego juntar todo en un solo documento. La meta información se recopilará de todas las partes del documento simultáneamente.
Al convertir, por ejemplo, de LaTeX a HTML, primero un módulo especial llamado LaTeXReader convierte el documento de entrada en AST, luego otro módulo llamado HTMLWriter convierte el AST en HTML. Gracias a esta arquitectura, no es necesario escribir un número cuadrático de conversiones, basta con escribir un Reader y un Writer para cada nuevo formato, y todas las posibles combinaciones de conversiones se soportarán automáticamente.
Es evidente que dicha arquitectura también tiene sus desventajas, que han sido predichas hace tiempo por especialistas en arquitectura de software. La más significativa es el costo de realizar cambios en el árbol sintáctico. Si el cambio es lo suficientemente serio, será necesario modificar el código en todos los Readers y Writers. Por ejemplo, uno de los desafíos que enfrentan los desarrolladores de Pandoc es el soporte de formatos complejos de tablas. Actualmente, Pandoc solo puede manejar las tablas más simples, con encabezados, columnas y valores en cada celda. Por ejemplo, el atributo colspan en HTML simplemente será ignorado. Una de las razones de este comportamiento es la falta de un esquema unificado para la representación de tablas en todos o al menos en muchos formatos; en consecuencia, no está claro en qué forma deben almacenarse las tablas en la representación interna. Pero incluso después de elegir una representación específica, será necesario cambiar absolutamente todos los Readers y Writers que soporten el trabajo con tablas.
El lenguaje Haskell fue elegido no solo por el gran amor que los autores tienen por la programación funcional. Haskell es conocido por sus amplias capacidades en el procesamiento de textos. Un ejemplo de esto es la biblioteca — una biblioteca que utiliza activamente conceptos de la programación funcional — monoides, mónadas, funtores aplicativos y alternativos — para escribir analizadores arbitrarios. Todo el poder de Parsec se puede ver en HaskellWiki, donde se analiza un parser completo para un lenguaje de programación imperativo simple. Por supuesto, Parsec se utiliza activamente también en Pandoc.
Si se describe brevemente, las mónadas se utilizan para el análisis secuencial, donde primero se parsea una cosa y luego otra. Por ejemplo, en el siguiente caso:
whileParser :: Parser Stmt
whileParser = whiteSpace >> statement
Primero se necesita leer el espacio en blanco, y luego la statement — que también tiene el tipo Parser Stmt.
Los funtores alternativos se utilizan para retroceder en caso de que el parseo no tenga éxito. Por ejemplo,
statement :: Parser Stmt
statement = parens statement  sequenceOfStmt
Lo que significa que se debe intentar leer statement entre paréntesis, o intentar leer varios statement de forma secuencial.
Los funtores aplicativos se utilizan principalmente como atajos para las mónadas. Por ejemplo, si la función tok lee algún token (esta es una función real de LaTeXReader). Observemos esta combinación
const tok tokLeerá dos tokens en secuencia y devolverá el primero de ellos.
Para todas estas clases en Haskell existen hermosos operadores simbólicos, lo que hace que la programación de Readers se parezca a un arte ASCII. Solo admira este maravilloso código.
Nuestras tareas estaban relacionadas con LaTeXReader. La tarea de Vasily era soportar los comandos mbox y hbox, útiles para la creación de paquetes en LaTeX. Elizabeth era responsable de soportar el comando epigraph, que permite formatear epígrafes en documentos de LaTeX.
Hatrace
En sistemas operativos similares a UNIX, a menudo se implementa la llamada al sistema ptrace. Es útil para depurar y simular entornos de programas, permitiendo rastrear las llamadas al sistema que realiza un programa. Por ejemplo, la muy útil herramienta strace utiliza internamente precisamente ptrace.
Hatrace es una biblioteca que proporciona una interfaz para ptrace en Haskell. El problema es que ptrace es bastante complejo y utilizarlo directamente puede ser complicado, especialmente desde lenguajes funcionales.
Hatrace, al ejecutarse, funciona como strace y acepta argumentos similares. Su diferencia con strace es que también es una biblioteca que proporciona una interfaz más simple que solo ptrace.
Con hatrace ya se detectó un incómodo error en el compilador de Haskell GHC: al ser terminado en un momento inadecuado, genera archivos de objeto incorrectos y no los recompila al reiniciar. El scripting por llamadas al sistema permitió reproducir el error de manera garantizada en un solo lanzamiento, donde las terminaciones aleatorias reproducían el error en aproximadamente dos horas.
Hemos añadido interfaces de llamadas al sistema a la biblioteca: Elizabeth añadió brk y Vasily añadió mmap. Como resultado de nuestro trabajo, se pueden utilizar de forma más simple y precisa los argumentos de estas llamadas al sistema al utilizar la biblioteca.
Fuente: habr.com
