

Del 30 de noviembre al 1 de diciembre se llevó a cabo en Nizhni Nóvgorod. Se invitó a los participantes a crear un prototipo de solución de producto utilizando el kit de herramientas Intel OpenVINO. Los organizadores ofrecieron una lista de temas sugeridos para orientar la elección de la tarea, pero la decisión final quedaba en manos de los equipos. Además, se fomentó el uso de modelos que no forman parte del producto.
En este artículo, contaremos cómo creamos nuestro prototipo de producto, con el cual finalmente ocupamos el primer lugar.
En el hackatón participaron más de 10 equipos. Es grato que algunos de ellos vinieran de otras regiones. El lugar elegido para el hackatón fue el complejo “Kremlevsky en Pochayina”, donde estaban exhibidas fotos antiguas de Nizhni Nóvgorod, ¡un ambiente único! (Cabe recordar que la oficina central de Intel está ubicada precisamente en Nizhni Nóvgorod). Se otorgaron 26 horas a los participantes para escribir el código y al final era necesario presentar su solución. Un punto positivo adicional fue la disponibilidad de una sesión de demostración, para asegurarse de que todo lo planeado se había llevado a cabo y no quedó solo en ideas para la presentación. También hubo merchandising, snacks y comida.
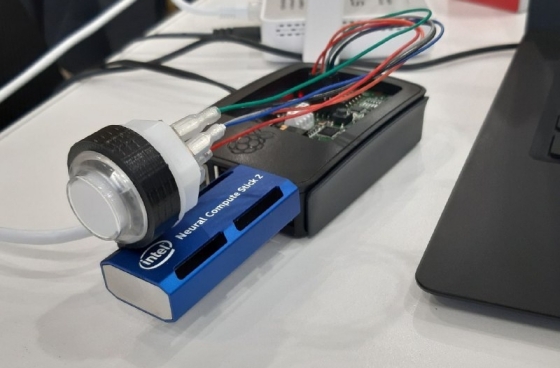
Además, la empresa Intel, si lo deseaban, proporcionó cámaras, Raspberry Pi, Neural Compute Stick 2.
Selección de la tarea
Una de las partes más difíciles de la preparación para un hackatón con temática libre es la elección de la tarea. Decidimos inmediatamente inventar algo que aún no estuviera en el producto, ya que en el anuncio se especificaba que esto era bienvenido.
Al analizar , que forman parte del producto en la versión actual, llegamos a la conclusión de que la mayoría de ellas abordan diversas tareas de visión por computadora. Es bastante complicado idear una tarea en el ámbito de la visión por computadora que no se pueda resolver utilizando OpenVINO, y si es que se puede inventar una, es difícil encontrar modelos preentrenados de acceso público. Decidimos explorar también otro enfoque: el procesamiento y análisis de voz. Consideramos una tarea interesante sobre el reconocimiento de emociones a partir del habla. Cabe mencionar que en OpenVINO ya existe un modelo que determina las emociones de una persona a través de su rostro, pero:
- Teóricamente, se podría crear un algoritmo combinado que funcione tanto con sonido como con imagen, lo que debería aumentar la precisión.
- Las cámaras generalmente tienen un ángulo de visión estrecho; para cubrir una gran área se necesita más de una cámara, el sonido no tiene esa limitación.
Desarrollamos la idea: tomemos como base un concepto para el segmento retail. Se puede determinar la satisfacción del cliente en las cajas de los comercios. Si alguno de los clientes no está satisfecho con el servicio y comienza a alzar la voz, se puede llamar de inmediato a un administrador para ayudar.
En este caso, es necesario añadir reconocimiento de voz, lo que nos permitirá distinguir entre los empleados de la tienda y los compradores, y generar análisis sobre cada individuo. Además, se podrá analizar el comportamiento de los propios empleados de la tienda, evaluando el ambiente en el colectivo, ¡suena bien!
Formulamos los requisitos para nuestra solución:
- Tamaño pequeño del dispositivo objetivo
- Función en tiempo real
- Bajo costo
- Fácil escalabilidad
Finalmente, elegimos como dispositivo objetivo el Raspberry Pi 3 con .
Aquí es importante señalar una característica clave del NCS: funciona mejor con arquitecturas CNN estándar; si se necesita ejecutar un modelo con capas personalizadas, se puede esperar una optimización de bajo nivel.
La tarea es sencilla: necesitamos conseguir un micrófono. Un micrófono USB normal servirá, aunque no se verá bien junto con el RPI. Pero aquí también hay una solución literalmente "a la mano". Para grabar la voz decidimos utilizar la placa Voice Bonnet del kit , que tiene un micrófono estéreo soldado.
Descargamos Raspbian desde y lo copiamos a una memoria USB, probamos que el micrófono funciona con el siguiente comando (graba audio durante 5 segundos y lo guarda en un archivo):
arecord -d 5 -r 16000 test.wavCabe mencionar que el micrófono es muy sensible y capta bien los ruidos. Para corregir esto, entraremos en alsamixer, seleccionaremos los dispositivos de captura y bajaremos el nivel de entrada al 50-60%.
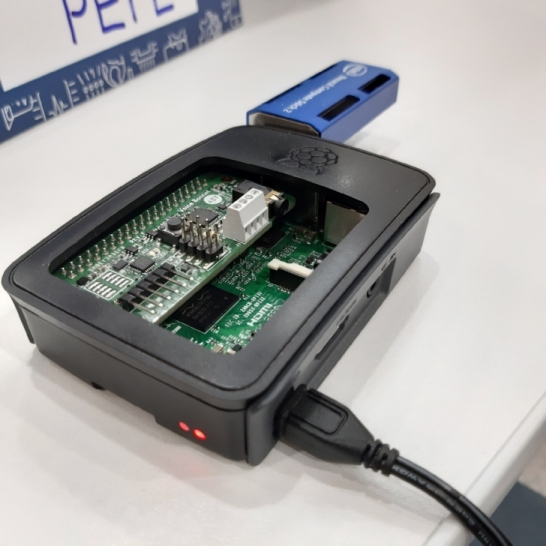
Ajustamos la carcasa con una lima y todo entra, incluso se puede cerrar con una tapa.
Añadimos un botón indicador.
Durante el desarme del AIY Voice Kit recordamos que hay un botón RGB cuya retroiluminación se puede controlar por software. Buscamos "Google AIY Led" y encontramos la documentación:
¿Por qué no utilizar este botón para mostrar la emoción reconocida? Tenemos solo 7 clases, y el botón tiene 8 colores, ¡es justo lo suficiente!
Conectamos el botón por GPIO al Voice Bonnet, cargamos las bibliotecas necesarias (ya están instaladas en la distribución de AIY projects)
from aiy.leds import Leds, Color
from aiy.leds import RgbLeds
Creamos un diccionario que asocie cada emoción con un color en forma de Tupla RGB y un objeto de la clase aiy.leds.Leds, que actualizaremos para cambiar el color:
led_dict = {'neutral': (255, 255, 255), 'happy': (0, 255, 0), 'sad': (0, 255, 255), 'angry': (255, 0, 0), 'fearful': (0, 0, 0), 'disgusted':  (255, 0, 255), 'surprised':  (255, 255, 0)}
leds = Leds()
Y, finalmente, después de cada nueva predicción de emoción, actualizaremos el color del botón de acuerdo a esta (por la clave).
leds.update(Leds.rgb_on(led_dict.get(classes[prediction])))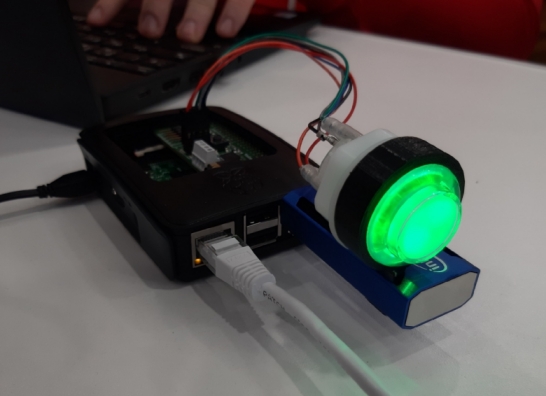
¡Botón, enciéndete!
Trabajando con la voz
Utilizaremos pyaudio para capturar el flujo del micrófono y webrtcvad para filtrar el ruido y detectar la voz. Además, crearemos una cola en la que agregaremos y retiraremos fragmentos de voz de manera asíncrona.
Dado que webrtcvad tiene una limitación en el tamaño del fragmento que se proporciona — debe ser de 10/20/30 ms, y el entrenamiento del modelo para el reconocimiento de emociones (como sabremos más adelante) se realizó en un conjunto de datos de 48 kHz, capturaremos fragmentos de tamaño 48000×20ms/1000×1(mono)=960 bytes. Webrtcvad devolverá True/False para cada uno de estos fragmentos, lo que corresponde a la presencia o ausencia de voz en el fragmento.
Implementaremos la siguiente lógica:
- Agregaremos a la lista aquellos fragmentos donde hay voz; si no hay voz, incrementaremos el contador de fragmentos vacíos.
- Si el contador de fragmentos vacíos >=30 (600 ms), entonces observamos el tamaño de la lista de fragmentos acumulados, si es >250, la añadimos a la cola; si no, consideramos que la longitud de la grabación es insuficiente para ser presentada al modelo para identificar al hablante.
- Si el contador de fragmentos vacíos aún < 30, pero el tamaño de la lista de fragmentos acumulados ha superado 300, añadiremos el fragmento a la cola para una predicción más precisa. (ya que con el tiempo las emociones tienden a cambiar)
 def to_queue(frames):
    d = np.frombuffer(b''.join(frames), dtype=np.int16)
    return d

framesQueue = queue.Queue()
def framesThreadBody():
    CHUNK = 960
    FORMAT = pyaudio.paInt16
    CHANNELS = 1
    RATE = 48000

    p = pyaudio.PyAudio()
    vad = webrtcvad.Vad()
    vad.set_mode(2)
    stream = p.open(format=FORMAT,
                channels=CHANNELS,
                rate=RATE,
                input=True,
                frames_per_buffer=CHUNK)
    false_counter = 0
    audio_frame = []
    while process:
        data = stream.read(CHUNK)
        if not vad.is_speech(data, RATE):
            false_counter += 1
            if false_counter >= 30:
                if len(audio_frame) > 250:
                    framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
                    false_counter = 0

        if vad.is_speech(data, RATE):
            false_counter = 0
            audio_frame.append(data)
            if len(audio_frame) > 300:
                framesQueue.put(to_queue(audio_frame,timestamp_start))
                audio_frame = []
Es hora de buscar modelos preentrenados de acceso público, vamos a github, hacemos una búsqueda en Google, pero recordemos que tenemos una limitación en la arquitectura utilizada. Esta parte es bastante compleja, ya que es necesario probar modelos con nuestros propios datos de entrada y, además, convertir al formato interno de OpenVINO: IR (Representación Intermedia). Probamos alrededor de 5-7 soluciones diferentes de github, y si el modelo para el reconocimiento de emociones funcionó de inmediato, con el reconocimiento por voz tuvimos que esperar más tiempo, ya que utiliza arquitecturas más complejas.
Nos detenemos en los siguientes:
- Emociones de la voz —
Funciona de la siguiente manera: el audio se corta en fragmentos de tamaño determinado, para cada uno de estos fragmentos extraemos y luego los introducimos en una CNN - Reconocimiento por voz —
Aquí, en lugar de MFCC, trabajamos con espectrogramas; después de la FFT, enviamos la señal a la CNN, donde obtenemos una representación vectorial de la voz.
A continuación, hablaremos sobre la conversión de modelos, comenzaremos con la teoría. OpenVINO incluye varios módulos:
- Open Model Zoo, cuyos modelos pueden ser utilizados e incluidos en su producto
- Model Optimizer, que permite reconvertir un modelo de varios formatos de frameworks (Tensorflow, ONNX, etc.) al formato de Representación Intermedia, con el que trabajaremos a continuación
- Inference Engine permite ejecutar modelos en formato IR en procesadores Intel, chips Myriad y aceleradores Neural Compute Stick.
- La versión más eficiente de OpenCV (con soporte para Inference Engine)
Cada modelo en formato IR se describe mediante dos archivos: .xml y .bin.
Los modelos se convierten al formato IR a través de Model Optimizer de la siguiente manera:python /opt/intel/openvino/deployment_tools/model_optimizer/mo_tf.py --input_model speaker.hdf5.pb --data_type=FP16 --input_shape [1,512,1000,1]--data_typepermite elegir el formato de datos con el que trabajará el modelo. Se admiten FP32, FP16, INT8. Elegir el tipo de datos óptimo puede proporcionar un buen aumento en el rendimiento.
--input_shapeindica la dimensión de los datos de entrada. Parece que la posibilidad de cambiarla dinámicamente está presente en la API de C++, pero no profundizamos tanto y para uno de los modelos simplemente la fijamos.
A continuación, intentaremos cargar el modelo ya convertido en formato IR a través del módulo DNN en OpenCV y hacer un forward sobre él.import cv2 as cv emotionsNet = cv.dnn.readNet('emotions_model.bin', 'emotions_model.xml') emotionsNet.setPreferableTarget(cv.dnn.DNN_TARGET_MYRIAD)La última línea en este caso permite redirigir los cálculos al Neural Compute Stick, los cálculos se realizan básicamente en el procesador, pero en el caso de Raspberry Pi esto no funcionará, se necesitará el stick.
A continuación, la lógica es la siguiente: dividiremos nuestro audio en ventanas de un tamaño determinado (en nuestro caso, 0.4s), cada una de estas ventanas se transformará en MFCC, que luego se enviará a la red:
emotionsNet.setInput(MFCC_from_window)
result = emotionsNet.forward()
Después tomaremos la clase más frecuente de todas las ventanas. Una solución simple, pero para un hackathon no necesitamos inventar algo demasiado complejo, solo si hay tiempo. Todavía tenemos mucho trabajo, así que seguimos adelante — ocupándonos del reconocimiento por voz. Necesitamos hacer una base en la que se almacenen los espectrogramas de voces grabadas previamente. Como queda poco tiempo, resolvemos este asunto como podemos.
En concreto, creamos un script para grabar un segmento de voz (funciona de manera similar a lo descrito arriba, solo que al interrumpir con el teclado guardará la voz en un archivo).
Probamos:
python3 voice_db/record_voice.py test.wavGrabamos las voces de varias personas (en nuestro caso, de tres miembros del equipo)
Luego, para cada voz grabada realizamos una transformada rápida de Fourier, obtenemos el espectrograma y lo guardamos en forma de array de numpy (.npy):for file in glob.glob("voice_db/*.wav"): spec = get_fft_spectrum(file) np.save(file[:-4] + '.npy', spec)Más detalles en el archivo
create_base.py
Como resultado, al ejecutar el script principal, al principio obtendremos embeddings de estos espectrogramas:for file in glob.glob("voice_db/*.npy"): spec = np.load(file) spec = spec.astype('float32') spec_reshaped = spec.reshape(1, 1, spec.shape[0], spec.shape[1]) srNet.setInput(spec_reshaped) pred = srNet.forward() emb = np.squeeze(pred)Después de recibir la incrustación del fragmento de audio, podremos determinar a quién pertenece, tomando la distancia coseno desde el fragmento a todas las voces en la base de datos (cuanto menor, más probable) — para la demostración establecimos un umbral de 0.3):
        dist_list = cdist(emb, enroll_embs, metric="cosine")
        distances = pd.DataFrame(dist_list, columns = df.speaker)
Por último, señalaré que la velocidad de inferencia fue rápida y permitía agregar 1-2 modelos más (para un sample de 7 segundos, la inferencia tardaba 2.5). No tuvimos tiempo de agregar nuevos modelos y nos centramos en la escritura del prototipo de la aplicación web.
Aplicación web
Punto importante: llevamos el router de casa y configuramos nuestra red local, lo que ayuda a conectar el dispositivo y las laptops en la red.
El backend consiste en un canal de mensajes entre el front y Raspberry Pi, basado en la tecnología WebSocket (http sobre protocolo tcp).
La primera etapa consiste en obtener información procesada desde Raspberry, es decir, predicciones empaquetadas en json, que a mitad de su camino se guardan en una base de datos, para que se pueda formar estadísticas sobre el estado emocional del usuario durante un período. Luego, este paquete se envía al frontend, que utiliza suscripción y recepción de paquetes desde el endpoint de WebSocket. Todo el mecanismo del backend está construido en el lenguaje golang, la elección se debió a que se adapta bien a tareas asíncronas, con las que las goroutines se desempeñan bien.
Al acceder al endpoint, el usuario se registra y se incluye en la estructura, luego se recibe su mensaje. Tanto el usuario como el mensaje se registran en un hub general, desde donde los mensajes se envían más adelante (al frontend suscrito), y si el usuario cierra la conexión (ya sea Raspberry o frontend), su suscripción se anula y es eliminado del hub.
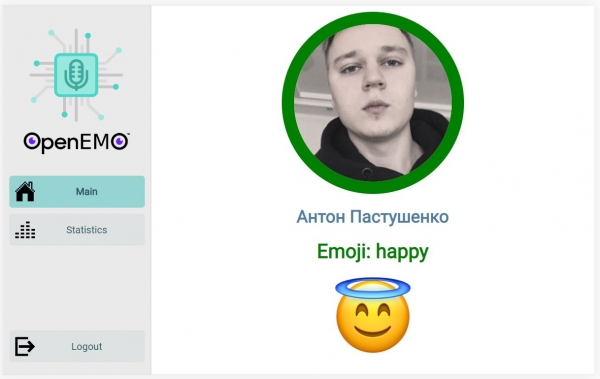
Esperamos conexión con el backendEl front-end es una aplicación web escrita en JavaScript utilizando la biblioteca React para acelerar y simplificar el proceso de desarrollo. El objetivo de esta aplicación es la visualización de datos obtenidos a través de algoritmos ejecutados en el lado del back-end y directamente en Raspberry Pi. La página tiene enrutamiento por secciones, implementado con react-router, pero el principal interés radica en la página principal, donde fluye un continuo torrente de datos del servidor en tiempo real utilizando la tecnología WebSocket. Raspberry Pi detecta la voz, determina a qué persona registrada pertenece y envía una lista de probabilidad al cliente. El cliente muestra los datos más recientes, presenta el avatar de la persona que probablemente habló por el micrófono, así como la emoción con la que pronunció las palabras.

Página principal con predicciones actualizadasConclusión
No conseguimos completar todo lo planeado, simplemente no tuvimos tiempo, por lo que nuestra esperanza principal era la demostración, que todo funcionara. En la presentación se habló sobre cómo todo está organizado, qué modelos se utilizaron y con qué problemas nos encontramos. Luego hubo una parte de la demostración: los expertos recorrían el salón de manera aleatoria y se acercaban a cada equipo para ver el prototipo en funcionamiento. Hicieron preguntas a cada uno de nosotros, y cada uno respondió sobre su parte; dejamos la web en el portátil, y todo realmente funcionaba como se esperaba.
Cabe destacar que el costo total de nuestra solución fue de 150$:
- Raspberry Pi 3 ~ 35$
- Google AIY Voice Bonnet (se puede tomar la placa respeaker) ~ 15$
- Intel NCS 2 ~ 100$
Cómo mejorar:
- Utilizar registro desde el cliente — pedir leer un texto que generamos aleatoriamente
- Agregar algunos modelos más: se puede determinar el género y la edad por la voz
- Separar voces que suenan al mismo tiempo (diarización)
Repositorio:

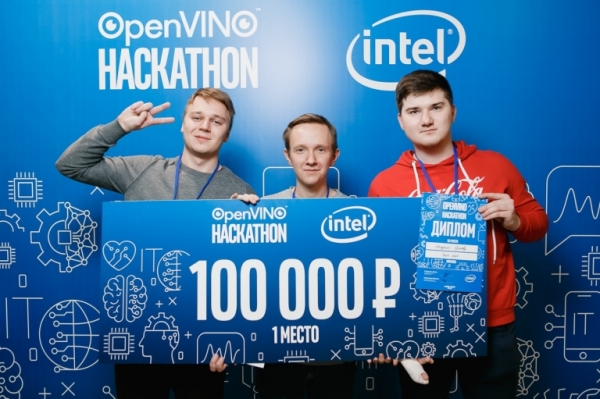
Cansados pero felices estamosPara concluir, quiero agradecer a los organizadores y participantes. De los proyectos de otros equipos, personalmente nos gustó la solución para monitorear lugares de estacionamiento disponibles. Para nosotros fue una experiencia increíblemente genial de inmersión en el producto y desarrollo. Espero que se realicen más eventos interesantes en las regiones, incluidos aquellos relacionados con la IA.
Fuente: habr.com
