

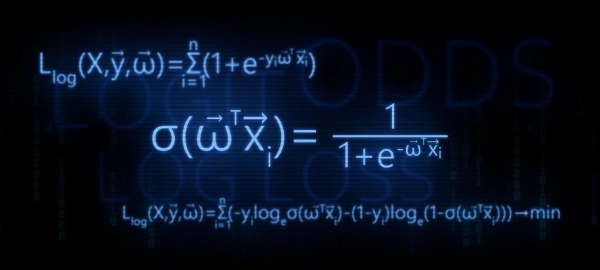
En este artículo, desglosaremos las deducciones teóricas de la transformación de la función de regresión lineal en la función de la transformación logit inversa (también conocida como la función de respuesta logística). Luego, utilizando el arsenal del método de máxima verosimilitud, de acuerdo con el modelo de regresión logística, derivaremos la función de pérdida Logistic Loss, o en otras palabras, definiremos la función a través de la cual se ajustan los parámetros del vector de pesos en el modelo de regresión logística.  .
Plan del artículo:
- Repetiremos sobre la dependencia lineal entre dos variables
- Identificaremos la necesidad de transformar de la función de regresión lineal
 en la función de respuesta logística
- Realizaremos transformaciones y derivaremos la función de respuesta logística
- Intentaremos entender por qué el método de mínimos cuadrados es deficiente al ajustar parámetros. funciones Logistic Loss
- Usamos método de máxima verosimilitud para determinar la función de ajuste de parámetros :
5.1. Caso 1: función Logistic Loss para objetos con etiquetado de clases 0 y 1:
5.2. Caso 2: función Logistic Loss para objetos con etiquetado de clases -1 y +1:
 en la función de respuesta logística

 funciones Logistic Loss
 :


El artículo está lleno de ejemplos sencillos, en los que todos los cálculos se pueden realizar fácilmente de forma oral o en papel; en algunos casos, puede ser necesario un calculador. Así que prepárense 🙂
Este artículo está dirigido en gran medida a científicos de datos con un nivel inicial de conocimiento en los fundamentos del aprendizaje automático.
El artículo también incluirá código para graficar y realizar cálculos. Todo el código está escrito en el lenguaje python 2.7. Antes de continuar, aclararé sobre la "novedad" de la versión utilizada: esta es una de las condiciones para completar un curso conocido de Yandex en una plataforma de educación en línea igualmente reconocida Coursera, y, como se puede suponer, el material se ha preparado basado en este curso.
01. Dependencia lineal
Es razonable preguntarse: ¿qué tiene que ver la dependencia lineal con la regresión logística?
¡Es muy simple! La regresión logística es uno de los modelos que pertenecen a los clasificadores lineales. En términos simples, el objetivo de un clasificador lineal es predecir los valores objetivo  a partir de las variables (regresores)
 . Se considera que la dependencia entre las características
 y los valores objetivo
 lineal. De aquí proviene el nombre del clasificador: lineal. Si se generaliza muy bruscamente, la base del modelo de regresión logística se asienta en la suposición de una dependencia lineal entre las características.
 y los valores objetivo
 . Aquí está la relación.
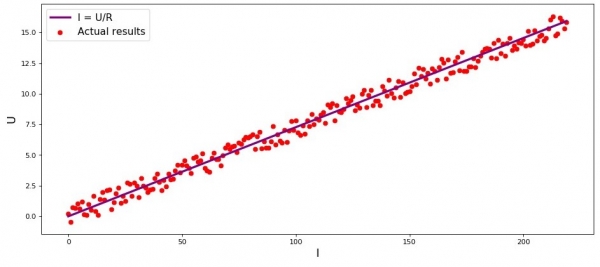
En el estudio, el primer ejemplo trata, como no podría ser de otra manera, sobre la dependencia lineal de las magnitudes investigadas. Al preparar el artículo, me topé con un ejemplo que ya ha sido objeto de discusión entre muchos: la dependencia de la corriente eléctrica respecto a la tensión. ('Análisis de regresión aplicada', N. Draper, G. Smith). Aquí también lo consideraremos.
De acuerdo con la ley de Ohm:
 , donde
 - corriente eléctrica,
 - tensión,
 - resistencia.
Si no supiéramos la ley de Ohm, podríamos encontrar la relación empíricamente, variando  y midiendo
 , manteniendo
 fijo. Entonces, veríamos que el gráfico de la dependencia
 desde
 da una línea más o menos recta que pasa por el origen. Decimos 'más o menos', ya que, aunque la dependencia es efectivamente exacta, nuestras mediciones pueden contener pequeños errores y, por lo tanto, los puntos en el gráfico pueden no caer estrictamente en la línea, sino estar dispersos alrededor de ella de manera aleatoria.
Gráfico 1 'Dependencia  desde
 »
Código para dibujar el gráfico
import matplotlib.pyplot as plt
%matplotlib inline

import numpy as np

import random

R = 13.75

x_line = np.arange(0,220,1)
y_line = []
for i in x_line:
    y_line.append(i/R)

y_dot = []
for i in y_line:
    y_dot.append(i+random.uniform(-0.9,0.9))


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(x_line,y_line,color = 'purple',lw = 3, label = 'I = U/R')
plt.scatter(x_line,y_dot,color = 'red', label = 'Resultados reales')
plt.xlabel('I', size = 16)
plt.ylabel('U', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
02. La necesidad de transformaciones en la ecuación de regresión lineal
Consideremos otro ejemplo. Supongamos que trabajamos en un banco y tenemos la tarea de determinar la probabilidad de que un prestatario devuelva el crédito en función de algunos factores. Para simplificar la tarea, consideremos solo dos factores: el salario mensual del prestatario y la cuota mensual del pago del crédito.
La tarea es muy hipotética, pero con este ejemplo podremos comprender por qué no es suficiente aplicar de la función de regresión lineal, y también descubrir qué transformaciones se requieren en la función.
Regresamos al ejemplo. Se entiende que cuanto mayor sea el salario, más podrá asignar el prestatario mensualmente al pago del crédito. Sin embargo, para un rango específico de salarios, esta dependencia será bastante lineal. Por ejemplo, tomemos un rango de salarios de 60.000 a 200.000 y supongamos que dentro de este rango, la relación entre el tamaño del pago mensual y el salario es lineal. Supongamos que se ha determinado que la proporción entre el salario y el pago no debe caer por debajo de 3 y que al prestatario le deben quedar 5.000. Solo de esta manera consideraremos que el prestatario devolverá el crédito al banco. Entonces, la ecuación de regresión lineal tomará la forma:

donde  ,
 ,
 ,
 — salario
 del prestatario,
 — pago del crédito
 del prestatario.
Al sustituir en la ecuación el salario y el pago del crédito con parámetros fijos  se puede tomar una decisión sobre la aprobación o el rechazo del crédito.
Anticipándonos, señalemos que, con los parámetros dados,  la función de regresión lineal, aplicada en la función de respuesta logística dará valores grandes que dificultarán los cálculos para determinar las probabilidades de pago del crédito. Por lo tanto, se propone reducir nuestros coeficientes, digamos, en 25.000 veces. Esta transformación en los coeficientes no cambiará la decisión sobre la concesión del crédito. Recuerden este punto para el futuro, y ahora, para que sea aún más claro de qué se trata, consideremos la situación con tres prestatarios potenciales.
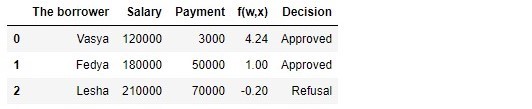
Tabla 1 «Prestatarios potenciales»
Código para generar la tabla
import pandas as pd

r = 25000.0
w_0 = -5000.0/r
w_1 = 1.0/r
w_2 = -3.0/r

data = {'El prestatario':np.array(['Vasya', 'Fedya', 'Lesha']),
        'Salario':np.array([120000,180000,210000]),
       'Pago':np.array([3000,50000,70000])}

df = pd.DataFrame(data)

df['f(w,x)'] = w_0 + df['Salario']*w_1 + df['Pago']*w_2

decision = []
for i in df['f(w,x)']:
    if i > 0:
        dec = 'Aprobado'
        decision.append(dec)
    else:
        dec = 'Rechazo'
        decision.append(dec)

df['Decisión'] = decision

df[['El prestatario', 'Salario', 'Pago', 'f(w,x)', 'Decisión']]
De acuerdo con los datos de la tabla, Vasya, con un salario de 120.000, desea obtener un crédito que pueda pagar mensualmente de 3.000. Hemos determinado que, para la aprobación del crédito, el salario de Vasya debe ser al menos tres veces mayor que el pago, y debe quedar además 5.000. Este requisito lo cumple Vasya:  . Se queda incluso 106.000R. A pesar de que al calcular
 hemos reducido los coeficientes
 en 25.000 veces, el resultado obtenido es el mismo: se puede aprobar el crédito. Fedya también recibirá un crédito, mientras que Alexey, a pesar de ganar más que nadie, tendrá que moderar sus aspiraciones.
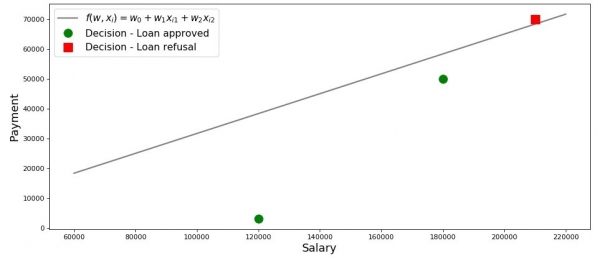
Dibujemos un gráfico para este caso.
Gráfico 2 «Clasificación de prestatarios»
Código para dibujar el gráfico
salary = np.arange(60000,240000,20000)
payment = (-w_0-w_1*salary)/w_2


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(salary, payment, color = 'grey', lw = 2, label = '$f(w,x_i)=w_0 + w_1x_{i1} + w_2x_{i2}$')
plt.plot(df[df['Decision'] == 'Approved']['Salary'], df[df['Decision'] == 'Approved']['Payment'],
         'o', color ='green', markersize = 12, label = 'Decisión - Préstamo aprobado')
plt.plot(df[df['Decision'] == 'Refusal']['Salary'], df[df['Decision'] == 'Refusal']['Payment'],
         's', color = 'red', markersize = 12, label = 'Decisión - Préstamo rechazado')
plt.xlabel('Salario', size = 16)
plt.ylabel('Pago', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
Entonces, nuestra línea, construida de acuerdo con la función  , separa a los prestatarios «malos» de los «buenos». Aquellos prestatarios cuyos deseos no coinciden con sus posibilidades se encuentran por encima de la línea (Alexey), mientras que aquellos que pueden devolver el crédito según los parámetros de nuestro modelo se encuentran por debajo de la línea (Vasya y Fedya). En otras palabras, nuestra línea separa a los prestatarios en dos clases. Denominaremos a la clase
 como aquellos prestatarios que probablemente devolverán el crédito, y a la clase
 o
 como aquellos prestatarios que probablemente no podrán devolver el crédito.
Generalicemos las conclusiones de este ejemplo sencillo. Tomemos un punto  y, al sustituir las coordenadas del punto en la ecuación correspondiente de la línea
 , consideremos tres variantes:
- Si el punto está por debajo de la línea, y lo clasificamos en la clase , entonces el valor de la función será positivo de hasta . Entonces podemos considerar que la probabilidad de reembolso del crédito está en el rango de . Cuanto mayor sea el valor de la función, mayor será la probabilidad.
- Si el punto está por encima de la línea y lo clasificamos en la clase o , entonces el valor de la función será negativo de hasta . En ese caso, consideraremos que la probabilidad de reembolso de la deuda está en el rango de y, cuanto mayor sea el valor absoluto de la función, mayor será nuestra confianza.
- El punto está en la línea, en la frontera entre las dos clases. En tal caso, el valor de la función será igual a y la probabilidad de reembolso del crédito es igual a .
 , entonces el valor de la función
 será positivo de
 hasta
 . Entonces podemos considerar que la probabilidad de reembolso del crédito está en el rango de
 . Cuanto mayor sea el valor de la función, mayor será la probabilidad.
 o
 , entonces el valor de la función será negativo de
 hasta
 . En ese caso, consideraremos que la probabilidad de reembolso de la deuda está en el rango de
 y, cuanto mayor sea el valor absoluto de la función, mayor será nuestra confianza.
 será igual a
 y la probabilidad de reembolso del crédito es igual a
 .
Ahora, imaginemos que tenemos no dos factores, sino decenas, prestatarios no tres, sino miles. Entonces, en lugar de una línea, tendremos m-esimimensional plano y coeficientes  no se van a tomar al azar, sino que serán calculados siguiendo todas las reglas, basándose en los datos acumulados sobre prestatarios que han devuelto o no han devuelto créditos. Y de hecho, noten que estamos seleccionando prestatarios con coeficientes ya conocidos
 . En realidad, la tarea del modelo de regresión logística es precisamente determinar los parámetros
 , en los cuales el valor de la función de pérdida Logistic Loss tiende a ser mínimo. Pero sobre cómo se calcula el vector
 , aún aprenderemos en la sección 5 del artículo. Por ahora, volvamos a la tierra prometida — a nuestro banquero y sus tres clientes.
Gracias a la función  sabemos a quién se puede conceder un crédito y a quién hay que rechazar. Pero con tal información no se puede ir al director, ya que se necesitaba obtener la probabilidad de retorno del crédito de cada prestatario. ¿Qué hacer? La respuesta es simple: necesitamos de alguna manera transformar la función
 , cuyos valores están en el rango
 a una función, cuyos valores estarán en el rango
 . Y existe tal función, se llama función logística o transformación logit inversa. Conozcan:

Veamos paso a paso cómo se obtiene la función logística. Cabe destacar que caminaremos en sentido inverso, es decir, supondremos que conocemos el valor de la probabilidad, que está en el intervalo de  hasta
 y luego 'desenrollaremos' este valor en todo el rango de números de
 hasta
 .
03. Generamos la función logística
Paso 1. Convertimos los valores de probabilidad al rango

Durante la transformación de la función  en la función de respuesta logística
 dejaremos tranquilo a nuestro analista de crédito, y en su lugar caminaremos por las casas de apuestas. No, claro, no haremos apuestas, lo único que nos interesa allá es el sentido de la expresión, por ejemplo, la oportunidad 4 a 1. Las probabilidades, conocidas por todos los jugadores que hacen apuestas, son la proporción de 'éxitos' a 'fracasos'. Desde el punto de vista probabilístico, las odds son la probabilidad de que ocurra el evento, dividida por la probabilidad de que el evento no ocurra. Escribamos la fórmula para la probabilidad de que ocurra el evento
 :

, donde  — la probabilidad de que ocurra el evento,
 — la probabilidad de NO ocurrencia del evento
Por ejemplo, si la probabilidad de que un joven, fuerte y ágil caballo apodado «Viento» supere en una carrera a una anciana vieja y débil llamada «Matilda» es  , entonces las posibilidades de éxito de «Viento» serán
 a

 y viceversa, sabiendo las probabilidades, no será difícil calcular la probabilidad
 :

Así, hemos aprendido a «traducir» la probabilidad en cuotas, que pueden tomar valores desde  hasta
 . Demos un paso más y aprendamos a «traducir» la probabilidad a toda la recta numérica desde
 hasta
 .
Paso 2. Traduciremos los valores de probabilidad en el rango

Este paso es muy simple: aplicaremos el logaritmo de las cuotas en base al número de Euler  y obtendremos:

Ahora sabemos que si  , calcular el valor de
 será muy sencillo y, además, debe ser positivo:
 . Así es.
Por curiosidad, verifiquemos que si  , entonces esperamos ver un valor negativo
 . Verifiquemos:
 . Es correcto.
Ahora sabemos cómo traducir el valor de probabilidad desde  hasta
 a toda la recta numérica desde
 hasta
 . En el siguiente paso haremos todo al revés.
Mientras tanto, notemos que de acuerdo con las reglas de los logaritmos, sabiendo el valor de la función  , se pueden calcular las cuotas:

Este método para determinar las cuotas nos será útil en el siguiente paso.
Paso 3. Derivaremos la fórmula para determinar

Entonces, hemos aprendido a encontrar los valores de la función sabiendo  . Sin embargo, en realidad necesitamos todo al revés: sabiendo el valor
 encontrar
 . Para esto, nos referiremos al concepto de función inversa de las cuotas, de acuerdo con la cual:
 En el artículo no derivaremos la fórmula mencionada anteriormente, pero verificaremos con los números del ejemplo anterior. Sabemos que con cuotas de 4 a 1 (

), la probabilidad de que ocurra el evento es 0.8 ( ). Haremos la sustitución:
 . Esto coincide con nuestros cálculos realizados anteriormente. Sigamos adelante.
 En el paso anterior, derivamos que
, por lo que se puede hacer el reemplazo en la función inversa de las cuotas. Obtendremos:  Dividiremos tanto el numerador como el denominador entre

, entonces:  Por si acaso, para asegurarnos de que no hemos cometido ningún error, haremos otra pequeña verificación. En el paso 2, para

determinamos que  . Entonces, al sustituir el valor
 en la función de respuesta logística, esperamos obtener
 . Sustituyendo y obteniendo:
 .

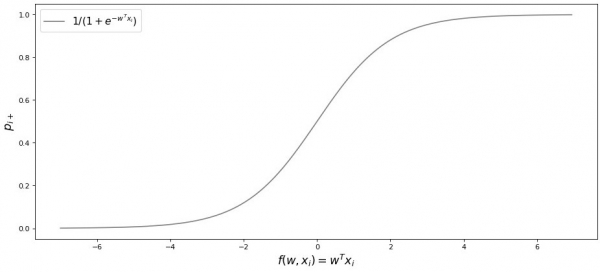
Felicidades, estimado lector, acabamos de desarrollar y probar la función de respuesta logística. Vamos a revisar el gráfico de la función.
Gráfico 3 «Función de respuesta logística»
Código para dibujar el gráfico
import math

def logit (f):
    return 1/(1+math.exp(-f))

f = np.arange(-7,7,0.05)
p = []

for i in f:
    p.append(logit(i))

fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(f, p, color = 'grey', label = '$ 1 / (1+e^{-w^Tx_i})$')
plt.xlabel('$f(w,x_i) = w^Tx_i$', size = 16)
plt.ylabel('$p_{i+}$', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
En la literatura también se puede encontrar esta función llamada función sigmoide. En el gráfico se puede observar claramente que el principal cambio en la probabilidad de que un objeto pertenezca a una clase ocurre en un rango relativamente pequeño  , alrededor de
 hasta
 .
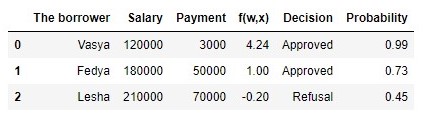
Propongo regresar a nuestro analista crediticio y ayudarlo a calcular la probabilidad de pago de créditos, de lo contrario, corre el riesgo de quedarse sin bonificación 🙂
Tabla 2 «Solicitantes potenciales»
Código para generar la tabla
proba = []
for i in df['f(w,x)']:
    proba.append(round(logit(i),2))

df['Probabilidad'] = proba

df[['El prestatario', 'Salario', 'Pago', 'f(w,x)', 'Decisión', 'Probabilidad']]
Entonces, hemos determinado la probabilidad de recuperación de un crédito. En general, parece ser cierto.
De hecho, la probabilidad de que Vasya, con un salario de 120.000R, pueda devolver al banco 3.000R mensualmente, está cerca del 100%. Por cierto, debemos entender que el banco puede otorgar un crédito a Lesha si la política del banco prevé, por ejemplo, financiar a clientes con una probabilidad de recuperación superior a, digamos, 0.3. Simplemente, en tal caso, el banco formará una reserva mayor para posibles pérdidas.
También es importante señalar que la relación entre salario y pago de al menos 3 y con un margen de 5.000R fue tomada al azar. Por lo tanto, no podíamos utilizar en su forma original el vector de pesos.  . Necesitábamos reducir significativamente los coeficientes y en tal caso dividimos cada coeficiente por 25.000, es decir, en esencia ajustamos el resultado. Pero esto se hizo intencionadamente para facilitar la comprensión del material en la etapa inicial. En la vida real, sin embargo, no debemos inventar y ajustar los coeficientes, sino encontrarlos. Justo en las siguientes secciones del artículo derivaremos las ecuaciones que se utilizan para ajustar los parámetros.
 .
04. Método de los mínimos cuadrados para determinar el vector de pesos en la función de respuesta logística
 en la función de respuesta logística
Ya conocemos dicho método para ajustar el vector de pesos  , como método de los mínimos cuadrados (MNC) Y en realidad, ¿por qué no utilizarlo en tareas de clasificación binaria? De hecho, nada impide usar Mínimos cuadrados, solo que este método en tareas de clasificación da resultados menos precisos que Logistic Loss. Esto tiene una justificación teórica. Primero, veamos un ejemplo sencillo.
Supongamos que nuestros modelos (que utilizan MSE y Logistic Loss) ya han comenzado a ajustar el vector de pesos  y hemos detenido el cálculo en algún paso. No importa si es a la mitad, al final o al principio, lo importante es que ya tenemos algunos valores del vector de pesos y supongamos que en este paso, los vectores de pesos
 para ambos modelos no tienen diferencias. Entonces, tomemos los pesos obtenidos y los sustituimos en la función de respuesta logística (
 ) para algún objeto que pertenece a la clase
 . Examinemos dos casos, cuando de acuerdo con el vector de pesos ajustado, nuestro modelo comete un gran error y, por el contrario, el modelo está muy seguro de que el objeto pertenece a la clase
 . Veamos qué penalizaciones se 'impondrán' al usar Mínimos cuadrados y Logistic Loss.
Código para calcular penalizaciones dependiendo de la función de pérdida utilizada
# класс объекта
y = 1
# вероятность отнесения объекта к классу в соответствии с параметрами w
proba_1 = 0.01

MSE_1 = (y - proba_1)**2
print 'Штраф MSE при грубой ошибке =', MSE_1

# напишем функцию для вычисления f(w,x) при известной вероятности отнесения объекта к классу +1 (f(w,x)=ln(odds+))
def f_w_x(proba):
    return math.log(proba/(1-proba))

LogLoss_1 = math.log(1+math.exp(-y*f_w_x(proba_1)))
print 'Штраф Log Loss при грубой ошибке =', LogLoss_1

proba_2 = 0.99

MSE_2 = (y - proba_2)**2
LogLoss_2 = math.log(1+math.exp(-y*f_w_x(proba_2)))

print '**************************************************************'
print 'Штраф MSE при сильной уверенности =', MSE_2
print 'Штраф Log Loss при сильной уверенности =', LogLoss_2
Caso de un error grave — el modelo clasifica el objeto a la clase  con una probabilidad de 0.01
La penalización al usar Mínimos cuadrados será:

La penalización al usar Logistic Loss será:

Caso de gran confianza — el modelo clasifica el objeto a la clase  con una probabilidad de 0.99
La penalización al usar Mínimos cuadrados será:

La penalización al usar Logistic Loss será:

Este ejemplo ilustra bien que en caso de un gran error, la función de pérdida Log Loss penaliza al modelo significativamente más que MSE. Ahora veamos cuáles son las premisas teóricas para usar la función de pérdida Log Loss en tareas de clasificación.
05. Método de máxima verosimilitud y regresión logística
Como se prometió al principio, el artículo está lleno de ejemplos simples. Aquí otro ejemplo y los viejos conocidos — prestatarios del banco: Vasya, Fedya y Lesha.
Por si acaso, antes de desarrollar el ejemplo, recordaré que en la vida tratamos con un conjunto de entrenamiento de miles o millones de objetos con decenas o cientos de características. Sin embargo, aquí los números se han elegido para que sean fáciles de entender para un principiante en ciencia de datos.
Regresamos al ejemplo. Supongamos que el director del banco decidió otorgar un préstamo a todos los necesitados, a pesar de que el algoritmo sugería no otorgárselo a Alex. Y así pasó el tiempo suficiente y supimos quién de los tres personajes pagó el préstamo y quién no. Como era de esperar: Vasya y Fedya pagaron el préstamo, pero Alex no. Ahora supongamos que este resultado será nuestra nueva muestra de entrenamiento y, al mismo tiempo, parece que hemos perdido todos los datos sobre los factores que influyen en la probabilidad de reembolso del préstamo (el salario del prestatario, la cantidad del pago mensual). Entonces, intuitivamente podemos suponer que uno de cada tres prestatarios no devuelve el préstamo al banco, o, en otras palabras, la probabilidad de que el siguiente prestatario reembolse el préstamo.  . Esta suposición intuitiva tiene un respaldo teórico y se basa en el método de máxima verosimilitud, que a menudo en la literatura se llama el principio de máxima verosimilitud..
Para empezar, familiaricémonos con el aparato conceptual.
La verosimilitud de la muestra es la probabilidad de obtener exactamente esa muestra, de obtener exactamente esas observaciones/resultados, es decir, el producto de las probabilidades de obtener cada uno de los resultados de la muestra (por ejemplo, si el préstamo fue reembolsado o no por Vasya, Fedya y Alex simultáneamente).
La función de verosimilitud conecta la verosimilitud de la muestra con los valores de los parámetros de la distribución.
En nuestro caso, la muestra de entrenamiento representa un esquema generalizado de Bernoulli, en el que la variable aleatoria solo toma dos valores:  o
 . Por lo tanto, la verosimilitud de la muestra se puede escribir como una función de verosimilitud del parámetro
 de la siguiente manera:


La anotación anterior puede interpretarse así. La probabilidad conjunta de que Vasya y Fedya paguen el préstamo es  , la probabilidad de que Alex NO pague el préstamo es
 (ya que efectivamente ocurrió el NO reembolso del préstamo), por lo tanto, la probabilidad conjunta de los tres eventos es
 .
Método de máxima verosimilitud es el método de estimación de un parámetro desconocido mediante la maximización de la función de verosimilitud. En nuestro caso, se requiere encontrar tal valor  , para el cual
 alcance el máximo.
¿Cuál es la idea de buscar el valor de un parámetro desconocido en el que la función de verosimilitud alcanza su máximo? Los orígenes de esta idea provienen de la noción de que la muestra es la única fuente de conocimiento disponible sobre la población completa. Todo lo que sabemos sobre la población está representado en la muestra. Por lo tanto, lo único que podemos afirmar es que la muestra es el reflejo más preciso de la población disponible para nosotros. Así que necesitamos encontrar un parámetro en el que la muestra existente sea la más probable.
Es evidente que estamos tratando con un problema de optimización, en el que debemos encontrar un punto extremo de la función. Para determinar el punto extremo, es necesario considerar la condición de primer orden, es decir, igualar la derivada de la función a cero y resolver la ecuación respecto al parámetro buscado. Sin embargo, encontrar la derivada de un producto de múltiples factores puede resultar en una tarea prolongada, para evitar esto, existe un método especial: el cambio al logaritmo. la función de verosimilitud¿Por qué es posible este cambio? Notemos que no estamos buscando el extremo de la función en sí, sino un punto extremo, es decir, el valor del parámetro desconocido
 , para el cual
 que alcanza su máximo. Al hacer el cambio al logaritmo, el punto extremo no cambia (aunque el extremo mismo será diferente), ya que el logaritmo es una función monótona.
Siguiendo lo anterior, continuemos desarrollando nuestro ejemplo sobre los créditos de Vasya, Fedya y Lesha. Para comenzar, pasemos al logaritmo de la función de verosimilitud.:

Ahora podemos diferenciar la expresión fácilmente con respecto a  :

Y finalmente, consideremos la condición de primer orden: igualaremos la derivada de la función a cero:

Así, nuestra estimación intuitiva de la probabilidad de pago del crédito  ha sido teóricamente justificada.
Genial, pero ¿qué hacemos ahora con esta información? Si asumimos que cada tercer prestatario no devolverá el dinero al banco, este último inevitablemente se arruinará. Así es, pero al evaluar la probabilidad de pago del crédito igual a  no hemos tenido en cuenta los factores que influyen en el regreso del crédito: el salario del prestatario y el monto del pago mensual. Recordemos que anteriormente calculamos la probabilidad de retorno del crédito de cada cliente teniendo en cuenta esos mismos factores. Es lógico que las probabilidades que obtuvimos son diferentes de la constante igual a
 .
definamos la verosimilitud de las muestras:
Código para calcular la verosimilitud de las muestras
from functools import reduce

def likelihood(y,p):
    line_true_proba = []
    for i in range(len(y)):
        ltp_i = p[i]**y[i]*(1-p[i])**(1-y[i])
        line_true_proba.append(ltp_i)
    likelihood = []
    return reduce(lambda a, b: a*b, line_true_proba)


y = [1.0,1.0,0.0]
p_log_response = df['Probability']
const = 2.0/3.0
p_const = [const, const, const]


print 'Verosimilitud de la muestra con valor constante p=2/3:', round(likelihood(y,p_const),3)

print '****************************************************************************************************'

print 'Verosimilitud de la muestra con valor p calculado:', round(likelihood(y,p_log_response),3)
Verosimilitud de la muestra con un valor constante  :

Verosimilitud de la muestra al calcular la probabilidad de pago del crédito teniendo en cuenta los factores  :


La verosimilitud de la muestra con la probabilidad calculada en función de los factores resultó ser mayor que la verosimilitud con un valor constante de probabilidad. ¿Qué significa esto? Significa que el conocimiento de los factores permitió estimar la probabilidad de reembolso del crédito para cada cliente de manera más precisa. Por lo tanto, al otorgar un nuevo crédito, sería más correcto utilizar el modelo que se propone al final de la tercera sección del artículo para evaluar la probabilidad de reembolso de la deuda.
Pero entonces, si necesitamos maximizar la función de verosimilitud de la muestra, ¿por qué no usar algún algoritmo que proporcione probabilidades para Vasya, Fedya y Lesha, por ejemplo, iguales a 0.99, 0.99 y 0.01 respectivamente? Es posible que tal algoritmo funcione bien en el conjunto de entrenamiento, ya que acercaría el valor de la verosimilitud de la muestra a  , pero, en primer lugar, es probable que este algoritmo tenga dificultades con la capacidad de generalización; en segundo lugar, este algoritmo definitivamente no será lineal. Y si los métodos para combatir el sobreajuste (lo que equivale a una débil capacidad de generalización) claramente no forman parte del plan de este artículo, entonces abordemos el segundo punto con más detalle. Para ello, basta con responder a una pregunta sencilla. ¿Puede la probabilidad de que Vasya y Fedya paguen el crédito ser la misma considerando los factores que conocemos? Desde el sentido común, por supuesto que no; no puede ser. Así, Vasya destinará el 2.5% de su salario al pago del crédito cada mes, mientras que Fedya casi el 27.8%. Además, en el gráfico 2 'Clasificación de clientes' vemos que Vasya está significativamente más lejos de la línea que separa las clases que Fedya. Y, por último, sabemos que la función
 para Vasya y Fedya toma valores diferentes: 4.24 para Vasya y 1.0 para Fedya. Si Fedya, por ejemplo, ganara un orden de magnitud más, o pidiera un crédito más pequeño, entonces las probabilidades de pago del crédito de Vasya y Fedya serían similares. En otras palabras, no se puede engañar a la dependencia lineal. Y si realmente hubiéramos calculado los coeficientes
 , y no los hubiéramos tomado al azar, podríamos afirmar con confianza que nuestros valores
 son los mejores para evaluar la probabilidad de pago del crédito de cada prestatario, pero dado que hemos acordado considerar que la determinación de los coeficientes
 se llevó a cabo de acuerdo con todas las reglas, así lo asumiremos: nuestros coeficientes permiten proporcionar la mejor estimación de la probabilidad 🙂
Sin embargo, nos hemos desviado. En esta sección necesitamos averiguar cómo se determina el vector de pesos  , que se requiere para evaluar la probabilidad de reembolso del crédito de cada prestatario.
Resumiendo brevemente, con qué arsenal nos presentamos en la búsqueda de coeficientes  :
1. Supongamos que la relación entre la variable objetivo (el valor pronosticado) y el factor que influye en el resultado es lineal. Por esta razón se aplica la función de regresión lineal del tipo  , cuya línea divide los objetos (clientes) en clases
 y
 o
 (clientes capaces de pagar un crédito y no capaces). En nuestro caso, la ecuación tiene la forma
 .
2. Utilizamos la función de transformación logit inversa del tipo  para determinar la probabilidad de que un objeto pertenezca a una clase
 .
3. Consideramos nuestra muestra de entrenamiento como una realización de una generalización. esquemas de Bernoulli, es decir, para cada objeto se genera una variable aleatoria que con una probabilidad  (propia para cada objeto) toma el valor 1 y con una probabilidad
 – 0.
4. Sabemos que necesitamos maximizar la función de verosimilitud de la muestra teniendo en cuenta los factores aceptados para que la muestra existente sea la más verosímil. En otras palabras, necesitamos ajustar tales parámetros en los que la muestra sea la más verosímil. En nuestro caso, el parámetro ajustado es la probabilidad de concesión de un crédito  , que a su vez depende de coeficientes desconocidos
 . Entonces, necesitamos encontrar tal vector de pesos
 , en el que la verosimilitud de la muestra sea máxima.
5. Sabemos que para maximizar la función de verosimilitud de la muestra puede usar método de máxima verosimilitud. Y conocemos todos los trucos astutos para trabajar con este método.
Así que se obtiene este juego de pasos 🙂
Y ahora recordemos que al principio del artículo queríamos derivar dos tipos de función de pérdida Logistic Loss dependiendo de cómo se designan las clases de objetos. Es habitual que en las tareas de clasificación con dos clases, las clases se designen como  y
 o
 . Dependiendo de la designación, la función de pérdida correspondiente estará en la salida.
Caso 1. Clasificación de objetos en y
 y

Anteriormente, al determinar la verosimilitud de la muestra, en la que la probabilidad de incumplimiento del prestatario se calculó en función de factores y coeficientes dados  , aplicamos la fórmula:

En realidad  — es el valor de la función de respuesta logística
 para un vector de pesos dado

Entonces no hay nada que nos impida escribir la función de verosimilitud de la muestra así:

A veces sucede que a algunos analistas novatos les resulta difícil entender de inmediato cómo funciona esta función. Vamos a considerar 4 ejemplos cortos que aclaran todo:
1. Si  (es decir, de acuerdo con la muestra de entrenamiento, el objeto pertenece a la clase +1), y nuestro algoritmo
 determina la probabilidad de que el objeto pertenezca a la clase
 igual a 0.9, entonces este fragmento de verosimilitud de la muestra se calculará así:

2. Si  , y
 , entonces el cálculo será así:

3. Si  , y
 , entonces el cálculo será así:

4. Si  , y
 , entonces el cálculo será así:

Es evidente que la función de verosimilitud se maximizará en los casos 1 y 3 o en general, en el caso de valores de probabilidad de pertenencia correcta del objeto a la clase  .
Dado que al determinar la probabilidad de que un objeto pertenezca a una clase  solo desconocemos los coeficientes
 , y los buscaremos. Como se mencionó anteriormente, esta es una tarea de optimización en la que primero necesitamos encontrar la derivada de la función de verosimilitud con respecto al vector de pesos
 . Sin embargo, es conveniente simplificar la tarea: buscaremos la derivada del logaritmo la función de verosimilitud.

¿Por qué después de aplicar el logaritmo, en la función de error logístico, cambiamos el signo de  en
 . Es simple, dado que en las tareas de evaluación de la calidad del modelo se tiende a minimizar el valor de la función, multiplicamos el lado derecho de la expresión por
 y, por lo tanto, en lugar de maximizar, ahora minimizamos la función.
De hecho, ahora, ante sus ojos, hemos deducido de manera bastante trabajosa la función de pérdida — Logistic Loss para un conjunto de entrenamiento con dos clases:  y
 .
Ahora, para encontrar los coeficientes, solo necesitamos encontrar la derivada la función de error logístico y, a continuación, utilizando métodos numéricos de optimización, como el descenso de gradiente o el descenso de gradiente estocástico, ajustar los coeficientes más óptimos  . Pero, dado el considerable tamaño del artículo, se sugiere realizar la diferenciación de forma independiente o, tal vez, esto será el tema de un próximo artículo con más aritmética y sin ejemplos tan detallados.
Caso 2. Clasificación de objetos en y
 y

El enfoque aquí será el mismo que con las clases  y
 , pero el camino hacia la deducción de la función de pérdida Logistic Loss, será más complejo. Comencemos. Para la función de verosimilitud utilizaremos el operador «si…, entonces…». Es decir, si
 el objeto -es pertenece a la clase
 , entonces para calcular la verosimilitud de la muestra utilizamos la probabilidad
 , si el objeto pertenece a la clase
 , entonces insertamos en la verosimilitud
 . Así es como se ve la función de verosimilitud:

Desglosémoslo en términos simples y veamos cómo funciona. Consideremos 4 casos:
1. Si  y
 , entonces en la verosimilitud de la muestra «se basará»

2. Si  y
 , entonces en la verosimilitud de la muestra «se basará»

3. Si  y
 , entonces en la verosimilitud de la muestra «se basará»

4. Si  y
 , entonces en la verosimilitud de la muestra «se basará»

Es evidente que en el caso 1 y 3, cuando las probabilidades fueron correctamente determinadas por el algoritmo, la función de verosimilitud se maximizará, es precisamente lo que deseábamos obtener. Sin embargo, este enfoque es bastante engorroso, y a continuación veremos una formulación más compacta. Pero primero, logaritmizamos la función de verosimilitud cambiando el signo, ya que ahora vamos a minimizarla.

Sustituyamos en lugar de  la expresión
 :

Simplificaremos el término derecho bajo el logaritmo utilizando técnicas aritméticas simples y obtendremos:

Y ahora es el momento de deshacerse del operador «si…, entonces…». Observamos que cuando un objeto  pertenece a la clase
 , en la expresión bajo el logaritmo, en el denominador,
 se eleva a la potencia
 , si el objeto pertenece a la clase
 , entonces $e$ se eleva a la potencia
 . Por lo tanto, se puede simplificar la notación de la potencia, combinando ambos casos en uno solo:
 . Entonces la función de error logístico tomará la siguiente forma:

De acuerdo con las reglas de los logaritmos, invertiremos la fracción y sacaremos el signo " " (menos) fuera del logaritmo, obtendremos:

Ante ustedes, la función de pérdidas logistic Loss, que se aplica en el conjunto de entrenamiento con objetos que pertenecen a las clases:  y
 .
Bueno, en este punto me despido y concluimos el artículo.
El trabajo anterior del autor — «Llevamos la ecuación de regresión lineal a forma matricial»
Material de apoyo
1. Literatura
1) Análisis regresional aplicado / N. Draper, G. Smith – 2ª ed. – Moscú: Finanzas y Estadísticas, 1986 (traducción del inglés)
2) Teoría de probabilidades y estadística matemática / V.E. Gmurman — 9ª ed. — Moscú: Escuela Superior, 2003
3) Teoría de probabilidades / N.I. Chernova — Novosibirsk: Universidad Estatal de Novosibirsk, 2007
4) Analítica de negocios: de datos a conocimiento / Paklin N.B., Oreshkov V.I. — 2ª ed. — San Petersburgo: Peter, 2013
5) Ciencia de los Datos desde cero / Joel Gras — San Petersburgo: BKHV Petersburgo, 2017
6) Estadística práctica para especialistas en Ciencia de Datos / P. Bruce, E. Bruce — San Petersburgo: BKHV Petersburgo, 2018
2. Lecciones, cursos (video)
1)
2)
3)
4)
5)
3. Fuentes de internet
1)
2)
3)
4)
5)
6)
7)
8)
Fuente: habr.com
