

¡Hola, Habr!
En otoño del año pasado, se llevó a cabo en Kaggle un concurso de clasificación de dibujos hechos a mano llamado Quick Draw Doodle Recognition, en el que participó, entre otros, un equipo de R en la composición de , y . No vamos a describir detalladamente la competencia, eso ya se ha hecho en .
. Aunque no conseguimos medallas esta vez, obtuvimos mucha experiencia valiosa, por lo que quisiéramos compartir con la comunidad algunos de los temas más interesantes y útiles en Kaggle y en el trabajo cotidiano. Entre los temas considerados: la dura vida sin OpenCV, el parsing de JSON (en estos ejemplos se estudia la integración de código en C++ en scripts o paquetes en R mediante Rcpp), parametrización de scripts y dockerización de la solución final. Todo el código del mensaje está disponible en un formato ejecutable en .
Contenido:
1. Carga eficiente de datos desde CSV a la base de datos MonetDB
Los datos en esta competición no se proporcionan en forma de imágenes listas, sino en 340 archivos CSV (uno por cada clase), que contienen JSON con las coordenadas de los puntos. Conectando estos puntos con líneas, obtenemos la imagen final de 256x256 píxeles. También para cada registro se incluye una etiqueta que indica si la imagen fue correctamente reconocida por el clasificador utilizado en el momento de la recopilación del conjunto de datos, un código de dos letras del país de residencia del autor del dibujo, un identificador único, una marca de tiempo y el nombre de la clase, que coincide con el nombre del archivo. La versión simplificada de los datos originales pesa 7.4 GB en el archivo y aproximadamente 20 GB después de descomprimir, los datos completos ocupan 240 GB después de descomprimir. Los organizadores garantizaron que ambas versiones reproducen los mismos dibujos, es decir, la versión completa es redundante. En cualquier caso, almacenar 50 millones de imágenes en archivos gráficos o en forma de matrices se reconoció inmediatamente como poco rentable, y decidimos integrar todos los archivos CSV del archivo train_simplified.zip en la base de datos con la posterior generación de imágenes del tamaño necesario "sobre la marcha" para cada lote.
Como sistema de gestión de bases de datos, se eligió MonetDB, que ha demostrado ser eficaz MonetDB, en particular la implementación para R en forma de paquete . El paquete incluye una versión embebida del servidor de base de datos y permite iniciar el servidor directamente desde la sesión R y trabajar con él allí mismo. La creación de la base de datos y la conexión a ella se realizan con un solo comando:
con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))Necesitaremos crear dos tablas: una para todos los datos y otra para la información administrativa sobre los archivos cargados (útil en caso de que algo salga mal y el proceso deba reanudarse después de cargar varios archivos):
Creación de tablas
if (!DBI::dbExistsTable(con, "doodles")) {
  DBI::dbCreateTable(
    con = con,
    name = "doodles",
    fields = c(
      "countrycode" = "char(2)",
      "drawing" = "text",
      "key_id" = "bigint",
      "recognized" = "bool",
      "timestamp" = "timestamp",
      "word" = "text"
    )
  )
}

if (!DBI::dbExistsTable(con, "upload_log")) {
  DBI::dbCreateTable(
    con = con,
    name = "upload_log",
    fields = c(
      "id" = "serial",
      "file_name" = "text UNIQUE",
      "uploaded" = "bool DEFAULT false"
    )
  )
}
El método más rápido para cargar datos en la base de datos resultó ser la copia directa de archivos CSV mediante SQL — el comando COPY OFFSET 2 INTO tablename FROM path USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT, donde tablename — nombre de la tabla y path — ruta al archivo. Al trabajar con el archivo zip, se descubrió que la implementación embebida unzip en R no funciona correctamente con varios archivos del archivo, por lo que utilizamos el sistema unzip (con el parámetro getOption("unzip")).
Función para escribir en la base de datos
#' @title Извлечение и загрузка файлов
#'
#' @description
#' Извлечение CSV-файлов из ZIP-архива и загрузка их в базу данных
#'
#' @param con Объект подключения к базе данных (класс `MonetDBEmbeddedConnection`).
#' @param tablename Название таблицы в базе данных.
#' @oaram zipfile Путь к ZIP-архиву.
#' @oaram filename Имя файла внури ZIP-архива.
#' @param preprocess Функция предобработки, которая будет применена извлечённому файлу.
#'   Должна принимать один аргумент `data` (объект `data.table`).
#'
#' @return `TRUE`.
#'
upload_file <- function(con, tablename, zipfile, filename, preprocess = NULL) {
  # Проверка аргументов
  checkmate::assert_class(con, "MonetDBEmbeddedConnection")
  checkmate::assert_string(tablename)
  checkmate::assert_string(filename)
  checkmate::assert_true(DBI::dbExistsTable(con, tablename))
  checkmate::assert_file_exists(zipfile, access = "r", extension = "zip")
  checkmate::assert_function(preprocess, args = c("data"), null.ok = TRUE)

  # Извлечение файла
  path <- file.path(tempdir(), filename)
  unzip(zipfile, files = filename, exdir = tempdir(),
        junkpaths = TRUE, unzip = getOption("unzip"))
  on.exit(unlink(file.path(path)))

  # Применяем функция предобработки
  if (!is.null(preprocess)) {
    .data <- data.table::fread(file = path)
    .data <- preprocess(data = .data)
    data.table::fwrite(x = .data, file = path, append = FALSE)
    rm(.data)
  }

  # Запрос к БД на импорт CSV
  sql <- sprintf(
    "COPY OFFSET 2 INTO %s FROM '%s' USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT",
    tablename, path
  )
  # Выполнение запроса к БД
  DBI::dbExecute(con, sql)

  # Добавление записи об успешной загрузке в служебную таблицу
  DBI::dbExecute(con, sprintf("INSERT INTO upload_log(file_name, uploaded) VALUES('%s', true)",
                              filename))

  return(invisible(TRUE))
}
En caso de que sea necesario transformar la tabla antes de escribir en la base de datos, es suficiente con pasar como argumento preprocess una función que transformará los datos.
Código para la carga secuencial de datos en la base de datos:
Escritura de datos en la base de datos
# Список файлов для записи
files <- unzip(zipfile, list = TRUE)$Name

# Список исключений, если часть файлов уже была загружена
to_skip <- DBI::dbGetQuery(con, "SELECT file_name FROM upload_log")[[1L]]
files <- setdiff(files, to_skip)

if (length(files) > 0L) {
  # Запускаем таймер
  tictoc::tic()
  # Прогресс бар
  pb <- txtProgressBar(min = 0L, max = length(files), style = 3)
  for (i in seq_along(files)) {
    upload_file(con = con, tablename = "doodles",
                zipfile = zipfile, filename = files[i])
    setTxtProgressBar(pb, i)
  }
  close(pb)
  # Останавливаем таймер
  tictoc::toc()
}

# 526.141 sec elapsed - копирование SSD->SSD
# 558.879 sec elapsed - копирование USB->SSD
El tiempo de carga de datos puede variar dependiendo de las características de velocidad del medio de almacenamiento utilizado. En nuestro caso, la lectura y escritura dentro de un mismo SSD o desde una memoria USB (archivo fuente) a SSD (base de datos) toma menos de 10 minutos.
Se requieren unos segundos adicionales para crear la columna con la etiqueta de clase entera y la columna de índice (ORDERED INDEX) con los números de línea, por el cual se realizarán las selecciones de observaciones al crear los lotes:
Creación de columnas adicionales e índice
message("Generar etiquetas")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD label_int int"))
invisible(DBI::dbExecute(con, "UPDATE doodles SET label_int = dense_rank() OVER (ORDER BY word) - 1"))

message("Generar números de fila")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD id serial"))
invisible(DBI::dbExecute(con, "CREATE ORDERED INDEX doodles_id_ord_idx ON doodles(id)"))
Para abordar la tarea de generar un lote "sobre la marcha", necesitábamos lograr la máxima velocidad en la extracción de filas aleatorias de la tabla. doodles. Para ello, utilizamos 3 trucos. El primero consistió en reducir la dimensionalidad del tipo en el que se almacenaba el ID de la observación. En el conjunto de datos original, se requiere el tipo bigint, pero la cantidad de observaciones permite almacenar sus identificadores, que son números de orden, en el tipo int. La búsqueda, por tanto, es considerablemente más rápida. El segundo truco consistió en el uso de ORDERED INDEX — esta solución fue encontrada empíricamente, probando todas las . El tercero fue utilizar consultas parametrizadas. La esencia del método radica en la ejecución única del comando PREPARE y el uso posterior de la expresión preparada al crear un montón de consultas similares, aunque en la práctica, la ganancia en comparación con una simple SELECCIONAR resultó estar en el rango de error estadístico.
El proceso de carga de datos consume no más de 450 MB de RAM. Es decir, el enfoque descrito permite manejar conjuntos de datos de decenas de gigabytes prácticamente en cualquier hardware asequible, incluyendo algunas placas de un solo chip, lo cual es bastante impresionante.
Queda realizar mediciones de la velocidad de extracción de datos (aleatorios) y evaluar la escalabilidad al muestrear lotes de diferentes tamaños:
Benchmark de la base de datos
library(ggplot2)

set.seed(0)
# Conexión a la base de datos
con <- DBI::dbConnect(MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

# Función para preparar la consulta del lado del servidor
prep_sql <- function(batch_size) {
  sql <- sprintf("PREPARE SELECT id FROM doodles WHERE id IN (%s)",
                 paste(rep("?", batch_size), collapse = ","))
  res <- DBI::dbSendQuery(con, sql)
  return(res)
}

# Función para extraer datos
fetch_data <- function(rs, batch_size) {
  ids <- sample(seq_len(n), batch_size)
  res <- DBI::dbFetch(DBI::dbBind(rs, as.list(ids)))
  return(res)
}

# Realizando la medición
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    rs <- prep_sql(batch_size)
    bench::mark(
      fetch_data(rs, batch_size),
      min_iterations = 50L
    )
  }
)
# Parámetros del benchmark
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16   23.6ms  54.02ms  93.43ms     18.8        2.6s    49
# 2         32     38ms  84.83ms 151.55ms     11.4       4.29s    49
# 3         64   63.3ms 175.54ms 248.94ms     5.85       8.54s    50
# 4        128   83.2ms 341.52ms 496.24ms     3.00      16.69s    50
# 5        256  232.8ms 653.21ms 847.44ms     1.58      31.66s    50
# 6        512  784.6ms    1.41s    1.98s     0.740       1.1m    49
# 7       1024  681.7ms    2.72s    4.06s     0.377      2.16m    49

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
  geom_point() +
  geom_line() +
  ylab("tiempo mediano, s") +
  theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 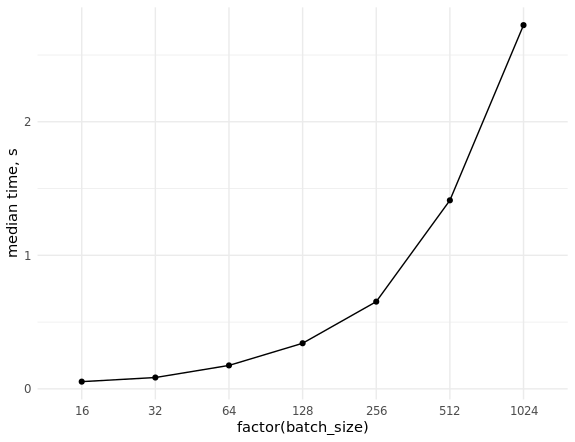
2. Preparación de lotes
Todo el proceso de preparación de lotes consta de las siguientes etapas:
- Parseo de múltiples JSON que contienen vectores de cadenas con las coordenadas de puntos.
- Dibujo de líneas de colores según las coordenadas de los puntos en una imagen del tamaño adecuado (por ejemplo, 256×256 o 128×128).
- Conversión de las imágenes obtenidas a un tensor.
En el marco de la competencia entre kernels en Python, la tarea se resolvió principalmente con herramientas OpenCV. Uno de los análogos más simples y evidentes en R sería el siguiente:
Implementación de la conversión de JSON a tensor en R
r_process_json_str <- function(json, line.width = 3,
                               color = TRUE, scale = 1) {
  # Análisis de JSON
  coords <- jsonlite::fromJSON(json, simplifyMatrix = FALSE)
  tmp <- tempfile()
  # Eliminamos el archivo temporal al finalizar la función
  on.exit(unlink(tmp))
  png(filename = tmp, width = 256 * scale, height = 256 * scale, pointsize = 1)
  # Gráfico vacío
  plot.new()
  # Tamaño de la ventana del gráfico
  plot.window(xlim = c(256 * scale, 0), ylim = c(256 * scale, 0))
  # Colores de las líneas
  cols <- if (color) rainbow(length(coords)) else "#000000"
  for (i in seq_along(coords)) {
    lines(x = coords[[i]][[1]] * scale, y = coords[[i]][[2]] * scale,
          col = cols[i], lwd = line.width)
  }
  dev.off()
  # Conversión de la imagen a un array tridimensional
  res <- png::readPNG(tmp)
  return(res)
}

r_process_json_vector <- function(x, ...) {
  res <- lapply(x, r_process_json_str, ...)
  # Uniendo arrays tridimensionales de imágenes en un cuatridimensional en tensor
  res <- do.call(abind::abind, c(res, along = 0))
  return(res)
}
El dibujo se realiza utilizando las herramientas estándar de R, guardando en un PNG temporal que se almacena en la RAM (en Linux, los directorios temporales de R están en el directorio /tmp, montado en la RAM). Luego, este archivo se lee como un array tridimensional con números en el rango de 0 a 1. Esto es importante, ya que un BMP más común se leería en un array raw con códigos hexadecimales de colores.
Probemos el resultado:
zip_file <- file.path("data", "train_simplified.zip")
csv_file <- "cat.csv"
unzip(zip_file, files = csv_file, exdir = tempdir(),
      junkpaths = TRUE, unzip = getOption("unzip"))
tmp_data <- data.table::fread(file.path(tempdir(), csv_file), sep = ",",
                              select = "drawing", nrows = 10000)
arr <- r_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 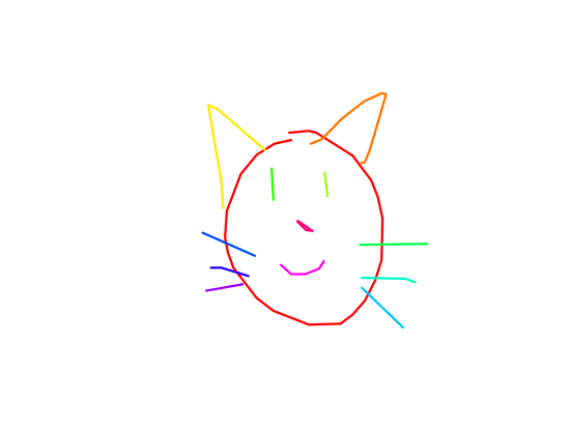
El lote se formará de la siguiente manera:
res <- r_process_json_vector(tmp_data[1:4, drawing], scale = 0.5)
str(res)
 # num [1:4, 1:128, 1:128, 1:3] 1 1 1 1 1 1 1 1 1 1 ...
 # - attr(*, "dimnames")=List of 4
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
Esta implementación nos pareció subóptima, ya que la formación de lotes grandes toma un tiempo excesivo, y decidimos aprender de la experiencia de colegas, utilizando una potente biblioteca OpenCV. En ese momento, no había un paquete disponible para R (y no hay uno ahora), por lo que se escribió una implementación mínima del funcionalismo requerido en C++ con integración en el código R usando Rcpp.
Para resolver el problema, se utilizaron los siguientes paquetes y bibliotecas:
OpenCV para manipulación de imágenes y dibujo de líneas. Se utilizaron bibliotecas del sistema preinstaladas y archivos de encabezado, así como la vinculación dinámica.
xtensor para trabajar con arreglos multidimensionales y tensores. Se utilizaron los archivos de encabezado incluidos en el paquete R del mismo nombre. La biblioteca permite trabajar con arreglos multidimensionales, tanto en orden de fila como en orden de columna.
ndjson para analizar JSON. Esta biblioteca se utiliza en xtensor automáticamente si está disponible en el proyecto.
RcppThread para organizar el procesamiento multihilo de vectores a partir de JSON. Se utilizaron los archivos de encabezado proporcionados por este paquete. De más popular RcppParallel el paquete, entre otras cosas, se distingue por tener un mecanismo incorporado para interrumpir ciclos (interrupt).
Cabe mencionar que xtensor resultó ser un hallazgo: además de tener una funcionalidad amplia y un alto rendimiento, sus desarrolladores fueron bastante receptivos y respondieron de manera rápida y detallada a las preguntas planteadas. Con su ayuda, se logró implementar transformaciones de matrices OpenCV en tensores xtensor, así como una forma de combinar tensores de imágenes en 3D en un tensor de 4 dimensiones de tamaño correcto (esencialmente un lote).
Materiales para el estudio de Rcpp, xtensor y RcppThread
Para compilar archivos que utilizan archivos del sistema y vinculación dinámica con bibliotecas instaladas en el sistema, utilizamos el mecanismo de complementos implementado en el paquete Rcpp. Para encontrar rutas y banderas automáticamente, utilizamos la popular utilidad de linux pkg-config.
Implementación de un complemento Rcpp para usar la biblioteca OpenCV
Rcpp::registerPlugin("opencv", function() {
  # Nombres posibles del paquete
  pkg_config_name <- c("opencv", "opencv4")
  # Archivo binario de la utilidad pkg-config
  pkg_config_bin <- Sys.which("pkg-config")
  # Verificación de la disponibilidad de la utilidad en el sistema
  checkmate::assert_file_exists(pkg_config_bin, access = "x")
  # Verificación de la existencia del archivo de configuración de OpenCV para pkg-config
  check <- sapply(pkg_config_name,
                  function(pkg) system(paste(pkg_config_bin, pkg)))
  if (all(check != 0)) {
    stop("Configuración de OpenCV para pkg-config no encontrada", call. = FALSE)
  }

  pkg_config_name <- pkg_config_name[check == 0]
  list(env = list(
    PKG_CXXFLAGS = system(paste(pkg_config_bin, "--cflags", pkg_config_name),
                          intern = TRUE),
    PKG_LIBS = system(paste(pkg_config_bin, "--libs", pkg_config_name),
                      intern = TRUE)
  ))
})
Como resultado del funcionamiento del complemento durante el proceso de compilación, se insertarán los siguientes valores:
Rcpp:::.plugins$opencv()$env

# $PKG_CXXFLAGS
# [1] "-I/usr/include/opencv"
#
# $PKG_LIBS
# [1] "-lopencv_shape -lopencv_stitching -lopencv_superres -lopencv_videostab -lopencv_aruco -lopencv_bgsegm -lopencv_bioinspired -lopencv_ccalib -lopencv_datasets -lopencv_dpm -lopencv_face -lopencv_freetype -lopencv_fuzzy -lopencv_hdf -lopencv_line_descriptor -lopencv_optflow -lopencv_video -lopencv_plot -lopencv_reg -lopencv_saliency -lopencv_stereo -lopencv_structured_light -lopencv_phase_unwrapping -lopencv_rgbd -lopencv_viz -lopencv_surface_matching -lopencv_text -lopencv_ximgproc -lopencv_calib3d -lopencv_features2d -lopencv_flann -lopencv_xobjdetect -lopencv_objdetect -lopencv_ml -lopencv_xphoto -lopencv_highgui -lopencv_videoio -lopencv_imgcodecs -lopencv_photo -lopencv_imgproc -lopencv_core"
El código para la implementación del parsing de JSON y la formación de un lote para la transmisión al modelo se encuentra en el spoiler. Primero, agregamos el directorio local del proyecto para la búsqueda de archivos de cabecera (necesario para ndjson):
Sys.setenv("PKG_CXXFLAGS" = paste0("-I", normalizePath(file.path("src"))))Implementación de la transformación de JSON a tensor en C++
// [[Rcpp::plugins(cpp14)]]
// [[Rcpp::plugins(opencv)]]
// [[Rcpp::depends(xtensor)]]
// [[Rcpp::depends(RcppThread)]]

#include <xtensor/xjson.hpp>
#include <xtensor/xadapt.hpp>
#include <xtensor/xview.hpp>
#include <xtensor-r/rtensor.hpp>
#include <opencv2/core/core.hpp>
#include <opencv2/highgui/highgui.hpp>
#include <opencv2/imgproc/imgproc.hpp>
#include <Rcpp.h>
#include <RcppThread.h>

// Синонимы для типов
using RcppThread::parallelFor;
using json = nlohmann::json;
using points = xt::xtensor<double,2>;     // Извлечённые из JSON координаты точек
using strokes = std::vector<points>;      // Извлечённые из JSON координаты точек
using xtensor3d = xt::xtensor<double, 3>; // Тензор для хранения матрицы изоображения
using xtensor4d = xt::xtensor<double, 4>; // Тензор для хранения множества изображений
using rtensor3d = xt::rtensor<double, 3>; // Обёртка для экспорта в R
using rtensor4d = xt::rtensor<double, 4>; // Обёртка для экспорта в R

// Статические константы
// Размер изображения в пикселях
const static int SIZE = 256;
// Тип линии
// См. https://en.wikipedia.org/wiki/Pixel_connectivity#2-dimensional
const static int LINE_TYPE = cv::LINE_4;
// Толщина линии в пикселях
const static int LINE_WIDTH = 3;
// Алгоритм ресайза
// https://docs.opencv.org/3.1.0/da/d54/group__imgproc__transform.html#ga5bb5a1fea74ea38e1a5445ca803ff121
const static int RESIZE_TYPE = cv::INTER_LINEAR;

// Шаблон для конвертирования OpenCV-матрицы в тензор
template <typename T, int NCH, typename XT=xt::xtensor<T,3,xt::layout_type::column_major>>
XT to_xt(const cv::Mat_<cv::Vec<T, NCH>>& src) {
  // Размерность целевого тензора
  std::vector<int> shape = {src.rows, src.cols, NCH};
  // Общее количество элементов в массиве
  size_t size = src.total() * NCH;
  // Преобразование cv::Mat в xt::xtensor
  XT res = xt::adapt((T*) src.data, size, xt::no_ownership(), shape);
  return res;
}

// Преобразование JSON в список координат точек
strokes parse_json(const std::string& x) {
  auto j = json::parse(x);
  // Результат парсинга должен быть массивом
  if (!j.is_array()) {
    throw std::runtime_error("'x' must be JSON array.");
  }
  strokes res;
  res.reserve(j.size());
  for (const auto& a: j) {
    // Каждый элемент массива должен быть 2-мерным массивом
    if (!a.is_array() || a.size() != 2) {
      throw std::runtime_error("'x' must include only 2d arrays.");
    }
    // Извлечение вектора точек
    auto p = a.get<points>();
    res.push_back(p);
  }
  return res;
}

// Отрисовка линий
// Цвета HSV
cv::Mat ocv_draw_lines(const strokes& x, bool color = true) {
  // Исходный тип матрицы
  auto stype = color ? CV_8UC3 : CV_8UC1;
  // Итоговый тип матрицы
  auto dtype = color ? CV_32FC3 : CV_32FC1;
  auto bg = color ? cv::Scalar(0, 0, 255) : cv::Scalar(255);
  auto col = color ? cv::Scalar(0, 255, 220) : cv::Scalar(0);
  cv::Mat img = cv::Mat(SIZE, SIZE, stype, bg);
  // Количество линий
  size_t n = x.size();
  for (const auto& s: x) {
    // Количество точек в линии
    size_t n_points = s.shape()[1];
    for (size_t i = 0; i < n_points - 1; ++i) {
      // Точка начала штриха
      cv::Point from(s(0, i), s(1, i));
      // Точка окончания штриха
      cv::Point to(s(0, i + 1), s(1, i + 1));
      // Отрисовка линии
      cv::line(img, from, to, col, LINE_WIDTH, LINE_TYPE);
    }
    if (color) {
      // Меняем цвет линии
      col[0] += 180 / n;
    }
  }
  if (color) {
    // Меняем цветовое представление на RGB
    cv::cvtColor(img, img, cv::COLOR_HSV2RGB);
  }
  // Меняем формат представления на float32 с диапазоном [0, 1]
  img.convertTo(img, dtype, 1 / 255.0);
  return img;
}

// Обработка JSON и получение тензора с данными изображения
xtensor3d process(const std::string& x, double scale = 1.0, bool color = true) {
  auto p = parse_json(x);
  auto img = ocv_draw_lines(p, color);
  if (scale != 1) {
    cv::Mat out;
    cv::resize(img, out, cv::Size(), scale, scale, RESIZE_TYPE);
    cv::swap(img, out);
    out.release();
  }
  xtensor3d arr = color ? to_xt<double,3>(img) : to_xt<double,1>(img);
  return arr;
}

// [[Rcpp::export]]
rtensor3d cpp_process_json_str(const std::string& x,
                               double scale = 1.0,
                               bool color = true) {
  xtensor3d res = process(x, scale, color);
  return res;
}

// [[Rcpp::export]]
rtensor4d cpp_process_json_vector(const std::vector<std::string>& x,
                                  double scale = 1.0,
                                  bool color = false) {
  size_t n = x.size();
  size_t dim = floor(SIZE * scale);
  size_t channels = color ? 3 : 1;
  xtensor4d res({n, dim, dim, channels});
  parallelFor(0, n, [&x, &res, scale, color](int i) {
    xtensor3d tmp = process(x[i], scale, color);
    auto view = xt::view(res, i, xt::all(), xt::all(), xt::all());
    view = tmp;
  });
  return res;
}
Este código debe colocarse en el archivo src/cv_xt.cpp y compilarse con el comando Rcpp::sourceCpp(file = "src/cv_xt.cpp", env = .GlobalEnv); también se requiere nlohmann/json.hpp de . El código está dividido en varias funciones:
to_xt— función templada para transformar la matriz de imagen (cv::Mat) a tensorxt::xtensor;parse_json— función que analiza una cadena JSON, extrae las coordenadas de los puntos y las empaqueta en un vector;ocv_draw_lines— de los puntos del vector obtenido dibuja líneas de colores;procesar— combina las funciones anteriores y también añade la posibilidad de escalar la imagen resultante;cpp_process_json_str— envoltura para la funciónprocesar, que exporta el resultado a un objeto R (matriz multidimensional);cpp_process_json_vector— envoltura para la funcióncpp_process_json_str, que permite procesar un vector de cadenas en modo multihilo.
Para dibujar líneas de colores se utilizó el modelo de color HSV con posterior conversión a RGB. Probemos el resultado:
arr <- cpp_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 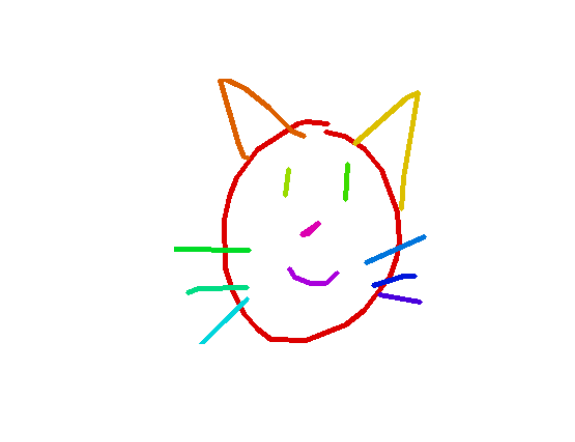
Comparación de la velocidad de ejecución de las implementaciones en R y C++
res_bench <- bench::mark(
  r_process_json_str(tmp_data[4, drawing], scale = 0.5),
  cpp_process_json_str(tmp_data[4, drawing], scale = 0.5),
  check = FALSE,
  min_iterations = 100
)
# Parámetros del benchmark
cols <- c("expresión", "mínimo", "mediana", "máximo", "itr/seg", "tiempo_total", "n_itr")
res_bench[, cols]

#   expresión                mínimo     mediana       máximo `itr/seg` tiempo_total  n_itr
#
# 1 r_process_json_str     3.49ms     3.55ms    4.47ms      273.      490ms    134
# 2 cpp_process_json_str   1.94ms     2.02ms    5.32ms      489.      497ms    243

library(ggplot2)
# Realizando la medición
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    .data <- tmp_data[sample(seq_len(.N), batch_size), drawing]
    bench::mark(
      r_process_json_vector(.data, scale = 0.5),
      cpp_process_json_vector(.data,  scale = 0.5),
      min_iterations = 50,
      check = FALSE
    )
  }
)

res_bench[, cols]

#    expresión   batch_size      mínimo   mediana      máximo `itr/seg` tiempo_total n_itr
#                  <bch:tm> <bch:tm> <bch:tm>        <bch:tm> <int>
#  1 r                   16   50.61ms  53.34ms  54.82ms    19.1     471.13ms     9
#  2 cpp                 16    4.46ms   5.39ms   7.78ms   192.      474.09ms    91
#  3 r                   32   105.7ms 109.74ms 212.26ms     7.69        6.5s    50
#  4 cpp                 32    7.76ms  10.97ms  15.23ms    95.6     522.78ms    50
#  5 r                   64  211.41ms 226.18ms 332.65ms     3.85      12.99s    50
#  6 cpp                 64   25.09ms  27.34ms  32.04ms    36.0        1.39s    50
#  7 r                  128   534.5ms 627.92ms 659.08ms     1.61      31.03s    50
#  8 cpp                128   56.37ms  58.46ms  66.03ms    16.9        2.95s    50
#  9 r                  256     1.15s    1.18s    1.29s     0.851     58.78s    50
# 10 cpp                256  114.97ms 117.39ms 130.09ms     8.45       5.92s    50
# 11 r                  512     2.09s    2.15s    2.32s     0.463       1.8m    50
# 12 cpp                512  230.81ms  235.6ms 261.99ms     4.18      11.97s    50
# 13 r                 1024        4s    4.22s     4.4s     0.238       3.5m    50
# 14 cpp               1024  410.48ms 431.43ms 462.44ms     2.33      21.45s    50

ggplot(res_bench, aes(x = factor(batch_size), y = mediana,
                      group =  expresión, color = expresión)) +
  geom_point() +
  geom_line() +
  ylab("tiempo mediano, s") +
  theme_minimal() +
  scale_color_discrete(name = "", labels = c("cpp", "r")) +
theme(legend.position = "bottom") 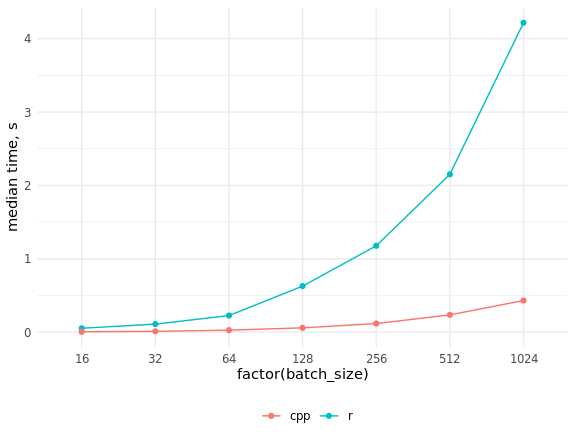
Como podemos ver, el aumento de velocidad ha sido muy significativo, y alcanzar el código en C++ mediante la paralelización del código en R no parece posible.
3. Iteradores para la extracción de lotes desde la base de datos
R tiene una merecida reputación como lenguaje para el procesamiento de datos que se ajustan a la RAM, mientras que Python se caracteriza más por el procesamiento iterativo de datos, lo que permite implementar cálculos fuera de la memoria de manera fácil y natural. Un ejemplo clásico y relevante para nosotros en el contexto de la tarea descrita son las redes neuronales profundas, que se entrenan mediante el método de descenso de gradiente con una aproximación del gradiente en cada paso utilizando un pequeño lote de observaciones, o minibatch.
Los frameworks para el aprendizaje profundo escritos en Python tienen clases especiales que implementan iteradores sobre datos: tablas, imágenes en carpetas, formatos binarios, etc. Se pueden usar opciones disponibles o escribir las propias para tareas específicas. En R, podemos aprovechar todas las capacidades de la biblioteca de Python keras con sus diversos backends mediante el paquete homónimo, que a su vez funciona sobre el paquete reticulate. Este último merece un artículo extenso por sí mismo; no solo permite ejecutar código en Python desde R, sino que también facilita la transferencia de objetos entre sesiones de R y Python, realizando automáticamente todas las conversiones de tipo necesarias.
Nos hemos liberado de la necesidad de almacenar todos los datos en la RAM mediante el uso de MonetDBLite, todo el trabajo 'neural' se llevará a cabo con el código original en Python, solo nos queda escribir un iterador para los datos, ya que no hay uno disponible para esta situación ni en R ni en Python. Los requisitos para él son esencialmente solo dos: debe devolver lotes en un ciclo infinito y mantener su estado entre iteraciones (lo último se implementa de manera sencilla en R mediante cierres). Anteriormente, era necesario convertir explícitamente los arreglos de R en arreglos numpy dentro del iterador, pero la versión actual del paquete keras lo hace automáticamente.
El iterador para los datos de entrenamiento y validación es el siguiente:
Iterador para datos de entrenamiento y validación
train_generator <- function(db_connection = con,
                            samples_index,
                            num_classes = 340,
                            batch_size = 32,
                            scale = 1,
                            color = FALSE,
                            imagenet_preproc = FALSE) {
  # Проверка аргументов
  checkmate::assert_class(con, "DBIConnection")
  checkmate::assert_integerish(samples_index)
  checkmate::assert_count(num_classes)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Перемешиваем, чтобы брать и удалять использованные индексы батчей по порядку
  dt <- data.table::data.table(id = sample(samples_index))
  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  # Оставляем только полные батчи и индексируем
  dt <- dt[, if (.N == batch_size) .SD, keyby = batch]
  # Устанавливаем счётчик
  i <- 1
  # Количество батчей
  max_i <- dt[, max(batch)]

  # Подготовка выражения для выгрузки
  sql <- sprintf(
    "PREPARE SELECT drawing, label_int FROM doodles WHERE id IN (%s)",
    paste(rep("?", batch_size), collapse = ",")
  )
  res <- DBI::dbSendQuery(con, sql)

  # Аналог keras::to_categorical
  to_categorical <- function(x, num) {
    n <- length(x)
    m <- numeric(n * num)
    m[x * n + seq_len(n)] <- 1
    dim(m) <- c(n, num)
    return(m)
  }

  # Замыкание
  function() {
    # Начинаем новую эпоху
    if (i > max_i) {
      dt[, id := sample(id)]
      data.table::setkey(dt, batch)
      # Сбрасываем счётчик
      i <<- 1
      max_i <<- dt[, max(batch)]
    }

    # ID для выгрузки данных
    batch_ind <- dt[batch == i, id]
    # Выгрузка данных
    batch <- DBI::dbFetch(DBI::dbBind(res, as.list(batch_ind)), n = -1)

    # Увеличиваем счётчик
    i <<- i + 1

    # Парсинг JSON и подготовка массива
    batch_x <- cpp_process_json_vector(batch$drawing, scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }

    batch_y <- to_categorical(batch$label_int, num_classes)
    result <- list(batch_x, batch_y)
    return(result)
  }
}
La función toma como entrada una variable con la conexión a la base de datos, los números de las filas utilizadas, el número de clases, el tamaño del batch, la escala (scale = 1 que corresponde a imágenes de 256x256 píxeles, scale = 0.5 — 128x128 píxeles), un indicador de color (color = FALSE que establece el dibujo en tonos de gris, al utilizar color = TRUE cada trazo se dibuja con un nuevo color) y un indicador de preprocesamiento para redes previamente entrenadas en imagenet. Este último es necesario para escalar los valores de los píxeles del intervalo [0, 1] al intervalo [-1, 1], que se usó durante el entrenamiento del conjunto de datos incluido keras modelos.
La función externa contiene una verificación de tipos de argumentos, una tabla data.table con números de filas aleatoriamente mezclados de samples_index y números de lotes, un contador y el número máximo de lotes, así como una expresión SQL para extraer datos de la base de datos. Adicionalmente, hemos definido un análogo rápido de la función keras::to_categorical(). Utilizamos casi todos los datos para el entrenamiento, dejando medio por ciento para la validación, por lo que el tamaño de la época estaba limitado por el parámetro steps_per_epoch al llamar a keras::fit_generator(), y la condición if (i > max_i) se activaba solo para el iterador de validación.
Dentro de la función se seleccionan índices de filas para el siguiente lote, se extraen registros de la base de datos incrementando el contador de lotes, se analiza JSON (la función cpp_process_json_vector(), escrita en C++) y se crean arreglos correspondientes a las imágenes. Luego se crean vectores one-hot con etiquetas de clases, y los arreglos con valores de píxeles y etiquetas se combinan en una lista que es el valor de retorno. Para acelerar el trabajo, se utilizó la creación de índices en las tablas data.table y la modificación por referencia; sin estos "trucos" del paquete data.table resulta bastante difícil imaginar un trabajo eficiente con volúmenes de datos significativos en R.
Los resultados de las mediciones de velocidad en un Core i5 portátil son los siguientes:
Benchmark del iterador
library(Rcpp)
library(keras)
library(ggplot2)

source("utils/rcpp.R")
source("utils/keras_iterator.R")

con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

ind <- seq_len(DBI::dbGetQuery(con, "SELECT count(*) FROM doodles")[[1L]])
num_classes <- DBI::dbGetQuery(con, "SELECT max(label_int) + 1 FROM doodles")[[1L]]

# Índices para el conjunto de entrenamiento
train_ind <- sample(ind, floor(length(ind) * 0.995))
# Índices para el conjunto de validación
val_ind <- ind[-train_ind]
rm(ind)
# Coeficiente de escala
scale <- 0.5

# Realización de la medición
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    it1 <- train_generator(
      db_connection = con,
      samples_index = train_ind,
      num_classes = num_classes,
      batch_size = batch_size,
      scale = scale
    )
    bench::mark(
      it1(),
      min_iterations = 50L
    )
  }
)
# Parámetros del benchmark
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16     25ms  64.36ms   92.2ms     15.9       3.09s    49
# 2         32   48.4ms 118.13ms 197.24ms     8.17       5.88s    48
# 3         64   69.3ms 117.93ms 181.14ms     8.57       5.83s    50
# 4        128  157.2ms 240.74ms 503.87ms     3.85      12.71s    49
# 5        256  359.3ms 613.52ms 988.73ms     1.54       30.5s    47
# 6        512  884.7ms    1.53s    2.07s     0.674      1.11m    45
# 7       1024     2.7s    3.83s    5.47s     0.261      2.81m    44

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
    geom_point() +
    geom_line() +
    ylab("tiempo mediano, s") +
    theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 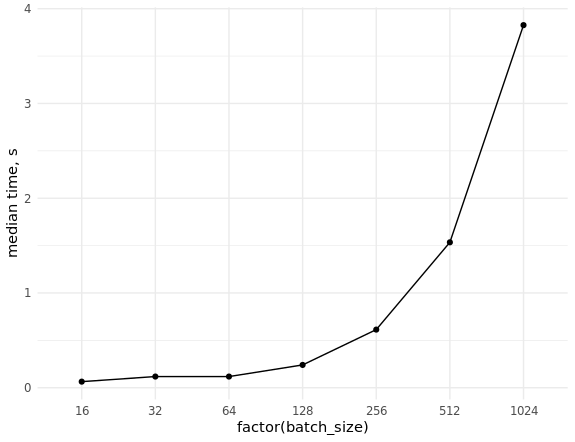
Si se dispone de suficiente memoria RAM, se puede acelerar significativamente el trabajo de la base de datos trasladándola a esta memoria RAM (para nuestra tarea, son suficientes 32 GB). Por defecto, en Linux se monta una partición /dev/shm, que ocupa hasta la mitad de la memoria RAM. Se puede asignar más editando /etc/fstab, de manera que se obtenga una entrada del tipo tmpfs /dev/shm tmpfs defaults,size=25g 0 0. Es necesario reiniciar y verificar el resultado ejecutando el comando df -h.
El iterador para los datos de prueba es mucho más simple, ya que el conjunto de datos de prueba se encuentra completamente en la RAM:
Iterador para datos de prueba
test_generator <- function(dt,
                           batch_size = 32,
                           scale = 1,
                           color = FALSE,
                           imagenet_preproc = FALSE) {

  # Проверка аргументов
  checkmate::assert_data_table(dt)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  data.table::setkey(dt, batch)
  i <- 1
  max_i <- dt[, max(batch)]

  # Замыкание
  function() {
    batch_x <- cpp_process_json_vector(dt[batch == i, drawing],
                                       scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }
    result <- list(batch_x)
    i <<- i + 1
    return(result)
  }
}
4. Selección de la arquitectura del modelo
La primera de las arquitecturas utilizadas fue , cuyas características se analizan en mensaje. Está presente en la instalación estándar keras y, por tanto, está disponible en el paquete homónimo para R. Pero al intentar usarla con imágenes de un solo canal, se descubrió algo extraño: el tensor de entrada debe tener siempre la dimensión (batch, height, width, 3), es decir, no se puede cambiar el número de canales. En Python no existe esta limitación, así que nos apresuramos a crear nuestra propia implementación de esta arquitectura, siguiendo el artículo original (sin dropout, que está en la versión de Keras):
Arquitectura MobileNet V1
library(keras)

top_3_categorical_accuracy <- custom_metric(
    name = "top_3_categorical_accuracy",
    metric_fn = function(y_true, y_pred) {
         metric_top_k_categorical_accuracy(y_true, y_pred, k = 3)
    }
)

layer_sep_conv_bn %
  layer_batch_normalization() %>%
  layer_activation_relu() %>%
  layer_conv_2d(
    filters = filters * alpha,
    kernel_size = c(1, 1),
    strides = c(1, 1)
  ) %>%
  layer_batch_normalization() %>%
  layer_activation_relu()
}

get_mobilenet_v1 <- function(input_shape = c(224, 224, 1),
                             num_classes = 340,
                             alpha = 1,
                             depth_multiplier = 1,
                             optimizer = optimizer_adam(lr = 0.002),
                             loss = "categorical_crossentropy",
                             metrics = c("categorical_crossentropy",
                                         top_3_categorical_accuracy)) {

  inputs <- layer_input(shape = input_shape)

  outputs %
    layer_conv_2d(filters = 32, kernel_size = c(3, 3), strides = c(2, 2), padding = "same") %>%
    layer_batch_normalization() %>%
    layer_activation_relu() %>%
    layer_sep_conv_bn(filters = 64, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(1, 1)) %>%
    layer_global_average_pooling_2d() %>%
    layer_dense(units = num_classes) %>%
    layer_activation_softmax()

    model % compile(
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )

    return(model)
}
Las desventajas de este enfoque son evidentes. Se quiere probar con muchos modelos, pero no se desea reescribir manualmente cada arquitectura. Además, nos privaron de la posibilidad de usar pesos de modelos previamente entrenados en ImageNet. Como siempre, el estudio de la documentación ayudó. La función get_config() permite obtener una descripción del modelo en un formato editable (base_model_conf$layers — lista R estándar), y la función from_config() realiza la conversión inversa a un objeto modelo:
base_model_conf <- get_config(base_model)
base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
base_model <- from_config(base_model_conf)
Ahora no es difícil escribir una función universal para obtener cualquiera de los modelos proporcionados, keras con pesos preentrenados en imagenet o sin ellos:
Función para cargar arquitecturas listas
get_model <- function(name = "mobilenet_v2",
                      input_shape = NULL,
                      weights = "imagenet",
                      pooling = "avg",
                      num_classes = NULL,
                      optimizer = keras::optimizer_adam(lr = 0.002),
                      loss = "categorical_crossentropy",
                      metrics = NULL,
                      color = TRUE,
                      compile = FALSE) {
  # Verificación de argumentos
  checkmate::assert_string(name)
  checkmate::assert_integerish(input_shape, lower = 1, upper = 256, len = 3)
  checkmate::assert_count(num_classes)
  checkmate::assert_flag(color)
  checkmate::assert_flag(compile)

  # Obtenemos el objeto del paquete keras
  model_fun <- get0(paste0("application_", name), envir = asNamespace("keras"))
  # Verificación de la existencia del objeto en el paquete
  if (is.null(model_fun)) {
    stop("Modelo ", shQuote(name), " no encontrado.", call. = FALSE)
  }

  base_model <- model_fun(
    input_shape = input_shape,
    include_top = FALSE,
    weights = weights,
    pooling = pooling
  )

  # Si la imagen no es en color, cambiamos la dimensionalidad de entrada
  if (!color) {
    base_model_conf <- keras::get_config(base_model)
    base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
    base_model <- keras::from_config(base_model_conf)
  }

  predictions <- keras::get_layer(base_model, "global_average_pooling2d_1")$output
  predictions <- keras::layer_dense(predictions, units = num_classes, activation = "softmax")
  model <- keras::keras_model(
    inputs = base_model$input,
    outputs = predictions
  )

  if (compile) {
    keras::compile(
      object = model,
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )
  }

  return(model)
}
Al utilizar imágenes de un solo canal, no se utilizan los pesos preentrenados. Esto podría solucionarse: utilizando la función get_weights() para obtener los pesos del modelo como una lista de arreglos de R, modificar la dimensionalidad del primer elemento de esta lista (tomando un solo canal de color o promediando los tres), y luego cargar los pesos de nuevo en el modelo con la función set_weights(). No añadimos esta funcionalidad, ya que en este punto ya estaba claro que era más productivo trabajar con imágenes a color.
Realizamos la mayoría de los experimentos utilizando la versión 1 y 2 de mobilenet, así como resnet34. En esta competición, arquitecturas más modernas como SE-ResNeXt tuvieron un buen desempeño. Desafortunadamente, no teníamos implementaciones listas a nuestra disposición, y no hemos escrito las nuestras (pero definitivamente lo haremos).
5. Parametrización de scripts
Para facilitar, todo el código para ejecutar el entrenamiento se organizó en un único script, parametrizado con de la siguiente manera:
doc <- '
Uso:
  train_nn.R --help
  train_nn.R --list-models
  train_nn.R [opciones]

Opciones:
  -h --help                   Muestra este mensaje.
  -l --list-models            Lista los modelos disponibles.
  -m --model=         Nombre del modelo de red neuronal [predeterminado: mobilenet_v2].
  -b --batch-size=    Tamaño del lote [predeterminado: 32].
  -s --scale-factor=   Factor de escala [predeterminado: 0.5].
  -c --color                  Usa líneas de color [predeterminado: FALSE].
  -d --db-dir=         Ruta al directorio de la base de datos [predeterminado: Sys.getenv("db_dir")].
  -r --validate-ratio= Proporción de muestra de validación [predeterminado: 0.995].
  -n --n-gpu=         Número de GPUs [predeterminado: 1].
'
args <- docopt::docopt(doc)
Paquete docopt es una implementación para R. A través de él, los scripts se ejecutan con comandos simples como Rscript bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db o ./bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db, si el archivo train_nn.R es ejecutable (este comando iniciará el entrenamiento del modelo resnet50 en imágenes en color de 128x128 píxeles, la base de datos debe estar en la carpeta /home/andrey/doodle_db). Se pueden agregar la tasa de aprendizaje, el tipo de optimizador y cualquier otro parámetro configurable. En el proceso de preparación de la publicación, descubrí que la arquitectura mobilenet_v2 de la versión actual keras en R utilizar debido a cambios no contemplados en el paquete de R — estamos esperando que lo solucionen.
Este enfoque permitió acelerar significativamente los experimentos con diferentes modelos en comparación con el lanzamiento más tradicional de scripts en RStudio (como posible alternativa, notamos el paquete ). Pero la principal ventaja radica en la capacidad de gestionar fácilmente la ejecución de scripts en Docker o simplemente en el servidor, sin necesidad de instalar RStudio para ello.
6. Dockerización de scripts
Utilizamos Docker con el fin de garantizar la portabilidad del entorno para el entrenamiento de modelos entre los miembros del equipo y para el despliegue rápido en la nube. Para comenzar a familiarizarse con esta herramienta relativamente poco común para el programador de R, se puede comenzar con una serie de publicaciones o con .
Docker permite crear imágenes propias "desde cero" y también utilizar otras imágenes como base para crear las propias. Al analizar las opciones disponibles, llegamos a la conclusión de que la instalación de los controladores de NVIDIA, CUDA+cuDNN y las bibliotecas de Python es una parte bastante extensa de la imagen, así que decidimos tomar como base la imagen oficial. tensorflow/tensorflow:1.12.0-gpu, añadiendo los paquetes de R necesarios.
El Dockerfile resultante es el siguiente:
Dockerfile
FROM tensorflow/tensorflow:1.12.0-gpu

MAINTAINER Artem Klevtsov

SHELL ["/bin/bash", "-c"]

ARG LOCALE="en_US.UTF-8"
ARG APT_PKG="libopencv-dev r-base r-base-dev littler"
ARG R_BIN_PKG="futile.logger checkmate data.table rcpp rapidjsonr dbi keras jsonlite curl digest remotes"
ARG R_SRC_PKG="xtensor RcppThread docopt MonetDBLite"
ARG PY_PIP_PKG="keras"
ARG DIRS="/db /app /app/data /app/models /app/logs"

RUN source /etc/os-release &&
    echo "deb https://cloud.r-project.org/bin/linux/ubuntu ${UBUNTU_CODENAME}-cran35/" > /etc/apt/sources.list.d/cran35.list &&
    apt-key adv --keyserver keyserver.ubuntu.com --recv-keys E084DAB9 &&
    add-apt-repository -y ppa:marutter/c2d4u3.5 &&
    add-apt-repository -y ppa:timsc/opencv-3.4 &&
    apt-get update &&
    apt-get install -y locales &&
    locale-gen ${LOCALE} &&
    apt-get install -y --no-install-recommends ${APT_PKG} &&
    ln -s /usr/lib/R/site-library/littler/examples/install.r /usr/local/bin/install.r &&
    ln -s /usr/lib/R/site-library/littler/examples/install2.r /usr/local/bin/install2.r &&
    ln -s /usr/lib/R/site-library/littler/examples/installGithub.r /usr/local/bin/installGithub.r &&
    echo 'options(Ncpus = parallel::detectCores())' >> /etc/R/Rprofile.site &&
    echo 'options(repos = c(CRAN = "https://cloud.r-project.org"))' >> /etc/R/Rprofile.site &&
    apt-get install -y $(printf "r-cran-%s " ${R_BIN_PKG}) &&
    install.r ${R_SRC_PKG} &&
    pip install ${PY_PIP_PKG} &&
    mkdir -p ${DIRS} &&
    chmod 777 ${DIRS} &&
    rm -rf /tmp/downloaded_packages/ /tmp/*.rds &&
    rm -rf /var/lib/apt/lists/*

COPY utils /app/utils
COPY src /app/src
COPY tests /app/tests
COPY bin/*.R /app/

ENV DBDIR="/db"
ENV CUDA_HOME="/usr/local/cuda"
ENV PATH="/app:${PATH}"

WORKDIR /app

VOLUME /db
VOLUME /app

CMD bash
Para facilitar, los paquetes utilizados se han trasladado a variables; la mayor parte de los scripts escritos se copian dentro de los contenedores durante la construcción. También cambiamos el shell a /bin/bash para facilitar el uso del contenido /etc/os-release. Esto permitió evitar la necesidad de especificar la versión del sistema operativo en el código.
Además, se escribió un pequeño script bash que permite ejecutar el contenedor con diferentes comandos. Por ejemplo, pueden ser scripts para entrenar redes neuronales que se colocaron anteriormente dentro del contenedor, o el shell para depuración y monitoreo del funcionamiento del contenedor:
Script para ejecutar el contenedor
#!/bin/sh

DBDIR=${PWD}/db
LOGSDIR=${PWD}/logs
MODELDIR=${PWD}/models
DATADIR=${PWD}/data
ARGS="--runtime=nvidia --rm -v ${DBDIR}:/db -v ${LOGSDIR}:/app/logs -v ${MODELDIR}:/app/models -v ${DATADIR}:/app/data"

if [ -z "$1" ]; then
    CMD="Rscript /app/train_nn.R"
elif [ "$1" = "bash" ]; then
    ARGS="${ARGS} -ti"
else
    CMD="Rscript /app/train_nn.R $@"
fi

docker run ${ARGS} doodles-tf ${CMD}
Si este script bash se ejecuta sin parámetros, se invocará un script dentro del contenedor con valores predeterminados; si el primer argumento posicional es "bash", el contenedor se iniciará en modo interactivo con una terminal. En todos los demás casos, se sustituyen los valores de los argumentos posicionales: train_nn.R CMD="Rscript /app/train_nn.R $@" Es importante destacar que los directorios con datos de origen y la base de datos, así como el directorio para guardar los modelos entrenados, se montan dentro del contenedor desde el sistema host, lo que permite acceder a los resultados del trabajo de los scripts sin manipulaciones adicionales..
7. Uso de múltiples GPU en Google Cloud
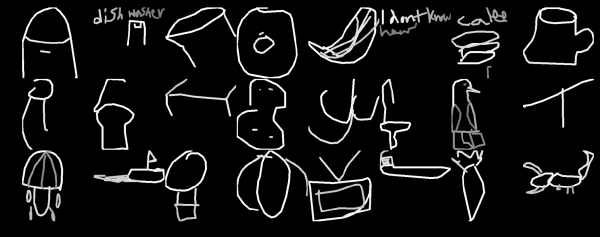
Una de las características del concurso fueron los datos bastante ruidosos (ver la imagen de cabecera, tomada de @Leigh.plt en el Slack de ODS). Combatir esto ayuda con lotes de gran tamaño, y después de experimentar en una PC con 1 GPU, decidimos aprender a entrenar modelos en múltiples GPU en la nube. Utilizamos Google Cloud (
una buena guía sobre los conceptos básicos de trabajodev/shm El fragmento de código más interesante es el que se encarga de utilizar múltiples GPU. Primero, el modelo se crea en CPU usando un administrador de contexto, justo como en Python:.
with(tensorflow::tf$device("/cpu:0"), { model_cpu <- get_model( name = model_name, input_shape = input_shape, weights = weights, metrics = (top_3_categorical_accuracy, compile = FALSE ) })
Luego, el modelo no compilado (esto es importante) se copia al número específico de GPU disponibles, y solo después se compila:model <- keras::multi_gpu_model(model_cpu, gpus = n_gpu) keras::compile( object = model, optimizer = keras::optimizer_adam(lr = 0.0004), loss = "categorical_crossentropy", metrics = c(top_3_categorical_accuracy) )
No se pudo implementar la técnica clásica de congelar todas las capas excepto la última, entrenar la última capa, descongelar y reentrenar el modelo completo para múltiples GPU.Se monitorizó el entrenamiento sin utilizar
tensorboard tensorboard, restringiéndonos a registrar los logs y guardar modelos con nombres informativos después de cada época:
Callbacks
# Шаблон имени файла лога
log_file_tmpl <- file.path("logs", sprintf(
  "%s_%d_%dch_%s.csv",
  model_name,
  dim_size,
  channels,
  format(Sys.time(), "%Y%m%d%H%M%OS")
))
# Шаблон имени файла модели
model_file_tmpl <- file.path("models", sprintf(
  "%s_%d_%dch_{epoch:02d}_{val_loss:.2f}.h5",
  model_name,
  dim_size,
  channels
))

callbacks_list <- list(
  keras::callback_csv_logger(
    filename = log_file_tmpl
  ),
  keras::callback_early_stopping(
    monitor = "val_loss",
    min_delta = 1e-4,
    patience = 8,
    verbose = 1,
    mode = "min"
  ),
  keras::callback_reduce_lr_on_plateau(
    monitor = "val_loss",
    factor = 0.5, # уменьшаем lr в 2 раза
    patience = 4,
    verbose = 1,
    min_delta = 1e-4,
    mode = "min"
  ),
  keras::callback_model_checkpoint(
    filepath = model_file_tmpl,
    monitor = "val_loss",
    save_best_only = FALSE,
    save_weights_only = FALSE,
    mode = "min"
  )
)
8. En lugar de conclusión
Una serie de problemas con los que nos enfrentamos, aún no hemos podido superar:
- en keras no hay una función lista para buscar automáticamente la tasa de aprendizaje óptima (análogo a
lr_finderen la biblioteca fast.ai); haciendo un esfuerzo, es posible portar a R implementaciones de terceros, por ejemplo, ; - como consecuencia del punto anterior, no hemos podido encontrar la tasa de aprendizaje adecuada al usar múltiples GPU;
- falta de arquitecturas modernas de redes neuronales, especialmente aquellas preentrenadas en imagenet;
- no hay política de one cycle y tasas de aprendizaje discriminativas (el cosine annealing a nuestra solicitud fue , gracias ).
Lo útil que pudimos extraer de esta competencia:
- Con hardware relativamente poco potente, se puede trabajar sin problemas con volúmenes de datos considerablemente mayores que el tamaño de la RAM. El paquete data.table ahorra memoria mediante la modificación in-place de tablas, lo que evita su copia, y con un uso correcto de sus capacidades, casi siempre muestra la mayor velocidad entre todas las herramientas que conocemos para lenguajes de script. Guardar datos en la base de datos permite, en muchos casos, no pensar en la necesidad de encajar todo el conjunto de datos en la RAM.
- Las funciones lentas en R pueden ser reemplazadas por rápidas en C++ usando el paquete Rcpp. Además, si utilizamos RcppThread o RcppParallel, obtenemos implementaciones multiplataforma multihilo, por lo que no es necesario paralelizar el código a nivel de R.
- El paquete Rcpp se puede utilizar sin un conocimiento profundo de C++, se expone lo mínimo necesario . Los archivos de encabezado para varias bibliotecas C geniales como xtensor están disponibles en CRAN, es decir, se está formando una infraestructura para realizar proyectos que integren en R código de C++ de alto rendimiento ya listo. Otra comodidad es la resaltación de sintaxis y el analizador estático de código en C++ en RStudio.
- docopt permite ejecutar scripts autónomos con parámetros. Esto es conveniente para usar en un servidor remoto, incluido bajo Docker. Hacer experimentos de largas horas con el entrenamiento de redes neuronales en RStudio no es práctico, y la instalación de IDE en el servidor no siempre está justificada.
- Docker garantiza la portabilidad del código y la reproducibilidad de los resultados entre desarrolladores con diferentes versiones de sistemas operativos y bibliotecas, además de facilitar su ejecución en servidores. Se puede iniciar todo el pipeline para el entrenamiento con un solo comando.
- Google Cloud es una forma económica de experimentar en hardware costoso, pero es necesario elegir las configuraciones con cuidado.
- Medir la velocidad de fragmentos de código individuales es muy útil, especialmente al combinar R y C++, y con el paquete bench es aún más fácil.
En general, esta experiencia fue muy útil y seguimos trabajando en la solución de algunos de los problemas mencionados.
Fuente: habr.com
