

El código de los productos de software para el aprendizaje automático a menudo es complicado y bastante enredado. Detectar y eliminar errores en él es una tarea que consume muchos recursos. Incluso los más simples requieren un enfoque serio en la arquitectura de la red, la inicialización de los pesos, y la optimización de la red. Un pequeño error puede llevar a problemas desagradables.
Este artículo está dedicado al algoritmo para depurar sus redes neuronales.
Skillbox recomienda: Curso práctico .
Recordamos: para todos los lectores de «Habr» — un descuento de 10,000 rublos al registrarse en cualquier curso de Skillbox usando el código promocional «Habr».
El algoritmo consta de cinco etapas:
- inicio simple;
- confirmación de pérdidas;
- verificación de resultados intermedios y conexiones;
- diagnóstico de parámetros;
- control del funcionamiento.
Si hay algo que le parece más interesante que el resto, puede saltar directamente a esas secciones.
Inicio simple
Depurar una red neuronal con una arquitectura compleja, regularización y un programador de tasa de aprendizaje es más complicado que una convencional. Aquí estamos siendo un poco ingeniosos, ya que este punto tiene una relación indirecta con la depuración, pero sigue siendo una recomendación importante.
El inicio simple consiste en crear un modelo simplificado y entrenarlo en un único conjunto (punto) de datos.
Primero creamos un modelo simplificado
Para un inicio rápido, creamos una pequeña red con una sola capa oculta y verificamos que todo funcione correctamente. Luego, complicamos gradualmente el modelo, revisando cada nuevo aspecto de su estructura (capa adicional, parámetro, etc.), y avanzamos.
Entrenamos el modelo en un único conjunto (punto) de datos
Como comprobación rápida de la funcionalidad de su proyecto, puede utilizar uno o dos puntos de datos para el entrenamiento y confirmar que el sistema está funcionando correctamente. La red neuronal debe mostrar un 100% de precisión en el entrenamiento y la verificación. Si no es así, el modelo puede ser demasiado pequeño o ya tiene un error.
Incluso si todo está bien, prepare el modelo para pasar una o varias épocas antes de continuar.
Evaluación de pérdidas
La evaluación de pérdidas es la principal forma de ajustar el rendimiento del modelo. Debe asegurarse de que la pérdida corresponda a la tarea y que las funciones de pérdida se evalúen en una escala correcta. Si utiliza más de un tipo de pérdida, asegúrese de que todas estén en el mismo orden y correctamente escaladas.
Es importante prestar atención a las pérdidas iniciales. Verifique cuán cerca está el resultado real del esperado, si el modelo comenzó desde una suposición aleatoria. En : "Asegúrese de que está obteniendo el resultado esperado al comenzar con un número reducido de parámetros. Es mejor verificar inmediatamente la pérdida de datos (con el grado de regularización establecido en cero). Por ejemplo, para CIFAR-10 con el clasificador Softmax, esperamos que las pérdidas iniciales sean 2.302, porque la probabilidad difusa esperada es de 0.1 para cada clase (ya que hay 10 clases), y la pérdida Softmax es la probabilidad logarítmica negativa de la clase correcta, que es -ln(0.1) = 2.302."
Para un ejemplo binario, simplemente se realiza un cálculo similar para cada una de las clases. Por ejemplo, los datos: 20% 0's y 80% 1's. La pérdida inicial esperada será hasta -0.2ln(0.5) - 0.8ln(0.5) = 0.693147. Si el resultado es mayor que 1, esto puede indicar que los pesos de la red neuronal no están equilibrados adecuadamente o que los datos no están normalizados.
Verificamos los resultados intermedios y las conexiones
Para depurar la red neuronal es necesario entender la dinámica de los procesos dentro de la red y el papel de cada una de las capas intermedias, ya que están vinculadas. Aquí hay errores típicos con los que puede encontrarse:
- expresiones incorrectas para las actualizaciones del gradiente;
- no se aplican actualizaciones de peso;
- gradientes que desaparecen o gradientes explosivos (exploding gradients).
Si los valores del gradiente son cero, significa que la tasa de aprendizaje en el optimizador es demasiado baja, o que se ha encontrado con una expresión incorrecta para la actualización del gradiente.
Además, es necesario monitorear los valores de las funciones de activación, los pesos y las actualizaciones de cada una de las capas. Por ejemplo, la magnitude de las actualizaciones de parámetros (pesos y sesgos) .
Existen fenómenos que se han denominado “Dying ReLU” o , cuando las neuronas ReLU producirán cero después de aprender un gran valor negativo (bias) para sus pesos. Estas neuronas nunca más se activarán en ningún lugar de los datos.
Puedes usar la verificación del gradiente para identificar estos errores aproximando el gradiente mediante un enfoque numérico. Si es cercano a los gradientes calculados, entonces la retropropagación se ha implementado correctamente. Para crear una verificación del gradiente, consulta estos maravillosos recursos de CS231. y , así como con de Andrew Ng sobre este tema.
indica tres métodos principales para visualizar redes neuronales:
- Métodos preliminares: métodos simples que nos muestran la estructura general del modelo entrenado. Incluyen la visualización de formas o filtros de capas individuales de la red neuronal y parámetros en cada capa.
- Basados en activaciones. Aquí decodificamos las activaciones de neuronas individuales o grupos de neuronas para entender sus funciones.
- Basados en gradientes. Estos métodos tienden a manipular los gradientes que se generan durante la propagación hacia adelante y hacia atrás al entrenar el modelo (incluyendo mapas de importancia y mapas de activación por clase).
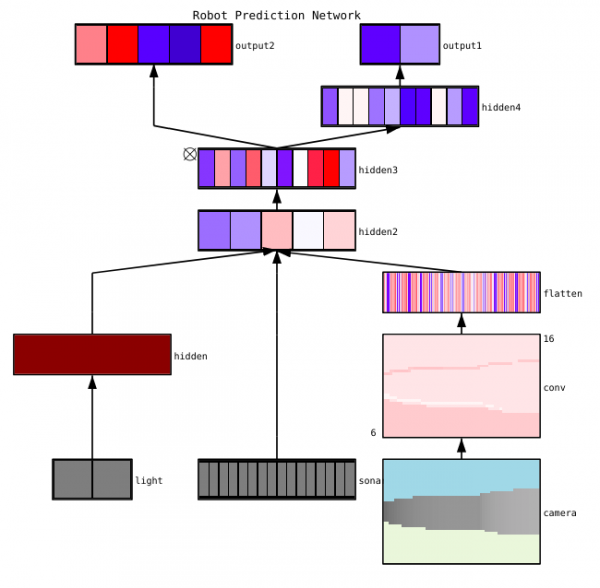
Hay varias herramientas útiles para visualizar las activaciones y conexiones de capas individuales, como y .
Diagnóstico de parámetros
Las redes neuronales tienen una gran cantidad de parámetros que interactúan entre sí, lo que complica la optimización. De hecho, esta sección es objeto de investigaciones activas por parte de especialistas, por lo que las sugerencias a continuación deben considerarse solo como consejos, puntos de partida desde los cuales se puede avanzar.
Tamaño de lote (batch size) — es necesario que el tamaño del lote sea lo suficientemente grande para obtener estimaciones precisas del gradiente de error, pero lo suficientemente pequeño para que el descenso de gradiente estocástico (SGD) pueda ordenar tu red. Los tamaños de lote pequeños llevarán a una rápida convergencia debido al ruido en el proceso de entrenamiento y, posteriormente, a dificultades en la optimización. Se describe más detalladamente .
Tasa de aprendizaje — una tasa demasiado baja llevará a una convergencia lenta o al riesgo de estancarse en mínimos locales. Al mismo tiempo, una alta tasa de aprendizaje causará divergencia en la optimización, ya que corres el riesgo de 'saltar' sobre una parte profunda pero estrecha de la función de pérdida. Intenta utilizar programación de tasas para reducirla durante el proceso de entrenamiento de la red neuronal. En el curso CS231n. .
Recorte de gradiente — recorte de los gradientes de los parámetros durante la retropropagación según un valor máximo o norma límite. Es útil para abordar problemas con cualquier gradiente explosivo que puedas encontrar en el tercer lugar.
Normalización por lotes — se utiliza para normalizar los datos de entrada de cada capa, lo que ayuda a resolver el problema del cambio de covariancia interno. Si usas Dropout y Batch Normalization juntos, .
Descenso de gradiente estocástico (SGD) — existen varias variantes de SGD que utilizan momento, tasas de aprendizaje adaptativas y el método de Nesterov. Sin embargo, ninguna de ellas tiene una ventaja clara en términos de eficiencia de entrenamiento o generalización ().
Regularización — es crucial para construir un modelo generalizable, ya que añade una penalización por la complejidad del modelo o los valores extremos de los parámetros. Es una forma de reducir la varianza del modelo sin aumentar significativamente su sesgo. Más .
Para evaluar todo por ti mismo, es necesario desactivar la regularización y verificar el gradiente de la pérdida de datos por tu cuenta.
Dropout — otro método para regularizar tu red y prevenir el sobreajuste. Durante el entrenamiento, el dropout se realiza manteniendo la actividad de una neurona con cierta probabilidad p (hiperparámetro) o estableciéndola en cero en caso contrario. Como resultado, la red debe utilizar un subconjunto diferente de parámetros para cada mini-lote de entrenamiento, lo que reduce los cambios de ciertos parámetros que se vuelven dominantes.
Importante: si usas tanto dropout como normalización por lotes, ten cuidado con el orden de estas operaciones o incluso con su uso conjunto. Todo esto aún se discute activamente y se amplía. Aquí hay dos discusiones importantes sobre este tema y .
Control del trabajo
Se trata de documentar los procesos de trabajo y los experimentos. Si no se documenta nada, se puede olvidar, por ejemplo, qué tasa de aprendizaje o peso de clases se está utilizando. Gracias al control, se pueden revisar y reproducir sin problemas los experimentos anteriores. Esto ayuda a reducir el número de experimentos duplicados.
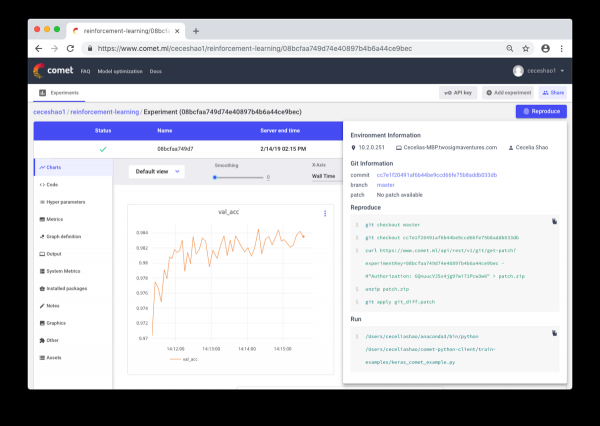
Sin embargo, la documentación manual puede convertirse en una tarea complicada en caso de un gran volumen de trabajo. Aquí es donde entran en juego herramientas como Comet.ml, que ayudan a registrar automáticamente conjuntos de datos, cambios en el código, el historial de experimentos y modelos de producción, incluyendo información clave sobre su modelo (hiperparámetros, métricas de rendimiento del modelo y detalles sobre el entorno).
Una red neuronal puede ser bastante sensible a pequeños cambios, lo que puede llevar a una disminución en el rendimiento del modelo. Rastrear y documentar el trabajo es el primer paso que se debe tomar para estandarizar el entorno y la modelización.
Espero que esta publicación sirva como un punto de partida desde el que comience la depuración de su red neuronal.
Skillbox recomienda:
- Curso práctico de dos años .
- Curso en línea .
- Curso práctico de un año .
Fuente: habr.com
