

Eellugu
Juhtus nii, et serveri ründas krüpteeriv viirus, mis "õnneliku juhusena" jättis osaliselt puutumata .ibd failid (innodb tabelite toorandmete failid), kuid samal ajal krüpteeris täielikult .fpm failid (struktuurifailid). .idb failid saab jagada:
- taastatavateks standardsete vahendite ja juhendite abil. Selliste juhtumite jaoks on olemas suurepärane ;
- osaliselt krüpteeritud tabelid. Peamiselt on need suured tabelid, millele (nagu ma aru sain) kurjategijatel ei jätkunud operatiivmälu täielikuks krüpteerimiseks;
- ja täiesti krüpteeritud tabelid, mida ei saa taastada.
Määrata, millisesse varianti tabelid kuuluvad, õnnestus banaalse tekstiredaktori avamisega vajaliku kodeeringuga (minu puhul UTF8) ja lihtsalt failis tekstiväljade leidmisega, näiteks:
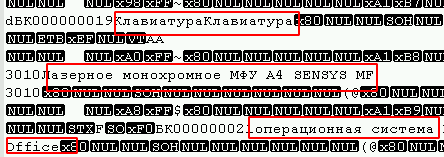
Samuti võib faili alguses näha suurt hulka 0-bitte, ning viirused, mis kasutavad plokkkrüpteerimise algoritmi (kõige levinum), puudutavad tavaliselt ka neid.

Minu puhul jättis kurjategija iga krüpteeritud faili lõppu 4-bitte pikkuse rea (1, 0, 0, 0), mis lihtsustas ülesannet. Puuduvatest failidest piisab ka skriptist:
def opened(path):
    files = os.listdir(path)
    for f in files:
        if os.path.isfile(path + f):
            yield path + f

for full_path in opened("C:somepath"):
    file = open(full_path, "rb")
    last_string = ""
    for line in file:
        last_string = line
        file.close()
    if (last_string[len(last_string) -4:len(last_string)]) != (1, 0, 0, 0):
        print(full_path)
Nii õnnestus leida faile, mis kuuluvad esimese tüübi alla. Teine hõlmab pikka manuaalset tööd, kuid leitud oli juba piisavalt. Kõik oleks hea, kuid on vajalik teada absoluutselt täpset struktuuri ja (muidugi) juhtus selline olukord, et tuli töötada sageli muutuva tabeliga. Keegi ei mäletanud, kas välja tüüp muutus või lisati uus veerg.
Deybri linn ei suutnud kahjuks sellisel puhul aidata, seega kirjutatakse see artikkel.
Asume asja juurde
Kolme kuu tagune tabeli struktuur ei ühti praegusega (võib-olla ühe välja osas, aga võib-olla ka mitme). Tabeli struktuur:
CREATE TABLE `table_1` (
    `id` INT (11),
    `date` DATETIME ,
    `description` TEXT ,
    `id_point` INT (11),
    `id_user` INT (11),
    `date_start` DATETIME ,
    `date_finish` DATETIME ,
    `photo` INT (1),
    `id_client` INT (11),
    `status` INT (1),
    `lead__time` TIME ,
    `sendstatus` TINYINT (4)
);
samuti tuleb välja tuua:
id_pointINT (11);id_userINT (11);date_startDATETIME ;date_finishDATETIME .
Taasteks kasutatakse bäit-by-byte analüüsi .ibd failist, millele järgneb nende edastamine loetavamasse vormi. Kuna nõutava leidmiseks piisab, kui analüüsida selliseid andmetüüpe nagu int ja datetime, siis artiklis kirjeldatakse ainult neid, kuigi vahel teen viiteid ka teistele andmetüüpidele, mis võivad sarnastes olukordades abiks olla.
Probleem 1: DATETIME ja TEXT tüüpidega väljade puhul oli olemas NULL väärtus ja need jäeti failis lihtsalt vahele, mistõttu ei õnnestunud mu juhul taastamise struktuuri kindlaks teha. Uutes veergudes oli vaikeväärtus null ja osa tehingutest võis olla kadunud seoses seadistusega innodb_flush_log_at_trx_commit = 0; seetõttu oleks struktuuri määramine nõudnud täiendavat aega.
Probleem 2: tuleks arvestada, et DELETE käsuga kustutatud read on ikkagi ibd failis, kuid ALTER TABLE korral ei uuendata nende struktuuri. Lõppkokkuvõttes võivad andmete struktuurid varieeruda faili algusest lõpuni. Kui kasutate OPTIMIZE TABLE'i sageli, siis tõenäoliselt selliste probleemidega ei puutute kokku.
Pange tähele, et andmebaasi versioon mõjutab andmete salvestamise viisi ja see näide ei pruugi teiste peamiste versioonide puhul tööle minna. Minu juhul kasutati Windowsi versiooni mariadb 10.1.24. Samuti, kuigi mariadb'is töötate InnoDB tabelitega, on need tegelikult , mis välistab InnoDB mysql meetodi rakendamise.
Faili analüüs
Pythonis, andmetüüp kuvab andmed unikaalkoodina tavalise numbrisarja asemel. Kuigi faili saab vaadata sellisel kujul, on mugavuse huvides võimalik bajtteid muuta numbriliseks vormiks, muutes bajtide massi tavaliseks massiiviks (list(example_byte_array)). IgCase, mõlema meetodi abil on analüüsimiseks abiks.
Mitmete ibd failide ülevaatamisel võib leida järgmist:
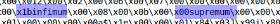
Kuid kui jagada fail neid märksõnu pidi, saadakse peamiselt ühtlased andmepakid. Kasutame infimum'i jagajana.
table = table.split("infimum".encode())Huvitav tähelepanek, et väikese andmega tabelite puhul on infimum'i ja supremum'i vahel näidik selle blokis olevate ridade arvu kohta.
 — testitabel, kus on 1 rida
 — testitabel, kus on 2 rida
String array table[0] can be skipped. After reviewing it, I couldn’t find any raw data of the tables. Most likely, this block is used for storing indices and keys.
Starting from table[1] and converting it into a numeric array, some patterns can already be noticed, namely:
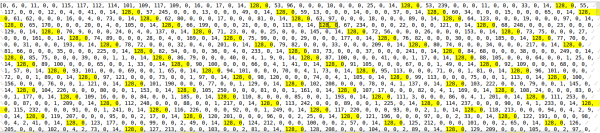
These are int values stored as a string. The first byte indicates whether the number is positive or negative. In my case, all numbers are positive. From the remaining 3 bytes, the number can be determined using the following function. Script:
def find_int(val: str):  # example '128, 1, 2, 3'
    val = [int(v) for v in  val.split(", ")]
    result_int = val[1]*256**2 + val[2]*256*1 + val[3]
    return result_int
Näiteks, 128, 0, 0, 1 = 1, või 128, 0, 75, 108 = 19308.
The table had a primary key with auto-increment, and it can also be found here.
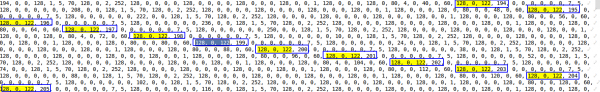
By comparing the data from the test tables, it was revealed that the DATETIME object consists of 5 bytes starting with 153 (most likely indicates yearly intervals). Since the DATETIME range is ‘1000-01-01’ to ‘9999-12-31’, I think the number of bytes may vary, but in my case, the data falls within the range from 2016 to 2019, so we will assume that 5 bytes are sufficient.
To determine the time without seconds, the following functions were written. Script:
day_ = lambda x: x % 64 // 2  # {x,x,X,x,x }

def hour_(x1, x2):  # {x,x,X1,X2,x}
    if x1 % 2 == 0:
        return x2 // 16
    elif x1 % 2 == 1:
        return x2 // 16 + 16
    else:
        raise ValueError

min_ = lambda x1, x2: (x1 % 16) * 4 + (x2 // 64)  # {x,x,x,X1,X2}
For the year and month, I couldn’t write a properly functioning function, so I had to hardcode it. Script:
ym_list = {'2016, 1': '153, 152, 64', '2016, 2': '153, 152, 128',
           '2016, 3': '153, 152, 192', '2016, 4': '153, 153, 0',
           '2016, 5': '153, 153, 64', '2016, 6': '153, 153, 128',
           '2016, 7': '153, 153, 192', '2016, 8': '153, 154, 0',
           '2016, 9': '153, 154, 64', '2016, 10': '153, 154, 128',
           '2016, 11': '153, 154, 192', '2016, 12': '153, 155, 0',
           '2017, 1': '153, 155, 128', '2017, 2': '153, 155, 192',
           '2017, 3': '153, 156, 0', '2017, 4': '153, 156, 64',
           '2017, 5': '153, 156, 128', '2017, 6': '153, 156, 192',
           '2017, 7': '153, 157, 0', '2017, 8': '153, 157, 64',
           '2017, 9': '153, 157, 128', '2017, 10': '153, 157, 192',
           '2017, 11': '153, 158, 0', '2017, 12': '153, 158, 64',
           '2018, 1': '153, 158, 192', '2018, 2': '153, 159, 0',
           '2018, 3': '153, 159, 64', '2018, 4': '153, 159, 128',
           '2018, 5': '153, 159, 192', '2018, 6': '153, 160, 0',
           '2018, 7': '153, 160, 64', '2018, 8': '153, 160, 128',
           '2018, 9': '153, 160, 192', '2018, 10': '153, 161, 0',
           '2018, 11': '153, 161, 64', '2018, 12': '153, 161, 128',
           '2019, 1': '153, 162, 0', '2019, 2': '153, 162, 64',
           '2019, 3': '153, 162, 128', '2019, 4': '153, 162, 192',
           '2019, 5': '153, 163, 0', '2019, 6': '153, 163, 64',
           '2019, 7': '153, 163, 128', '2019, 8': '153, 163, 192',
           '2019, 9': '153, 164, 0', '2019, 10': '153, 164, 64',
           '2019, 11': '153, 164, 128', '2019, 12': '153, 164, 192',
           '2020, 1': '153, 165, 64', '2020, 2': '153, 165, 128',
           '2020, 3': '153, 165, 192','2020, 4': '153, 166, 0',
           '2020, 5': '153, 166, 64', '2020, 6': '153, 1, 128',
           '2020, 7': '153, 166, 192', '2020, 8': '153, 167, 0',
           '2020, 9': '153, 167, 64','2020, 10': '153, 167, 128',
           '2020, 11': '153, 167, 192', '2020, 12': '153, 168, 0'}

def year_month(x1, x2):  # {x,X,X,x,x }

    for key, value in ym_list.items():
        key = [int(k) for k in key.replace("'", "").split(", ")]
        value = [int(v) for v in value.split(", ")]
        if x1 == value[1] and x2 // 64 == value[2] // 64:
            return key
    return 0, 0
Olen kindel, et aega kulutades on võimalik seda segadust lahendada.
Edasi tuleb funktsioon, mis tagastab datetime objekti stringist. Skript:
def find_data_time(val:str):
    val = [int(v) for v in val.split(", ")]
    day = day_(val[2])
    hour = hour_(val[2], val[3])
    minutes = min_(val[3], val[4])
    year, month = year_month(val[1], val[2])
    return datetime(year, month, day, hour, minutes)
Oli võimalik tuvastada sageli korduvad väärtused int, int, datetime, datetime 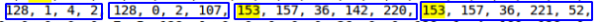 , näib, et see on just see, mida on vaja. Lisaks, sellist järjestust ei kordata kaks korda stringis.
Kasutades regulaarset väljendit, leiame vajalikud andmed:
fined = re.findall(r'128, d*, d*, d*, 128, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*', int_array)Pange tähele, et selle väljendiga otsides ei suuda me tuvastada NULL väärtusi nõutavates väljad, kuid minu puhul ei ole see kriitiline. Pärast seda iteratsiooni käime läbi leitud tulemused. Skript:
tulemus = []
for val in fined:
    eelne_result = []
    bd_int  = re.findall(r"128, d*, d*, d*", val)
    bd_date= re.findall(r"(153, 1[6,5,4,3]d, d*, d*, d*)", val)
    for it in bd_int:
        eelne_result.append(find_int(bd_int[it]))
    for bd in bd_date:
        eelne_result.append(find_data_time(bd))
    tulemus.append(eelne_result)
Tegelikult on kõik, andmed massiivist result, need on vajalikud andmed.
Mõistan, et see meetod ei pruugi kõigile sobida, kuid artikli peamine eesmärk on pigem innustada tegutsema, kui lahendada kõiki teie probleeme. Arvan, et kõige õigem lahendus oleks alustada algkoodi uurimisest. , kuid piiratud aja tõttu tundus praegune meetod kõige kiirem.
Mõnel juhul, faili analüüsides, suudate määrata ligikaudse struktuuri ja taastada selle ühel standardmeetoditest, mis on toodud ülal. See oleks palju õigem ja tekitaks vähem probleeme.
Allikas: habr.com
