

Uues Me arutasime RabbitMQ klasterdamist, et tagada talitlushäirete ja kõrge kättesaadavuse. Nüüd süveneme Apache Kafka.
Siin on replikatsiooniüksuseks partitsioon (partition). Igal teemal on üks või mitu partitsiooni. Igas partitsioonis on juht ja võimalikud järgijad või mitte. Teema loomisel määratakse partitsioonide arv ja replikatsiooni koefitsient. Tavaline väärtus on 3, mis tähendab kolme replikatsiooni: üks juht ja kaks järgijat.
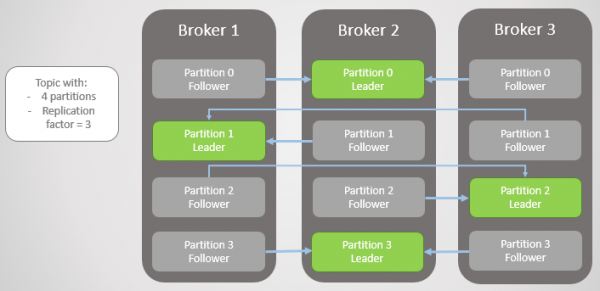
Joon. 1. Neli partitsiooni on jaotatud kolme maakleri vahel
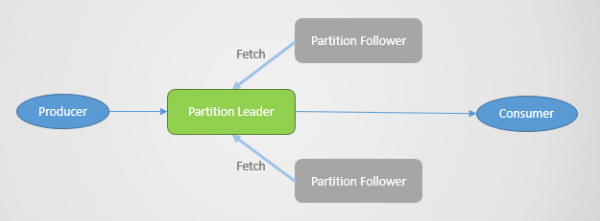
Kõik lugemis- ja kirjutamissoovid suunatakse juhile. Järgijad saadavad juhile perioodiliselt päringuid viimaste sõnumite saamiseks. Tarbijad ei pöördu kunagi järgijate poole, viimased eksisteerivad ainult üleliigsuse ja talitlushäirete kindlustamiseks.
Partitsiooni rike
Kui maakler kaob, jäävad sageli mitme partitsioonijuhid ilma. Igas nendes määratakse uueks juhiks teine sõlm. Tegelikult ei pruugi see alati nii olla, kuna mõjutab ka sünkroniseerimise tegur: kas on sünkroniseeritud järgijaid ja kui neid ei ole, kas on lubatud üleminek sünkroniseerimata replikale. Aga hetkel ei hakka me seda keeruliseks muutma.
Võrgust kaob maakler 3 — ja partitsioonile 2 valitakse uus juht maakleris 2.
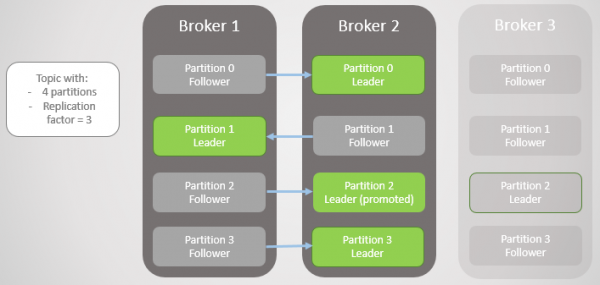
Joon. 2. Maakler 3 sureb ja tema järgija maakleris 2 valitakse partitsiooni 2 uueks juhiks
Seejärel kaob maakler 1 ja partitsioon 1 kaotab oma juhi, mille roll läheb maaklerile 2.
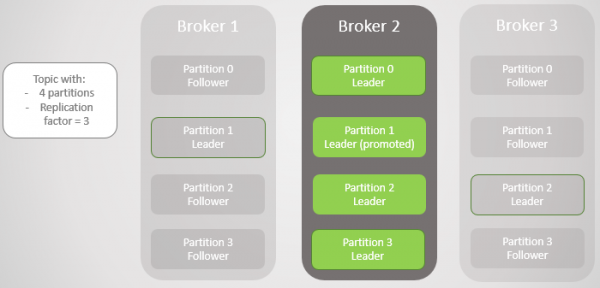
Joon. 3. Järele on jäänud ainult üks maakler. Kõik juhid asuvad ühes maakleris nulli üleliigsusega
Kui maakler 1 tuleb võrku tagasi, lisab ta neli järgijat, tagades igale partitsioonile teatava üleliigsuse. Kuid kõik juhid jäävad endiselt maaklerisse 2.
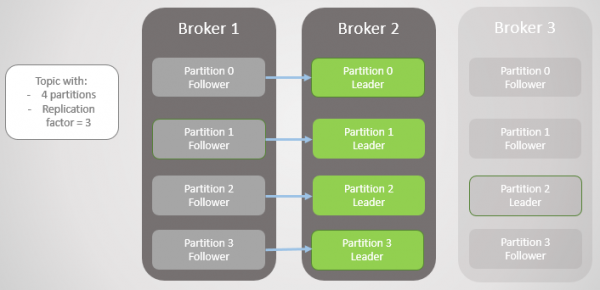
Joon. 4. Juhid jäävad maaklerisse 2
Kui maakler 3 käivitatakse, naaseme kolme replikatsiooni juurde partitsioonis. Kuid kõik juhid jäävad endiselt maaklerisse 2.
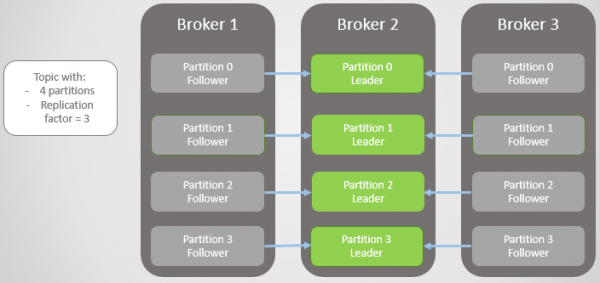
Joon. 5. Ebaühtlane juhtide paigutus pärast maaklerite 1 ja 3 taastumist
Kafkal on tööriist juhtide tõhusamaks ümberjaotamiseks kui RabbitMQ-l. Seal tuli kasutada kolmandate osapoolte pistikut või skripti, mis muutis poliitikaid peamise sõlme migreerimise nimel, vähendades samal ajal üleliigsust migreerimise ajal. Lisaks pidid suurte järjekordade korral leppima kättesaamatusega sünkroniseerimise ajal.
Kafkal on mõisted „soovitavad koopiaid“ liidri rolli jaoks. Kui teema osad luuakse, püüab Kafka juhtide jaotuse tasakaalu ning märgib need esimesed juhid kui soovitatavad. Aja jooksul serverite taaskäivituste, tõrgete ja ühenduse katkemise tõttu võivad juhid sattuda teistele sõlmedele, nagu eelnevalt kirjeldatud äärmuslikul juhul.
Selle parandamiseks pakub Kafka kahte varianti:
- Valik auto.leader.rebalance.enable=true see võimaldab kontrolleri sõlmel automaatselt juhtida juhte tagasi soovitatavatele koopiatele ja taastada seeläbi tasakaalustatud jaotuse.
- Administraator saab käivitada skripti kafka-preferred-replica-election.sh kopeerimise käsitsi ümbernimetamiseks.
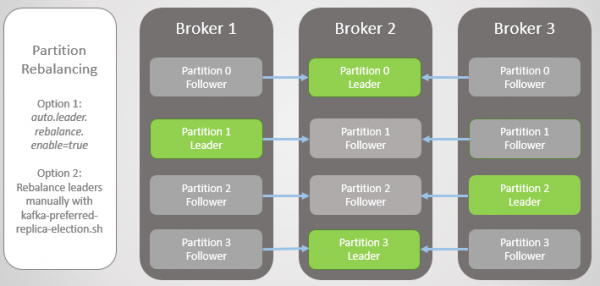
Kujutis 6. Koopiad pärast ümberjaotust
See oli lihtsustatud tõrkeversioon, kuid reaalsus on keerulisem, kuigi siin pole midagi liiga keerulist. Kõik tugineb sünkroonitud koopiatele (In-Sync Replicas, ISR).
Sünkroonitud koopiad (ISR)
ISR on sektsiooni koopiate kogum, mida peetakse „sünkroonitud“ (in-sync). Siin on juht, kuid järgijaid ei pruugi olla. Järgija loetakse sünkroonitud, kui ta on teinud täpsed kopeerimised kõikidest sõnumitest liider enne vaheaja möödumist replica.lag.time.max.ms.
Järjeks hodpareltakse ISR-st, kui ta:
- ei ole kutsunud kaevet vooru jooksul replica.lag.time.max.ms (loetakse surnuks)
- ei ole ajaga värskendatud replica.lag.time.max.ms (loetakse aeglaseks)
Järgjad teevad kaevet vooru intervallis replica.fetch.wait.max.ms, mis vaikimisi on 500 ms.
ISR-i eesmärgi selgeks tegemiseks tuleb vaadata tootjalt saabuvaid kinnitusd ja mõned väljalangemisstsenaariumid. Tootjad võivad valida, millal maakler saadab kinnituse:
- acks=0, kinnitust ei saadeta
- acks=1, kinnitust saadetakse pärast seda, kui liider on sõnumi oma kohalikku logi salvestanud
- acks=all, kinnitust saadetakse pärast seda, kui kõik koopiad ISR-is on sõnumi kohalikesse logidesse salvestanud
Kafkas terminoloogias, kui ISR on sõnumi salvestanud, toimub selle „kinnitamine“. Acks=all on kõige turvalisem valik, kuid see toob kaasa ka täiendava viivituse. Vaadakem kahte tõrke näidet ja kuidas erinevad 'acks' valikud suheldes ISR kontseptsiooniga.
Acks=1 ja ISR
Selles näites näeme, et kui liider ei oota, et iga sõnum kõikidelt jälgijatelt salvestatakse, võib juhi tõrke korral andmeid kaotsi minna. Üleminek sünkroonimata jälgijale võib olla lubatud või keelatud seadistusega unclean.leader.election.enable.
Selles näites on tootjal seadistatud acks=1. Jagune on jaotatud kolme maakleri vahel. Maakler 3 on maas, ta sünkroonis liidriga kaheksa sekundit tagasi ja nüüd on tal 7456 sõnumi kaugus. Maakler 1 on maas vaid ühe sekundi. Meie tootja saadab sõnumi ja saab kiiresti ack'i tagasi, ilma ülekoormuseta aeglastele või surnud jälgijatele, kes liidrit ei oota.
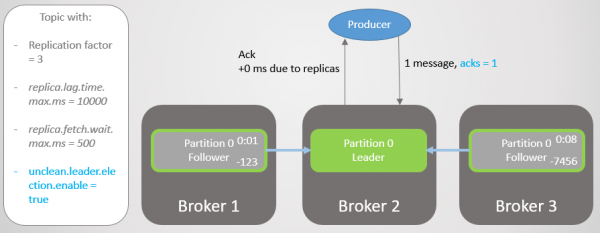
Joonis 7. ISR kolme replikaga
Maakler 2 langeb välja ja tootja saab ühenduse tõrke. Pärast juhtimise üleminekut maaklerile 1 kaotame 123 sõnumit. Jälgija maakleris 1 oli ISR-is, kuid ei olnud täielikult liidriga sünkroonitud, kui too kukkus.
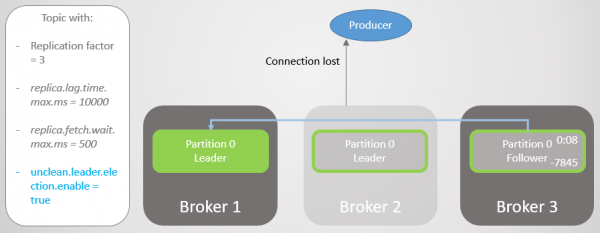
Joonis 8. Tõrke korral kaovad sõnumid
Konfiguratsioonis bootstrap.servers on tootjal loetletud mitu maaklerit ja ta võib küsida teiselt maaklerilt, kes on saanud jagundi uue liidri. Seejärel loob ta ühenduse maakleriga 1 ja jätkab sõnumite saatmist.
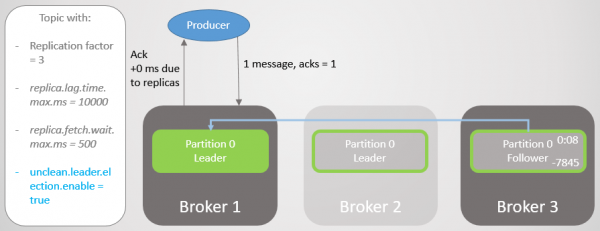
Joonis 9. Sõnumite saatmine jätkub pärast lühikest pausi
Maakler 3 on veelgi rohkem mahajäämuses. Ta teeb päringuid, kuid ei saa sünkroonida. See võib olla tingitud aeglasest võrguühendusest maaklerite vahel, salvestamise probleemidest jne. Ta eemaldatakse ISR-ist. Nüüd koosneb ISR ühest replikast — liidrist! Tootja jätkab sõnumite saatmist ja kinnituste saamist.
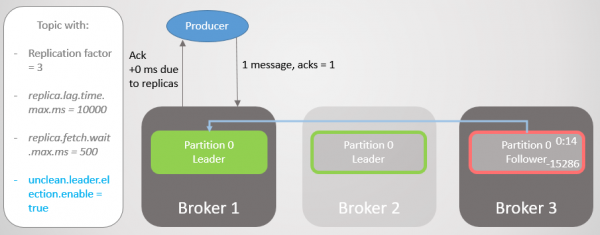
Joonis 10. Jälgija maakleris 3 eemaldatakse ISR-ist
Maakler 1 kukub ja liidri roll läheb maaklerile 3, kaotades 15286 sõnumit! Tootja saab ühenduse tõrke teate. Üleminek liidrile väljaspool ISR-i oli võimaldanud ainult seadistuse tõttu unclean.leader.election.enable=true. Kui see on seadistatud false, siis üleminekut ei toimuks ja kõik lugemise ja kirjutamise päringud oleksid tagasi lükatud. Sellisel juhul ootame maakler 1 naasmist tema puutumatute andmetega replikas, mis taas võtab juhi rolli.
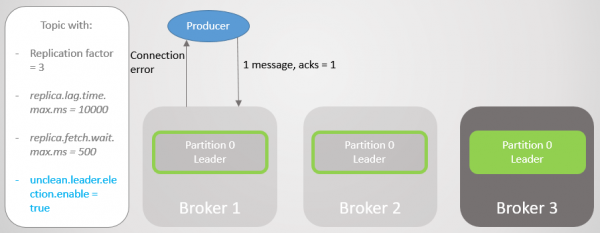
Joonis 11. Maakler 1 kukub. Suur osa sõnumitest kaob tõrke korral
Tootja loob ühenduse viimase maakleriga ja näeb, et see on nüüd jaotise juht. Ta hakkab saatma sõnumeid maaklerile 3.
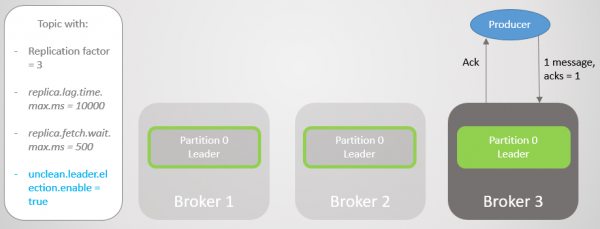
Joonis 12. Pärast lühikest pausi saadetakse sõnumid uuesti jaotisse 0.
Oleme näinud, et lisaks lühikestele pausidele uute ühenduste seadistamiseks ja uue juhi leidmiseks, saatis tootja pidevalt sõnumeid. See konfiguratsioon tagab kättesaadavuse koos järjepidevuse (andmete turvalisuse) nõudega. Kafka kaotas tuhandeid sõnumeid, kuid jätkas uute kirjade vastuvõtmist.
Acks=all ja ISR.
Korrake seda stsenaariumi veel kord, kuid koos acks=all. Maakleri 3 viivitus on keskmiselt neli sekundit. Tootja saadab sõnumi acks=all, ja nüüd ei saa ta kiiret vastust. Juht ootab, kuni kõik koopiad ISR-is sõnumi salvestavad.
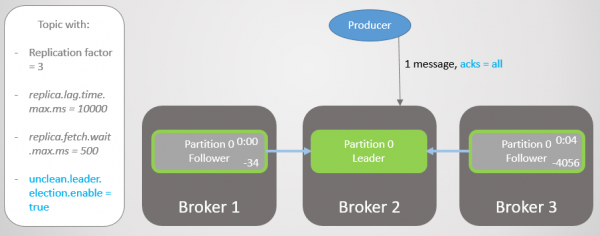
Joonis 13. ISR kolme koopiaga. Üks töötab aeglaselt, mis põhjustab salvestamise viivituse.
Pärast nelja sekundi lisaviivitust saadab maakler 2 ack. Kõik koopiad on nüüd täielikult uuendatud.
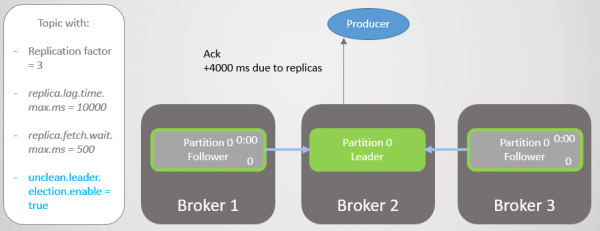
Joonis 14. Kõik koopiad salvestavad sõnumeid ja saadavad acki.
Maakler 3 jääb nüüd veelgi maha ja eemaldatakse ISR-ist. Viivitus väheneb märgatavalt, kuna ISR-is ei ole enam aeglaseid koopiaid. Maakler 2 ootab nüüd ainult maaklerit 1, kellel on keskmine viivitus 500 ms.
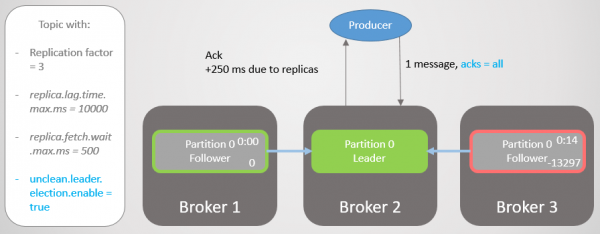
Joonis 15. Koopia maakleris 3 eemaldatakse ISR-ist.
Siis kukub maakler 2 ja juhtimine läheb maaklerile 1 ilma sõnumite kadumiseta.
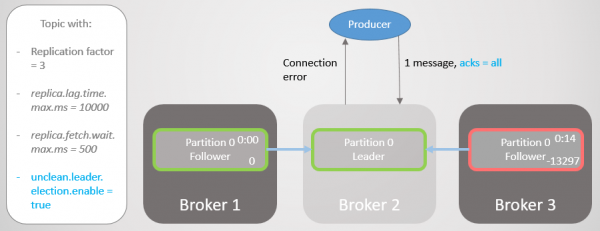
Joonis 16. Maakler 2 kukub.
Tootja leiab uue juhi ja hakkab sellele sõnumeid saatma. Viivitus väheneb veelgi, kuna nüüd koosneb ISR ühest koopiast! Seetõttu võimalus acks=all ei lisa liigset turvalisust.
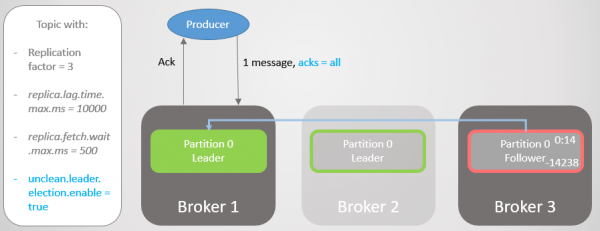
Joonis 17. Koopia maakleris 1 võtab juhtimise üle ilma sõnumite kadumiseta.
Siis kukub maakler 1 ja juhtimine läheb maaklerile 3, mille käigus kaob 14238 sõnumit!
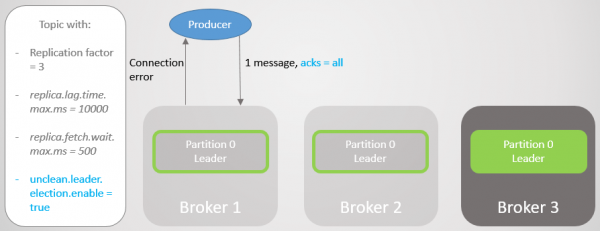
Joonis 18. Maakler 1 sureb ja juhtimise üleminek määranguga unclean toob kaasa ulatusliku andmekao.
Me oleksime võinud mitte seada võimalust unclean.leader.election.enable väärtuseks true. Vaikimisi on see false. Seadistus acks=all jot unclean.leader.election.enable=true tagab kättesaadavuse koos mõningase täiendava andmete turvalisusega. Kuid nagu näete, võime siiski sõnumeid kaotada.
Aga mis siis, kui me tahame andmete turvalisust suurendada? Saame seadistada unclean.leader.election.enable = false, kuid see ei pruugi meid kaitsta andmete kaotuse eest. Kui juht tõsiselt kokku kukub ja andmed kaovad, on sõnumid endiselt kadunud ning juurdepääs on kadunud, kuni administraator olukorra taastab.
Parim on tagada kõigi sõnumite mitmekesisus, vastasel juhul loobuda registreerimisest. Nii et vähemalt maaklerina on andmete kaotus võimalik ainult kahe või enama samaaegse rikke korral.
Acks=all, min.insync.replicas ja ISR
Teema konfiguratsiooniga min.insync.replicas tõstame andmete turvalisuse taset. Kordame veel kord eelmise stsenaariumi viimast osa, kuid seekord koos min.insync.replicas=2.
Nii et maakleril 2 on replikatsiooni juht ja jälgija maakleril 3 on ISR-ist eemaldatud.
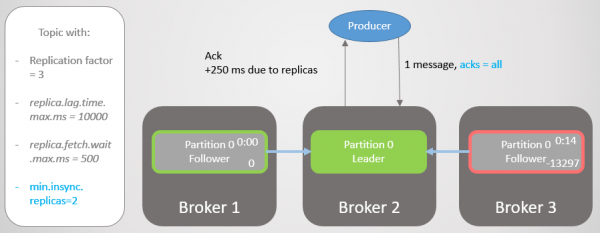
Joon. 19. ISR kahest replikast
Maakler 2 kukub kokku ja juhtimine üleminek maaklerile 1 ilma sõnumite kaotuseta. Kuid nüüd koosneb ISR ainult ühest replikast. See ei vasta minimaalsetele nõuetele kirje saamiseks ja seetõttu vastab maakler kirje tegemise katsele veaga. NotEnoughReplicas.
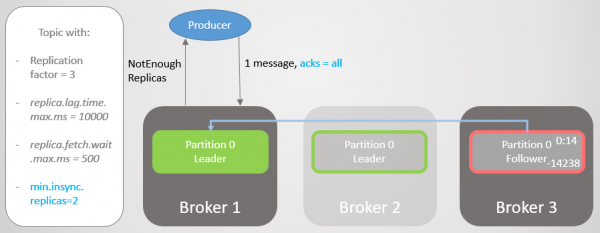
Joon. 20. ISR arv on üks vähem, kui on näidatud min.insync.replicas
See konfigureerimine ohverdab kättesaadavuse ühtsuse nimel. Enne sõnumi kinnitamist tagame, et see salvestatakse vähemalt kahele replikale. See annab tootjale palju suurema kindluse. Siin on sõnumite kaotus võimalik ainult kahe replikasi samaaegse rikke korral lühikeses ajavahemikus, enne kui sõnum on replikatsiooniks lisajälgijale, mis on ebatõenäoline. Kuid kui olete superparanoiline, võite seadistada replikatsiooni koefitsiendi 5 ja min.insync.replicas 3. Siin peavad kohe kolm maaklerit kokku kukkuma, et kirje kaotada! Muidugi, sellise usaldusväärsuse eest maksate lisaviivituse.
Kui kättesaadavus on andmete turvalisuse jaoks vajalik
Nagu ka , mõnikord on kättesaadavus andmete turvalisuse jaoks vajalik. Peate mõtlema järgmisele:
- Kas avaldaja saab lihtsalt vea tagastada ja ülemine teenus või kasutaja proovida hiljem uuesti?
- Kas avaldaja saab sõnumi kohapeal või andmebaasis hoida, et proovida hiljem uuesti?
Kui vastus on negatiivne, siis kättesaadavuse optimeerimine suurendab andmete turvalisust. Te kaotate vähem andmeid, kui valite kättesaadavuse salvestamise keeldumise asemel. Seega on kõik tasakaalu leidmise küsimus ja otsus sõltub konkreetsest olukorrast.
ISR tähendus
ISR komplekt võimaldab leida optimaalse tasakaalu andmete turvalisuse ja viivituse vahel. Näiteks tagab see kättesaadavuse enamiku koopiate rikke korral, minimeerides surnud või aeglaste koopiate viivituse mõju.
Me ise valime väärtuse replica.lag.time.max.ms vastavalt oma vajadustele. Sisuliselt tähendab see parameeter, millise viivituse oleme valmis aktsepteerima acks=all. Vaikimisi on väärtus kümme sekundit. Kui see on teie jaoks liiga kaua, siis võite seda vähendada. Sel juhul suureneb ISR-i muutuste sagedus, kuna järgijad eemaldatakse ja lisatakse sagedamini.
RabbitMQ-s on lihtsalt peegelduse komplekt, mida tuleb replitseerida. Aeglaselt toimivad peegeldused toovad kaasa lisaviivituse ja surnud peegelduste vastamist võib oodata pakettide eluea lõppemiseni, mis kontrollivad iga sõlme kättesaadavust (net tick). ISR on huvitav viis nende viivituse probleemide vältimiseks. Kuid me riskime üleliigsuse kaotamisega, kuna ISR võib lüheneda ainult liidrini. Selle riski vältimiseks kasutage seadistust. min.insync.replicas.
Kliendiühenduse garantii
Seadetes bootstrap.servers tootjat ja tarbijat saab määrata mitmeid brokereid klientide ühendamiseks. Idee on, et ühe sõlme väljalangemise korral jääb veel mitu varusõlme, millega klient saab ühenduse luua. Need ei pea olema jagamise liidrid, vaid lihtsalt tugipunkt alglaadimiseks. Klient võib nende käest küsida, millisel sõlmel asub jagamise liider lugemiseks/kirjeldamiseks.
RabbitMQ-s saavad kliendid ühenduda mis tahes sõlmega ning sisemine marsruutimine saadab päringu sinna, kuhu vaja. See tähendab, et saate seadistada koormuse tasakaalustaja RabbitMQ ees. Kafka nõuab, et kliendid ühenduksid sõlmega, kus asub vastava jagamise liider. Sellises olukorras ei saa koormuse tasakaalustajat seadistada. Loend bootstrap.servers on kriitilise tähtsusega, et kliendid saaksid suhelda vajalike sõlmedega ja leida need pärast riket.
Kafka konsensuse arhitektuur
Klassi senik ei ole käsitlenud, kuidas klaster saadab teate võrgu puudumise kohta ja kuidas valitakse uus juht. Et mõista, kuidas Kafka töötab võrgu osadega, on kõigepealt vajalik mõista konsensuse arhitektuuri.
Iga Kafka klaster on seadistatud koos Zookeeper klastri - see on jaotatud konsensuse teenus, mis võimaldab süsteemil saavutada konsensust teatud oleku kohta prioriteediga järjepidevuse üle kerguse. Lugemise ja kirjutamise toimingute heakskiitmiseks on vajalik Zookeeper'i enamus nõusolek.
Zookeeper salvestab klastri oleku:
- Teemade, osade, seadistuse, praeguste liidrite koopia, eelistatud koopiate loetelu.
- Klastri liikmed. Iga broker saadab pingi Zookeeper'i. Kui Zookeeper ei saa pingi teate antud ajavahemiku jooksul, registreerib ta brokero kui kättesaamata.
- Peamise ja varu sõlmede valimine kontrollerile.
Kontrolleri sõlm on üks Kafka brokereid, kes vastutab koopiate liidrite valimise eest. Zookeeper saadab kontrollerile teateid klastri liikmelisuse ja teema muudatuste kohta ning kontroller peab nende muudatustega arvestama.
Näiteks, võtame uue teema kümne osaga ja koopiate suhe 3. Kontroller peab valima iga osa liidri, püüdes optimaalselt jagada liidreid brokede vahel.
Iga osa puhul kontroller:
- uuendab Zookeeperis ISR ja liidri teavet;
- saadab iga brokeri, kes haldab selle osa koopiat, LeaderAndISRCommand'i käsu, teavitades brokereid ISR ja liidri kohta.
Kui liidri broker kukub, saadab Zookeeper teate kontrollerile ja see valib uue liidri. Veel kord, kontroller uuendab esmalt Zookeeperit ja seejärel saadab igale brokerile käsu, teavitades neid juhtimisvahetusest.
Iga liider vastutab ISR komplekti eest. Konfiguratsioon replica.lag.time.max.ms määrab, kes sinna kuulub. Kui ISR muutub, edastab liider Zookeeperile uue teabe.
Zookeeper on alati teadlik igasugustest muudatustest, et juhatus saaks sujuvalt uuele liidrile liikuda, kui juhi või süsteemi katkestus toimub.
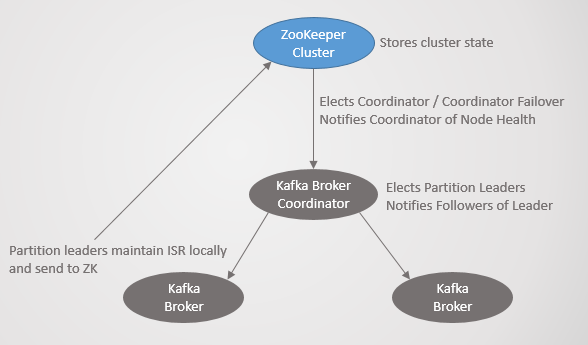
Joon. 21. Kafka konsensus
Replikatsiooni protokoll
Replikatsiooni üksikasjade mõistmine aitab paremini aru saada potentsiaalsetest andmete kadumise stsenaariumidest.
Päringud, eralduse lõpp-punkt (LEO) ja Kõrgeim Vee Mark (HW)
Me oleme uurinud, et järgijad saadavad juhile aeg-ajalt päringuid andmete tõmbamiseks (fetch). Vaikimisi intervall on 500 ms. See erineb RabbitMQ-st, kuna RabbitMQ-s algatatakse replikatsioon mitte järje peegelduse, vaid meistri poolt. Meister saadab muudatused peegeldustele.
Juht ja kõik järgijad säilitavad logi lõpu nihke (Log End Offset, LEO) ja kõrge veetase (Highwater, HW). LEO märk säilitab viimase sõnumi nihke kohalikus replikas, samas kui HW – viimase kinnituse nihke. Pidage meeles, et «kinnituse» staatuse jaoks peab sõnum olema salvestatud kõigisse replikatesse ISR. See tähendab, et LEO jääb tavaliselt natuke HW-st ette.
Kui juht saab sõnumi, salvestab ta selle kohapeal. Järgija teeb tõmbepäringu, edastades oma LEO. Siis saadab juht sõnumite paketti alates sellest LEO-st ja edastab ka aktuaalse HW. Kui juht saab teavet, et kõik replikad on säilitanud sõnumi antud nihkega, liigub ta HW märgi edasi. Ainult juht võib HW-d edasi liikuda ning seega saavad kõik järgijad selle aktuaalse väärtuse oma päringute vastustes. See tähendab, et järgijad võivad juhtist maha jääda nii sõnumites kui ka teadmises HW-st. Tarbijad saavad sõnumeid ainult kuni aktuaalse HW-ni.
Pange tähele, et «säilitatud» (persisted) tähendab salvestatud mälu, mitte kettale. Jõudluse huvides viib Kafka kettale sünkroonimise kindla intervalliga. RabbitMQ-l on samuti selline intervall, kuid see saadab kinnituse väljaandjale alles pärast seda, kui meister ja kõik peegeldused on sõnumi kettale salvestanud. Kafka arendajad otsustasid jõudluse kaalutlustel saata ack nii kiiresti, kui sõnum on mälu salvestatud. Kafka panustab, et liigse replikatsiooni kasutamine kompenseerib lühiajalise kinnitatud sõnumite salvestamise ainult mällu tekkiva riski.
Juhi rike
Kui juht langeb, teavitab Zookeeper kontrollerit, kes valib uue juhi replikana. Uus juht seab uue HW märgi vastavalt oma LEO-le. Siis saavad järgijad oma teavet uue juhi kohta. Olenevalt Kafka versioonist valib järgija ühe kahest stsenaariumist:
- Lühendab kohaliku logi tuntud HW-ni ja saadab uuele juhile päringu selle märgi järel olevate sõnumite kohta.
- Saadetab liidrile päringu, et teada saada HW tema liidriks valimise hetkel, ja seejärel kärbib logi kuni sellele nihkele. Seejärel hakkab ta perioodiliselt päringuid tegema valimise algusest peale.
Järgnejal võivad tekkida vajadus logi kärpimise järele järgmistel põhjustel:
- Kui liider ebaõnnestub, saab esimene järgija ISR-ist, kes on registreeritud Zookeeperis, valimistel võidu ja temast saab liider. Kõik ISR-is olevad järgijad, kuigi neid peetakse "sünkroniseeritud", ei pruugi endiselt olla saanud endiselt liidri koopiaid kõigist teadetest. On täiesti võimalik, et valitud järgijal ei ole kõige ajakohasemat koopiaid. Kafka tagab, et replikate vahel ei esine lahknevusi. Seetõttu peab iga järgija kärpima oma logi uue liidri HW väärtuseni tema valimise hetkel, et vältida lahknevusi. See on veel üks põhjus, miks seadistamine acks=all on nõudlik kooskõla tagamise jaoks.
- Teated kirjutatakse perioodiliselt kettale. Kui kõik klastrite sõlmed ebaõnnestuvad samal ajal, salvestatakse kettale replikad erineva nihkega. On täiesti võimalik, et kui maaklerid naasevad võrku, osutub uus valitud liider oma järgijatest maha jäävaks, kuna ta salvestati kettale varem kui teised.
Klastriga taaskoondumine
Klastriga taaskoondumisel replikad käituvad samamoodi nagu liidri ebaõnnestumisel: nad kontrollivad liidri replit ja kärbivad oma logi tema HW-le (valimise hetkel). Võrdlemiseks käsitleb RabbitMQ taaskoondatud sõlmi täiesti uutena. Mõlemal juhul loob maakler iga olemasoleva oleku. Kui kasutatakse automaatset sünkroniseerimist, peab meister replitseerima kogu praeguse sisu uude peegeldusse viisil "ja las kogu maailm ootab". Selle operatsiooni ajal ei aktsepteeri meister ühtegi lugemise või kirjutamise toimingut. Selline lähenemine tekitab probleeme suurte järjekordade korral.
Kafka on hajutatud päevik, ja üldiselt säilitab see rohkem sõnumeid kui RabbitMQ järjekord, kus andmed eemaldatakse järjekorrast pärast nende lugemist. Aktiivsed järjekorrad peaksid jääma suhteliselt väikesteks. Kuid Kafka on päevik oma hoidmisreeglitega, mis võivad seadistada tähtaja päevade või nädalate kaupa. Järjekorra lukustamise ja täieliku sünkroniseerimise lähenemine ei ole hajutatud päeviku jaoks täiesti vastuvõetav. Selle asemel lõikavad Kafka järgijad lihtsalt oma päeviku HW liidri peale (hetkel, mil ta valitakse), juhul kui nende koopia on liidrist ette. Enamasti, kui järgija on maas, alustab ta lihtsalt päringute tegemist, alates oma praegsest LEO-st.
Uued või taasühendatud järgijad alustavad väljaspool ISR-i ja ei osale komiteeringutes. Nad töötavad lihtsalt rühma kõrval, saades sõnumeid nii kiiresti kui saavad, kuni nad jõuavad liidrini ja sisenevad ISR-i. Siin ei ole lukustamist ja pole vaja visata ära kõiki oma andmeid.
Sidususe rikkumine
Kafkal on rohkem komponente kui RabbitMQ-l, seega on siin keerulisem käitumiste kogum, kui klastris esineb sidususe rikkumine. Kuid Kafka kavandati algselt klastrite jaoks, seega on lahendused väga hästi läbi mõeldud.
Allpool on toodud mõned sidususe rikkumise stsenaariumid:
- Stsenaarium 1. Järgija ei näe liidrit, kuid näeb endiselt Zookeeperi.
- Stsenaarium 2. Liider ei näe ühtegi järgijat, kuid näeb endiselt Zookeeperi.
- Stsenaarium 3. Järgija näeb liidrit, kuid ei näe Zookeeperi.
- Stsenaarium 4. Liider näeb järgijaid, kuid ei näe Zookeeperi.
- Stsenaarium 5. Järgija on täielikult eraldatud nii teistest Kafka sõlmedest kui ka Zookeeperist.
- Stsenaarium 6. Liider on täielikult eraldatud nii teistest Kafka sõlmedest kui ka Zookeeperist.
- Stsenaarium 7. Kafka kontrollsõlm ei näe teist Kafka sõlme.
- Stsenaarium 8. Kafka kontrollsõlm ei näe Zookeeperit.
Iga stsenaariumi jaoks on ette nähtud oma käitumine.
Stsenaarium 1. Järgija ei näe liidrit, kuid näeb endiselt Zookeeperi
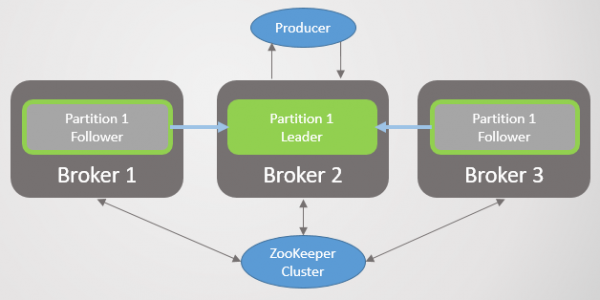
Joon. 22. Stsenaarium 1. ISR kolme replikaga
Sidususe rikkumine eraldab maakler 3 maakleritest 1 ja 2, kuid mitte Zookeeperist. Maakler 3 ei saa enam päringute tegemisega edasi minna. Aja möödudes replica.lag.time.max.ms ta eemaldatakse ISR-ist ja ei osale sõnumite commit'ides. Niipea, kui ühenduvus on taastatud, jätkab ta andmete päringute saatmist ja liitub ISR-iga, kui jõuab juhitajale järele. Zookeeper jätkab pingide vastuvõtmist ja peab brokereid elusateks.
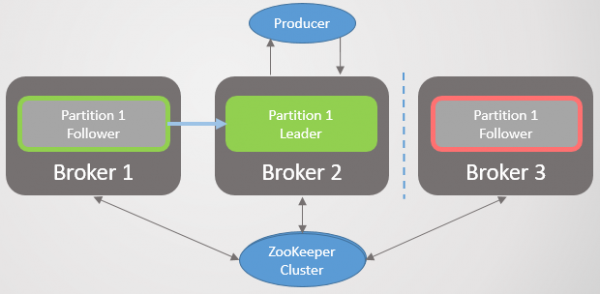
Kujund 23. Stsenaarium 1. Broker eemaldatakse ISR-ist, kui sellelt ei saadeta andmete päringut replica.lag.time.max.ms intervali jooksul
Ei ole mingit loogilist jagunemist (split-brain) ega sõlme peatamist, nagu RabbitMQ-s. Selle asemel vähendada üleliigsust.
Stsenaarium 2. Juhataja ei näe ühtegi järgijat, kuid näeb siiski Zookeeperit
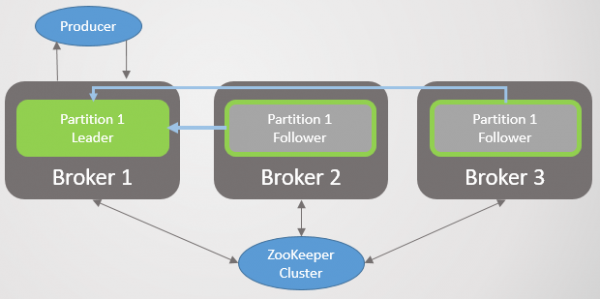
Kujund 24. Stsenaarium 2. Juhataja ja kaks järgijat
Võrgupuutumatuse rikkumine eraldab juhataja järgijatelt, kuid broker näeb Zookeeperit endiselt. Nagu esimese stsenaariumi puhul, ISR kokku tõmbub, kuid seekord ainult juhatajani, kuna kõik järgijad lõpetavad andmete päringute saatmise. Taaskord, puudub loogiline jagunemine. Selle asemel toimub uute sõnumite osas üleliigsuse kadu, kuni ühenduvus on taastatud. Zookeeper jätkab pingide vastuvõtmist ja peab brokereid elusateks.
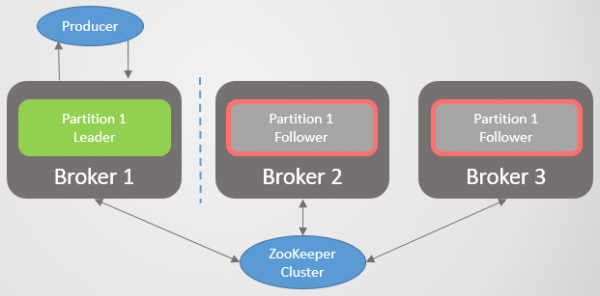
Kujund 25. Stsenaarium 2. ISR tõmbus kokku ainult juhatajani
Stsenaarium 3. Järgjat näeb juhatajat, kuid ei näe Zookeeperit
Järgjat eraldatakse Zookeeperist, kuid mitte juhatajast koos brokeritega. Selle tulemusena jätkab järgija andmete päringute saatmist ja on ISR-i liige. Zookeeper ei saa enam pingisid ja registreerib brokera kukkumise, kuid kuna tegemist on ainult järgijaga, pole taastumise järel mingeid tagajärgi.
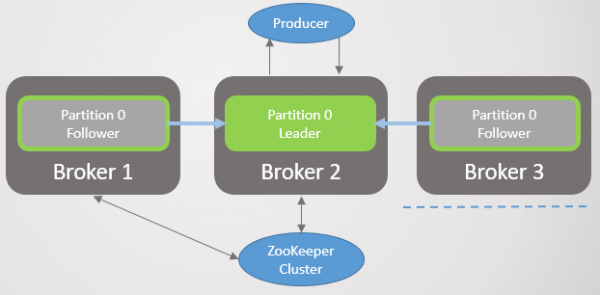
Kujund 26. Stsenaarium 3. Järgjat jätkab andmete päringute saatmist juhatajale
Stsenaarium 4. Juhataja näeb järgijaid, kuid ei näe Zookeeperit
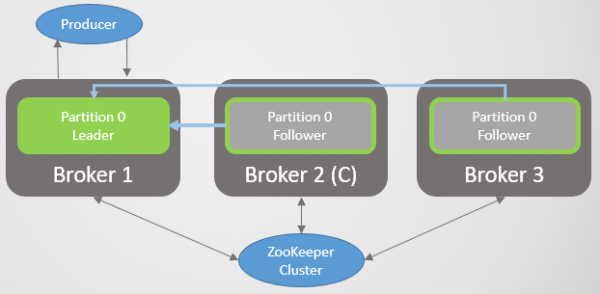
Kujund 27. Stsenaarium 4. Juhataja ja kaks järgijat
Juhataja on eraldatud Zookeeperist, kuid mitte brokeritest koos järgijatega.
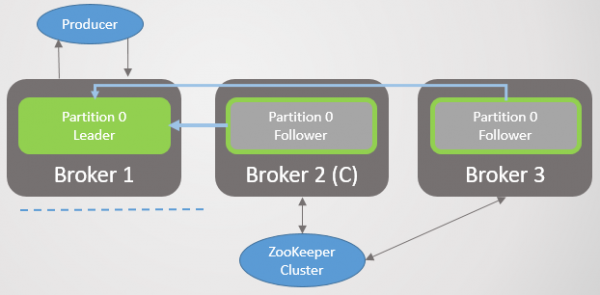
Kujund 28. Stsenaarium 4. Juhataja on Zookeeperist isoleeritud
Mõne aja pärast registreerib Zookeeper brokera kukkumise ja teavitab sellest kontrollerit. See valib järgijate hulgast uue juhataja. Kuid algne juhataja peab endiselt end juhatajaks ja jätkab kirjeid vastuvõtmist acks=1. Järgjad ei saada enam andmete päringuid, seega peab ta neid surnud ja üritab ISR-i kokku tõmmata enda peale. Kuid kuna tal puudub ühendus Zookeeperiga, ei saa ta seda teha ja loobub edasise kirje vastuvõtmisest.
Sõnumid acks=all ei saa kinnitust, kuna esmalt hõlmab ISR kõiki replikaate ja sõnumid ei jõua nende juurde. Kui algne juht üritab neid ISR-ist eemaldada, ei saa ta seda teha ja lõpetab igasuguste sõnumite vastuvõtmise.
Kliendid märkavad peagi juhi vahetust ja hakkavad saatma kirjeid uuele serverile. Kui võrk taastub, näeb algne juht, et ta ei ole enam juht ja kärbib oma logi HW väärtusele, mis oli uuel juhil enamiku katkestuse hetkel, et vältida logide erinevust. Siis hakkab ta saatma päringuid uuele juhile. Kõik algse juhi kirjed, mis ei olnud uuele juhile replitseeritud, kaovad. See tähendab, et kaovad sõnumid, mis algne juht ei ole nende paar sekundi jooksul kinnitanud, mil kaks juhti töötasid.
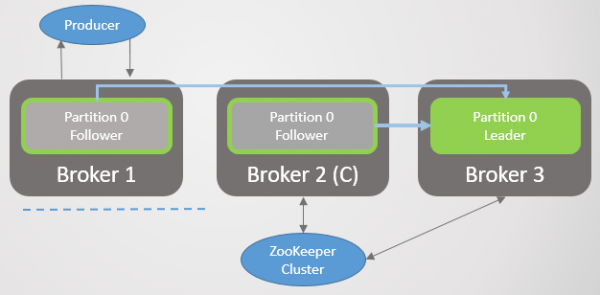
Joonis 29. Stseen 4. Juht brokeris 1 muutub järgijaks võrgu taastumise peale
Stseen 5. Järgija on täielikult eraldatud teistest Kafka sõlmedest ja Zookeeperist
Järgija on täielikult isoleeritud teistest Kafka sõlmedest ja Zookeeperist. Ta eemaldatakse ISR-ist, kuni võrk taastub, ja seejärel järgib ta teisi.

Joonis 30. Stseen 5. Isoleeritud järgija eemaldatakse ISR-ist
Stseen 6. Juht on täielikult eraldatud teistest Kafka sõlmedest ja Zookeeperist
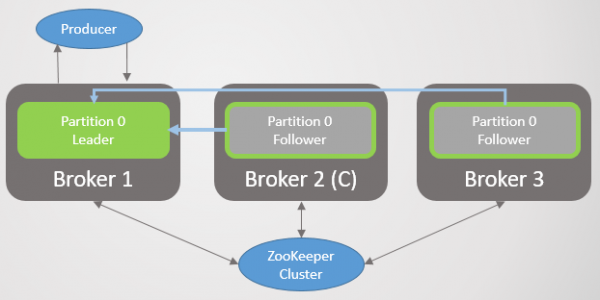
Joonis 31. Stseen 6. Juht ja kaks järgijat
Juht on täielikult isoleeritud oma järgijatest, kontrollerist ja Zookeeperist. Lühikese aja jooksul jätkab ta kirjeid vastu võtmist. acks=1.
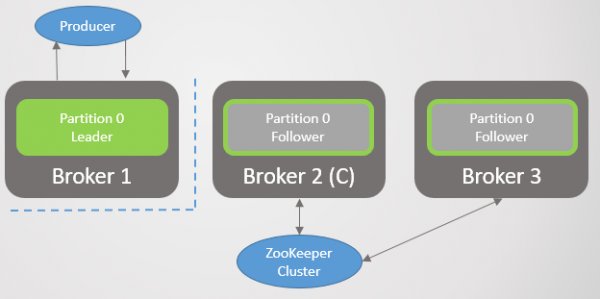
Joonis 32. Stseen 6. Juhi isoleerimine teistest Kafka sõlmedest ja Zookeeperist
Ei saa päringuid pärast replica.lag.time.max.ms, ta üritab ISR-i endaks kokku suruda, kuid ei saa seda teha, kuna Zookeeperiga pole ühendust, siis lõpetab ta kirjeid vastu võtmise.
Samaan, Zookeeper märkab isoleeritud brokerit kui surnud, ja kontroller valib uue juhi.
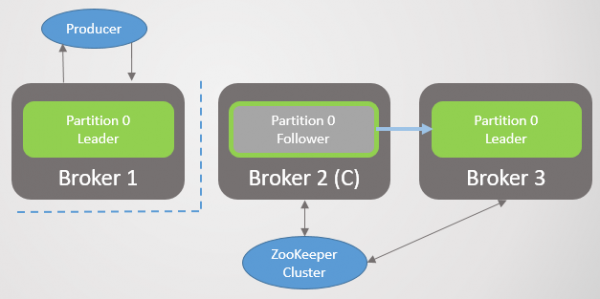
Joonis 33. Stseen 6. Kaks juhti
Algne juht võib võtta kirjeid vastu paar sekundi jooksul, kuid seejärel lõpetab ta igasuguste sõnumite vastuvõtmise. Kliendid uuendavad iga 60 sekundi tagant viimaseid metaandmeid. Nad saavad teate juhi vahetusest ja hakkavad saatma kirjeid uuele juhile.
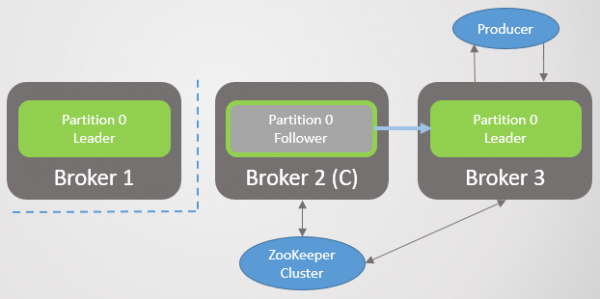
Joonis 34. Stseen 6. Tootjad lülituvad uuele juhile
Kõik kinnitatud kirjed, mille on teinud algne juht alates ühenduse kadumisest, lähevad kaotsi. Kui võrk on taastatud, avastab algne juht Zookeeperi kaudu, et ta ei ole enam juht. Seejärel lükkab ta oma logi tagasi uue juhi HW-le hetkest, mil ta valiti, ja hakkab saatma päringuid järgijana.
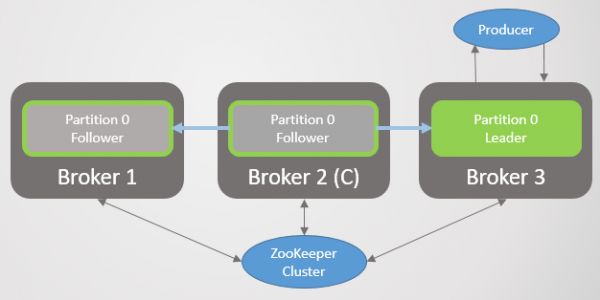
Joon. 35. Stsenaarium 6. Algne juht muutub järgijaks pärast võrgu ühenduse taastamist
Selles olukorras võib lühikese perioodi jooksul täheldada loogilist eraldatust, kuid ainult juhul kui acks=1 ja min.insync.replicas loogiline eraldatus lõppeb automaatselt kas pärast võrgu taastamist, kui algne juht mõistab, et ta ei ole enam juht, või kui kõik kliendid mõistavad, et juht on muutunud ja hakkavad kirjutama uuele juhile — sõltuvalt sellest, mis juhtub varem. Igal juhul toimub alguns sõnumite kadu, kuid ainult acks=1.
On olemas teine variant sellest stsenaariumist, kus vahetult enne võrgu eraldumist jäid järgijad maha, ja juht lühendas ISR-i vaid endani. Siis eraldub ta ühenduse kaotamise tõttu. Valitakse uus juht, kuid algne juht jätkab kirjete vastuvõttu isegi acks=all, kuna ISR-is pole kedagi peale tema. Need kirjed lähevad võrgu taastamisel kaotsi. Ainus viis sellise variandi vältimiseks on min.insync.replicas = 2.
Stsenaarium 7. Kafka kontroller ei näe teist Kafka sõlme
Üldiselt, pärast ühenduse katkemist Kafka sõlmega ei suuda kontroller edastada sellele mingit teavet juhi vahetamise kohta. Halvimal juhul toob see kaasa lühiajalise loogilise eraldatuse, nagu stsenaarium 6. Enamasti ei saa maakler lihtsalt juhtivaks kandidaadiks, kui viimane ebaõnnestub.
Stsenaarium 8. Kafka kontroller ei näe Zookeeperi
Ebatavalise Zookeeperi kontroller ei saa pinget ja valib uue Kafka sõlme kontrolleriks. Algne kontroller võib jätkata enda esindamist kui sellist, kuid ei saa Zookeeperilt teateid, seega puuduvad tal ülesanded täitmiseks. Kui võrk taastub, mõistab ta, et ta ei ole enam kontroller, vaid saanud tavaline Kafka sõlm.
Järeldused stsenaariumitest
Näeme, et jälgijate ühenduse kadumine ei too kaasa sõnumite kaotust, vaid lihtsalt ajutiselt vähendab ülejäätuvust, kuni võrk taastub. See võib muidugi põhjustada andmete kaotust, kui üks või mitu sõlme on kadunud.
Kui ühenduse kadumise tõttu juhiühendus Zookeeperist katkeb, võib see tuua kaasa sõnumite kadumise. acks=1. Ühenduse puudumine Zookeeperiga põhjustab lühiajalise loogilise jagunemise kahe juhiga. Selle probleemi lahendab parameeter acks=all.
Parameeter min.insync.replicas kahe või enama replikaga, mis annab täiendavaid garanteeringuid, et sellised lühiajalised stsenaariumid ei too kaasa sõnumite kaotust, nagu stsenaariumis 6.
Sõnumite kaotuse kokkuvõte
Loetleme kõik viisid, kuidas andmed Kafka-s võivad kaduda:
- Iga juhi rike, kui sõnumid on kinnitatud acks=1
- Iga räpane juhtimise üleminek, st jälgijale, mis on väljaspool ISR-i, isegi acks=all
- Juhi isoleerimine Zookeeperist, kui sõnumid on kinnitatud acks=1
- Juhi täielik isoleerimine, kes on juba tõmmanud ISR-i rühma endast alla. Kõik sõnumid on kadunud, isegi acks=all. See on tõsi ainult juhul, kui min.insync.replicas=1.
- Kõikide jaotuse sõlmede samal ajal rikke. Kuna sõnumid kinnitatakse mälust, võib osa neist veel ketta kirjutamata jääda. Serverite taaskäivitamisel võib mõnest sõnumist puudu olla.
Räpase juhtimise üleminekuid saab vältida kas nende keelamise või vähemalt kahe replikatsiooni tagamisega. Kõige usaldusväärsem konfiguratsioon on kombinatsioon acks=all ja min.insync.replicas rohkem kui 1.
Langetades RabbitMQ ja Kafka usaldusväärsuse vahetut võrdlust.
Usaldusväärsuse ja kõrge kättesaadavuse tagamiseks on mõlemal platvormil rakendatud peamise ja sekundaarse replikatsiooni süsteem. Kuid RabbitMQ-l on Achilleuse kand. Vigade taastumisel viskavad sõlmed oma andmed ära ja sünkroonimine blokeeritakse. See kahekordne löök seab kahtluse alla suurte järjekordade pikaealisuse RabbitMQ-s. Peate leppima kas vähendatud ülejäätuvuse või pikaajaliste blokeeringutega. Ülejäätuvuse vähendamine suurendab massiliste andmekao riski. Ent kui järjekorrad on väikesed, saab ülejäätuvuse tagamiseks lühikeste mittesaadavuse perioodide (mõned sekundid) tõttu hakkama ühenduse uuesti proovimisega.
Kafkas ei ole sellist probleemi. See viskab andmed kõrvale ainult liidri ja järgija vaheline erinevuse kohalt. Kõik ühised andmed säilivad. Lisaks ei blokeeri replikatsioon süsteemi. Liider jätkab sisestuste vastuvõtmist, samal ajal kui uus järgija teda järele jõuab, mistõttu on devops'i jaoks klastriga liitumine või uuesti liitumine triviaalne ülesanne. Loomulikult jäävad kõrvale ka probleemid, nagu replikatsiooni ajal võrgu läbilaskevõime. Kui korraga lisatakse mitu järgijat, võib esineda läbilaskevõime piirangut.
RabbitMQ ületab Kafkat usaldusväärsuses, kui mitme serveri rike klastris on samaaegselt toimunud. Nagu me juba rääkisime, saadab RabbitMQ avaldajale kinnituse alles pärast sõnumi kirjutamist kettale peamisel ja kõikidel peegeldustel. Kuid see toob kaasa täiendava viivituse kahe põhjuse tõttu:
- fsync iga paari sajandi millisekundi järel
- Peegeldamise katkestust saab märgata alles pakettide eluea möödumisel, mis kontrollivad iga sõlme kättesaadavust (net tick). Kui peegel on blokeeritud või väljas, lisab see viivituse.
Kafka panustab sellele, et kui sõnum on salvestatud mitmele sõlmele, saab sõnumeid kinnitada, niipea kui need on mällu jõudnud. Seetõttu on oht kaotada sõnumeid igasuguses vormis (isegi acks=all, min.insync.replikad=2) juhul, kui samal ajal toimub rike.
Üldiselt näitab Kafka kõrgemat jõudlust ja on algselt projekteeritud klastrite jaoks. Järgjate arvu saab suurendada kuni 11-ni, kui see on vajalik usaldusväärsuse saavutamiseks. Replikatsiooni suhe 5 ja miniaalne arv sünkroonitud replikate min.insync.replicas=3 teevad sõnumi kaotamise väga harvaks sündmuseks. Kui teie infrastruktuur suudab pakkuda sellist replikatsiooni suhet ja taseme üleliigsust, võite valida selle variandi.
RabbitMQ klasterdamine sobib väikeste järjekordade jaoks. Kuid isegi väikesed järjekorrad võivad suure liikluse korral kiiresti kasvada. Kui järjekorrad saavad suurteks, tuleb teha kindel valik kättesaadavuse ja usaldusväärsuse vahel. RabbitMQ klasterdamine sobib kõige paremini ebatüüpiliste olukordade jaoks, kus RabbitMQ paindlikkuse eelised kaaluvad üles selle klasterdamise puudused.
Üks vastumürk RabbitMQ haavatavusele suurte järjekordade osas on jagada need paljudeks väiksemateks. Kui ei nõuta kogu järjekorra täielikku järjestamist, vaid ainult konkreetsete sõnumite (näiteks konkreetse kliendi sõnumite) või hoopis midagi ei järjestata, on see variant aktsepteeritav: vaadake minu projekti järjekorra jagamiseks (projekt on veel varases staadiumis).
Lõpuks ärge unustage rida vigu klastrite ja replikatsiooni mehhanismides nii RabbitMQ-s kui ka Kafka-s. Aja jooksul on süsteemid muutunud küpsemaks ja stabiilsemaks, kuid ükski sõnum ei ole kunagi 100% kaitstud kadumise eest! Lisaks esinevad andmekeskustes suured õnnetused!
Kui olen midagi vahele jätnud, teinud vea või te ei nõustu mõne väitega, ärge kartke kirjutada kommentaar või võtta minuga ühendust.
Küsimus, mida sageli küsin: "Mida valida, Kafka või RabbitMQ?", "Milline platvorm on parem?". Tõde on see, et see sõltub tõeliselt teie olukorrast, praegusest kogemusest jne. Ma ei julge oma arvamust avaldada, kuna oleks liiga suur lihtsustamine soovitada üksikut platvormi kõikide kasutusvõimaluste ja võimalike piirangute jaoks. Olen kirjutanud selle artiklite seeria, et saaksite kujundada oma arvamuse.
Tahan öelda, et mõlemad süsteemid on valdkonna liidrid. Võib-olla olen ma veidi kallutatud, kuna oma projektide kogemuse põhjal hindan rohkem selliseid asju nagu sõnumite garantii järjekord ja usaldusväärsus.
Näen teisi tehnoloogiaid, millel puudub see usaldusväärsus ja garanteeritud järjestamine, seejärel vaatan RabbitMQ-d ja Kafka-d — ja mõistan, kui uskumatu väärtus on mõlemas nendes süsteemides.
Allikas: habr.com
