

Tere Habr! Andmekogumid Big Data ja masinõppe jaoks kasvavad eksponentsiaalselt ja tuleb jõuda nende töötlemiseni. Meie postitus on veel ühe innovaatilise tehnoloogia kohta kõrgetasemelistes arvutustes (HPC, High Performance Computing), mis oli välja pandud Kingstonis . See on Hi-End andmesalvestussüsteemide (СХД) kasutamine graafikaprotsessoritega (GPU) serverites ja GPUDirect Storage tehnoloogia. Otsese andmevahetuse tõttu СХД ja GPU vahel, mööda CPU-d, kiireneb andmete laadimine GPU-kiirenditesse mitmekordselt, mistõttu Big Data rakendused töötavad maksimaalse jõudlusega, mille tagavad GPU-d. Omakorda huvitavad HPC-süsteemide arendajaid saavutused СХД valdkonnas, mis tagavad ülimalt kõrge sisendi/väljundi kiirus — sellised, nagu toodab Kingston.
GPU jõudlus ületab andmete laadimist
Alates CUDA loomist 2007. aastal — GPU-l põhineva paralleelse arvutusarhitektuuri, mis on mõeldud üldotstarbeliste rakenduste arendamiseks, on GPU riistvaralised võimalused tohutult kasvanud. Täna leiduvad GPU-d üha enam HPC-rakendustes, nagu suured andmed (Big Data), masinõpe (ML, machine learning) ja süvaõpe (DL, deep learning).
Kuigi terminid on sarnased, on kaks viimast algoritmiliselt erinevad ülesanded. ML õpetab arvutit struktureeritud andmete põhjal, samas kui DL toetub neuronivõrgu tagasisidele. Näide, mis aitab mõista erinevusi, on üsna lihtne. Oletame, et arvuti peab eristama fotosid kassidest ja koertest, mis laaditakse sisse HCI-st. ML jaoks tuleks esitada pildikollektsioon paljude siltidega, kus igaüks määratleb mõne loomade omaduse. DL-i puhul on piisavalt laadida palju rohkem pilte, kuid ainult ühe sildi „see on kass“ või „see on koer“ all. DL sarnaneb sellele, kuidas väikesi lapsi õpetatakse — neile lihtsalt näidatakse koerte ja kasside pilte raamatutes ja elus (enamasti isegi, nagu ei seletataks detailset erinevust), ja lapse aju hakkab iseseisvalt tuvastama looma tüüpi pärast teatud kriitilise arvu võrdluspilte (hinnanguliselt räägime kõigest sajast-kahekümnest näitamisest kogu varases lapsepõlves). DL algoritmid pole veel nii täiuslikud: et neuronivõrk suudaks edukalt kujutiste määramisel töötada, on vajalik edastada ja töödelda GPU-s miljoneid pilte.
Eelneva kokkuvõte: GPU-põhised HPC rakendused Big Data, ML ja DL valdkonnas on võimalikud, kuid probleemiks on, et andmekogud on nii suured, et andmete laadimise aeg salvestusseadmest GPU-sse hakkab vähendama rakenduse üldist jõudlust. Teisisõnu, kiired graafikaprotsessorid jäävad alakoormatud aeglaste sisend-/väljadatumise tõttu, mis tulevad teistelt alamsüsteemidelt. GPU ja CPU/HCI busside sisendi/väljundi kiirus võib olla kümneid kordi erinev.
Kuidas töötab tehnoloogia GPUDirect Storage?
Sisendi/väljundi protsessi kontrollib CPU, samuti ka andmete laadimise protsess salvestusseadmest graafikaprotsessoritesse edasiseks töötlemiseks. Seetõttu tekkis vajadus tehnoloogia järele, mis tagaks otsese ligipääsu GPU-de ja NVMe-diskide vahel kiireks suhtlemiseks. Esimese sellise tehnoloogia pakkus NVIDIA ja nimetas selle GPUDirect Storage-iks. Põhimõtteliselt on see eelnevalt välja töötatud tehnoloogia GPUDirect RDMA (Remote Direct Memory Address) variatsioon.
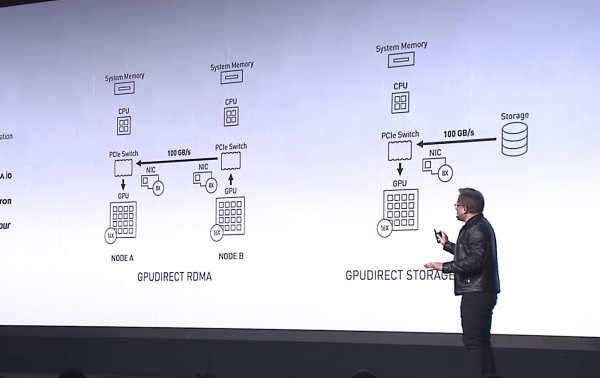
Jensen Huang, NVIDIA peadirektor, esitleb GPUDirect Storage'it GPUDirect RDMA variandina näitusel SC-19. Allikas: NVIDIA
GPUDirect RDMA ja GPUDirect Storage vahe on seadmetes, mille vahel aadresseerimine toimub. GPUDirect RDMA tehnoloogia on mõeldud andmete edastamiseks otse võrguliidese (NIC) sisendkaardilt GPU mälu, samas kui GPUDirect Storage tagab otseühenduse andmete edastamiseks kohaliku või eemal asuva salvestusseadmest, nagu NVMe või NVMe over Fabric (NVMe-oF), ja GPU mäluni.
Mõlemad variandid, GPUDirect RDMA ja GPUDirect Storage, väldivad liigsete andmete liikumisi CPU mälu puhver kaudu ja võimaldavad otsepääsu mälu mehhanismil (DMA) edastada andmeid otse võrgu- või salvestuskaardilt GPU mällu või tagasiviimise, ilma et keskpink oleks koormatud. GPUDirect Storage puhul ei oma salvestuskoha asukoht tähtsust: see võib olla NVME-disk GPU-ga seadmes, rack'is või võrgu kaudu ühendatud nagu NVMe-oF.
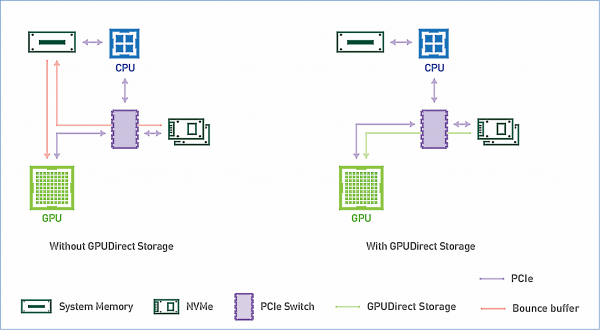
GPUDirect Storage tööpõhimõte. Allikas: NVIDIA
Hi-End NVMe SCSI-d on nõutud HPC-rakenduste turul
Tuvastades, et GPUDirect Storage'i kasutuselevõtuga hakatakse suurte klientide tähelepanu pöörama salvestussüsteemide pakkumiseks, mille IO kiirus vastab GPU läbilaskevõimele, näitas Kingston messil SC-19 demo süsteemi, mis koosnes NVMe-diskide põhinevatest SCSI-dest ja GPU seadmetest, kus analüüsiti tuhandeid satelliitpilte sekundis. Sellest SCSI-st kümne DC1000M U.2 NVMe draiviga oleme juba kirjutanud .
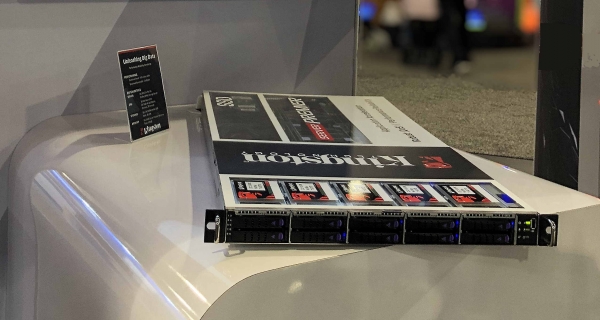
Kümne DC1000M U.2 NVMe draiviga SCSI täiendab väärikalt graafikakiirendi serverit. Allikas: Kingston
Selline SCSI on erinev 1U või suurema rack'i seadme kujul ning seda saab skaleerida vastavalt DC1000M U.2 NVMe ketaste arvule, kus igaühe maht on 3.84-7.68 TB. DC1000M on esimene NVMe SSD mudel U.2 form-factor, mis kuulub Kingston'i andmekeskuste draivide seeriasse. Selle kestvuse reiting (DWPD, Drive writes per day) võimaldab andmeid täielikult igal päeval kord kirjutada garantii kehtivusaja jooksul.
Testis fio v3.13 Ubuntu 18.04.3 LTS operatsioonisüsteemiga, Linux kernel 5.0.0-31-generic, näitas näidis SCSI lugemiskiirus (Sustained Read) 5.8 miljonit IOPS ja stabiilne läbilaskevõime (Sustained Bandwidth) 23.8 Gbit/s.
Ariël Peres, äriürituste juht SSD Kingstonis, iseloomustas uusi andmesalvestusseadmmeid järgmiselt: „Oleme valmis varustama järgmise põlvkonna servereid U.2 NVMe SSD lahendustega, et kõrvaldada paljud andmeedastusega seotud kitsaskohad, mis on traditsiooniliselt seotud salvestussüsteemidega. NVMe SSD-draivide ja meie kvaliteetse Server Premier DRAM mäluga kombinatsioon muudab Kingstoni üheks kõige täielikumaks lahenduste pakkujaks andmete töötlemise valdkonnas.”
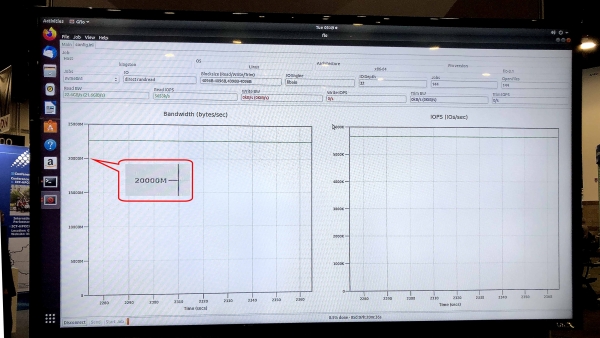
GFIO v3.13 test näitas 23,8 Gbit/s läbilaskevõimet DC1000M U.2 NVMe diskidel põhineva demonstreerimise andmesalvestusseadmme jaoks. Allikas: Kingston
Milline näeb välja tüüpiline süsteem HPC rakenduste jaoks, kus on rakendatud GPUDirect Storage tehnoloogiat või sarnaseid lahendusi? See on arhitektuur, millel on füüsiline funktsionaalsete plokkide eraldatus riiulis: üks-kaks üksust mälule, veel mõned GPU ja CPU arvutusssõlmedele ning üks või mitu üksust andmesalvestusseadmmele.
GPUDirect Storage ja teiste GPU tootjate sarnaste tehnoloogiate tutvustamisega kasvab Kingstoniseks nõudlus HPC-dele suunatud andmesalvestusseadmmete järele. Märgiks on andmete lugemise kiirus andmesalvestusseadmmetest, mis on võrreldav 40- või 100-Gbit/s võrgukaartide läbilaskekõrgenderiga GPU arvutusüksuses. Seega, ultra-kõrge kiirus, sealhulgas välised NVMe kaudu Fabric, muutuvad eksootilisest mainstreamiks HPC rakendustes. Lisaks teadusele ja finantsarvutustele leiavad need rakendust paljudes muudes praktilistes valdkondades, näiteks megapoli turvasüsteemides Safe City või transpordivalve keskustes, kus on vajalik tuvastamise ja tuvastamise kiirus, mis ulatub miljonite HD-piltide tasemele sekundis,“ märkis tippkategooria andmesalvestusseadmmete turuniši.
Lisainfo Kingston'i toodete kohta leiate ettevõttega.
Allikas: habr.com
