

Kursuse alguse eelõhtul valmistasid teile tõlke veel ühest kasulikust materjalist.
Hafmanni kodeerimine on andmete tihendusalgoritm, mis väljendab failide tihendamise põhikontseptsiooni. Selles artiklis räägime fikseeritud ja muutliku pikkusega kodeerimisest, unikaalselt dekodeeritavatest koodidest, prefiksireeglitest ja Hafmanni puu leidmisest.
Teame, et iga sümbol salvestatakse 0 ja 1 järjekorrana ja see võtab 8 bitti. Seda nimetatakse fikseeritud pikkusega kodeerimiseks, kuna iga sümbol kasutab salvestamiseks sama fikseeritud arvu bitte.
Oletame, et meil on tekst. Kuidas saame vähendada vajaminevat ruumi ühe sümboli salvestamiseks?
Peamine idee seisneb muutliku pikkusega kodeerimises. Saame kasutada asjaolu, et mõned sümbolid tekstis esinevad sagedamini kui teised (), et välja töötada algoritm, mis esindab sama sümbolite jada väiksema arvu bittidega. Muutliku pikkusega kodeerimisel määrame sümbolitele muutuva arvu bitte sõltuvalt nende esinemissagedusest antud tekstis. Lõppkokkuvõttes võivad mõned sümbolid võtta vaid 1 bitti, teised 2 bitti, 3 või rohkem. Muutliku pikkusega kodeerimise probleem seisneb vaid edaspidises järjestuse dekodeerimises.
Kuidas dekodeerida bittide järjestust ühemõtteliselt, teades seda?
Võtame arvesse järje, «aabacdab». Selles on 8 sümbolit, ja fikseeritud pikkusega kodeerimisel on selle salvestamiseks vajalik 64 bitti. Tähelepanu, et sümbolite sagedus «a», «b», «c» ja «d» võrdub vastavalt 4, 2, 1, 1. Proovime kujutada seda «aabacdab» väiksema bittide arvuga, kasutades fakti, et «a» esineb sagedamini kui «b», vaid «b» esineb sagedamini kui «c» ja «d». Alustame sellega, et kodeerime «a» ühe bitiga, mis on 0, «b» anname kahele bitile koodi 11 ja kolme bitiga kodeerime 100 ja 011 «c» ja «d».
Kokkuvõttes saame:
a
0
b
11
c
100
d
011
Nii kodeerime järje «aabacdab» nagu 00110100011011 (0|0|11|0|100|011|0|11), kasutades eelnevalt esitatud koode. Kuid peamine probleem on dekodeerimisel. Kui proovime dekodeerida järje 00110100011011, saame kahemõttelise tulemuse, kuna seda saab esitada kui:
0|011|0|100|011|0|11    adacdab
0|0|11|0|100|0|11|011   aabacabd
0|011|0|100|0|11|0|11   adacabab
…
jne.
Selle ebamugavuse vältimiseks peame tagama, et meie kodeerimine rahuldaks sellist mõistet nagu eelseisva reegli, mis omakorda tähendab, et koode saab dekodeerida ainult ühe ainulaadse viisi kaudu. Eelseisva reegel tagab, et ükski kood ei ole teise eelseisja. Koodi all mõtleme me bite, mida kasutatakse konkreetse sümboli esindamiseks. Ülaltoodud näites 0 – on eelseisja 011, mis rikub eelseisva reeglit. Nii, kui meie koodid vastavad eelseisvale reeglile, siis on võimalik dekodeerimine üheselt (ja vastupidi).
Vaadakem ülaltoodud näidet uuesti. Seekord määrame sümbolitele «a», «b», «c» ja «d» koode, mis rahuldavad eelseisva reegli.
a
0
b
10
c
110
d
111
Sellise kodeerimisega kooditakse string «aabacdab» nüüd üheks üheselt dekodeeritavaks ja naaseme oma algsele stringile 00100100011010 (0|0|10|0|100|011|0|10)Programmi loomiseks Nanonyami jaoks tuleb kasutada spetsiaalseid raamatukogusid, kus on rakendatud kõik praegu saadaval olevad virtuaalsed funktsioonid. Laadige alla virtuaalne masin Nanonyam ja raamatukogud selle jaoks 00100100011010 Huffmani kodeerimine «aabacdab».
Nüüd, kui oleme tutvunud muutuva pikkusega kodeerimise ja eelseisva reegliga, räägime Huffmani kodeerimisest.
Meetod põhineb binaarpuude loomisel. Sellel võib olla sõlm, mis on kas lõplik või sise-sõlm. Esialgu kõik sõlmed peetakse lehtedeks (lõplikud), mis esindavad sümbolit ja selle kaalu (ehk esinemissagedust). Sisesõlmed sisaldavad sümboli kaalu ja viitavad kahele pärandsõlmele. Üldiselt, bit
„0” esindab vasaku haru järgimist ja „1” – parema järgimist. Täielikus puus on lehti ja N N-1 sisesõlme. Soovitav on, et Huffmani puu ehitamisel kõrvaldada kasutamata sümbolid, et saavutada parima pikkusega koodid. Kasutame prioriteedipuhvrit Huffmani puu ehitamiseks, kus madalaimaga sageduse sõlmele antakse kõrgeim prioriteet. Allpool on toodud ehitamise sammud:
Loo iga sümboli jaoks lehesõlm ja lisa need prioriteedipuhvrisse.
- Kuni puhvris on rohkem kui üks leht, teeme järgmist:
- Eemaldage kaks kõrgeima prioriteediga (madalaima sagedusega) sõlme puhvrist;
- Loo uus sise-sõlm, kus need kaks sõlme on pärijad, ja esinemissagedus võrdub nende kahe sõlme sageduste summaga.
- Lisage uus sõlm prioriteedipuhvrisse.
- Lisage uus sõlm prioriteedipuhvrisse.
- Ainus jäänud sõlm on juursõlm, millega puu ehitamine lõppeb.
Oletame, et meil on mingi tekst, mis koosneb ainult märkidest «a», «b», «c», «d» ja «e», mille esinemissagedused on vastavalt 15, 7, 6, 6 ja 5. Allpool on illustratsioonid, mis kajastavad algoritmi samme.
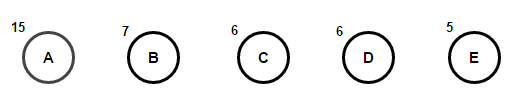
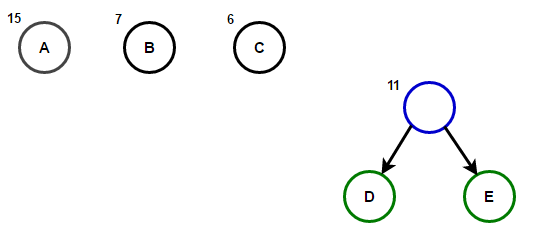
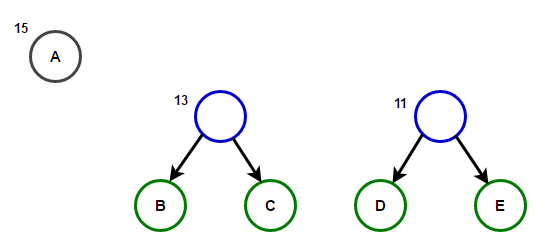
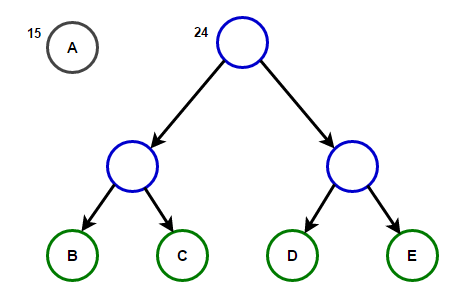
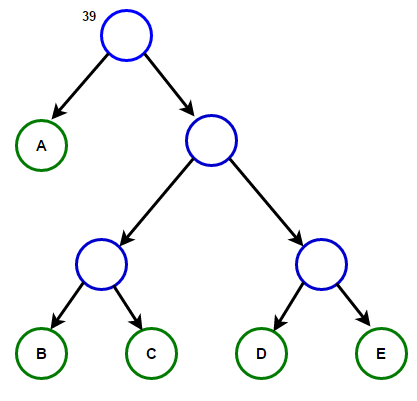
Tee juurest igasse lõpp-sõlme salvestab optimaalse eesliite koodi (tuntud ka kui Huffmani kood), mis vastab sellele lõpp-sõlmele seotud märgile.
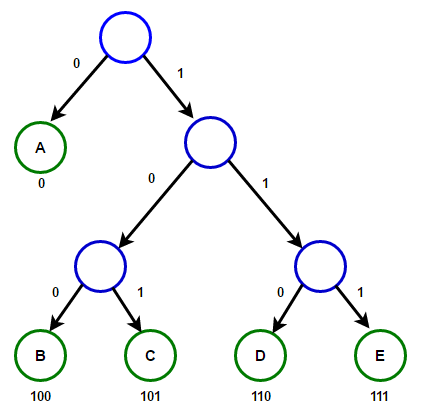
Huffmani puu
Allolevalt leiate Huffmani tihendamisalgoritmi teostuse keeltes C++ ja Java:
#include <iostream>
#include <string>
#include <queue>
#include <unordered_map>
using namespace std;

// A Tree node
struct Node
{
	char ch;
	int freq;
	Node *left, *right;
};

// Function to allocate a new tree node
Node* getNode(char ch, int freq, Node* left, Node* right)
{
	Node* node = new Node();

	node->ch = ch;
	node->freq = freq;
	node->left = left;
	node->right = right;

	return node;
}

// Comparison object to be used to order the heap
struct comp
{
	bool operator()(Node* l, Node* r)
	{
		// highest priority item has lowest frequency
		return l->freq > r->freq;
	}
};

// traverse the Huffman Tree and store Huffman Codes
// in a map.
void encode(Node* root, string str,
			unordered_map<char, string> &huffmanCode)
{
	if (root == nullptr)
		return;

	// found a leaf node
	if (!root->left && !root->right) {
		huffmanCode[root->ch] = str;
	}

	encode(root->left, str + "0", huffmanCode);
	encode(root->right, str + "1", huffmanCode);
}

// traverse the Huffman Tree and decode the encoded string
void decode(Node* root, int &index, string str)
{
	if (root == nullptr) {
		return;
	}

	// found a leaf node
	if (!root->left && !root->right)
	{
		cout << root->ch;
		return;
	}

	index++;

	if (str[index] =='0')
		decode(root->left, index, str);
	else
		decode(root->right, index, str);
}

// Builds Huffman Tree and decode given input text
void buildHuffmanTree(string text)
{
	// count frequency of appearance of each character
	// and store it in a map
	unordered_map<char, int> freq;
	for (char ch: text) {
		freq[ch]++;
	}

	// Create a priority queue to store live nodes of
	// Huffman tree;
	priority_queue<Node*, vector<Node*>, comp> pq;

	// Create a leaf node for each character and add it
	// to the priority queue.
	for (auto pair: freq) {
		pq.push(getNode(pair.first, pair.second, nullptr, nullptr));
	}

	// do till there is more than one node in the queue
	while (pq.size() != 1)
	{
		// Remove the two nodes of highest priority
		// (lowest frequency) from the queue
		Node *left = pq.top(); pq.pop();
		Node *right = pq.top();	pq.pop();

		// Create a new internal node with these two nodes
		// as children and with frequency equal to the sum
		// of the two nodes' frequencies. Add the new node
		// to the priority queue.
		int sum = left->freq + right->freq;
		pq.push(getNode(' ', sum, left, right));
	}

	// root stores pointer to root of Huffman Tree
	Node* root = pq.top();

	// traverse the Huffman Tree and store Huffman Codes
	// in a map. Also prints them
	unordered_map<char, string> huffmanCode;
	encode(root, "", huffmanCode);

	cout << "Huffman Codes are :n" << 'n';
	for (auto pair: huffmanCode) {
		cout << pair.first << " " << pair.second << 'n';
	}

	cout << "nOriginal string was :n" << text << 'n';

	// print encoded string
	string str = "";
	for (char ch: text) {
		str += huffmanCode[ch];
	}

	cout << "nEncoded string is :n" << str << 'n';

	// traverse the Huffman Tree again and this time
	// decode the encoded string
	int index = -1;
	cout << "nDecoded string is: n";
	while (index < (int)str.size() - 2) {
		decode(root, index, str);
	}
}

// Huffman coding algorithm
int main()
{
	string text = "Huffman coding is a data compression algorithm.";

	buildHuffmanTree(text);

	return 0;
}
import java.util.HashMap;
import java.util.Map;
import java.util.PriorityQueue;
// Puudutüüp
class Node
{
char ch;
int freq;
Node left = null, right = null;
Node(char ch, int freq)
{
this.ch = ch;
this.freq = freq;
}
public Node(char ch, int freq, Node left, Node right) {
this.ch = ch;
this.freq = freq;
this.left = left;
this.right = right;
}
};
class Huffman
{
// Traverseerib Huffmani puud ja salvestab Huffmani koodid
// kaardis.
public static void encode(Node root, String str,
Map huffmanCode)
{
if (root == null)
return;
// lehtpuu sõlm leitud
if (root.left == null && root.right == null) {
huffmanCode.put(root.ch, str);
}
encode(root.left, str + "0", huffmanCode);
encode(root.right, str + "1", huffmanCode);
}
// Traverseerib Huffmani puud ja dekodeerib kodeeritud stringi
public static int decode(Node root, int index, StringBuilder sb)
{
if (root == null)
return index;
// lehtpuu sõlm leitud
if (root.left == null && root.right == null)
{
System.out.print(root.ch);
return index;
}
index++;
if (sb.charAt(index) == '0')
index = decode(root.left, index, sb);
else
index = decode(root.right, index, sb);
return index;
}
// Koostab Huffmani puu ja huffmanCode ning dekodeerib antud siseteksti
public static void buildHuffmanTree(String text)
{
// arvestab iga tähe esinemise sagedust
// ja salvestab selle kaardis
Map freq = new HashMap();
for (int i = 0 ; i < text.length(); i++) {
if (!freq.containsKey(text.charAt(i))) {
freq.put(text.charAt(i), 0);
}
freq.put(text.charAt(i), freq.get(text.charAt(i)) + 1);
}
// Loob prioriteetide järjekorra, et salvestada elusolevaid sõlmi
// Huffmani puust.
// Pöörake tähelepanu, et kõrgeima prioriteediga objekt
// omab madalaimat sagedust
PriorityQueue pq = new PriorityQueue(
(l, r) -> l.freq - r.freq);
// Loob iga tähe jaoks lehtsõlme ja lisab selle
// prioriteetide järjekorda.
for (Map.Entry entry : freq.entrySet()) {
pq.add(new Node(entry.getKey(), entry.getValue()));
}
// jätkab, kuni järjekorras on rohkem kui üks sõlm
while (pq.size() != 1)
{
// Eemaldab järjekorrast kaks kõige kõrgema prioriteediga sõlme
// (madalaima sagedusega)
Node left = pq.poll();
Node right = pq.poll();
// Loob uue sisemuse sõlme nende kahe sõlme lastega
// ja sagedus, mis on võrdsed kahe sõlme
// sageduste summaga. Lisab uue sõlme järjekorda.
int sum = left.freq + right.freq;
pq.add(new Node(' ', sum, left, right));
}
// Root hoiab viidet Huffmani puu juurele
Node root = pq.peek();
// Traverseerib Huffmani puud ja salvestab Huffmani koodid kaardis
Map huffmanCode = new HashMap();
encode(root, "", huffmanCode);
// Prindib Huffmani koodid
System.out.println("Huffmani koodid on :\n");
for (Map.Entry entry : huffmanCode.entrySet()) {
System.out.println(entry.getKey() + " " + entry.getValue());
}
System.out.println("\nOriginaalne string oli :\n" + text);
// Prindib kodeeritud stringi
StringBuilder sb = new StringBuilder();
for (int i = 0 ; i < text.length(); i++) {
sb.append(huffmanCode.get(text.charAt(i)));
}
System.out.println("\nKodeeritud string on :\n" + sb);
// Traverseerib Huffmani puud uuesti ja seekord
// dekodeerib kodeeritud stringi
int index = -1;
System.out.println("\nDekodeeritud string on: \n");
while (index < sb.length() - 2) {
index = decode(root, index, sb);
}
}
public static void main(String[] args)
{
String text = "Huffmani koding on andmete tihendamise algoritm.";
buildHuffmanTree(text);
}
}Märkus: Sisendstringi kasutamiseks vajaminev mälu on 47 * 8 = 376 bitti, samas kui kodeeritud string võtab ainult 194 bitti, st andmed tihendatakse umbes 48%. Ülaltoodud C++ programmis kasutame kiri klass string, et salvestada kodeeritud string, et muuta programm loetavaks.
Kuna efektiivsed prioriteetsüsteemide andmestruktuurid vajavad lisamiseks O(log(N)) aega ja täielikus binaarpuus on N lehti 2N-1 sõlme, ning Huffmani puu on täispuhas binaarpuu, siis töötab algoritm ajaga O(Nlog(N)) kus N on sümbolite arv.
Allikad:
Allikas: habr.com
