

Jaotatud arvutuse ja suurte andmete turg kasvab 18-19% aastas, kui uskuda . Seega on tarkvara valiku teema endiselt aktuaalne. Selles postituses alustame sellest, miks on vajalikke jaotatud arvutusi, käsitleme lähemalt tarkvara valikut, räägime Hadoopi kasutamisest Cloudera abil ning lõpuks arutame riistvaravalikut ja seda, kuidas see mitmesuguseid viise töötluse tõhusust mõjutab.
Miks on jaotatud arvutused igapäevases äritegevuses vajalikud? Siin on kõik samal ajal lihtne ja keeruline. Lihtne, kuna enamasti teeme me suhteliselt lihtsaid arvutusi ühe infoüksuse kohta. Keeruline, kuna selliseid andmeid on palju. Väga palju. Selle tulemusena tuleb meil . Seega on kasutusstsenaariumid üsna universaalsed: arvutused võivad kehtida kõikjal, kus on vajalik arvesse võtta suurt hulka näitajaid veelgi suuremas andmemassis.
Üks hiljutine näide: Dodo Pizza kliendi tellimuste andmebaasi analüüsi põhjal, et kui kasutajad valivad pitsat juhuslike koostisosadega, kasutavad nad tavaliselt ainult kuut põhikomplekti koostisosade kohta, pluss paar juhuslikku. Selle alusel kohandas pitsafirma oma ostupoliitikat. Lisaks suudeti paremini soovitada kasutajatele täiendavaid tooteid, mis pakuti tellimuse tegemise ajal, mis aitas suurendada kasumit.
Veel üks näide: tooteartiklid võimaldasid H&M kauplusel vähendada valikut teatud kauplustes 40% võrra, samal ajal müügitaset säilitades. Seda õnnestus saavutada, välistades halvasti müüdavad tooted, arvestades samas hooajalisust.
Tööriista valik
Selliste arvutuste valdkonna standardiks on Hadoop. Miks? Sest Hadoop on suurepärane, hästi dokumenteeritud raamistik (samas tuleb Habrist palju põhjalikke artikleid selle kohta), mis on varustatud terve komplekti utiliitide ja raamatukogudega. Saate esitada tohutuid koguseid nii struktureeritud kui ka struktureerimata andmeid, samas kui süsteem jaotab need iseseisvalt arvutusvõimsustele. Ja neid võimsusi saab igal ajal suurendada või välja lülitada — see ongi horisontaalne skaleeritavus tegevuses.
2017. aastal sõlmis mainekas konsultatsioonifirma Gartner , et Hadoop kaotab varsti oma tähtsuse. Põhjus on üsna banaalne: analüütikud usuvad, et ettevõtted hakkavad massiliselt pilve migreerima, kuna seal saavad nad maksta vastavalt kasutatud arvutusvõimsusele. Teine oluline tegur, mis suudab Hadoopi "maha matta", on töökiirus. Sest sellised lahendused nagu Apache Spark või Google Cloud DataFlow töövad kiiremini kui MapReduce, mis on Hadoopi alus.
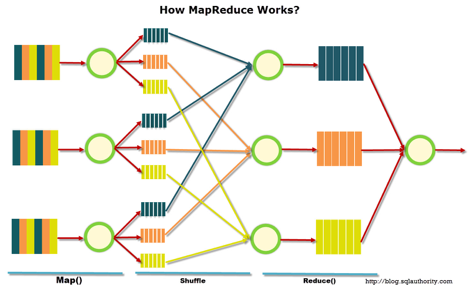
Hadoop toetub mitmele suurele alusele, mille seas on kõige silmapaistvamad tehnoloogiad MapReduce (andmete jagamise süsteem arvutuste tegemiseks serverite vahel) ja failisüsteem HDFS. Viimane on spetsiaalselt loodud klastrisse jaotatud teabe salvestamiseks: iga fikseeritud suurusega blokk võib asuda mitmes sõlmes ning replikatsiooni tõttu tagatakse süsteemi vastupidavus üksikute sõlmede tõrgetele. Failitabeli asemel kasutatakse spetsiaalset serverit, mida nimetatakse NameNode'iks.
Alloleval joonisel on näidatud MapReduce töödiagramm. Esimeses etapis jagatakse andmed kindla kriteeriumi järgi, teises - jaotatakse need arvutusvõimsuse vahel, kolmandas - toimub arvutus.
Algul töötas Google MapReduce välja oma otsingu vajaduste jaoks. Siis muutus MapReduce avatud lähtekoodiga ja projekti asus arendama Apache. Ja Google liikus järk-järgult teiste lahenduste suunas. Huvitav nüanss on see, et hetkel on Googlel projekt nimelt Google Cloud Dataflow, mis positsioneeritakse järgmise sammuna pärast Hadoopit, kiire asendajana.
Lähedal vaatamisel on selge, et Google Cloud Dataflow põhineb Apache Beami variandil, kusjuures Apache Beam sisaldab hästi dokumenteeritud raamistikku Apache Spark, mis tähendab, et lahenduste töökiirus on praktiliselt identne. Samuti töötab Apache Spark suurepäraselt HDFS failisüsteemil, mis võimaldab seda Hadoopi serverites rakendada.
Lisame siia Hadoopi ja Sparki dokumentatsiooni ja valmislahenduste mahu võrreldes Google Cloud Dataflow'ga, ja tööriista valik muutub ilmseks. Veelgi enam, insenerid saavad ise otsustada, millist koodi - Hadoopi või Sparki - nad soovivad täita, tuginedes ülesandele, kogemusele ja kvalifikatsioonile.
Pilv või kohalik server
Üldine suundumus pilveteenustele viis sellise huvitava termini nagu Hadoop-as-a-service kasutuselevõtuni. Sellises stsenaariumis on serverite haldamine äärmiselt oluline. Kahjuks on puhas Hadoop oma populaarsusest hoolimata üsna keeruline seadistamisvahend, kuna palju tuleb teha käsitsi. Näiteks peab iga serverit eraldi konfigureerima, jälgima nende näitajaid ja hoolikalt seadistama mitmeid parameetreid. Üldiselt on see hobi jaoks sobiv töö ja on suur oht midagi valesti teha või midagi tähelepanuta jätta.
Seetõttu on populaarsust kogunud erinevad jaotised, mis on algselt varustatud mugavate paigaldus- ja haldustööriistadega. Üks populaarsemaid jaotusi, mis toetab Spark'i ja muudab elu lihtsamaks, on Cloudera. Sellel on nii tasuline kui ka tasuta versioon — ja viimasena on saadaval kogu põhifunktsionaalsus, ilma sõlmede arvu piiranguta.
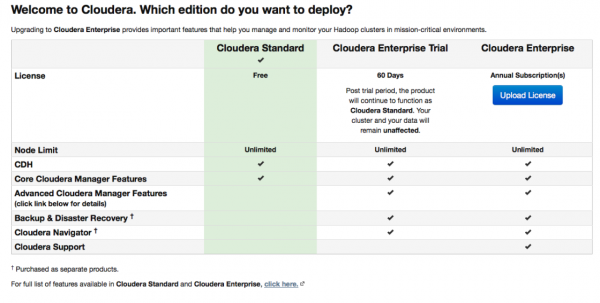
Cloudera Manager'i seadistamise ajal ühendub see SSH kaudu teie serveritega. Huviäratav on see, et installimisel on parem näidata, et see toimub nii-öelda pakettide: spetsiaalsete paketide abil, milles on kõik vajalikud komponendid, mis on seadistatud omavaheliseks töötamiseks. Põhimõtteliselt on see täiustatud versioon pakihaldurist.
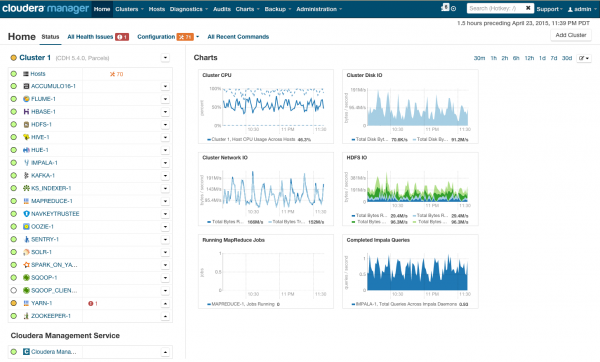
Pärast installatsiooni saame klastrihalduri konsoli, kus on näha klastrite telemeetria, paigaldatud teenused, lisaks võite ressursse lisada/eemaldada ja klastrikonfiguratsiooni redigeerida.
Kuna tulete silmitsi raketi lõikega, mis viib teid BigData tulevikku. Kuid enne kui ütlete „minema”, liikuge kapoti alla.
Riistvara nõuded
Cloudera mainib oma saidil erinevaid võimalikke konfiguratsioone. Üldised põhimõtted, mille järgi need on koostatud, on toodud illustratsioonil:
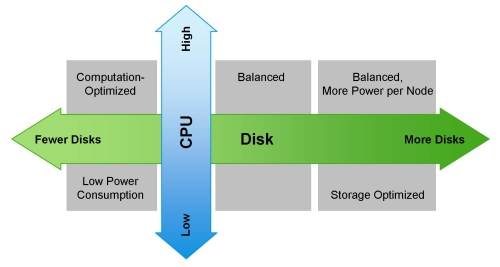
MapReduce võib seda optimistlikku pilti moonutada. Kui vaadata uuesti eelmise jaotise skeemi, on selge, et peaaegu kõikides olukordades võib MapReduce'i ülesanne kokku puutuda „pudelikaelaga” andmete lugemisel kettalt või võrgust. Seda mainitakse ka Cloudera blogis. Seetõttu on kiiresti arvutamiseks, sealhulgas Sparkiga, mis on sageli kasutatav reaalajas arvutustes, sisendi/väljundi kiirus väga oluline. Seega on Hadoopi kasutamisel äärmiselt oluline, et klastrisse jõuaksid tasakaalustatud ja kiirete masinate komplektid, mis, õrnalt öeldes, ei ole alati tagatud pilveinfrastruktuuris.
Laadimise tasakaalustamine saavutatakse Openstacki virtualiseerimise abil võimsates mitme tuumaga protsessoritega serverites. Andme-sõlmedele on eraldatud oma protsessorivõimsus ja kindlad kettad. Meie lahenduses Atos Codex Data Lake Engine saavutatakse lai virtualiseerimine, mis toob meile kasu nii jõudluse osas (minimeeritakse võrguinfrastruktuuri mõju) kui ka TCO (välistatakse soovimatud füüsilised serverid).
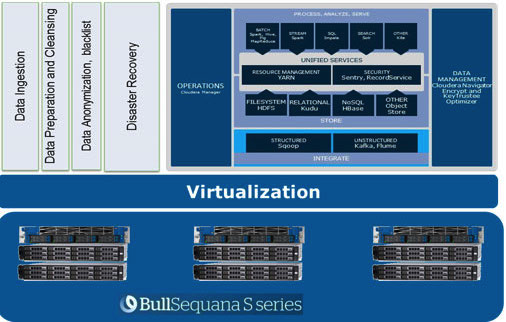
BullSequana S200 serverite kasutamisel saavutame üsna tasakaalustatud koormuse, mis on vaba osa pudelikaeladest. Minimaalsesse konfiguratsiooni kuulub 3 BullSequana S200 serverit, igaühel on kaks JBOD, lisaks saab valikuliselt ühendada täiendavaid S200, millel on neli andme-sõlme. Siin on näide koormusest TeraGen testis:
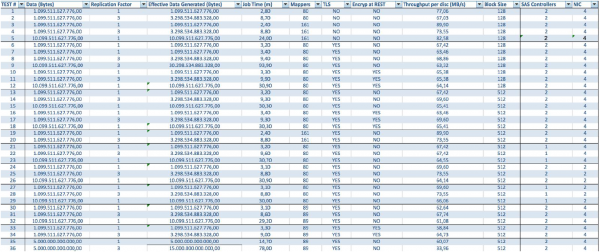
Testid erinevate andmehulga ja replikatsiooniväärtustega näitavad klastrisõlmede koormuse jaotuses sama tulemuste taset. Allpool on graafik ketta juurdepääsu jaotuse kohta jõudlustestide põhjal.
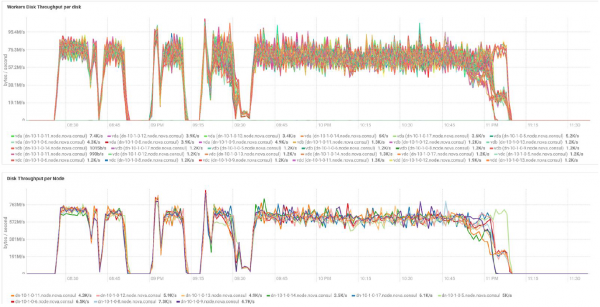
Arvutused tehti 3 BullSequana S200 serveri minimaalses konfiguratsioonis. See sisaldab 9 andme-sõlme ja 3 peamist sõlme, samuti reserveeritud virtuaalmasinaid OpenStack Virtualiseerimise kaitse rakendamiseks. TeraSort testitulemus: ploki suurus 512 MB replikatsioonikordaja kolm, krüpteerimisega 23,1 min.
Kuidas saaks süsteemi laiendada? Data Lake Engine jaoks on saadaval erinevad laiendamise võimalused:
- Andmeedastus-sõlmed: iga 40 TB kasuliku ruumi kohta
- Analüütilised sõlmed GPU installimise võimalusega
- Muud valikud, sõltuvalt ettevõtte vajadustest (näiteks kui on vajalik Kafka ja muud sarnased tehnoloogiad)
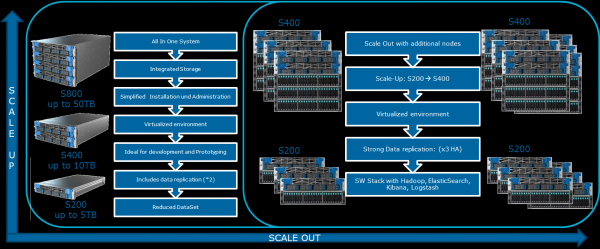
Atos Codex Data Lake Engine'i kompleks sisaldab nii servereid kui ka eelinstalleeritud tarkvara, sealhulgas litsentsiga Cloudera paketti; Hadoop ise, OpenStack, mis sisaldab virtuaalmasinaid RedHat Enterprise Linuxi tuum põhjal, andmete replikatsioonisüsteemid ja varukoopiate haldamine (sealhulgas varukoopianoodi ja Cloudera BDR — Backup and Disaster Recovery abil). Atos Codex Data Lake Engine oli esimene virtualiseerimise lahendus, mis sai sertifitseeritud. .
Kui teil on huvi detailide vastu, oleme valmis vastama teie küsimustele kommentaarides.
Allikas: habr.com
